


November 20, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.




Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
50 Fragen, die Sie jedem Anbieter im Jahr 2026 stellen sollten
Evaluierungen von Enterprise-KI-Plattformen scheitern auf vorsehbare Weise. Die Demo des Anbieters läuft mit einem kuratierten Test-Prompt. Seine Preisübersicht basiert auf Annahmen von 5.000 Tokens pro Aufruf, die nicht Ihrer tatsächlichen Arbeitslast entsprechen. Das gezeigte Sicherheitsarchitektur-Diagramm gilt für einen Bereitstellungsmodus, nach dem Sie nicht gefragt haben. Die behauptete MCP-Funktion ist erst „im nächsten Release“ verfügbar. Sechs Wochen später unterzeichnen Sie einen Vertrag für ein Produkt, das zu 70 Prozent passt, und Ihr Plattform-Team verbringt die Vertragslaufzeit damit, die restlichen 30 Prozent durch Eigenentwicklungen zu schließen.
Eine bewertete Ausschreibung (RFP) ändert diese Dynamik. Jeder Anbieter beantwortet dieselben Fragen schriftlich, bevor irgendeine Demo läuft. Ausweichende Antworten (eine umgangene Frage, eine Funktion, die „unseren Integrationspartner erfordert“, ein Compliance-Versprechen, das einer Detailfrage nicht standhält) werden im schriftlichen Protokoll offenbart, wo sie in einem Folgegespräch nicht mehr umgedeutet werden können. Dasselbe Protokoll zieht den Anbieter zur Rechenschaft, wenn die Realität nach der Unterschrift von den Vertriebsversprechen vor der Unterschrift abweicht – die mit Abstand häufigste Beschwerde im Beschaffungsprozess bei der Verlängerung nach dem ersten Jahr.
Drei Themen heben diese Vorlage über allgemeine Beschaffungs-Frameworks hinaus. MCP-Governance, der Protokoll-Stack, den Ihre KI-Agenten zur Kommunikation mit Werkzeugen nutzen werden und bei dem die meisten KI-Gateway-Produkte nachträglich Zugriffskontrollen anbauen, für die sie nicht konzipiert wurden. Agentische KI-Steuerung, die Trace-Korrelation, Kostenzuordnung und Isolationsgrenzen, die eine mehrstufige Agenten-Aufgabe in eine debuggbare, abrechenbare und steuerbare Einheit verwandeln, anstatt in einem Nebel unzusammenhängender LLM-Aufrufe zu enden. KI-spezifische Compliance, einschließlich Feldparität im Audit-Log zwischen LLM- und Tool-Aufrufen, strukturierte Antworten zur Datenresidenz, die das Routing von Modellanbietern über Regionen hinweg berücksichtigen, sowie architektonische BAA-Kontrollen, die die HIPAA-Durchsetzung zu einer realen Schutzmaßnahme statt zu bloßem Papierkram machen.
Nutzen Sie dies als Ausgangspunkt. Passen Sie die Gewichtungen an Ihre Umgebung an. Senden Sie dasselbe Dokument an jeden Anbieter auf Ihrer engeren Auswahl. Das Solutions-Team von TrueFoundry ist darauf vorbereitet, alle 50 Fragen schriftlich und mit Nachweisen im Rahmen der formalen Enterprise-Evaluierung zu beantworten.
Nun zu den Fragen selbst.

Abbildung 1. Split-Plane-Referenzarchitektur: Control Plane und Compute Plane sind durch eine reine Metadaten-Grenze getrennt, wobei ein einziger IdP Identitätsdaten in beide einspeist.
Die Reihenfolge der Schritte ist wichtiger als die Fragen selbst. Die meisten gescheiterten Evaluierungen überspringen den ersten Schritt: das Einholen schriftlicher Antworten auf die gesamte Vorlage, bevor ein Anbieter eine Demo zeigen darf. Demos dienen der Überprüfung schriftlicher Zusagen, nicht der Funktionserkundung. Wenn die erste Präsentation eines Features durch einen Anbieter auf einer Folie erfolgt, haben Sie ihm die Kontrolle über die Evaluierungsdokumentation überlassen.
Senden Sie die Vorlage gleichzeitig an jeden Anbieter Ihrer engeren Auswahl, mit einer Frist für die schriftliche Rückmeldung von zwei Wochen. Nutzen Sie die Antworten für eine Bewertung anhand einer gewichteten Rubrik. Erst nach der Auswertung buchen Sie Demos. In diesen Demos besteht die Aufgabe Ihres Plattform-Teams darin, zu überprüfen, ob die schriftlichen Angaben mit dem laufenden System übereinstimmen. Betrachten Sie jede Zusage, die erst in der Demo auftaucht, aber nicht in der schriftlichen Antwort enthalten war, als Klärungsbedarf und nicht als positiv zu bewertendes Feature.
Einige konkrete Empfehlungen für eine erfolgreiche Durchführung:
Wenn Sie schon einmal in einer Sicherheitsüberprüfung saßen, bei der sich der Compliance-Umfang des Anbieters nur auf die SaaS-Option bezog, die Sie gar nicht nutzen wollten, kennen Sie die Kosten des Überspringens dieser systematischen Bewertung. Ein bewertetes RFP erzwingt diese Details vor dem Vertragsabschluss.
Sicherheit und Compliance ist der Bereich, in dem die meisten KI-Plattform-Evaluierungen im zweiten Gespräch scheitern. Nicht, weil den Anbietern Zertifizierungen fehlen. Die meisten verfügen irgendwo über ein SOC 2 Type II. Die Fehlerursache liegt in der Abstimmung: Der Zertifizierungsumfang, die implementierten architektonischen Kontrollen und der von Ihnen tatsächlich gekaufte Bereitstellungsmodus stimmen nicht überein. Ein SOC 2, das das Marketingportal des Anbieters abdeckt, nützt nichts für ein KI-Gateway, das PHI On-Premise verarbeitet. Ein BAA, das als Vorlage existiert, aber nicht beschreibt, wie PHI in der Data Plane isoliert wird, ist Bürokratie, keine Schutzmaßnahme. Die folgenden Fragen erzwingen die Übereinstimmung zwischen Zertifizierungsumfang und architektonischer Realität, die verhindert, dass „Wir sind zertifiziert“-Antworten unberechtigtes Gewicht erhalten.
Ein weiteres Fehlermuster, das früh genannt werden sollte: Anbieter, die Sicherheitsfragen abstrakt beantworten, weil ihre konkrete Architektur auf zwei Produkte mit unterschiedlichen Sicherheitsstandards aufgeteilt ist. Ihre On-Premise-Version hat einen geringen Funktionsumfang und ist nicht separat zertifiziert. Ihre SaaS-Version verfügt über die Zertifizierungen, passt aber nicht in Ihre Umgebung. Erkennen Sie dies, indem Sie dieselbe Frage zweimal stellen und dabei jeweils den Bereitstellungsmodus angeben. Wenn die Antworten voneinander abweichen, betrachten Sie zwei Produkte, die als eines vermarktet werden.
Bewerten Sie diesen Abschnitt streng.
Ein Split-Plane-Deployment, bei dem die Data Plane (der Proxy, der Prompts, Modellantworten, Embeddings und MCP-Tool-Aufrufe verarbeitet) vollständig im VPC des Kunden läuft und niemals eine ausgehende Verbindung zur Infrastruktur des Anbieters für Request-Nutzlasten öffnet. Die Control Plane (Konfiguration, RBAC-Einstellungen, Dashboards) kann je nach Bereitstellungsmodus in der Infrastruktur des Anbieters oder des Kunden laufen, tauscht jedoch nur Metadaten aus. Audit-Logs, Prompt-Response-Daten und Embeddings landen im kundenkontrollierten Objektspeicher (S3, GCS, Azure Blob), nicht in vom Anbieter verwalteten Datenbanken. Wenn das „VPC-Deployment“ des Anbieters immer noch Prompts an einen vom Anbieter verwalteten Log-Aggregator sendet, handelt es sich um ein SaaS-Deployment in einer anderen Verpackung.
Überprüfen Sie den Abschnitt „System Description“ auf die explizite Nennung der abgedeckten Bereitstellungsmodi. Achten Sie auf Formulierungen wie „the multi-tenant SaaS environment hosted in [cloud]“ im Vergleich zu „the customer-deployed gateway and control plane components“. Wenn in der Beschreibung nur eines genannt wird, deckt die Zertifizierung auch nur dieses eine ab. Überprüfen Sie die abgedeckten Trust Services Criteria. Sicherheit ist die Basis, aber Verfügbarkeit, Vertraulichkeit und Verarbeitungsintegrität sind entscheidend für KI-Workloads, die regulierte Daten verarbeiten. Ein SOC 2, das nur die Sicherheit abdeckt, ist nur die halbe Miete.
Die Plattform bezieht Schlüssel von Modellanbietern beim Start des Gateways oder auf Anfrage aus dem Vault oder Secrets Manager des Kunden unter Verwendung einer vom Kunden verwalteten IAM-Rolle, wobei Schlüsselreferenzen (nicht die Schlüsselwerte selbst) in der Plattformkonfiguration gespeichert werden. Die Rotation ist ein Vault-Vorgang: Überschreiben Sie den Schlüssel im Vault, das Gateway übernimmt den neuen Wert beim nächsten Lesevorgang oder nach einem konfigurierbaren Aktualisierungsintervall. Die Plattform speichert Anbieterschlüssel niemals dauerhaft im Ruhezustand (at rest). Wenn die Antwort des Anbieters lautet: „Sie laden Schlüssel in unsere Admin-Benutzeroberfläche hoch und wir speichern sie verschlüsselt“, handelt es sich um ein anderes (und schwächeres) Sicherheitsmodell. Die Schlüssel befinden sich nun selbst bei einem „VPC“-Deployment in der Infrastruktur des Anbieters.
Das MCP-Tool-Aufruf-Log sollte Feld-Parität für die gemeinsamen Dimensionen (timestamp, request_id, trace_id, user, application, latency_ms, status, policy decision) plus die werkzeugspezifischen Felder aufweisen:
Beachten Sie die identische trace_id bei beiden: Der LLM-Aufruf und die MCP-Ausführung korrelieren mit einer einzelnen Benutzeranfrage – dies ist die konkrete Antwort auf Frage 8 in Abschnitt 4. Hashen Sie die Parameter, anstatt sie im Klartext zu loggen. Vollständiges Parameter-Logging stellt in regulierten Umgebungen ein Datenabfluss-Risiko dar. Wenn dem Beispiel-MCP-Log des Anbieters policy.decision, trace_id oder die Benutzerzuordnung fehlen, ist MCP-Governance lediglich eine nachträgliche Berichterstattung und keine Durchsetzung.

Abbildung 2. Audit-Log-Datenfluss: Feld-Parität zwischen LLM-Inferenz-Ereignissen und MCP-Tool-Aufruf-Ereignissen, beide korreliert durch eine trace_id.
„Im Ruhezustand verschlüsselt“ ist universell. Wessen Schlüssel die Verschlüsselung durchführt, ist die eigentliche Kontrolle. In einem Self-Hosted Deployment sind vom Kunden kontrollierte Schlüssel erreichbar, da sich die Datenspeicher im Konto des Kunden befinden; in einem SaaS-Deployment sind vom Kunden kontrollierte Schlüssel eine anbieterseitige Funktion, die gezielt entwickelt werden muss. Stellen Sie die Frage unter Angabe des Deployment-Modus.
Bei Self-Hosted-Deployments bedeutet „Patch-Verfügbarkeit“ ein getaggtes Release, das das Plattform-Team des Kunden bereitstellen kann. Das „Fenster für Kundenanwendung“ ist die SLA, zu der sich der Kunde intern verpflichtet. Wenn der Anbieter ein 30-Tage-Fenster für den Kunden bei kritischen CVEs vorschlägt, ist das ein langer Zeitraum, in dem Sie exponiert sind; fordern Sie hier Anpassungen.
Die meiste Enterprise-Beschaffung scheitert beim Deployment. Die Plattform sieht in der SaaS-Demo großartig aus, doch dann deckt der Security-Review drei Dinge auf, die sie blockieren: ausgehende Konnektivität zur Anbieter-Infrastruktur für Telemetrie, eine in der Anbieter-Cloud gehostete Konfigurationsdatenbank und eine Control Plane, die eng an eine bestimmte Cloud-Region gekoppelt ist. Bis diese Einschränkungen sichtbar werden, haben Sie bereits Preise für das falsche Produkt verhandelt. Der weitere Weg besteht dann entweder darin, aus einer Position der versunkenen Kosten neu zu verhandeln, oder ein Deployment zu akzeptieren, das Compliance-Schulden schafft.
Dieser Abschnitt deckt Deployment-Einschränkungen im Vorfeld auf. Die Anbieter, die diese Fragen sauber beantworten können, sind diejenigen, die bereits in Umgebungen wie Ihrer deployed haben. Die Anbieter, die ein Discovery-Call benötigen, um Abschnitt 2 zu beantworten, haben das nicht – und Sie werden das Integration Engineering in genau dem Discovery-Call erledigen, für den Sie sie bezahlen.
Achten Sie genau auf die Antworten.
Größenordnung für dauerhafte ~500 RPS: 3 bis 4 Gateway-Replikate mit jeweils 2 vCPU / 4 GB RAM, Postgres mit 4 vCPU / 16 GB RAM mit 100 GB SSD, Blob-Speicher skaliert mit der Aufbewahrungsdauer (eine 90-Tage-Aufbewahrung bei 10 KB/Log-Eintrag und 500 RPS entspricht etwa 1,2 TB). Der Anbieter sollte solche Zahlen vor der Vertragsunterzeichnung schriftlich vorlegen – nicht ein „hängt vom Workload ab“.

Abbildung 3. Eine Control Plane verwaltet gleichzeitig Compute Planes über AWS, Azure, GCP und On-Premises-Kubernetes hinweg, jede mit ihrer eigenen Data-Residency-Grenze.
Alles, was bei einem Multi-Region-Produktions-Setup schlechter als dies ist, sollte mit einer schriftlichen Erklärung begründet werden. „Wir unterstützen kein Multi-Region“ ist von einem kleinen Anbieter akzeptabel; „Wir unterstützen es, verpflichten uns aber nicht zur RTO“ ist es nicht.
Jede Produktseite eines AI-Gateways liest sich gleich: einheitliche API, intelligentes Routing, Kostenkontrolle, Observability. Die konkreten Details hinter diesen Begriffen trennen ein Gateway, das Sie in der Produktion betreiben können, von einem einfachen Proxy mit einer Marketing-Website. „Intelligentes Routing“ kann alles bedeuten – von einem statischen Round-Robin zwischen zwei Modellen bis hin zu einer echten Kaskadierungs-Policy mit Obergrenzen für Kosten, Abgleich von Fähigkeiten und Fallback-Ketten. „Kostenkontrolle“ kann ein Dashboard bedeuten, das Ihnen die Rechnung von gestern anzeigt, oder es kann harte Token-Budgets bedeuten, die der Anwendung tatsächlich den Fehlercode 429 zurückgeben, wenn ein Team sein Limit erreicht.
Die Fragen in diesem Abschnitt erzwingen konkrete Angaben. Lehnen Sie Antworten ab, die Ihnen nur die Marketingtexte wiedergeben. Der Anbieter, der sagt: „Wir unterstützen intelligentes Routing“, ohne die Regelsprache, das Kaskadenverhalten, die Fehlerbehandlung und die Budgetintegration zu beschreiben, verfügt über kein Routing. Er hat lediglich ein Konfigurations-Flag.
Fordern Sie den Nachweis ein, dass die Architektur tatsächlich existiert.
Die Anwendung sendet eine standardmäßige OpenAI-kompatible Anfrage. Das Gateway wählt den Provider basierend auf der Regel aus, fällt im Fehlerfall in der Kaskade zurück, fügt die Budgetreferenz zur Kostenzuordnung an und wendet Guardrails inline an. Es sind keine Änderungen am Anwendungscode erforderlich, wenn die Route neu konfiguriert wird. Wenn die „intelligente Routenführung“ eines Anbieters für jede Variante Änderungen auf Anwendungsebene erfordert, handelt es sich nicht um Routing auf Gateway-Ebene. Es ist ein Wrapper.
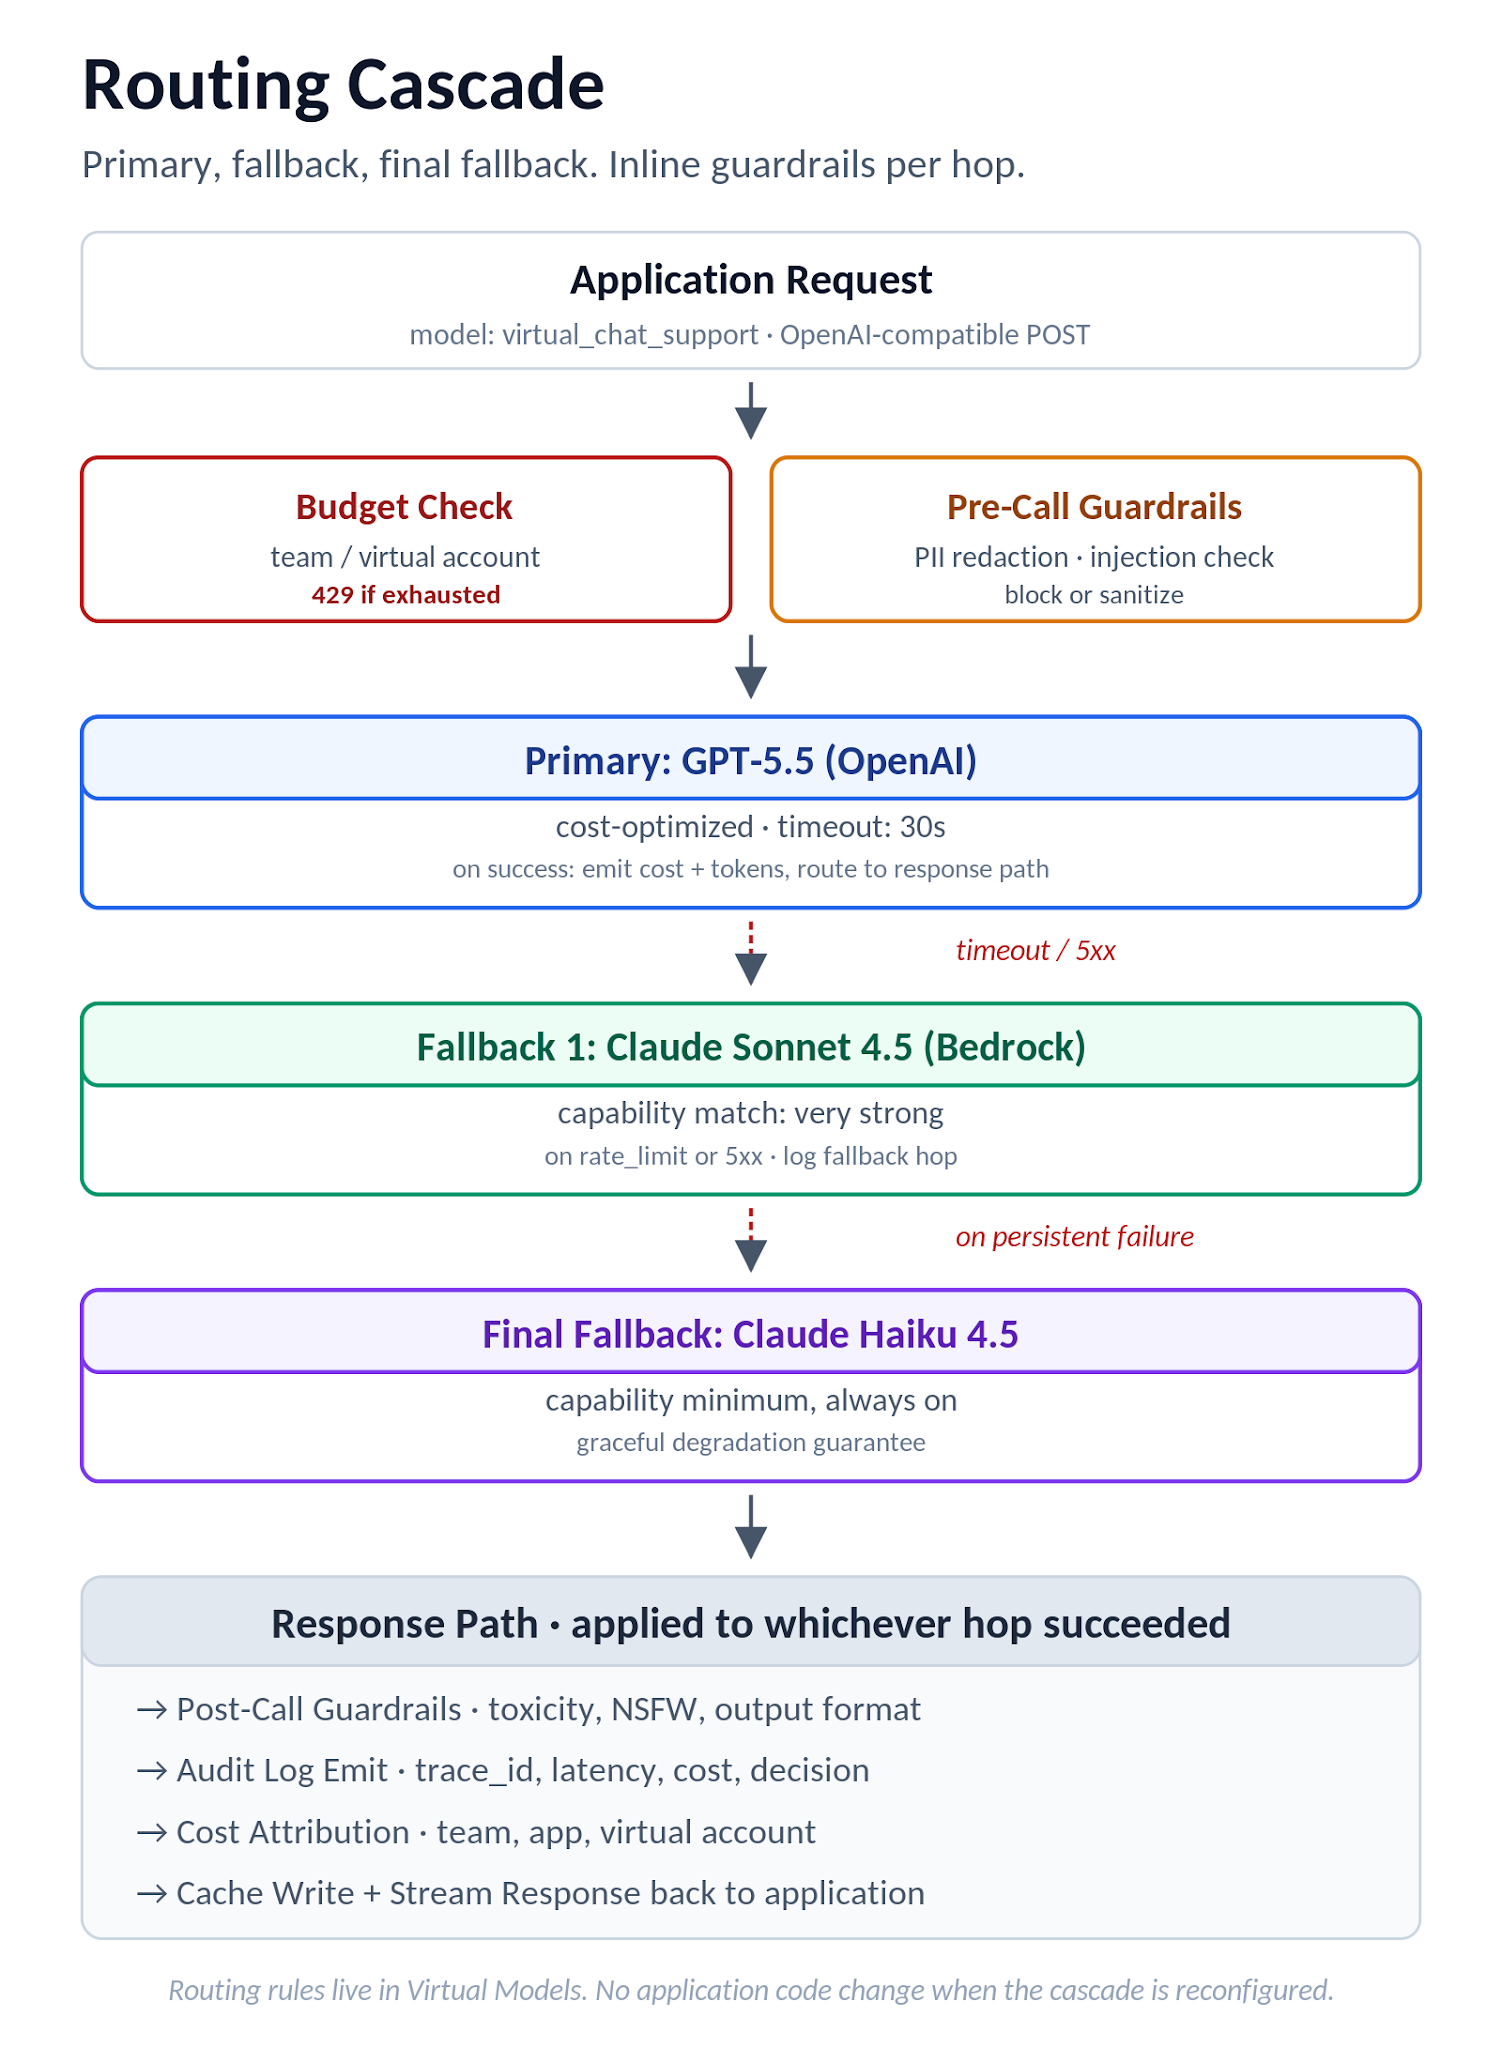
Abbildung 4. Ablauf der Routing-Kaskade: Budgetprüfung, Pre-Call-Guardrails, primärer Modellversuch, Fallback-Kette und ein einheitlicher Antwortpfad mit Audit, Kosten und Cache.
In diesem Abschnitt werden die meisten AI Gateway-Produkte an ihre Grenzen stoßen, da die meisten von ihnen für die Ära der LLM-Aufrufe entwickelt wurden und vor dem Zeitpunkt entstanden sind, als MCP in realen Unternehmensumgebungen auftauchte. MCP ist nicht „mehr Observability für Tool-Aufrufe“. Es ist eine separate Governance-Ebene: ein Register genehmigter Server, ein Durchsetzungspunkt dafür, welche Tools jede Rolle aufrufen kann, Audit-Logs, die den LLM-Aufruf-Logs in der Feldabdeckung entsprechen, und eine Policy Engine, die zum Aufrufzeitpunkt ausgeführt wird und nicht als Nachbereitungsexperiment. Anbieter, die nicht über diese Ebene verfügen, werden versuchen, die Fragen in Abschnitt 4 mit Beschreibungen der LLM-Observability zu beantworten. Achten Sie auf diese Ersetzung. Je direkter die Antwort, desto realer ist die Funktion.
Das zu erwartende Muster: Ein starker AI Gateway-Anbieter wird das MCP Gateway als separate Produktoberfläche mit eigenem Register, eigener RBAC-Zuordnung, eigenem Audit-Log-Schema und eigener Richtliniensprache beschreiben. Ein schwächerer Anbieter wird es als „erweiterte Observability“ über seinen bestehenden LLM-Observability-Stack beschreiben, was der Hinweis darauf ist, dass die Governance spärlich ist. Bewerten Sie Abschnitt 4 speziell; fassen Sie ihn nicht mit Abschnitt 3 zusammen.
Lesen Sie jede Antwort auf direkte Durchsetzungssprache hin.
Aktualisierungen dieser Regel sollten innerhalb von Sekunden an das Gateway übertragen werden (Konfigurations-Push, kein Re-Deployment). Wenn die Antwort des Anbieters lautet: „Richtlinien werden vom MCP-Server selbst ausgewertet“, handelt es sich nicht um eine vom Gateway durchgesetzte Richtlinie. Es ist eine vom Server durchgesetzte Richtlinie, und Sie müssen die Richtlinienparität über jeden MCP-Server im Katalog hinweg aufrechterhalten. Ein anderes Problem.
Das Gateway bewahrt die trace-id über jeden nachgelagerten Aufruf (LLM-Provider, MCP-Server, sekundärer Gateway-Hop) hinweg auf, indem es sie in ausgehende Header injiziert, und gibt jeden Aufruf als Span unter derselben trace-id aus. In Datadog, Grafana Tempo oder Jaeger ist das Ergebnis ein einziger Waterfall, der zeigt: Benutzeranfrage → LLM-Aufruf (claude-sonnet-4-6, 2,1s) → Tool-Aufruf (github.create_issue, 528ms) → LLM-Aufruf (Output-Formatter, 380ms) → Antwort. Ohne dies erscheint derselbe Ablauf als vier nicht zusammenhängende Einträge, und die Ursachenanalyse wird zur Ratenvermutung.

Abbildung 5. MCP Gateway-Architektur: ein Endpunkt für Entwickler-Tools und Agenten mit Auth-, Register-, Richtlinien- und Protokollierungsebenen zwischen Clients und MCP-Servern.
Der Unterschied zwischen einer AI-Plattform, die gut überwacht, und einer, die gut beobachtet, zeigt sich in den Fragen, die Ihr Finanzteam am Monatsende stellt. Das Monitoring teilt Ihnen mit, dass die Rechnung um 40 Prozent gestiegen ist. Observability teilt Ihnen mit, dass der Chatbot des Marketingteams vor drei Wochen in einer Schleife bei einem Kontextfenster-Sonderfall hängengeblieben ist, dass 70 Prozent des Anstiegs auf eine einzige Anwendung zurückzuführen sind und dass die außer Kontrolle geratenen Anfragen eine spezifische Signatur haben, die Sie an ein günstigeres Modell leiten können. Die erste Antwort macht die Finanzabteilung wütend. Die zweite Antwort macht die Finanzabteilung zum Verbündeten.
Derselbe Unterschied zeigt sich beim Debuggen von Agenten. Das Monitoring teilt Ihnen mit, dass eine Agentenaufgabe fehlgeschlagen ist. Observability teilt Ihnen mit, welcher LLM-Aufruf eine fehlerhafte Antwort zurückgegeben hat, welcher nachgelagerte Tool-Aufruf infolgedessen abgelaufen ist und auf welche Benutzeranfrage der Fehler zurückzuführen ist. Ohne korreliertes Tracing über die LLM- und MCP-Ebenen hinweg (Abschnitt 4, Frage 8) ist jeder Agentenfehler eine forensische Übung. Die folgenden Fragen zwingen den Anbieter zu beschreiben, was tatsächlich pro Aufruf erfasst wird, wie es abfragbar ist und wie die Daten die Plattform verlassen, wenn Ihr Finanzsystem sie benötigt.
Spezifische Details sind hier wichtig.
Dies macht die „Kostenzuordnung für Agenten“ zu einem Signal von Finanzqualität und nicht zu einer technischen Kuriosität.
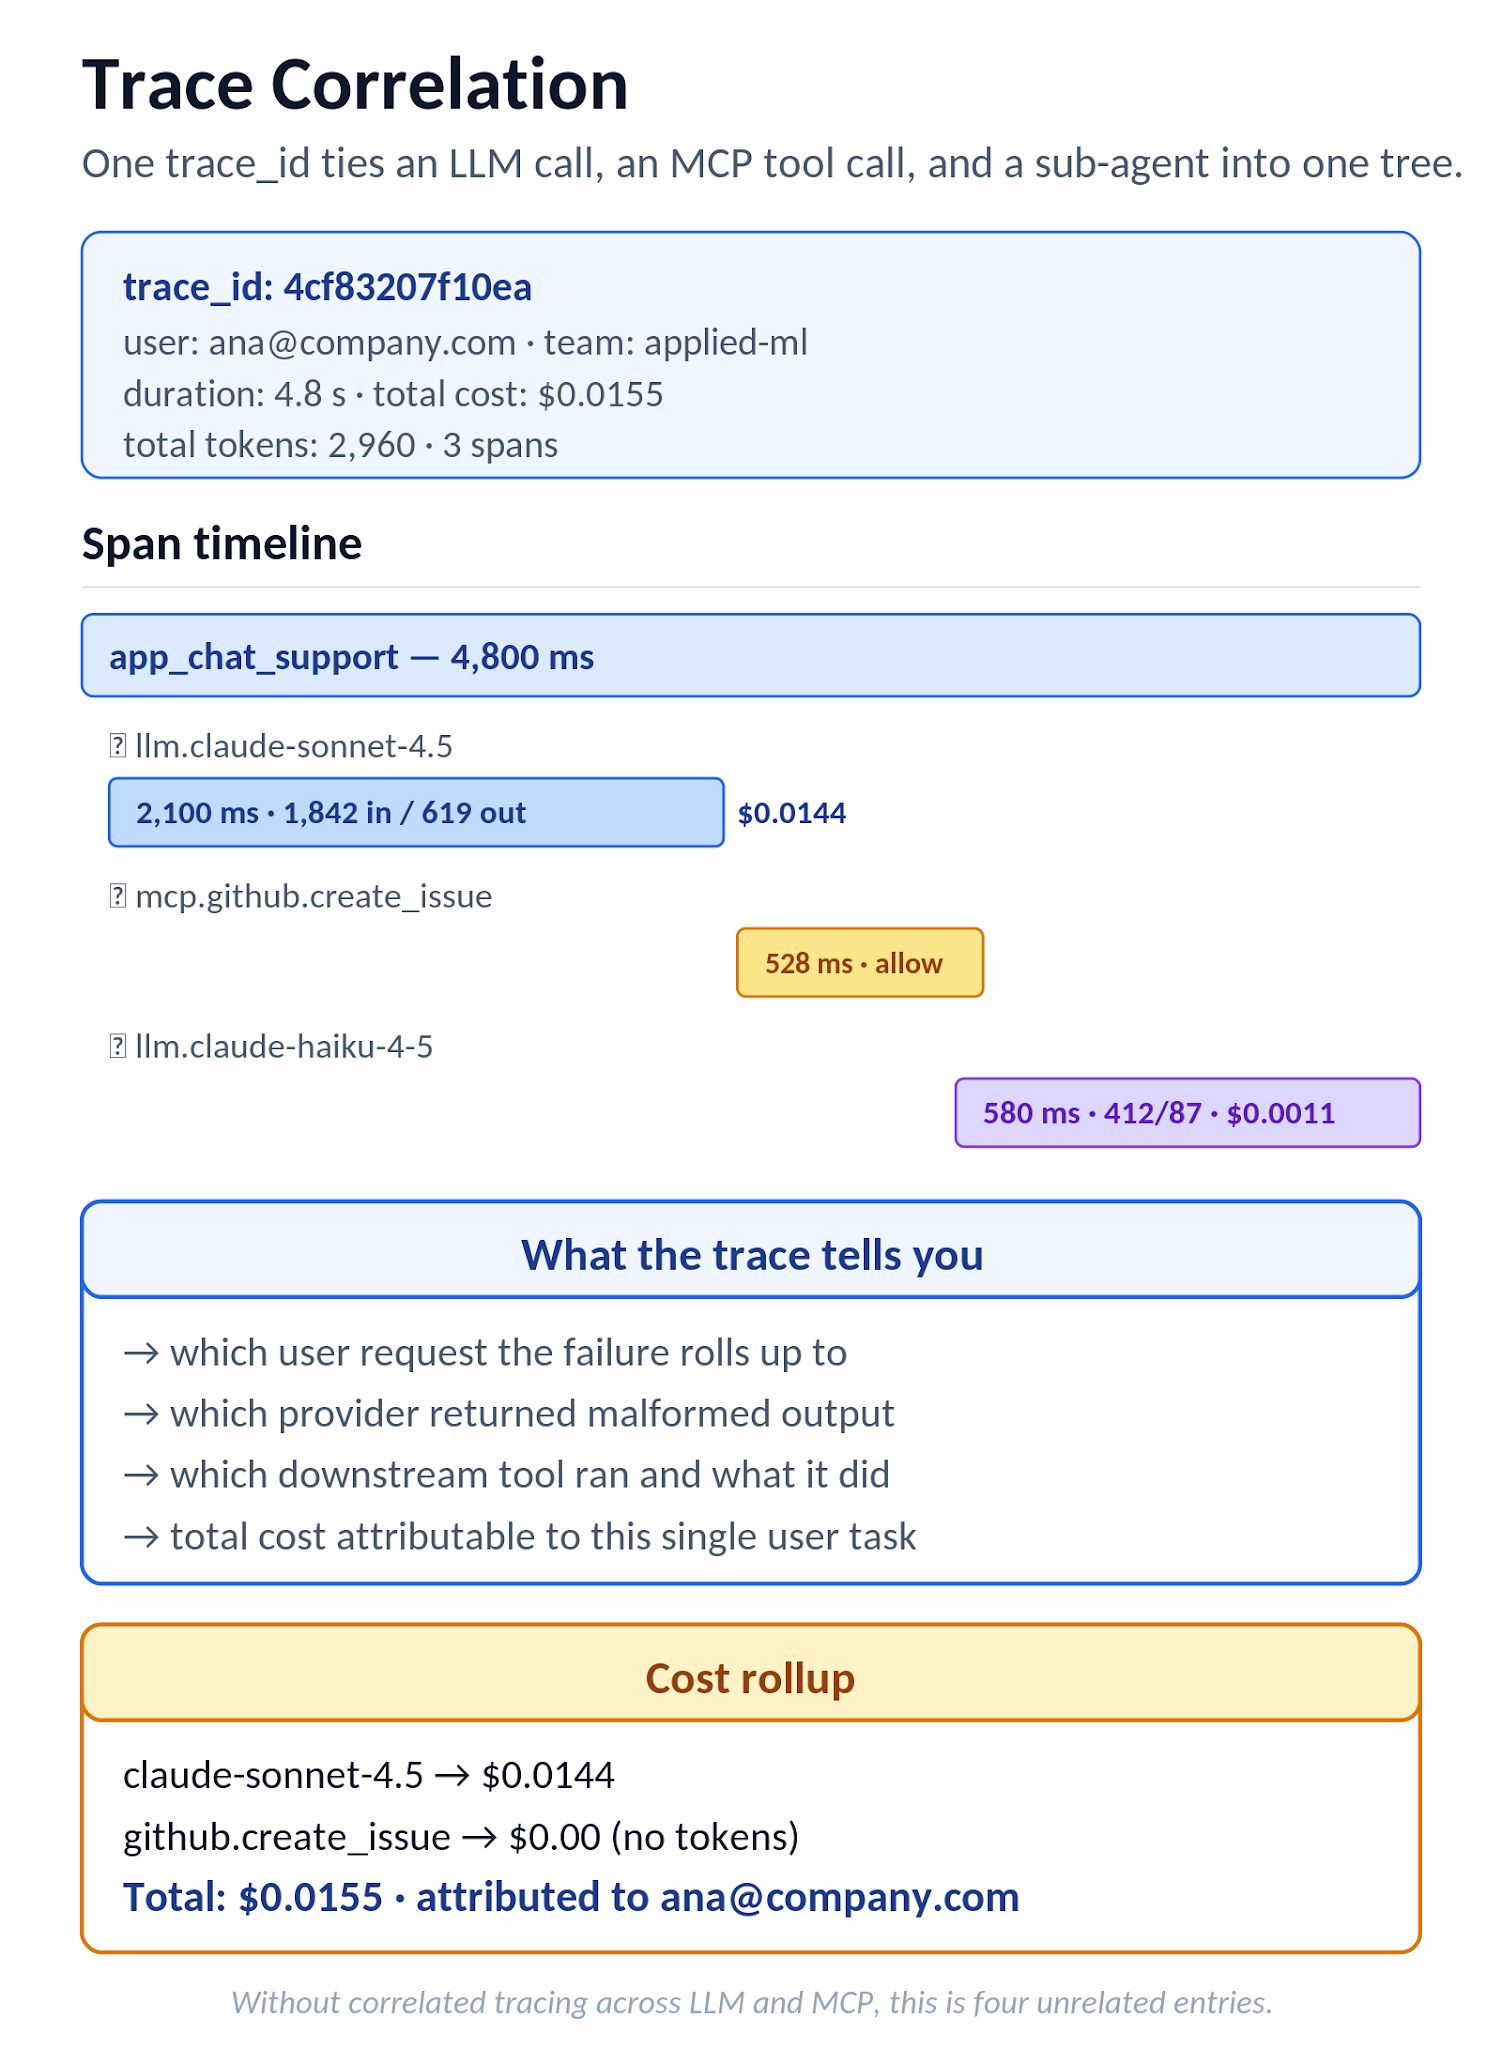
Abbildung 6. Trace-Waterfall-Ansicht einer einzelnen Agentenaufgabe: LLM-Aufruf, MCP-Tool-Aufruf und zweiter LLM-Aufruf, alle unter einer trace_id mit über Spans hinweg zusammengefassten Kosten.
Die Kosten einer Integrationslücke sind bei der Beschaffung selten sichtbar. Sie tauchen nach sechs Monaten auf, wenn der Zugriff eines gekündigten Mitarbeiters 48 Stunden dauert, um widerrufen zu werden, weil SCIM nicht real ist, wenn ein P1-Ausfall um 2 Uhr morgens eine automatische Antwort „wir antworten während der Geschäftszeiten“ erhält, weil das SLA aspirativ ist, wenn eine Okta-Gruppenumbenennung Rollenzuweisungen unterbricht, weil die SSO-Integration der Plattform nie mit Gruppen-Lebenszyklusereignissen getestet wurde. Jedes davon stellt endliche Engineering-Kosten dar, aber sie summieren sich zu der betrieblichen Steuer, die Plattform-Teams dazu bringt, bei der Verlängerung im dritten Jahr leise von ansonsten fähigen Produkten zu migrieren.
Abschnitt 6 bringt die betrieblichen Realitäten an die Oberfläche. Zwei diagnostische Muster: Jede „Ja“-Antwort auf eine Frage zur Protokollunterstützung verdient eine Nachfolgefrage dazu, welche Kunden dieses Protokoll heute in der Produktion ausführen im Vergleich zu welchen Kunden die ersten sein werden, die es ausprobieren. Und jede SLA-Zusage ohne explizit angehängte Gutschriften sollte als Marketingziel behandelt werden. Vertragliche SLAs gehen mit Gutschriften einher, da Anbieter das Risiko ihres Verfehlens einkalkulieren; aspirative SLAs werden vom Marketing geschrieben und tun dies nicht.
Lassen Sie sich die Gutschriften schriftlich geben.
Wenn die Plattform nur ein festes Claim-Format verarbeiten kann, wird die Integration mit allem außer Okta/Azure AD schmerzhaft. Die obige Flexibilität ist ein einmaliger Konfigurationsaufwand; ohne sie wird jedes IdP-Onboarding zu einem individuellen Projekt.
Wenn der Benutzer im IdP deprovisioniert wird, empfängt derselbe Endpunkt ein PATCH, das active auf false setzt, und die Plattform sollte den Zugriff des Benutzers umgehend widerrufen, anstatt erst beim nächsten Anmeldeversuch. Testen Sie dies im Proof-of-Concept: Deprovisionieren Sie einen Testbenutzer im IdP, versuchen Sie dann, ein noch gültiges Plattform-Token zu verwenden, und bestätigen Sie, dass der Deprovisionierungslebenszyklus Ende-zu-Ende funktioniert. Wenn die Plattform die Deprovisionierung erst bei der nächsten Benutzeranmeldung berücksichtigt, ist das eine Compliance-Lücke, die schriftlich festgehalten werden sollte.
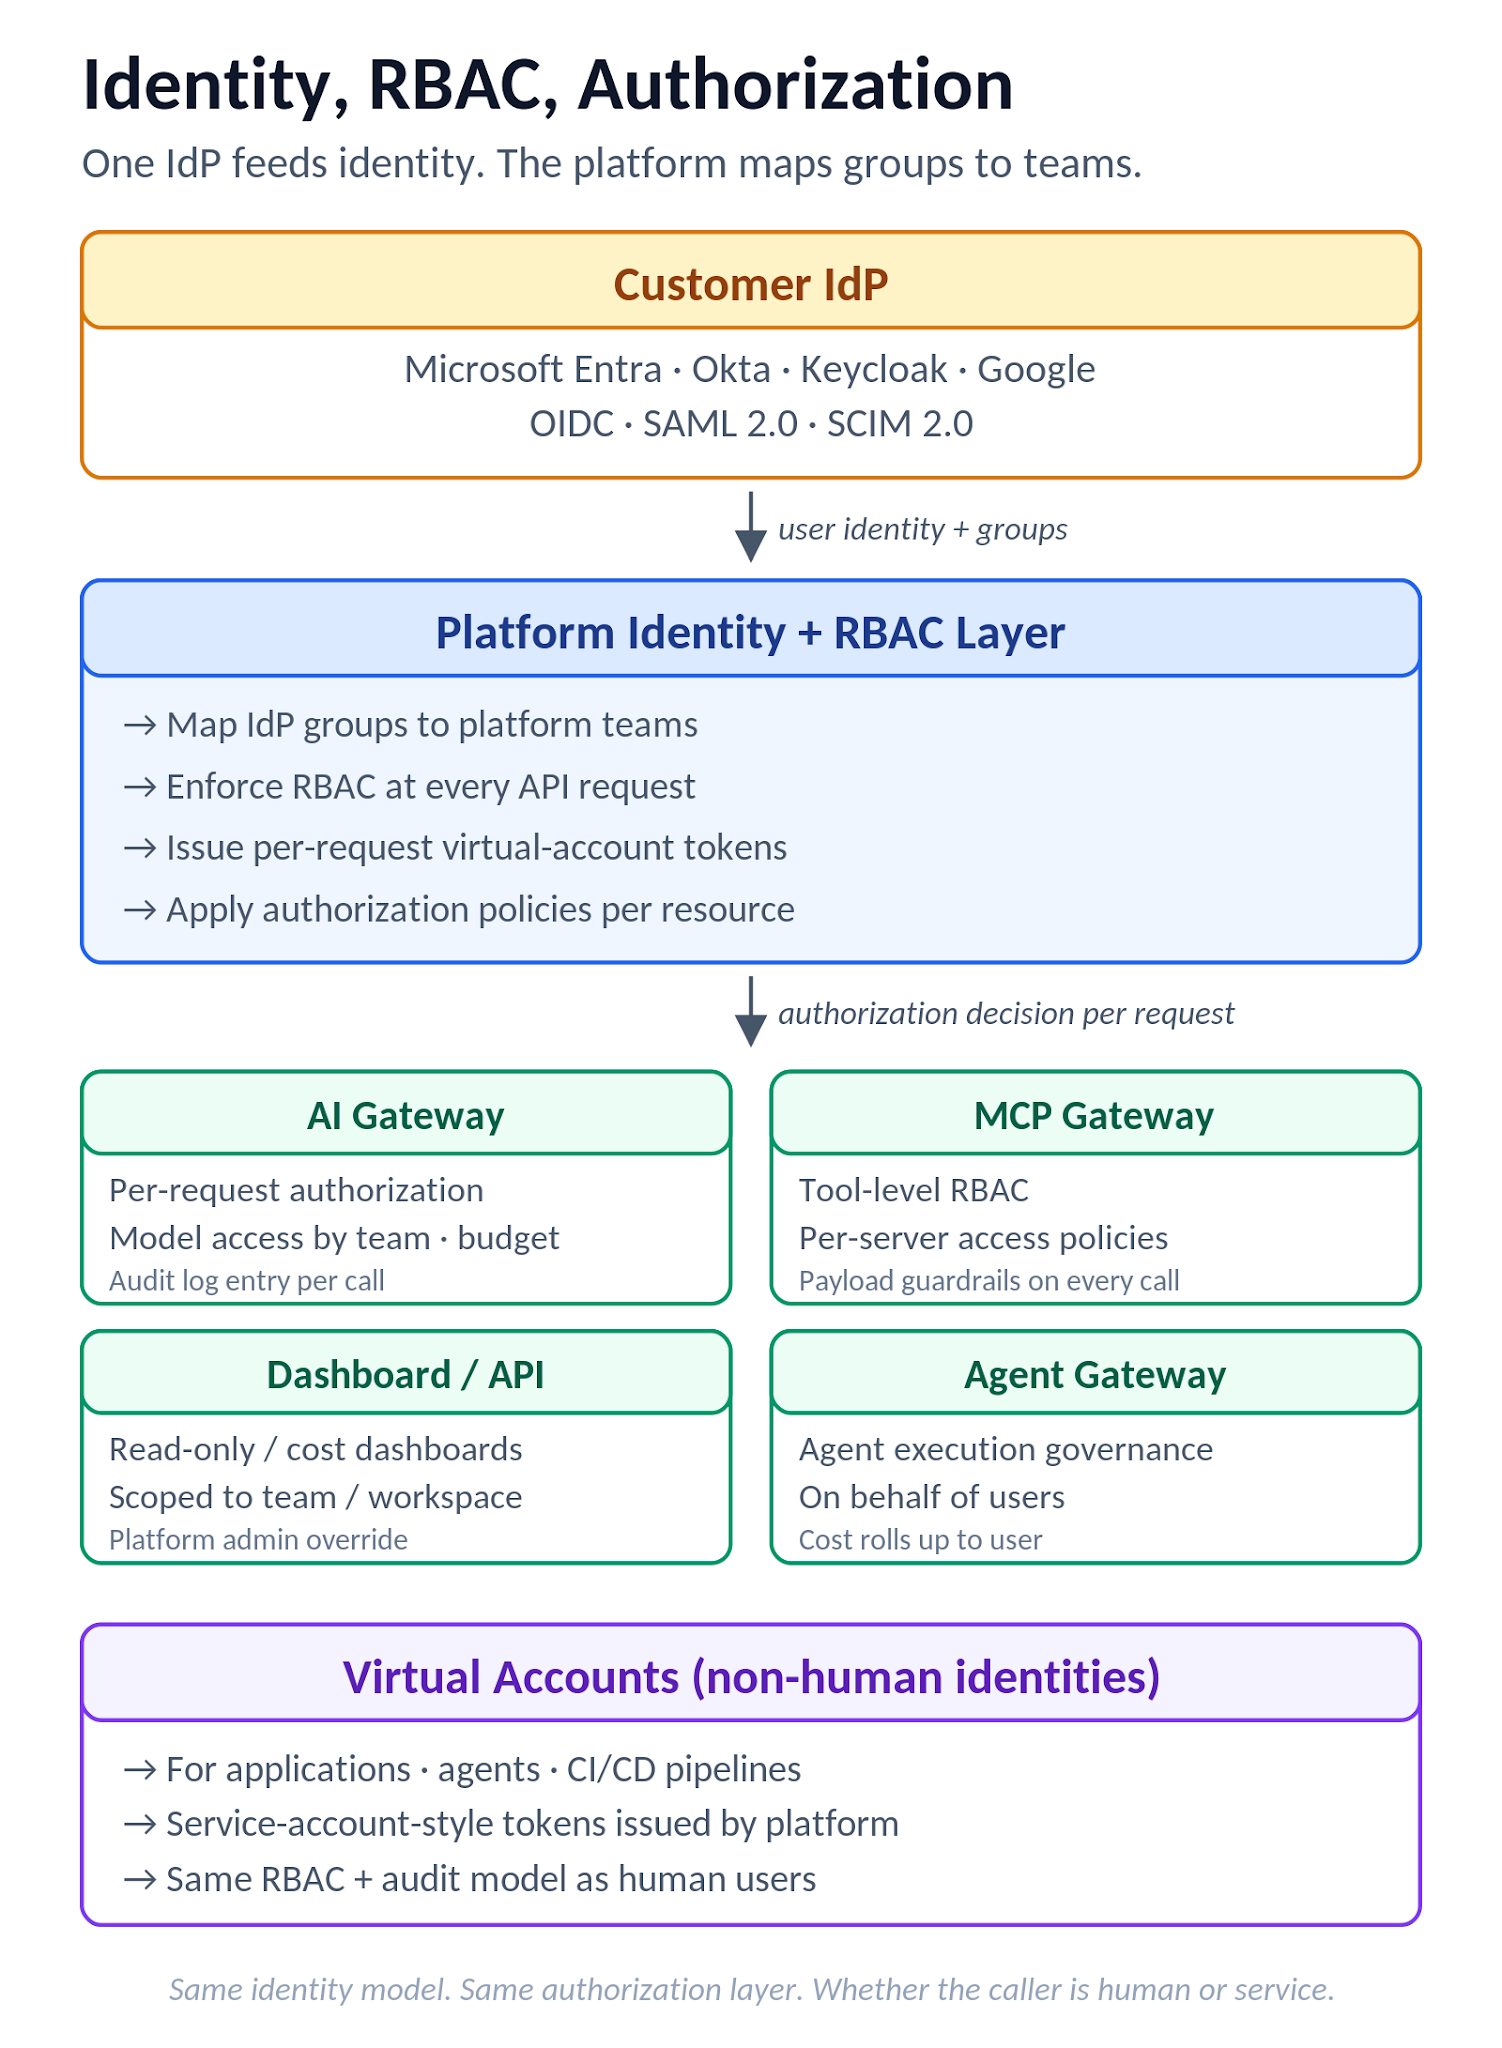
Abbildung 7. Identitäts- und RBAC-Ablauf: Der IdP liefert die Identität, die Plattform ordnet Gruppen Teams und Virtual Accounts zu, mit Durchsetzung am AI Gateway, MCP Gateway, Dashboard und Agent Gateway.
Achten Sie auf „Reaktionszeit“, die definiert ist als „eine automatische E-Mail, die den Eingang Ihres Tickets bestätigt“. Das ist keine Reaktion. Eine echte Reaktion ist ein Ingenieur, der sich mit dem Problem befasst. Und die Gutschriftsklausel ist der Test: Vertragliche SLAs beinhalten Gutschriften, Marketing-SLAs nicht.
Das Solutions-Team von TrueFoundry behandelt diese RFP als formelle Evaluierung, nicht als Vertriebsobjekt. Jede Frage erhält eine schriftliche Antwort mit Nachweisen: SOC 2 Type II-Berichte, BAA-Dokumentation für Healthcare-Bereitstellungen, Zusammenfassungen von Penetrationstests, Referenzarchitekturen, Beispiel-Audit-Logs, Kundenreferenzen. Das Ergebnis ist ein Dokument, das Ihre Sicherheits-, Beschaffungs- und Plattform-Teams nutzen, um eine Entscheidung zu treffen, ohne ein Discovery-Gespräch zu benötigen, um Lücken zu füllen.
Die Architektur hinter den Antworten entspricht direkt der Abschnittsstruktur dieser Vorlage, weshalb sich die meisten Fragen sauber auflösen lassen. Ein Überblick:
Das Bereitstellungsmodell ist Split-Plane. Die Control Plane ist das Orchestrierungsgehirn, das Konfiguration, RBAC und Dashboards hostet. Compute Planes verbinden sich über einen Agenten zurück und hosten die tatsächlichen Workloads, einschließlich AI Gateway, MCP Gateway und allen bereitgestellten Anwendungen oder selbst gehosteten Modellen. Compute Planes können in Cloud-Konten von Kunden (AWS, GCP, Azure) oder On-Prem Kubernetes ausgeführt werden, und mehrere Compute Planes lassen sich an eine Control Plane anschließen, um Multi-Environment-Betrieb unter einer einzigen Steuerungsoberfläche zu ermöglichen. Das AI Gateway kann in der Kundeninfrastruktur selbst gehostet werden (die Bereitstellungsoptionen sind separat dokumentiert), um Datenresidenz und Souveränitätskontrollen zu gewährleisten. Audit-Logs und Tracing-Daten werden über Gateway-Anforderungsprotokollierungs- und Tracing-Projekte gespeichert, wobei RBAC den Zugriff auf Traces und Logs steuert. Die Split-Plane-Architektur sorgt dafür, dass dieselbe Datenresidenzhaltung über SaaS-, Single-Cloud-, Multi-Cloud- und selbst gehostete Bereitstellungen hinweg verfügbar ist, anstatt jede als separates Produkt mit separaten Steuerungshaltungen zu behandeln.
Datensouveränität ist die Architektur, keine Marketingzeile.
Authentifizierung nutzt Enterprise-SSO über OIDC oder SAML 2.0 mit optionaler IdP-Token-Validierung direkt am AI Gateway für die API-Zugriffskontrolle. Gängige IdPs (Microsoft Entra ID, Okta, Keycloak, Google) werden unterstützt, wobei Identity-Claims und Gruppenmitgliedschaften vom IdP auf TrueFoundry-Teams abgebildet werden, um RBAC im großen Maßstab zu steuern. SCIM-Provisionierung wird bei allen SSO-Konfigurationen unterstützt – sowohl OIDC als auch SAML –, sodass die Deprovisionierung im IdP direkt übertragen wird, anstatt auf die nächste Benutzeranmeldung zu warten. RBAC arbeitet auf Tenant-Ebene (Admin-/Member-Rollen) plus benutzerdefinierten Rollen mit feingliedrigen Berechtigungen über Benutzer, Teams, Cluster, Workspaces, Deployments, AI Gateway Provider-Accounts, MCP-Server und Tracing-Projekte hinweg. Nicht-menschliche Identitäten (Anwendungen, Agenten) erhalten Virtual Accounts mit Service-Account-ähnlichen Tokens, und die Autorisierung pro Anfrage an den AI Gateway-Grenzen (Modelle, Agenten, MCP-Server und Tools) unterstützt Least-Privilege-Muster. Provider-Keys lassen sich in kundenverwaltete Secret-Stores integrieren; die Gateway-Authentifizierung ist dem IdP übergelagert, anstatt ihn zu ersetzen, sodass MFA und Conditional Access weiterhin vom IdP des Kunden durchgesetzt werden.
Das AI Gateway routet über 1.000+ LLMs hinweg über einen einzigen OpenAI-kompatiblen Endpunkt: OpenAI, Anthropic (direkt und über AWS Bedrock), Azure OpenAI, GCP Vertex AI, Groq, Mistral und selbstgehostete Modelle, die über vLLM, TGI oder Triton bereitgestellt werden. Das Routing wird über Virtual Models konfiguriert, die eine einzige Modellschnittstelle bereitstellen und Load Balancing oder Failover über mehrere zugrundeliegende Provider und Modelle hinweg durchführen. TrueFailover legt ein ausfall- und degradationsbewusstes Routing darüber, mit integrierter Multi-Regionen- und Multi-Cloud-Resilienz. Strikte Token- und Anfragelimits pro Benutzer, Team oder Virtual Account geben eine strukturierte Ablehnung zurück, wenn ein Team sein Budget erreicht, anstatt nur eine weiche Warnung auszugeben, während die Anfrage trotzdem durchgeht. Das Provider-Fallback erfolgt automatisch, und die Latenzverzögerung wird als separate Metrik für den Aufruf erfasst, anstatt in der Gesamtlatenz unterzugehen. Semantisches Caching nutzt Embeddings und Cosine-Similarity mit konfigurierbarem Schwellenwert und TTL; die Dokumentation nennt bis zu ~20-fache Latenzverbesserungen für wiederholte oder ähnliche Anfragen. Guardrails sind regelbasiert (Ziel nach Modell, Benutzer oder Metadaten), jede kann validieren (blockieren) oder mutieren (umschreiben/anonymisieren), und Bring-Your-Own-Guardrail wird über einen benutzerdefinierten Guardrail-Server unter Verwendung einer FastAPI-Vorlage unterstützt.
Routing ist hier das Produkt, nicht ein Konfigurations-Flag.
Der MCP- und Agenten-Stack ist der entscheidende Differenzierungsfaktor. TrueFoundry betreibt ein natives MCP Gateway und eine MCP Registry, die MCP-Server und Tools zentral registrieren, entdecken und über gesteuerte Zugriffskontrollen und Enterprise-Auth-Flows sicher verbinden. Moderne MCP-Transporte wie Streamable HTTP für Proxy-Verbindungen werden unterstützt, und die Protokollebene nutzt Standard-JSON-RPC-Messaging gemäß der MCP-Spezifikation. Die Authentifizierung ist vielschichtig: Gateway-Authentifizierung, Zugriffskontrolle auf MCP-Server sowie Server- oder Tool-spezifische Auth (einschließlich OAuth-basierter Muster, die für Enterprise-MCP-Server dokumentiert sind). Zentrale Konfiguration bedeutet, dass Entwickler-Tools mit einem einzigen Gateway-Endpunkt kommunizieren, anstatt dass jeder Entwickler seine eigenen MCP-Verbindungen einrichtet – genau das Shadow-Tooling-Muster, das die Registry verhindern soll. Der Agent Hub bietet organisatorische Katalogisierung und Orchestrierung für komplexe sowie bereits bestehende Agenten, und das Agent Gateway stellt die Enterprise-Governance-Ebene (sicherer Tool-Zugriff, Observability, Kostenkontrolle) für den Betrieb dieser Agenten in der Produktion bereit. Dieselbe Identität, die den LLM-Zugriff steuert, steuert auch den Tool-Zugriff, sodass die Autorisierung für beides in einer einzigen IdP-Konfiguration liegt. Und derselbe Trace-Kontext, der eine mehrstufige LLM-Agenten-Aufgabe zusammenhält, verknüpft auch die darunter liegenden MCP-Aufrufe – was eine prozessbezogene Kostenzuordnung und End-to-End-Debugging von der Theorie in die Praxis umsetzt.
Observability nutzt Gateway-Request-Logging mit Traces. Token-Anzahlen, Kosten, Latenz (TTFT und Gesamt), Guardrail-Entscheidungen, Policy-Entscheidungen sowie Team- und Anwendungszuordnungen werden pro Aufruf erfasst, als Traces gespeichert und über Tracing-Projekte mit eigenem RBAC zugänglich gemacht. Der Telemetrie-Export basiert auf Standards: OpenTelemetry-Datenexport sowie Log- und Trace-Export an externe Systeme wie Grafana, Datadog und Prometheus, sodass Kunden ihre bestehenden Observability-Stacks einbinden können, anstatt ein proprietäres System erlernen zu müssen. Kostendashboards arbeiten in Echtzeit und können über Lese-RBAC für Teamleiter freigegeben werden. Derselbe Logging-/Trace-Speicher erstellt zudem den auditierbaren Datensatz von Prompt-Injection-Versuchen, Policy-Treffern und Missbrauchsmustern, den Kunden für das zukünftige Guardrail-Tuning analysieren können.
Ihr bestehender Observability-Stack bleibt Ihr bestehender Observability-Stack.
Der Nachweis der Leistungsfähigkeit hinter alldem: 10 Milliarden verarbeitete Anfragen pro Monat über die gesamte Kundenbasis hinweg, 1.000+ von der Plattform verwaltete Kubernetes-Cluster, Gateway-seitiger Overhead unter 10ms p95 (TTFT) und 350+ dauerhafte RPS auf einem einzelnen vCPU. Zu den Kunden im Produktionsbetrieb gehören Resmed, Siemens Healthineers, Automation Anywhere, Zscaler und Nvidia. Die Series A wurde im Februar 2025 von Intel Capital angeführt, womit sich die Gesamtfinanzierung auf rund 21 Millionen US-Dollar beläuft, unter Beteiligung von Peak XV Partners (Surge), Eniac Ventures und Jump Capital.
Produktionsmaßstab, kein Pilotmaßstab.
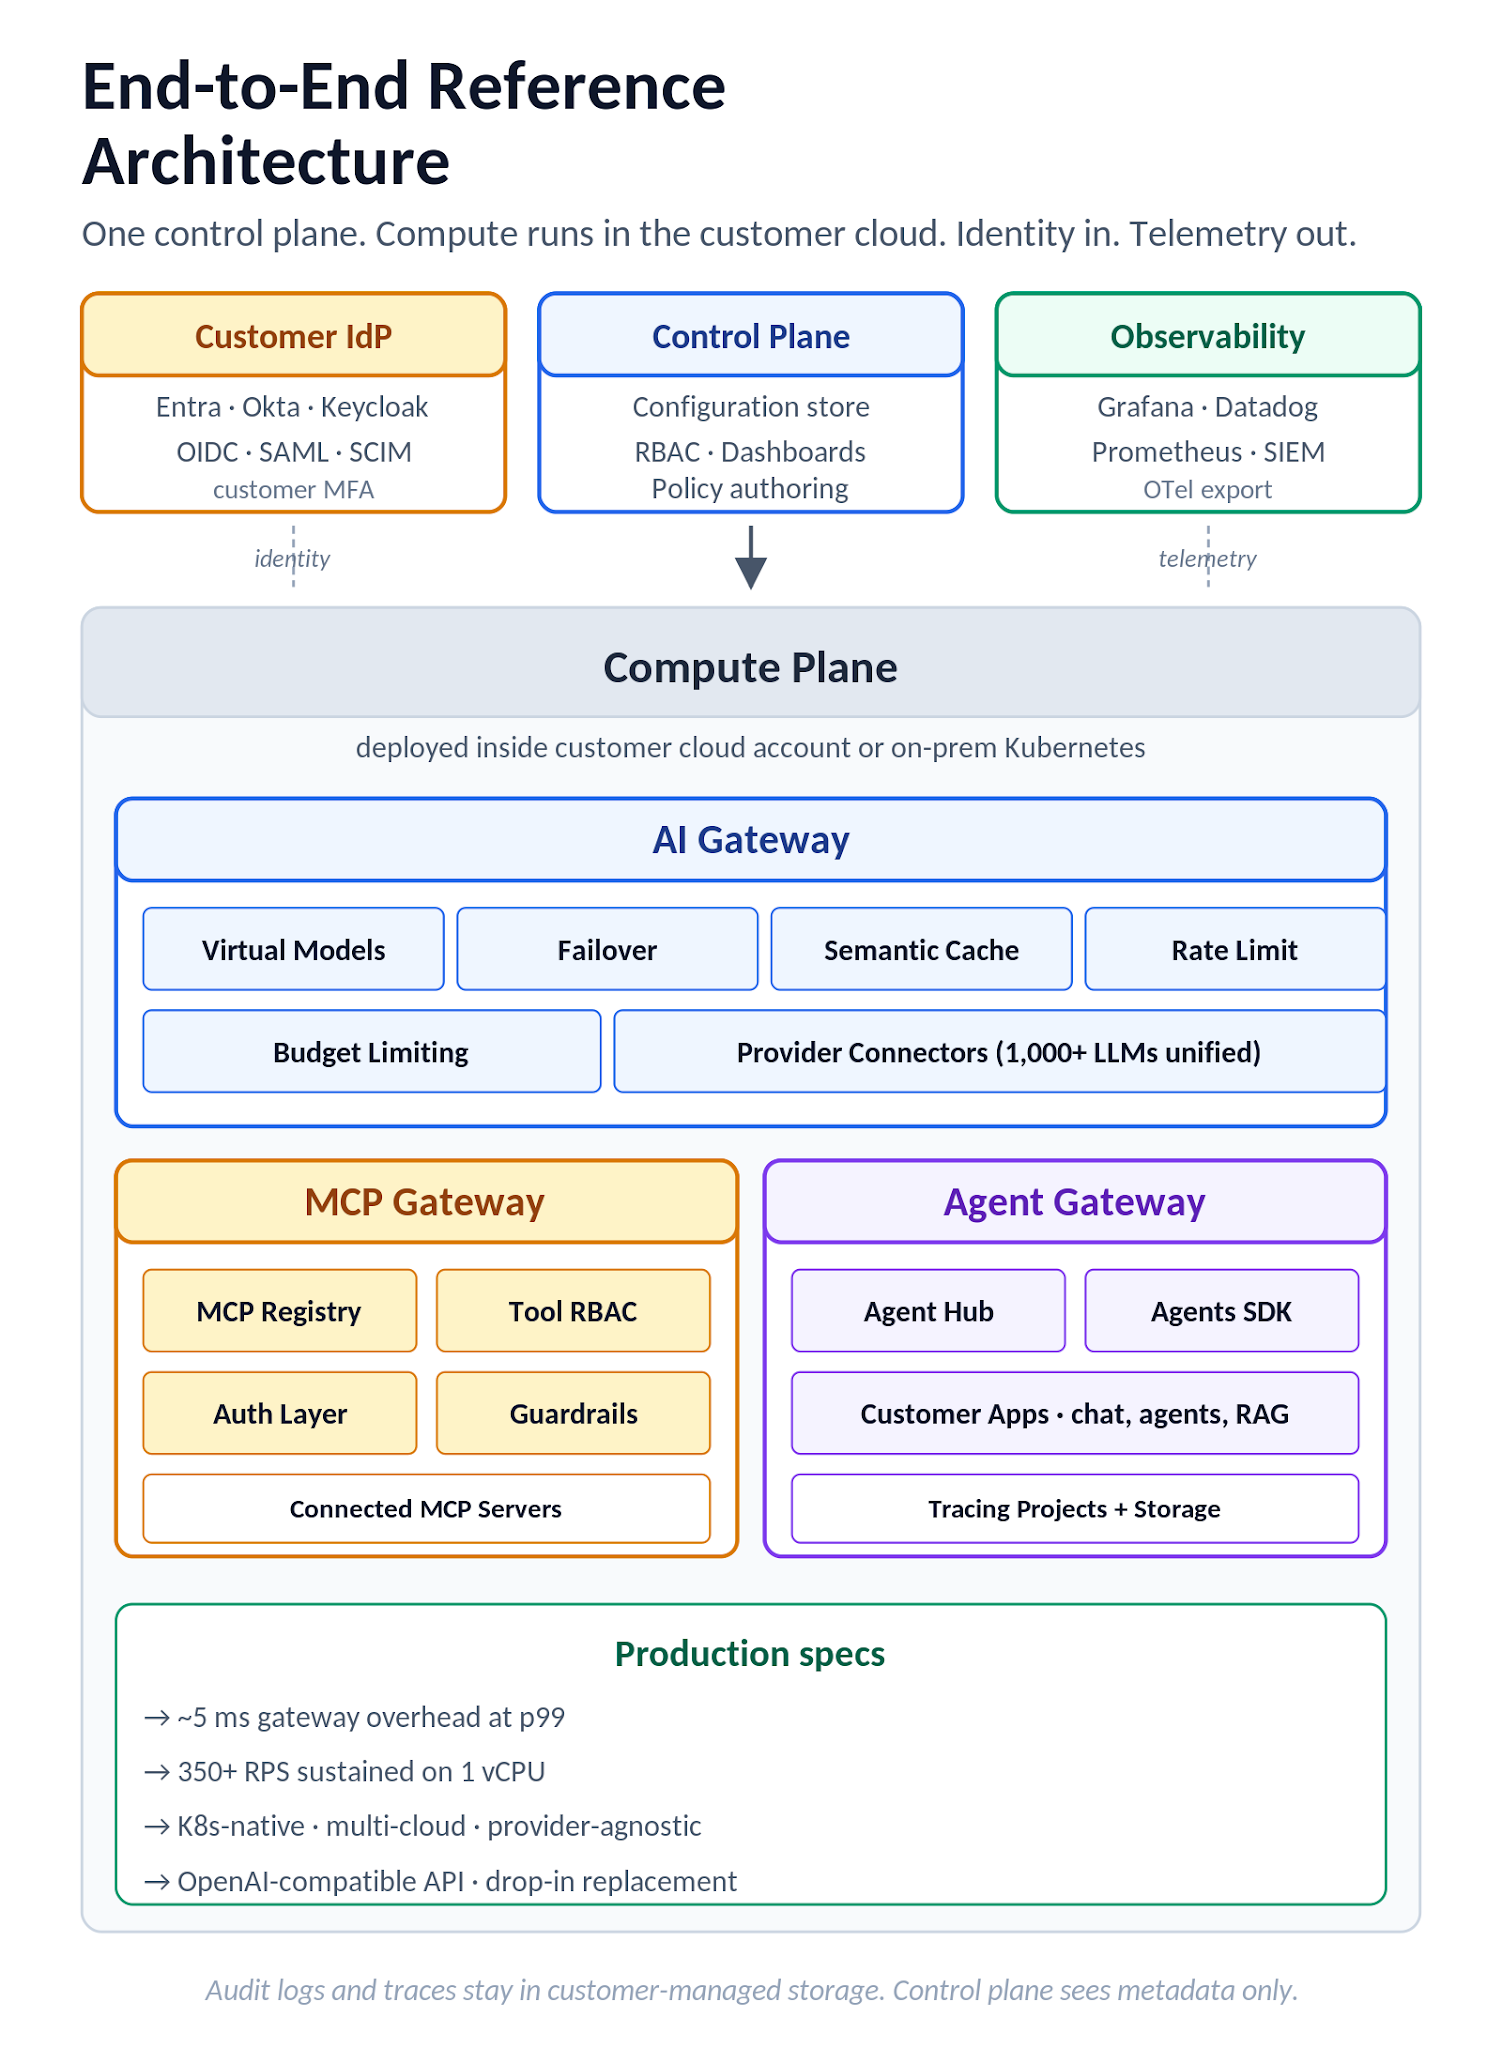
Abbildung 8. TrueFoundry End-to-End-Referenzarchitektur: Control Plane, Compute Plane (mit AI Gateway, MCP Gateway, Agent Gateway und Kunden-Apps), Kunden-IdP und Observability-Ziele.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet





