


November 20, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Published: November 20, 2026

Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Bifrost taucht im Jahr 2026 auf fast jeder Shortlist für „AI Gateways“ auf, meist neben den Begriffen am schnellsten und Open Source. Keine der beiden Behauptungen hält einer direkten Überprüfung der herstellereigenen Zahlen stand, weshalb wir es auf die harte Tour getestet haben: Selbst gebenchmarkt auf einer isolierten Testumgebung mit 1 vCPU.
Dieser Artikel behandelt, inwieweit die Leistungsversprechen von Bifrost unter realen Messbedingungen bestand haben — auf einem festen Teststand mit 1 vCPU / 2 GB RAM, demselben Standard, an den wir jedes Gateway in diesem Vergleich binden.
Dies ist der Abschnitt, dem sich jede Behauptung bezüglich des „schnellsten Gateways“ stellen muss.
Die Zahl des Herstellers: ~5.000 RPS bei ~11 Mikrosekunden durchschnittlichem Overhead — auf einer t3.xlarge-Instanz (4 vCPU) gegen einen gemockten Upstream. Bevor Sie das mit irgendetwas vergleichen, lesen Sie, was dabei tatsächlich gemessen wird. Laut Bifrosts eigener Quelle wird der Mikrosekunden-Wert ohne HTTP-Request-Handling und JSON-Marshalling ermittelt — es ist also die Zeit, die innerhalb der internen Pipeline des Gateways verbracht wird, nicht die Netto-Latenz, die der Anfrage eines Aufrufers hinzugefügt wird. Dieselbe Quelle gibt für eine t3.medium-Instanz 59 µs an, d. h. die Leistung verschlechtert sich auf einer kleineren Instanz bereits um das Fünffache. Zudem handelt es sich um einen Durchschnittswert, nicht um ein Perzentil, gemessen auf der vierfachen Rechenleistung, die die meisten Teams einem Gateway-Container tatsächlich zuweisen.
Nichts davon macht die Zahl unseriös; sie beantwortet lediglich eine andere Frage als „Wie sieht meine p99-Latenz aus?“. Alles Folgende ist die andere Zahl: die zusätzliche End-to-End-Latenz für reale, dokumentierte Nutzlastgrößen, einschließlich Marshalling und HTTP — der vollständige Aufpreis, den ein Aufrufer dafür zahlt, dass das Gateway im Pfad liegt. Mikrosekunden und Millisekunden sind hier beide korrekt, da sie unterschiedliche Dinge messen.
Wir haben einen festen Teststand aufgebaut — 1 vCPU, 2 GB RAM, Open-Loop-Last, derselbe Standard, an den wir jedes Gateway in diesem Vergleich binden — und Bifrost direkt über drei Nutzlastgrößen hinweg gemessen: klein (200 Input- / 100 Output-Token), mittel (2.000/500) und groß (20.000/1.000). Der Mock-Upstream hinter Bifrost war ebenfalls fixiert, sodass jede Verlangsamung auf Bifrost zurückzuführen ist und nicht auf ein fehlerhaftes Test-Double: 50 ms „Denkzeit“ + 50 ms bis zum ersten Token bei Nicht-Streaming-Aufrufen und eine feste Stream-Dauer von 500 ms bei Streaming-Aufrufen — das sind die Untergrenzen von ~55 ms und ~530–627 ms, die Sie in den folgenden Diagrammen sehen werden und die bei jeder Nutzlastgröße vorhanden sind.
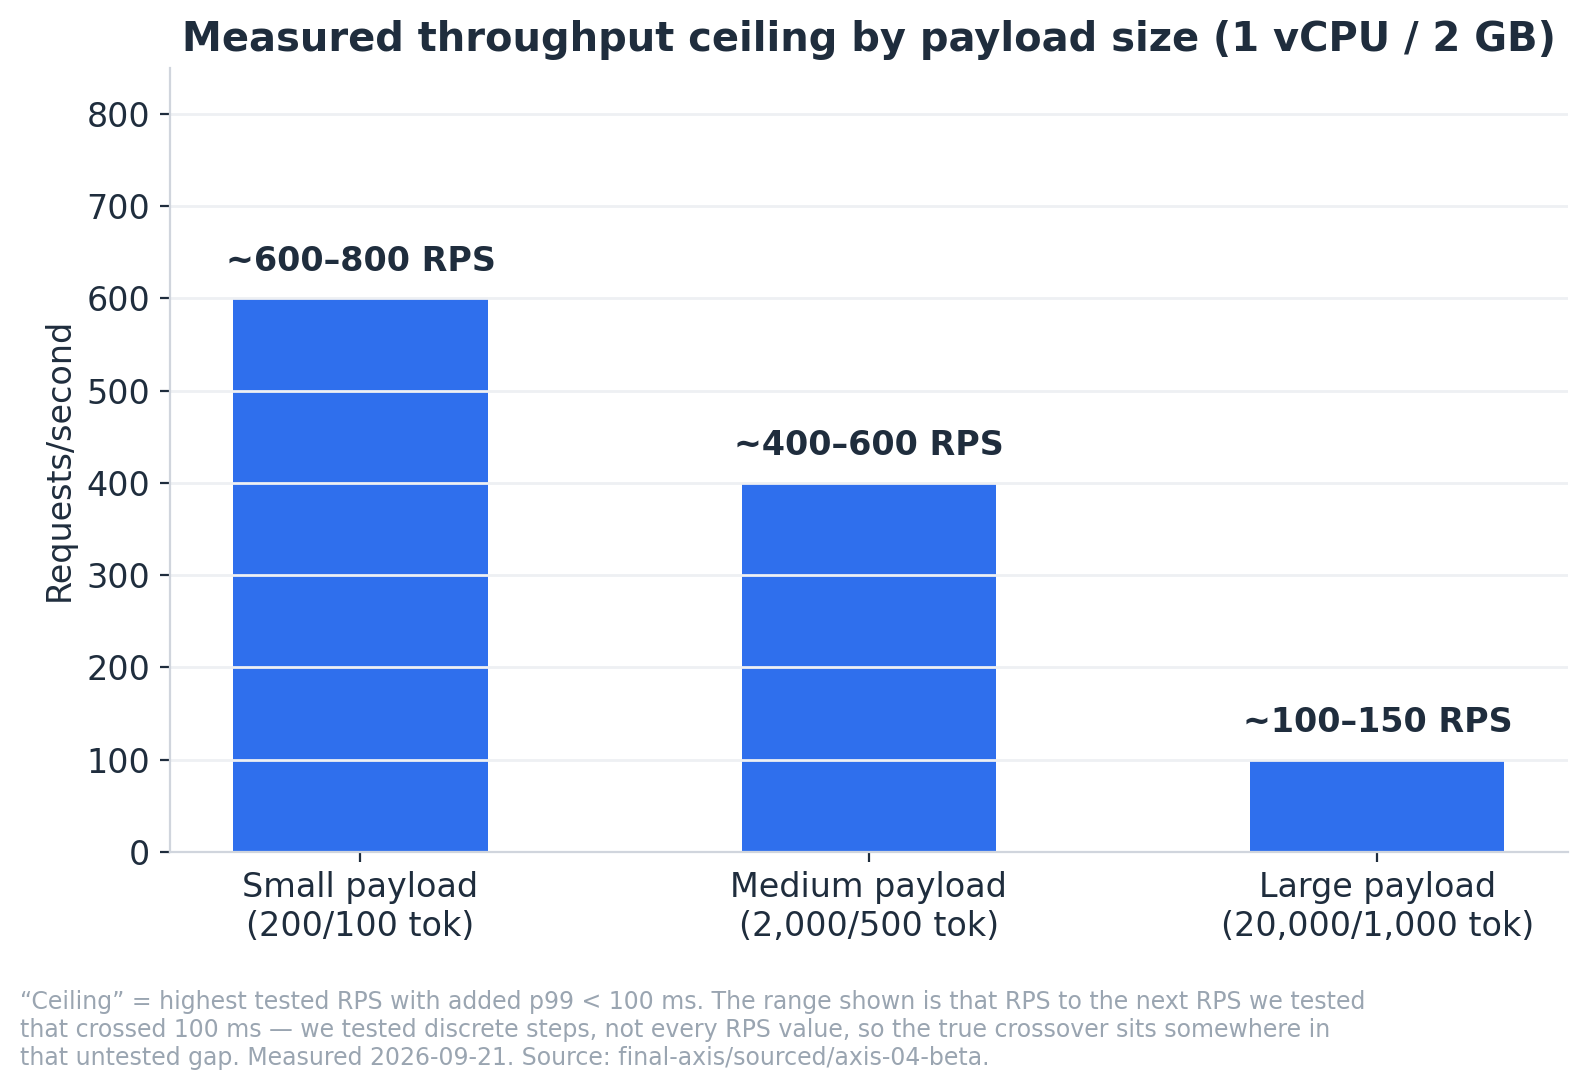
Reale Durchsatzgrenzen bei einem Budget von 100 ms zusätzlicher Latenz: ~600–800 RPS für kleine Nutzlasten, ~400–600 für mittlere, ~100–150 für große. Das sind bewusst Bereiche und keine exakten Zahlen — wir haben diskrete RPS-Stufen getestet, nicht jeden einzelnen Wert. Jede Obergrenze ist also im Grunde „die letzte RPS, von der wir bestätigt haben, dass sie in Ordnung war, bis zur nächsten, von der wir bestätigt haben, dass sie es nicht war“. Unterhalb des unteren Endes dieser Bereiche zahlt die mediane Anfrage 2–6 ms für das Gateway. Dieser Medianwert ist die freundlichste Zahl in diesem Abschnitt und die unbrauchbarste für die Kapazitätsplanung: Er verändert sich unter Last kaum — 2,1 bis 3,1 ms für kleine Nutzlasten über eine 60-fache Spanne des angebotenen Datenverkehrs — er bleibt also beruhigend niedrig bis genau zu dem Punkt, an dem das Gateway ausfällt. Die Zahl, die sich tatsächlich verändert, ist die p99-Latenz. Die zusätzliche p99-Latenz steigt von +5,6 ms (klein), +7,5 ms (mittel) und +15,2 ms (groß) bei 10 RPS auf +60 ms für kleine Nutzlasten bei 600 RPS, +75 ms für mittlere bei 400 und +41 ms für große bei nur 100 — und überschreitet dann in allen drei Fällen bei der jeweils nächsten von uns getesteten Stufe das 100-ms-Budget. Oberhalb des oberen Endes verschlechtert sich keine der drei Nutzlastgrößen ordnungsgemäß, und jede bricht auf unterschiedliche Weise ein. Hier ist jede Nutzlast im Vergleich, Gateway gegen seine eigene reale Direkt-zum-Mock-Messung (keine einzelne ungenaue Baseline, die über alle Größen hinweg geteilt wird — kleine, mittlere und große Nutzlasten haben jeweils eine tatsächlich unterschiedliche Untergrenze von ~55–62 ms bei direkter Messung, und das Diagramm zeigt die tatsächliche Zahl für jede):
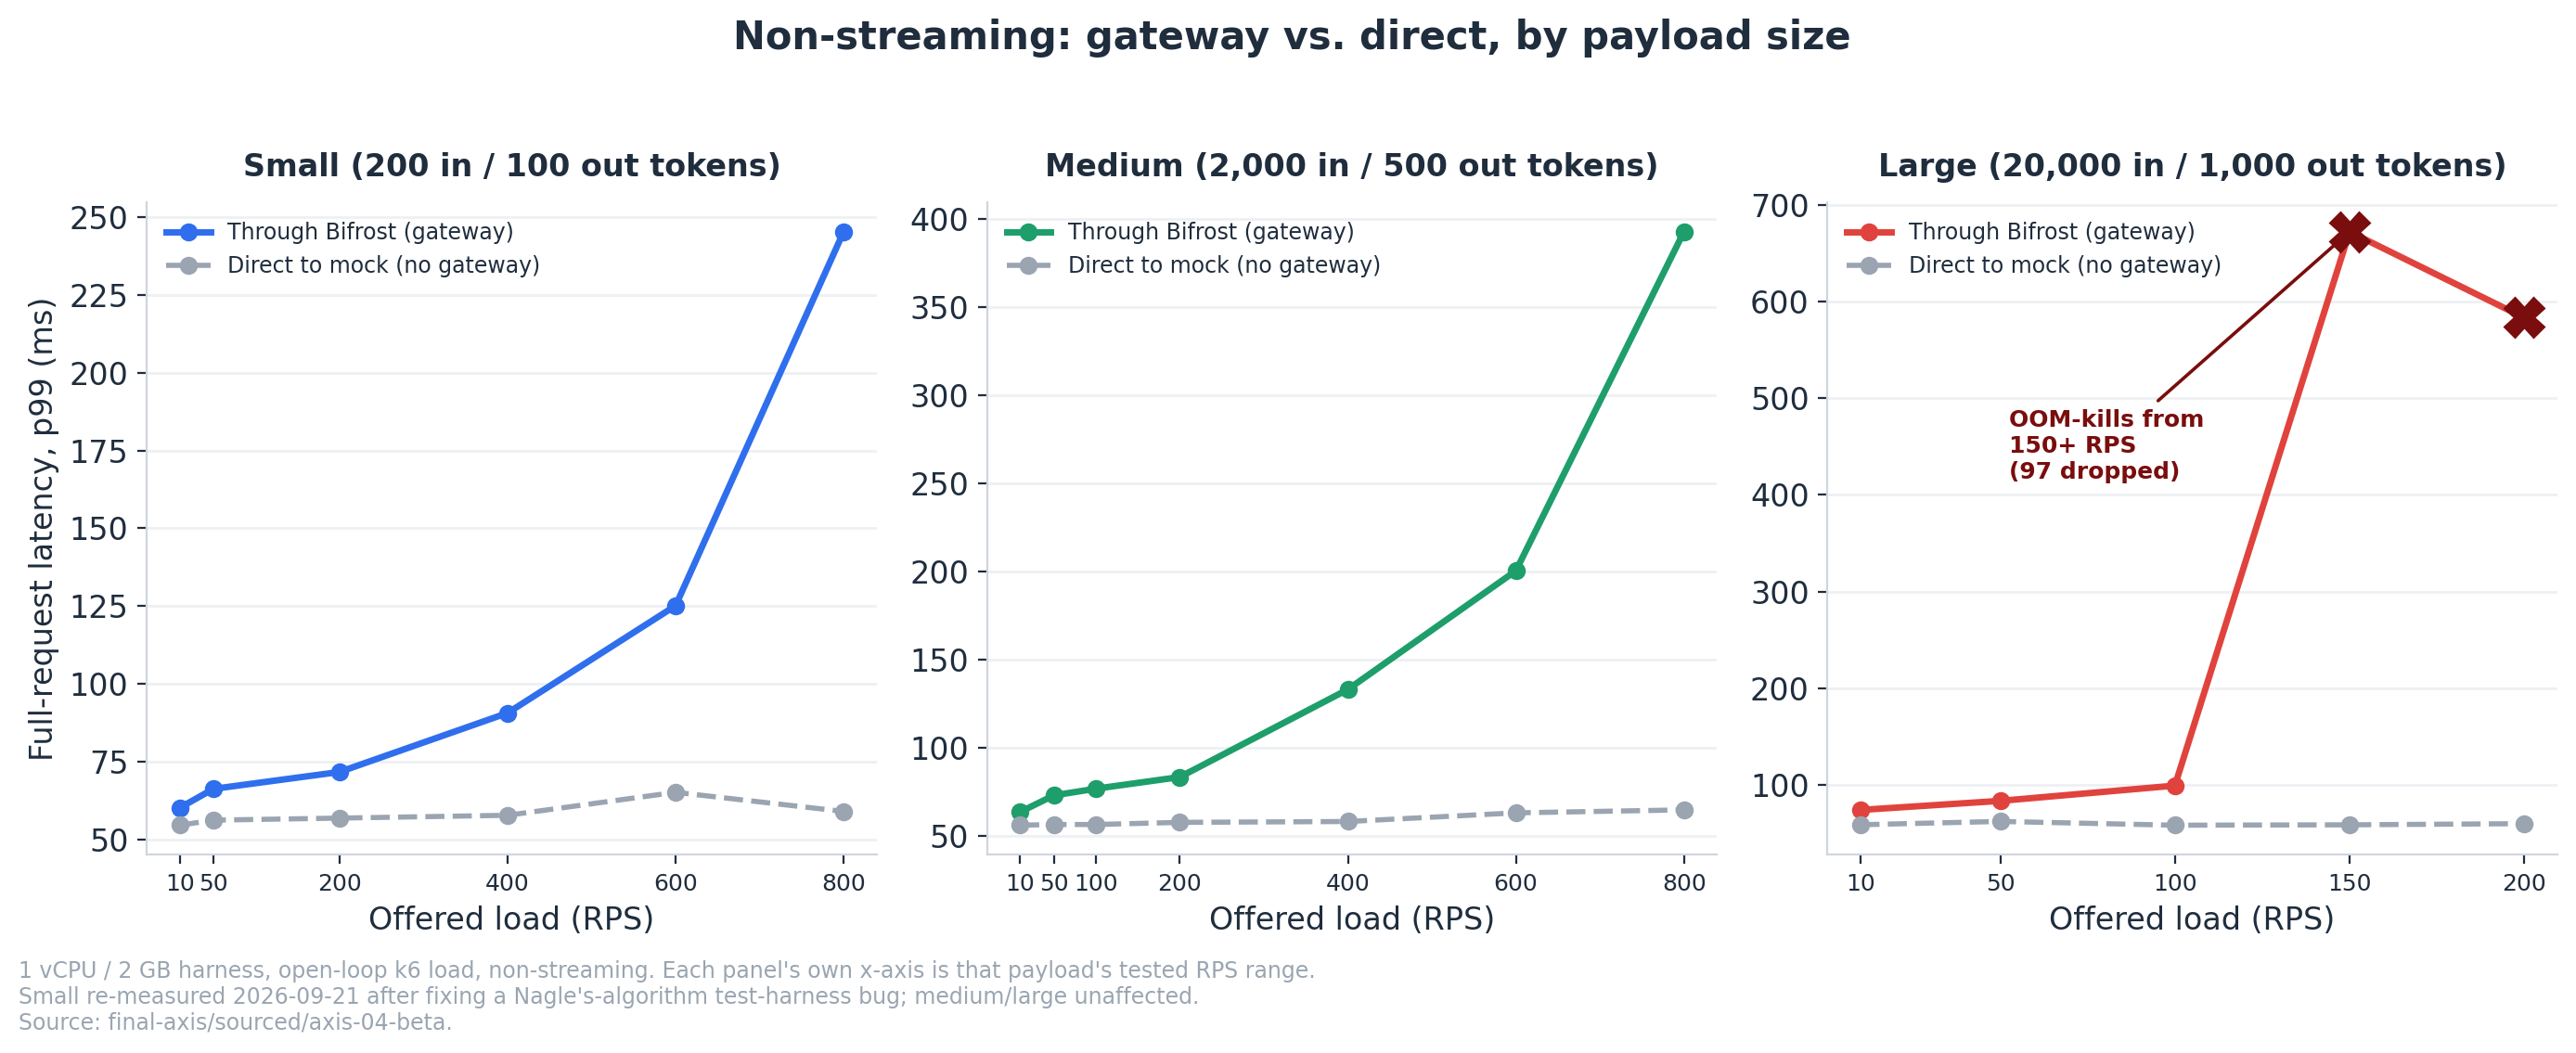
Kleine und mittlere Nutzlasten folgen demselben Verlauf — flach, gefolgt von einem steigenden p99-Tail — nur bei unterschiedlichen RPS. Der Anstieg bei kleinen Nutzlasten beginnt um 400–600 RPS; bei mittleren Nutzlasten beginnt er pro Anfrage früher, aber die härtere Grenze liegt weiter außen (400+ RPS), weil der Input von 2.000 Token die Kosten pro Anfrage durchgehend höher hält. Große Nutzlasten steigen überhaupt nicht allmählich an: Sie verlaufen von 10 bis 100 RPS flach und stürzen dann bei 150 RPS extrem ab, wo der Pod mitten im Durchlauf durch OOM (Out of Memory) beendet wird (61 verworfene Anfragen bei 150 RPS, 97 weitere bei 200). Das ist kein Warteschlangen-Knick wie bei kleinen/mittleren Nutzlasten — es ist eine harte Ressourcengrenze, die sich eher als nahezu vertikaler Sprung statt als Kurve zeigt.
Streaming stößt auf dieselbe Grenze, nur schneller, weil jeder offene Stream seine Puffer länger im Speicher hält — gleiche Behandlung, Gateway vs. Direktmessung, pro Nutzlast:
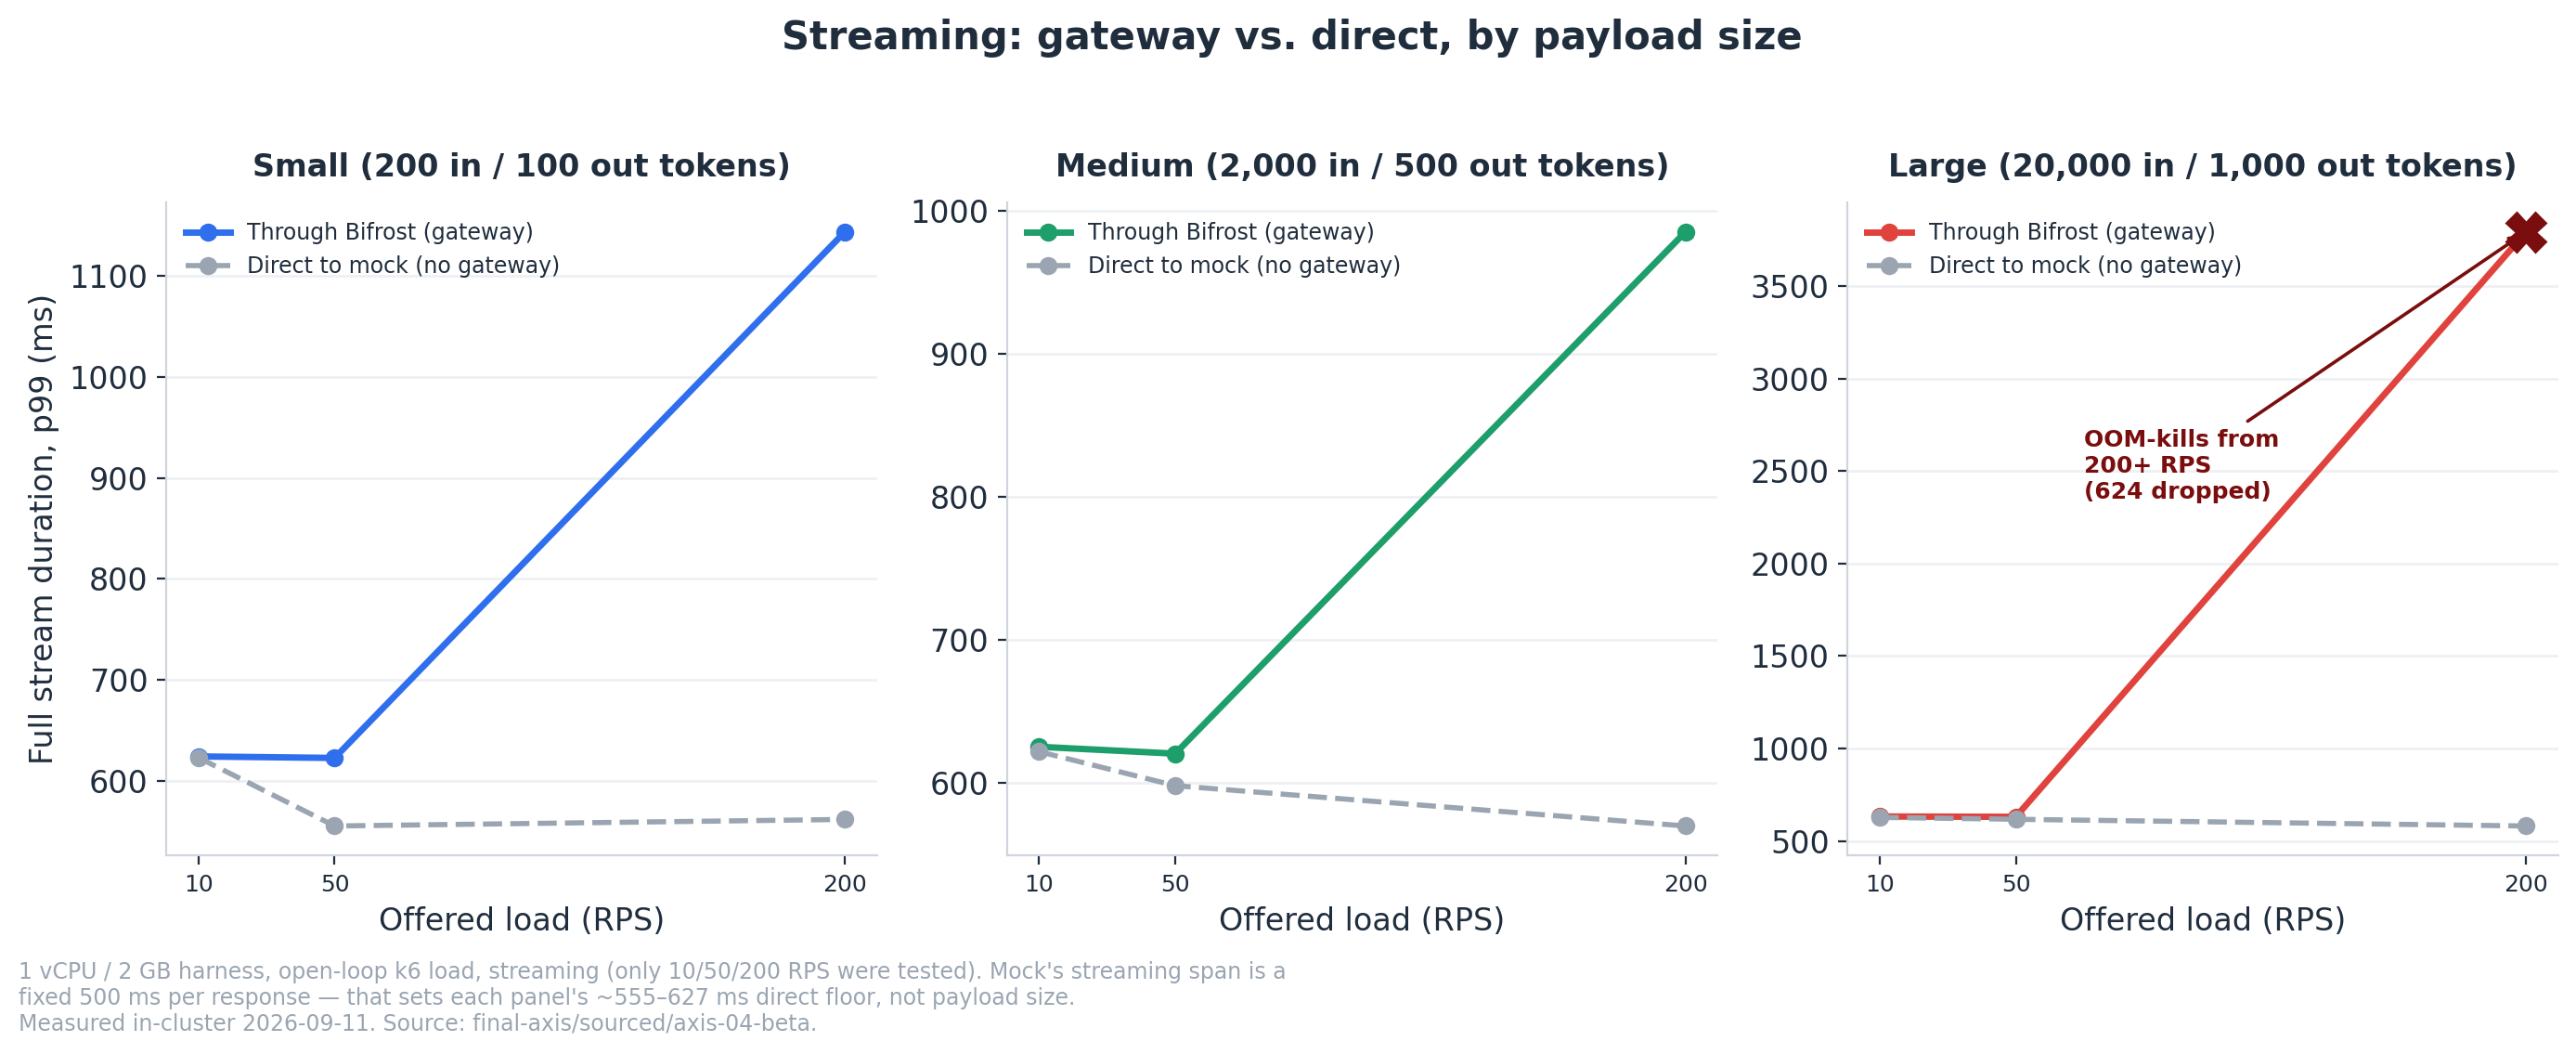
Das Streaming kleiner und mittlerer Nutzlasten folgt ihrer eigenen direkten Untergrenze von ~555–627 ms bis 50 RPS sehr genau und beginnt dann bei 200 RPS zu steigen (p99 bei kleinen Nutzlasten erreicht ~1,14 s, bei mittleren ~985 ms — beides durch Warteschlangen bedingt, kein OOM). Das Streaming großer Nutzlasten zeigt ebenfalls keinen allmählichen Anstieg: Bei 200 RPS bricht es mitten im Durchlauf durch OOM zusammen, reißt 624 von 12.001 Streams mit sich und lässt die p99-Latenz auf ~3,8 Sekunden ansteigen. Wenn Ihre Arbeitslast große Dokumente streamt, sind 200 RPS auf einer vCPU keine „langsamere“ Stufe — es ist eine Stufe, bei der das System „ausfällt“.
Die gesamte Stream-Dauer ist jedoch nicht die entscheidende Zahl, wenn Ihre Benutzeroberfläche lediglich das erste Token anzeigen muss — daher haben wir dies separat gemessen mit einer gepaarten asynchronen Messsonde, die die Zeit bis zum tatsächlichen ersten Inhalts-Token misst und nicht den TTFB von k6 (der hier für SSE ungültig ist, da der Mock Header vor dem Vorhandensein von Token leert):
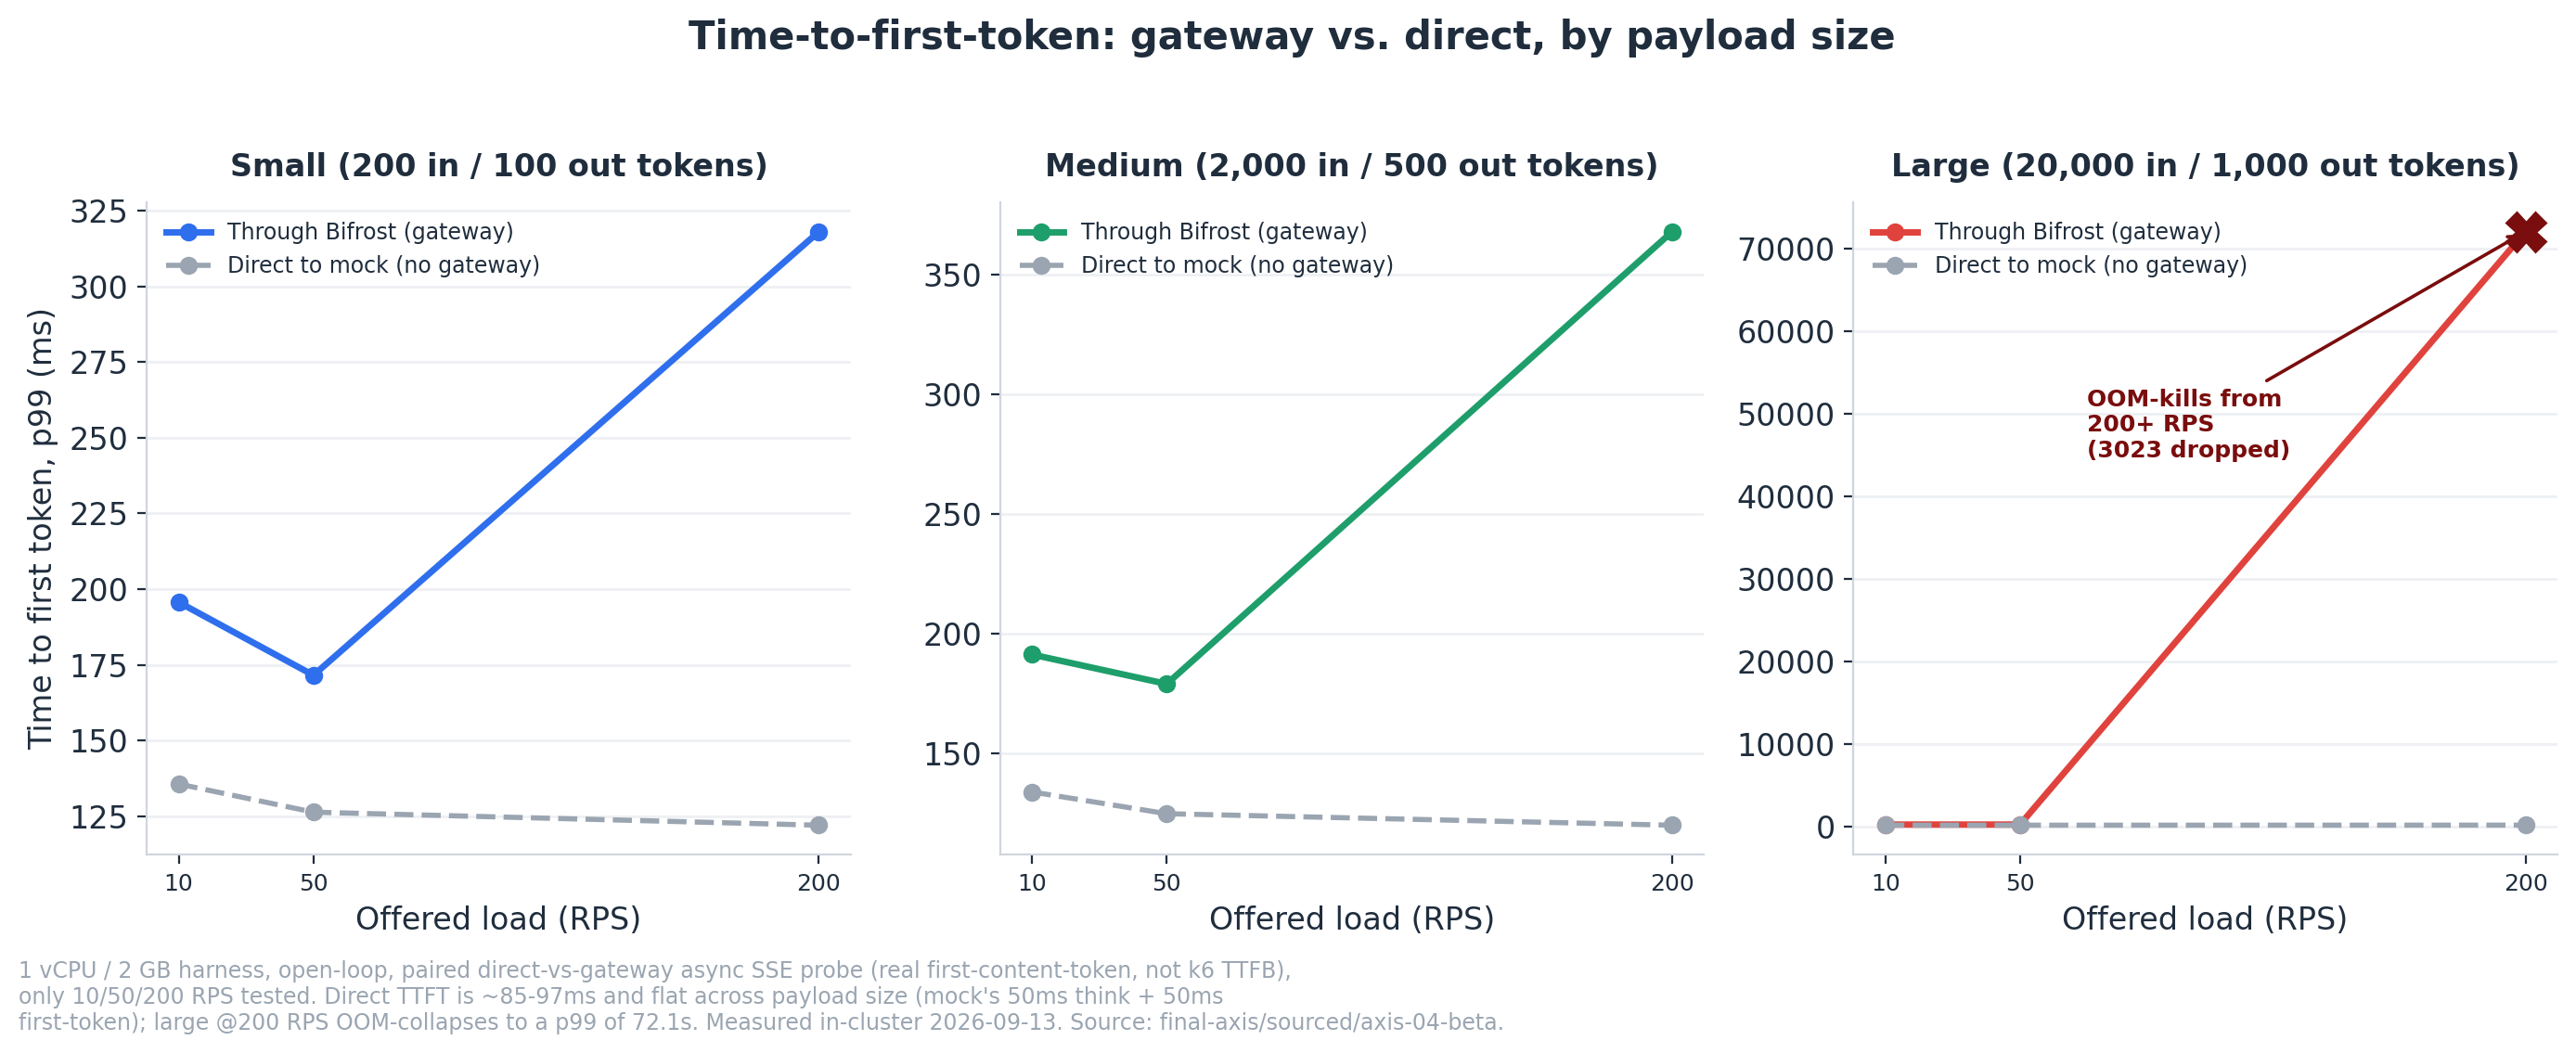
Der direkte TTFT liegt bei ~85–97 ms und verläuft über alle drei Nutzlastgrößen hinweg flach — eine Bestätigung dafür, dass die Input-Länge die Zeit bis zum ersten Token nicht verändert. Alles oberhalb dieser Untergrenze ist also Bifrosts eigener Streaming-Einrichtungsoverhead pro Anfrage. Dieser Zusatzaufwand beträgt ~27–46 ms und ist bei 10–50 RPS größenunabhängig (groß @10 RPS fügt +46 ms hinzu, klein @10 RPS fügt +43 ms hinzu — gleiche Größenordnung, unterschiedliche Nutzlast). Bei 200 RPS halten die Mediane für kleine und mittlere Nutzlasten immer noch (+57 bis +71 ms), aber der Tail explodiert — die zusätzliche p99-Latenz erreicht +196 bis +248 ms — und 10–13 % der Gateway-Streams schlagen komplett fehl; derselbe Warteschlangen-Knick, der auch im obigen Diagramm für den vollständigen Stream sichtbar ist. Groß @200 RPS hat kein Tail-Problem, sondern einen Zusammenbruch: Nur 128,8 von 200 angebotenen RPS werden verarbeitet, der TTFT-p99-Wert schnellt auf 72,1 Sekunden hoch und 3.023 von 12.001 Streams schlagen fehl — die OOM-Wand, diesmal aus der Perspektive des ersten Tokens statt der vollständigen Antwort betrachtet.
Und unter einer gezielten Überlastungsspitze blieben beide Modi von Bifrost speichersicher: „Blocking“ bedient schließlich jeden (die langsamste Anfrage wartete ~5 Sekunden), „Drop“ schlägt schnell mit einem sauberen 503-Fehler fehl.
Die Obergrenze für große Nutzlasten hat eine völlig andere Ursache als die für kleine/mittlere. Es liegt nicht an der CPU — und das lässt sich am klarsten erkennen, wenn man Speicher und CPU getrennt betrachtet, aufgeschlüsselt nach Nutzlastgröße und angebotener Last, anstatt nur als einzelnen Spitzenwert pro Nutzlast:
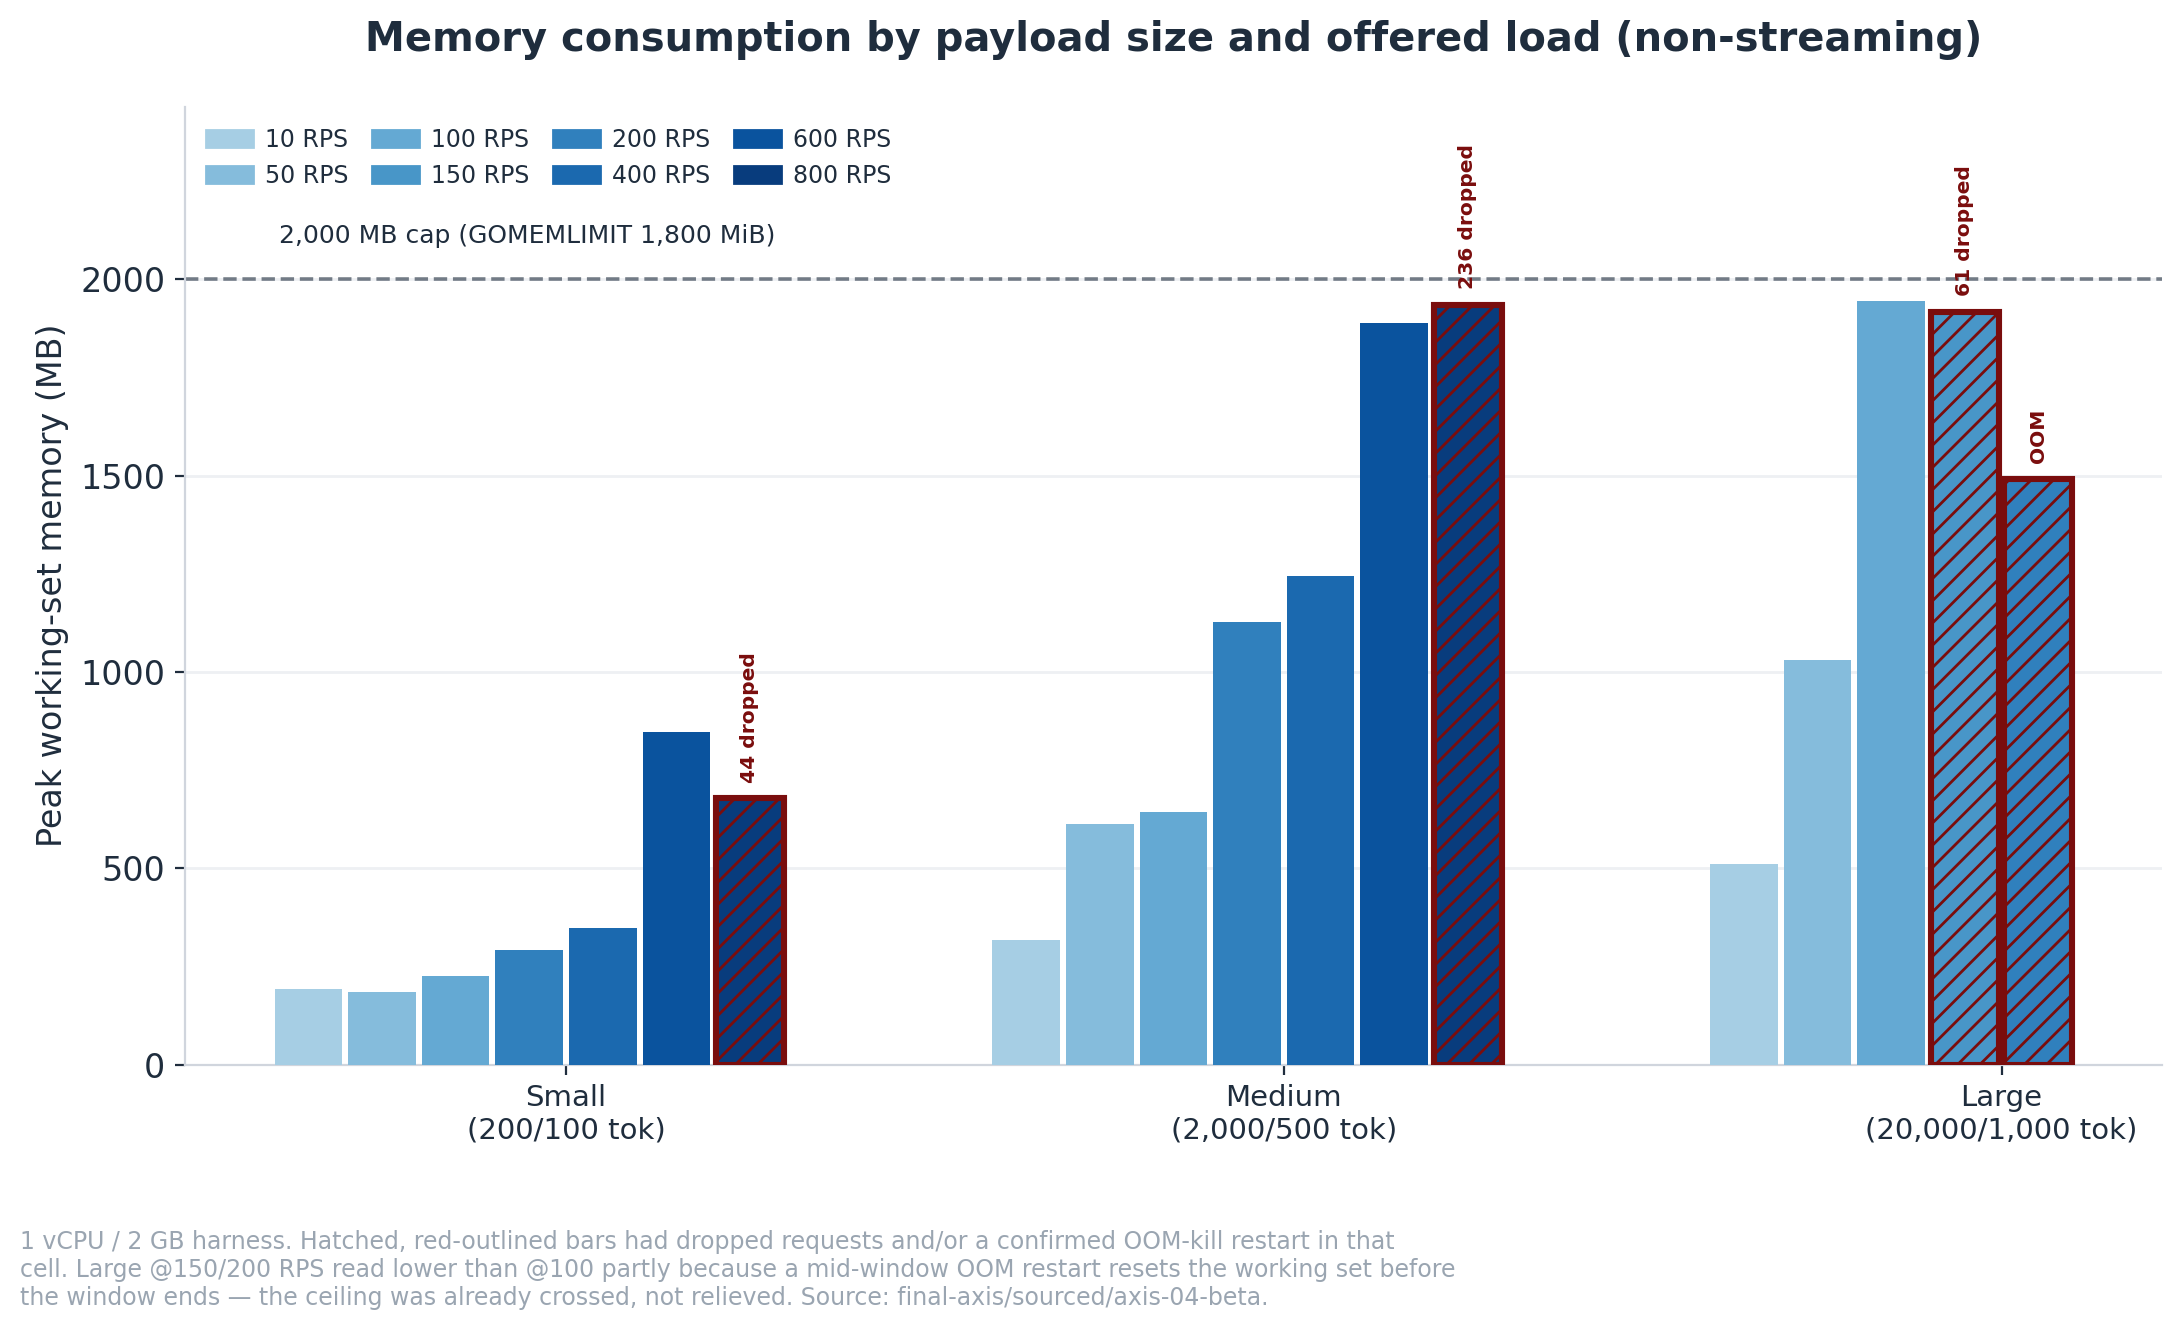
Kleine und mittlere Nutzlasten steigen allmählich an und kommen selbst bei ihren höchsten getesteten RPS nie in die Nähe des Limits von 2.000 MB (848 MB bzw. 1.935 MB). Bei großen Nutzlasten sieht das anders aus: Sie erreichen bereits bei 100 RPS 1.944 MB — 97 % des Limits —, ganze 50–700 RPS vor ihrer gemessenen „Obergrenze“. Die rot umrandeten und schraffierten Balken (groß @150, @200) zeigen tatsächlich niedrigere Werte als der 100-RPS-Balken. Das sieht nach Erholung aus, ist es aber nicht — ein OOM-Kill mitten im Messfenster startet den Pod neu und setzt den Working-Set-Zähler zurück, bevor das Messfenster endet. Diese Balken untererfassen also die reale Spitze, anstatt sie zu überschätzen.
Die CPU zeigt genau das gegenteilige Bild, was den Kern der Sache trifft:
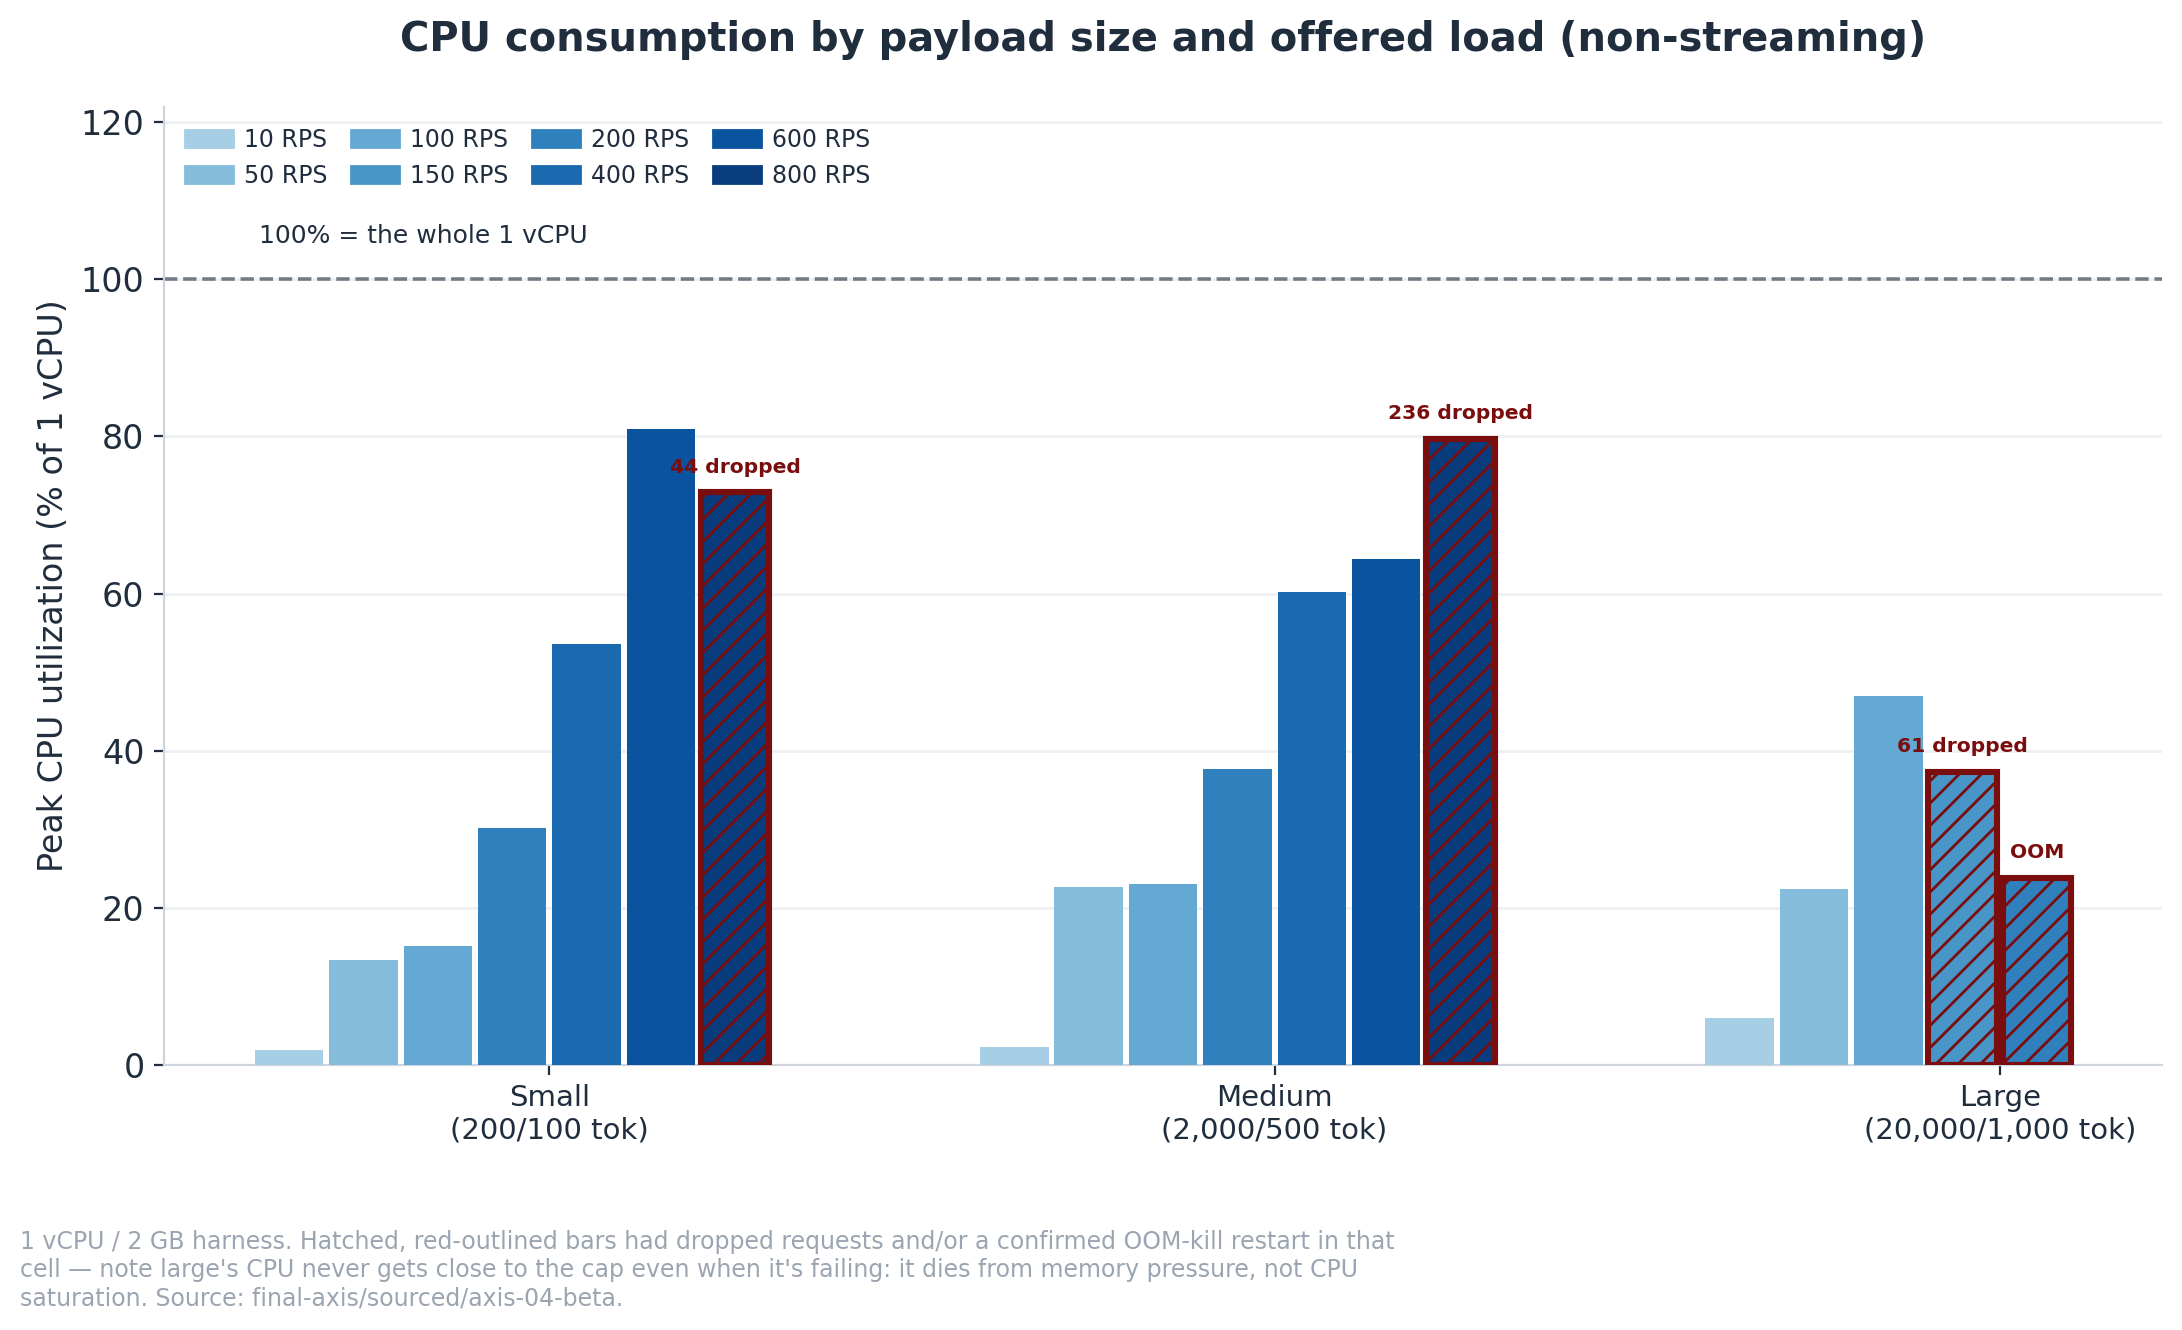
Kleine und mittlere Nutzlasten steigen bei ihren höchsten RPS beide in den Bereich von 73–80 % — das System ist hier tatsächlich CPU-gebunden und lastet die einzelne vCPU stark aus. Bei großen Nutzlasten passiert das nie: Selbst in den Zellen, in denen aktiv Anfragen verworfen werden und OOM-Kills auftreten (rot umrandet und schraffiert), liegt die maximale CPU-Auslastung bei lediglich 37 % und 24 %. Große Nutzlasten schlagen nicht fehl, weil der CPU-Spielraum erschöpft ist — sie schlagen fehl, weil der Speicher voll ist, während die CPU noch freie Kapazitäten hatte. Wenn Ihre Arbeitslast aus langen Dokumenten besteht, ist das die Zahl, um die herum Sie planen müssen, nicht die Anzahl der vCPUs.
Ein Exact-Match-Treffer verwandelt einen Aufruf von ~59 ms in einen von ~4 ms. Semantisches Caching — das Erkennen einer anders formulierten Wiederholung derselben Frage — verursacht reale Embedding-Kosten, schlägt einen neuen Aufruf jedoch immer noch um die Hälfte der Zeit:
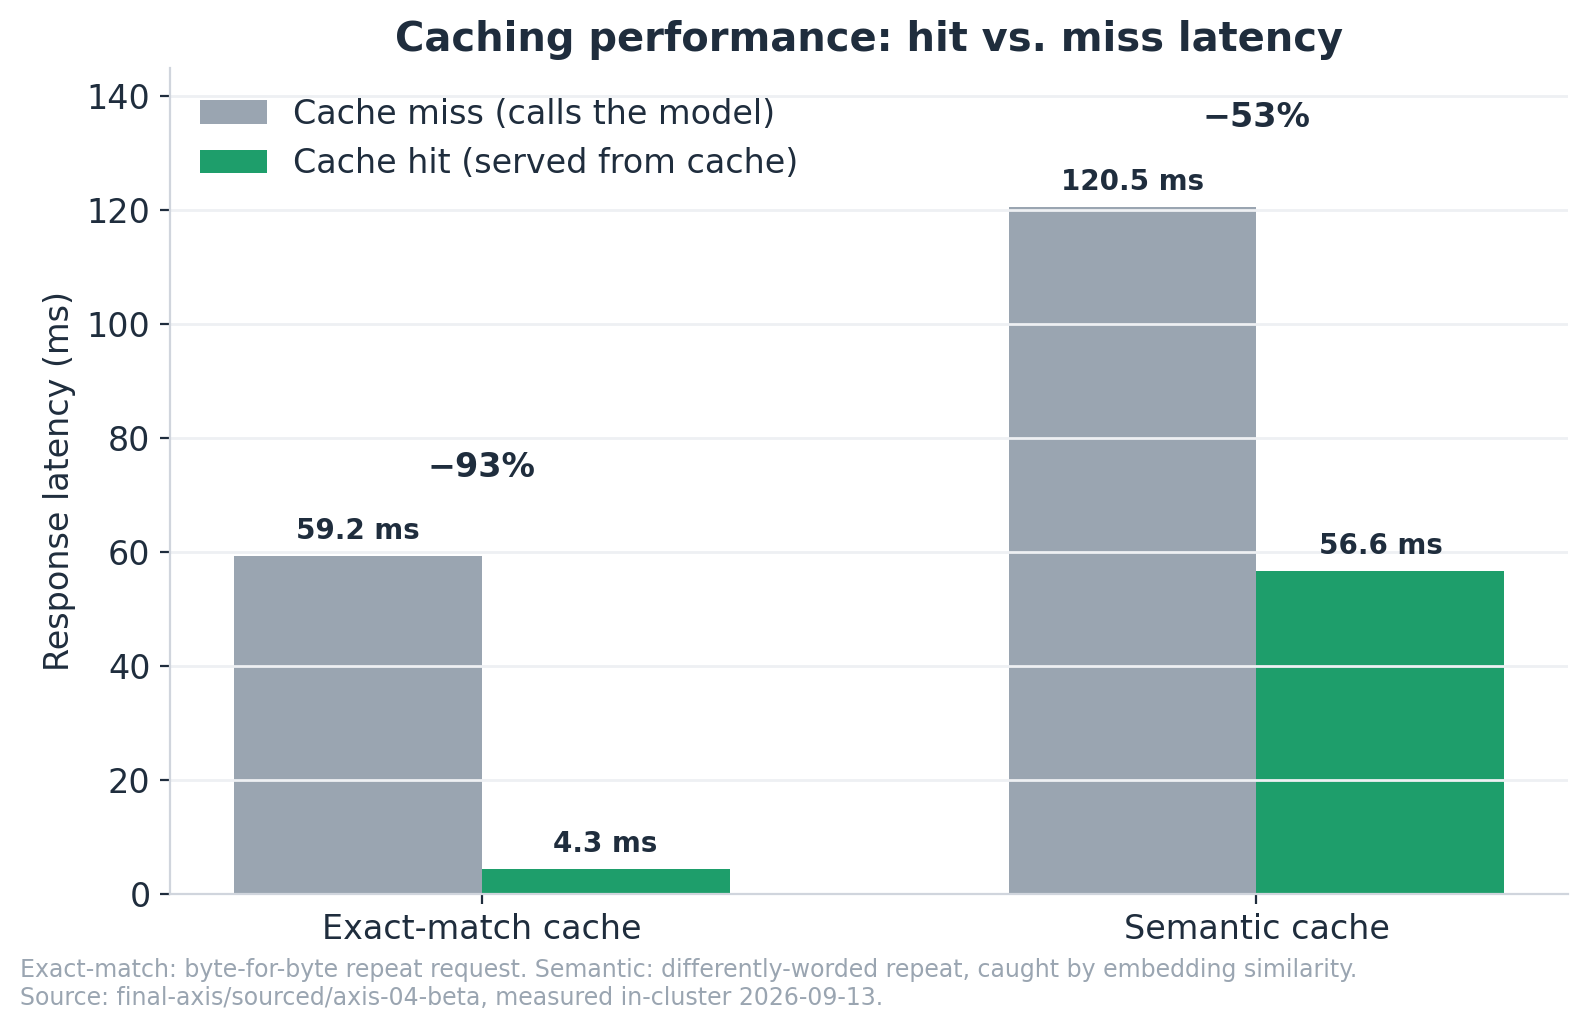
Keines der Ergebnisse ist für sich genommen überraschend — Caching soll schneller sein als der Aufruf des Modells, und das ist es auch. Die Zahlen hier sind lediglich die praktische Messung dessen, wie viel schneller es genau ist: 93 % für einen Exact-Match-Treffer, 53 % für einen semantischen Treffer, sobald die Embedding-Kosten bezahlt sind.
Zwei weitere Zahlen, bevor wir weitergehen: Der Kaltstart liegt im Median bei 8,7 Sekunden, wovon 8,2 Sekunden auf einen obligatorischen erneuten Download des Katalogs bei jedem Neustart in einem typischen containerisierten Setup entfallen — dies lässt sich mit persistentem Speicher beheben und wurde hier nicht unabhängig erneut getestet.
Ein Transparenzhinweis zu den obigen Zahlen: Speziell bei der Zelle für kleine Nutzlasten haben wir einen Fehler in unserem eigenen Teststand entdeckt und behoben (eine Wechselwirkung mit dem Nagle-Algorithmus im Netzwerk, die unsere Baseline unruhig machte) — nach der Behebung verschob sich die Durchsatzgrenze für kleine Nutzlasten bei Bifrost tatsächlich nach oben, von ~400 auf ~600–800 RPS. Wir erwähnen dies, weil man solche Dinge beim Benchmarking jedes Gateways (einschließlich Bifrost) leicht falsch machen kann, und wir lieber unsere Arbeit offenlegen als die Korrektur zu verschweigen.
Auf einem einzelnen Node ist der Overhead von Bifrost im Median tatsächlich gering: 2–6 ms zusätzlich zu einem ~55-ms-Upstream-Aufruf, flach über Nutzlastgrößen und nahezu flach über die Last hinweg. Das ist die vertretbare Version der Behauptung, das „schnellste Gateway“ zu sein, und das ist etwas wert — als Anteil an einem realen LLM-Aufruf geht es im Rauschen unter. Der Tail-Bereich zeigt ein anderes Bild. Die zusätzliche p99-Latenz reagiert empfindlich auf Last und erreicht an den von uns gemessenen Obergrenzen +41 bis +75 ms. Große Nutzlasten verlangsamen sich nicht nur allmählich, sondern stoßen an harte Grenzen: OOM-Kills bei 150 RPS und verworfene Anfragen. Caching funktioniert wie beworben (gemessene Latenzreduzierungen von 93 % und 53 %). Die Zahl des Herstellers von 5.000 RPS beschreibt eine größere Maschine und eine andere Arbeitslast, als die meisten Teams einsetzen. Für einen einzelnen Node gilt also: Die Geschwindigkeit im Median ist nicht das Problem — wohl aber die Tail-Latenz unter Last und die Speicherreserven bei dokumentenintensivem Datenverkehr.
Die schwierigere Frage ist, was passiert, wenn Sie mehr als einen Node ausführen. Ein Produktions-Gateway muss skaliert werden können (horizontal hoch- und herunterfahren) und den Ausfall eines Pods überstehen, ohne dass dies jemand bemerkt. In der Open-Source-Version wird es an dieser Stelle kompliziert. Konfigurationsänderungen werden nicht live an alle Replikate übertragen; das dokumentierte Muster ist eine gemeinsam genutzte Konfigurationsdatei zusammen mit einem Neustart. Jede Routing-Änderung, Schlüsselrotation oder Budget-Aktualisierung wird somit zu einem koordinierten Rollout über Ihre Gateway-Pods hinweg, anstatt eine einfach umstellbare Einstellung zu sein. Kommt noch ein Admin-Dashboard hinzu, das bis zur Erstellung des ersten Admin-Kontos für jeden erreichbar ist, eignet sich die Open-Source-Version am besten für einen einzelnen Node, den Sie genau beobachten, und nicht für eine ganze Flotte.
Bifrost Enterprise schließt einen Großteil dieser Lücke: Sein gRPC-Mesh überträgt Konfigurationsänderungen innerhalb von Sekunden ohne Neustart an jedes Replikat. Aber selbst die Enterprise-Version bleibt Infrastruktur, die Sie selbst bereitstellen, skalieren, patchen und überwachen müssen. Der Kauf der Lizenz nimmt Ihnen den betrieblichen Aufwand nicht ab.
Die eigentliche Entscheidung lautet also weniger „Ist Bifrost schnell?“, sondern vielmehr „Wer wird es betreiben?“. Ein Team mit dedizierten Plattform-/DevOps-Kapazitäten oder mit strengen Anforderungen, alles in der eigenen Umgebung zu halten, kann Bifrost gut betreiben — idealerweise auf Enterprise, wenn mehr als ein Replikat benötigt wird. Ein kleines Team, das lediglich ein zuverlässiges Gateway vor seinen LLM-Aufrufen benötigt, zieht in der Regel mehr Nutzen aus einem verwalteten Angebot als aus dem Eigenbetrieb der Gateway-Infrastruktur.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet





