October 8, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Published: October 6, 2026
Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
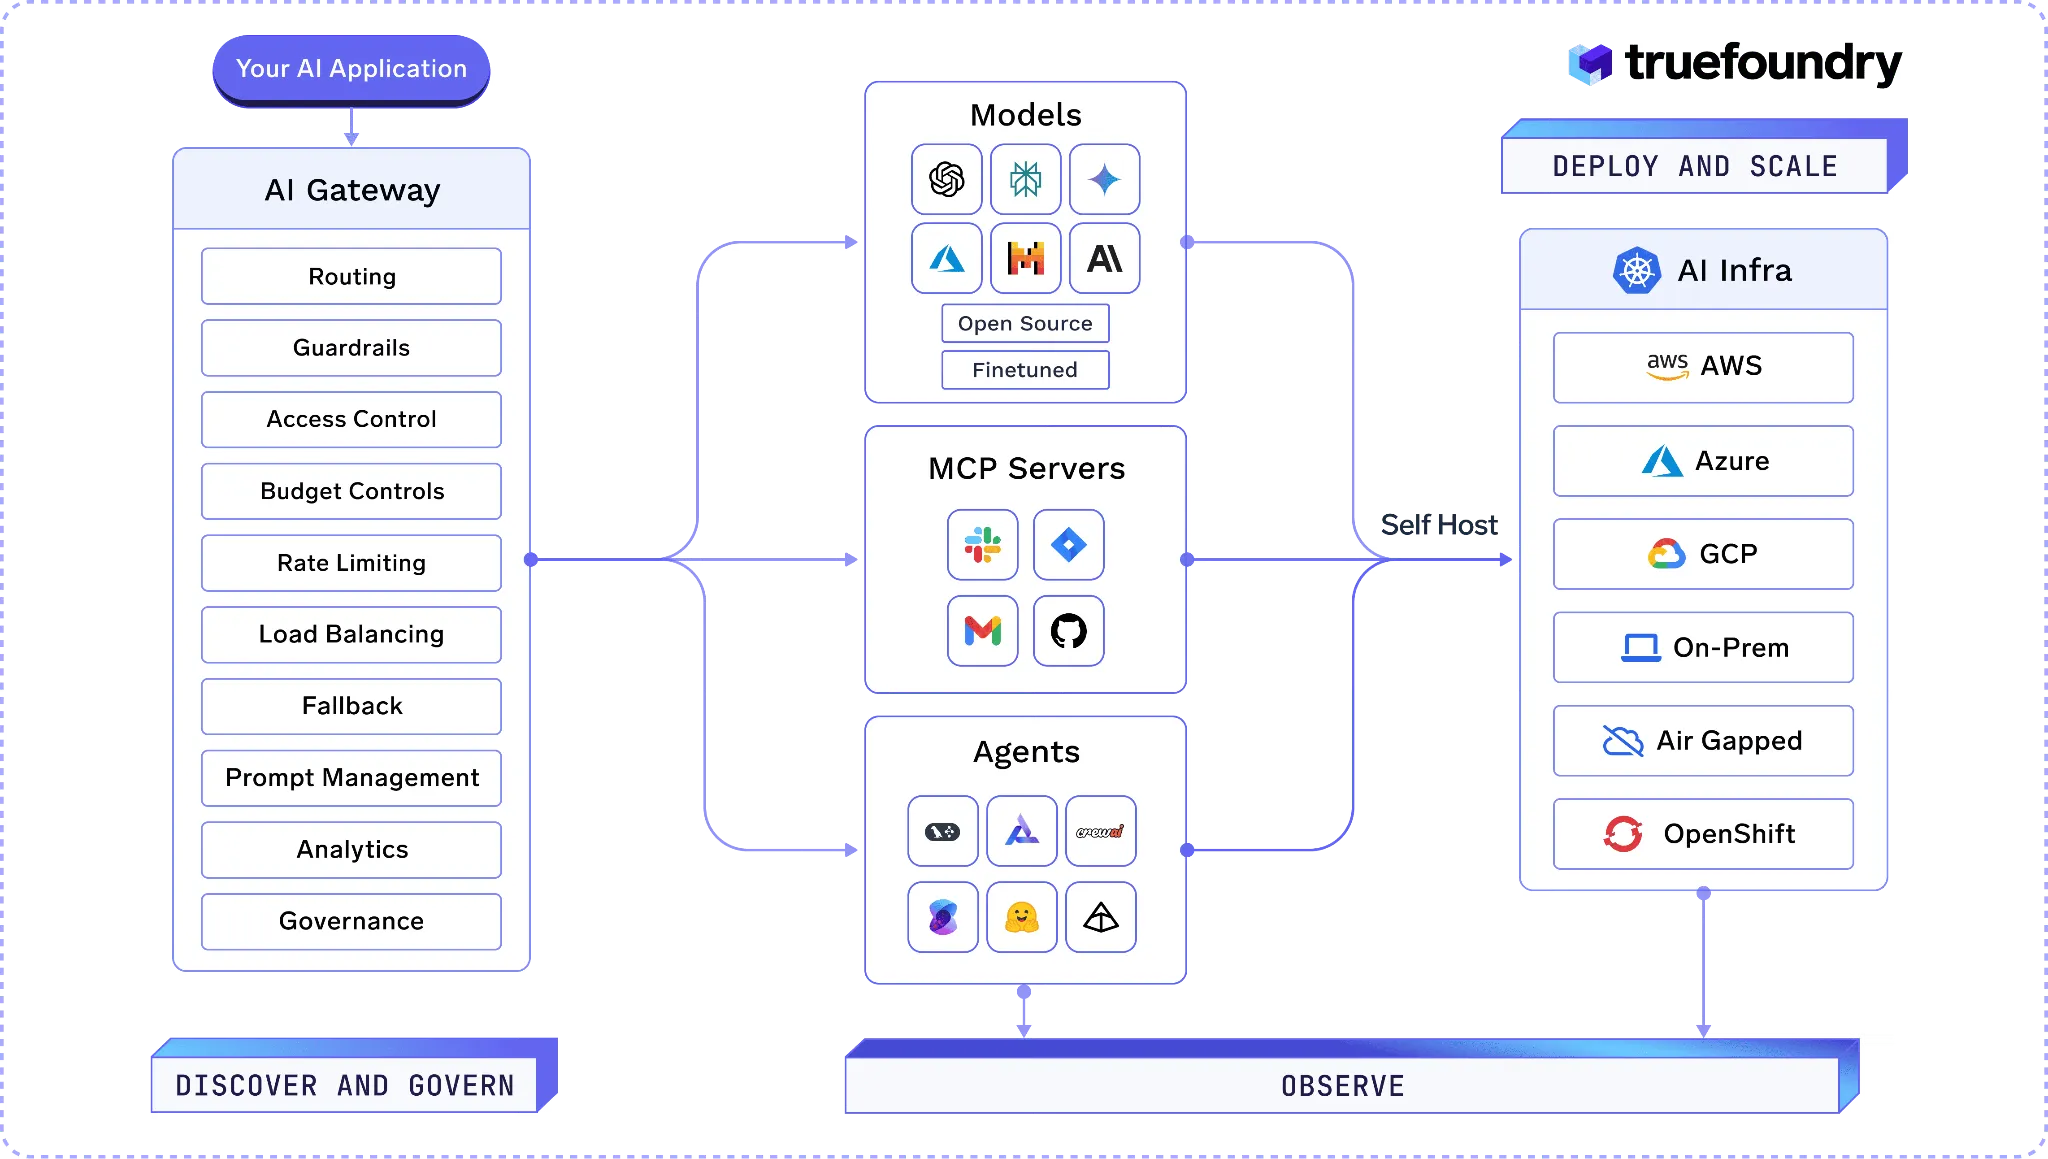
Betrachtet man die AI Engineer World's Fair 2026 aus der Perspektive eines CIOs, offenbart sich eine zweite Konferenz innerhalb der ersten. Ja, die Schlagzeilen drehten sich um Loops, Harnesses und Coding-Agents. Aber schauen Sie sich die Struktur des Programms an: der KI-native Unternehmen Leadership-Track lief an jedem Haupttag – parallel zu einem ständigen CTO-Circle und Leadership-Sessions mit Titeln wie „Tokenmaxxing“ und „AI Factories“ (offizielles Programm) – ein Thema, das wir in unserer Tokenmaxxing-Trilogie in Buchlänge behandelt haben: KI-Kosten-Governance, die Architektur kontrollierter Nutzungund Aufbau von KI-Hebelwirkung. Betrachten Sie die Teilnehmer: Die Liste der Konferenzbesucher liest sich wie ein Who-is-Who der Fortune 500 – Walmart, Capital One, Fidelity, Uber, Netflix, CVS Health, Toyotas Woven – neben den Labs und Startups (ai.engineer). Und schauen Sie sich die Tracks an, die im Laufe der Woche still und leise prominente Plätze einnahmen: Security (Tag 2), Evals (Tag 3), Agentic Commerce (Tag 4). Die Käufer waren vor Ort, und das Programm, für das sie kamen, lautete nicht „Können Agents das?“, sondern „Können wir das betreiben?“ – kontrolliert, messbar, innerhalb unserer Sicherheitsgrenzen. Die nüchterne Analystenliteratur erklärt warum. Die Demos der Vorreiter und die Warnungen der Analysten deuten auf dasselbe fehlende Bindeglied hin: eine Ausführungsebene für Unternehmen. Dieser kurze Beitrag handelt davon, was diese Ebene konkret erfordert – und die dokumentierte TrueFoundry-Oberfläche , die dies liefert.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet