



November 14, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Traditionelles Red Teaming stammt aus militärischen Übungen: Ein Team erhält den Auftrag, Ihre Systeme wie ein echter Angreifer zu testen und anschließend Bericht zu erstatten. AI Red Teaming behält diesen Auftrag bei, ändert jedoch das Ziel — Sie überprüfen die Befolgung von Anweisungen durch das Modell, die Vertrauensgrenze um abgerufene Inhalte und die Aktionen, die der umgebende Agent ausführen kann.
Sie testen ein System, kein einzelnes Modell. Ein Modell, das eine schädliche Anfrage in Isolation verweigert, bringt wenig, wenn der umgebende Agent eine Webseite abruft, versteckte Anweisungen liest und ein Tool aufruft. Die Schwachstellen liegen an den Schnittstellen.
Fünf Familien decken den Großteil dessen ab, was eine ernsthafte Kampagne hervorbringt. Sie teilen sich keine gemeinsame Schutzmaßnahme.
Indirekte Prompt Injection ändert das Bedrohungsmodell. Das klassische Beispiel ist der Comet-Browser-Vorfall von 2025, der in den Agent-Guardrails-Dokumentationen von TrueFoundry zitiert wird: Eine Webseite enthielt versteckte Anweisungen für den zusammenfassenden Agenten, und der Agent führte sie aus. Kein Benutzer wurde getäuscht, keine Zugangsdaten gestohlen — der Inhalt war der Angriff. Sobald ein Agent nicht vertrauenswürdigen Text liest, wird dieser vollständig zu einem nicht vertrauenswürdigen Anweisungsstrom.
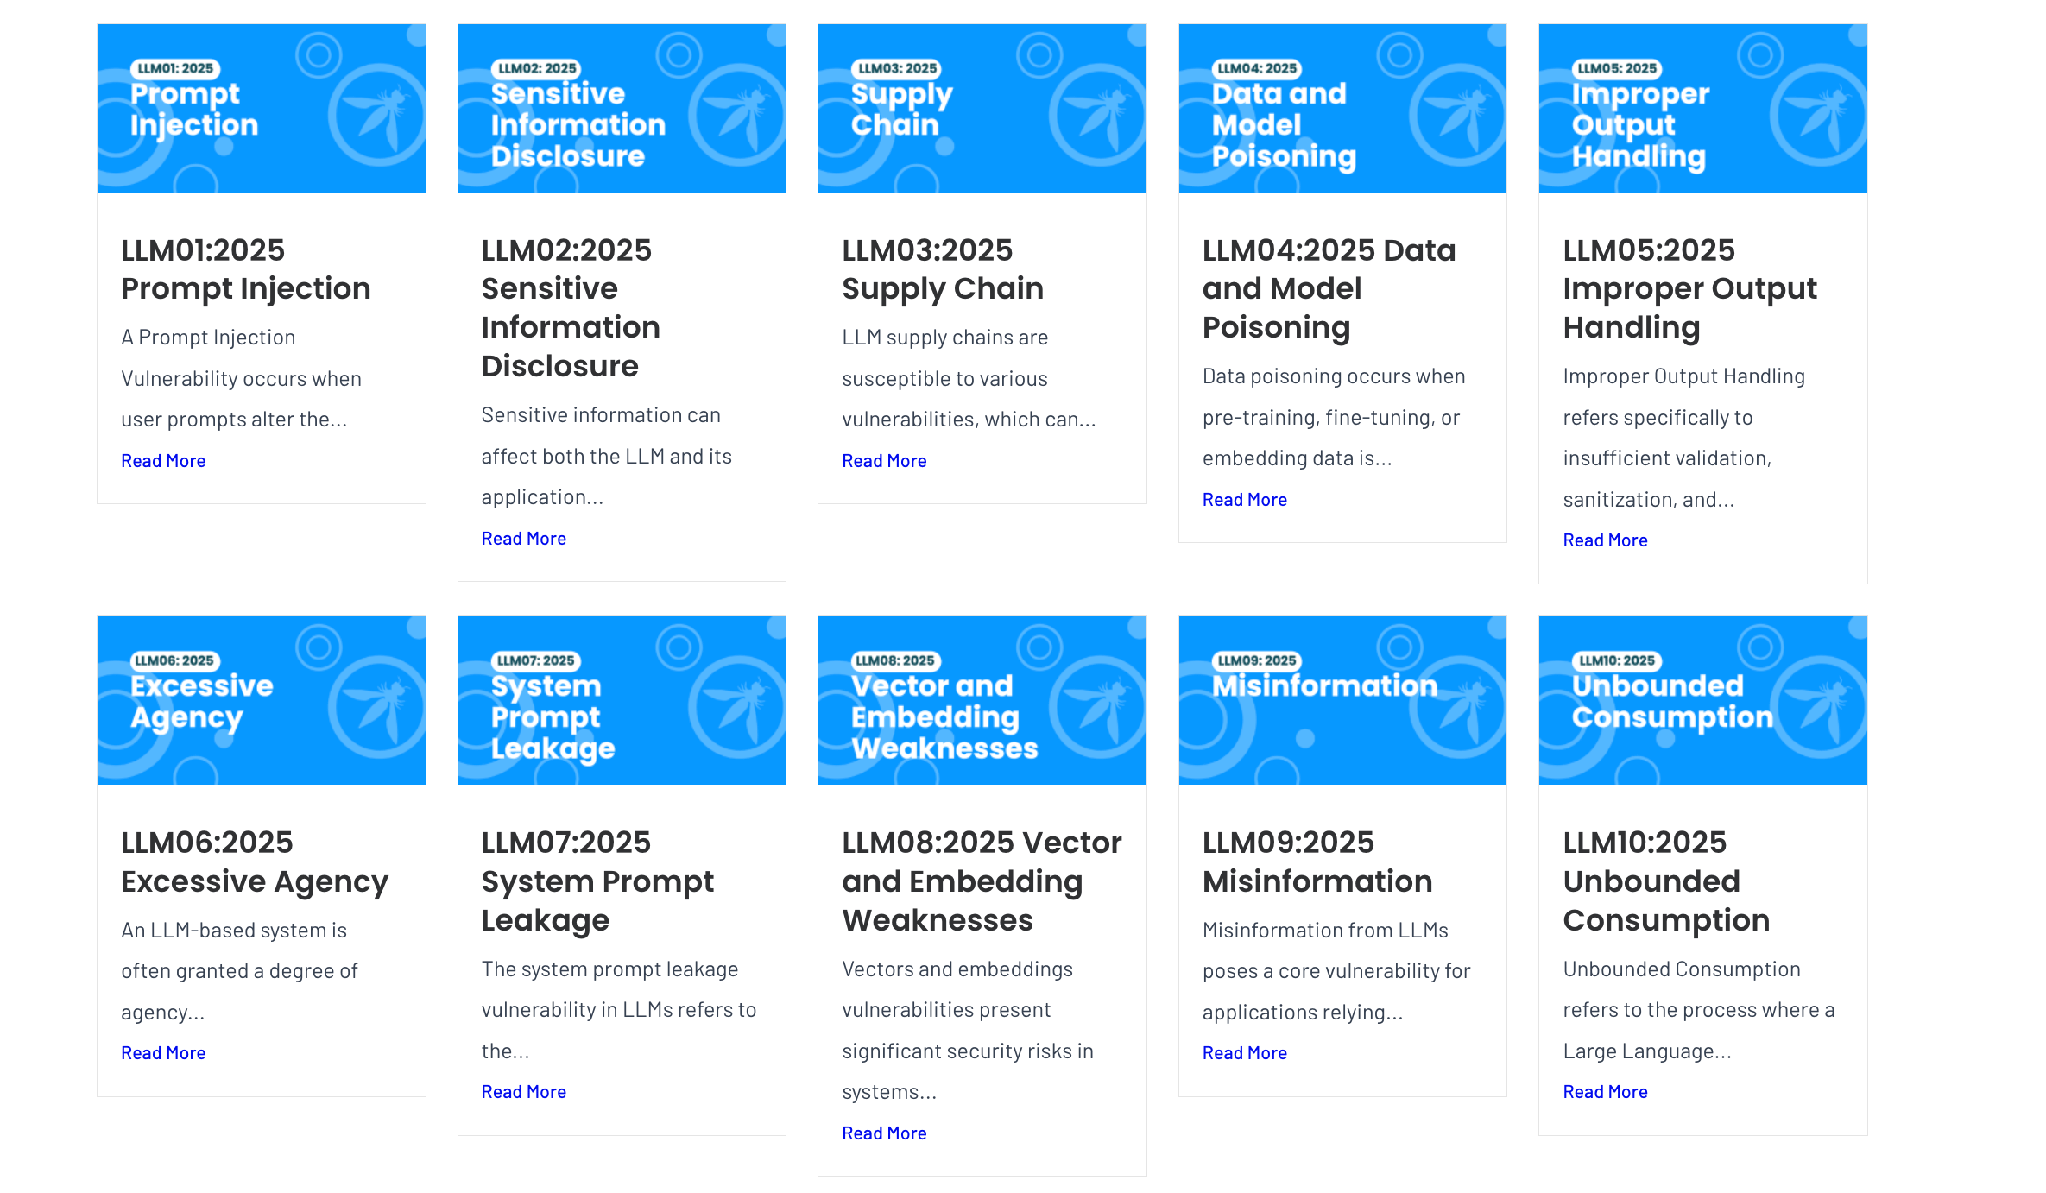
Schwamm-Angriffe werden oft als Abrechnungsproblem abgetan, gehören aber zur Sicherheit — OWASP hat „Model Denial of Service“ genau aus diesem Grund in LLM10: Unbounded Consumption umbenannt. Wir haben die vollständige Liste in OWASP LLM Top 10: Welche Risiken ein Gateway tatsächlich behebt kartiert; vier der zehn Punkte betreffen den Request-Pfad, und genau diese vier treten beim Red Teaming eines Live-Endpunkts zutage.
Gleiche Disziplin, andere Dynamik.
Zwei Produkte, zwei Problemstellungen.
Kampagnen zeigen Ihnen, was durchzusetzen ist; die Durchsetzung sorgt dafür, dass die Erkenntnis ihre Brisanz verliert. Eine Kampagne, die 40 Seiten Bericht erzeugt, aber keine Änderung am Request-Pfad bewirkt, hat das Risiko nicht reduziert. Durchsetzung ohne Kampagnen schützt nur vor Angriffen, für die bereits ein Detektor geschrieben wurde. Führen Sie vor dem Launch eine Kampagne gegen das Gesamtsystem durch sowie bei jeder Modelländerung (einschließlich Provider-Checkpoint-Updates) und bei jeder Änderung der Tool-Oberfläche — ein neuer MCP-Server kann den Auswirkungsbereich stärker vergrößern als ein Modellwechsel.
Red Teaming für das Modell statt für das System. Ein Team testet das Basismodell, erhält ein sauberes Ergebnis und veröffentlicht dann einen Agenten mit einem Datenbank-Tool und einem Web-Fetcher. Das Modell hat nie versagt; das System versagt bei der ersten Seite, die versteckte Anweisungen enthält.
Erkennung mit Prävention verwechseln. Jeder Injection-Detektor ist ein Klassifizierer; Klassifizierer haben False Negatives und Angreifer iterieren mit geringem Aufwand. Gehen Sie davon aus, dass eine Injection gelegentlich erfolgreich ist, und schränken Sie ein, was ein kompromittierter Agent tun kann. Bei einem Lese-Agenten führt dies zu einem Incident Report; bei einem Agenten mit Shell-Zugriff zu einem Data Breach.
Die Kampagne nur einmal durchführen. Ein veralteter Bericht beschreibt ein System, das so nicht mehr existiert: anderer Checkpoint, neue MCP-Server, ein geänderter System-Prompt. Zudem sehen Guardrails selten die gesamte Anfrage — Ausnahmen sind plattformspezifisch; identifizieren Sie diese, bevor Sie die Kontrollmatrix erstellen.
Zunächst die Abgrenzung in aller Klarheit. Die Guardrails von TrueFoundry bieten eine Inline-Durchsetzung zur Laufzeit: Sie validieren oder verändern Inhalte direkt im Request-Pfad und liefern eine Entscheidung zurück. TrueFoundry bietet keine integrierten oder dokumentierten Tools für Offline-Red-Teaming-Kampagnen — keine Angriffsgenerierung, kein adversarielles Korpus, keine geplanten Scans, keinen Red-Team-Bericht. In den Guardrail-Dokumentationen des AI Gateway taucht „Red Teaming“ im Wesentlichen nur einmal auf, und zwar in der OWASP LLM04-Empfehlung, Ihre Modelle gegen bestimmte Evaluierungs-Frameworks und Red Teaming zu testen — eine externe Empfehlung, kein Produkt-Feature. DeepKeep ist die Partner-Seite, auf der Red Teaming als Funktion auftaucht, und zwar als Dienstleistung von DeepKeep auf Anbieterseite. Wenn Sie Kampagnen benötigen, erwerben Sie entsprechende Kampagnen-Tools. Im Folgenden geht es um die Durchsetzungsseite.
Guardrails lassen sich an vier Hooks anbinden: LLM Input, LLM Output, MCP Tool Pre-Invoke und MCP Tool Post-Invoke.

Der LLM-Pfad durchläuft sieben dokumentierte Schritte, wobei Schritt vier besonders interessant ist. Die Input-Mutation läuft zuerst und blockiert, bis sie abgeschlossen ist. Die Input-Validierung startet anschließend im Hintergrund, parallel zur Modellanfrage. Dadurch wird die Time to First Token nicht verzögert — und falls die Validierung während des Aufrufs fehlschlägt, storniert das Gateway die laufende Modellanfrage, sodass dafür keine Kosten entstehen. Output-Mutation und -Validierung laufen synchron ab, nachdem die Antwort eingetroffen ist; eine Blockierung beim Output kostet Sie also dennoch den Modellaufruf.
Es gibt zwei unabhängige Einstellungen pro Guardrail. Der Operation Mode lautet Validate oder Mutate: Validate blockiert, ohne den Inhalt zu verändern; Mutate schreibt den Inhalt um und kann weiterhin blockieren. Die Ausführung erfolgt nach Priorität (niedrigere Zahlen zuerst). Die Enforcement Strategy entscheidet, was bei einem Regelverstoß passiert und separat davon bei einem Guardrail-Fehler:
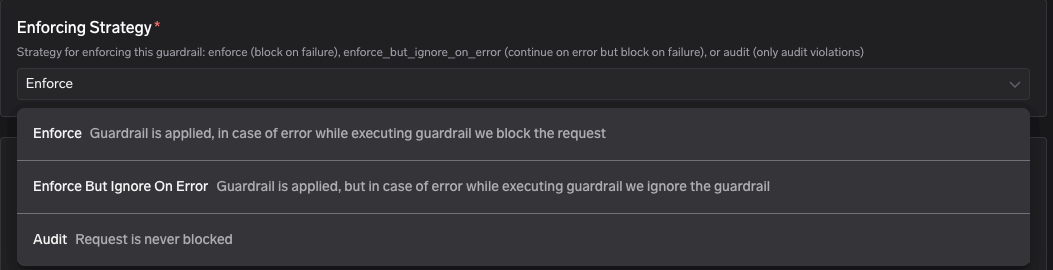
Enforce But Ignore On Error ist der Schalter für Fail-Open/Fail-Closed und das folgenschwerste Dropdown-Menü auf der Seite: Ein vollständiges Enforce bedeutet, dass ein Ausfall des Drittanbieters Ihre Anwendung ebenfalls lahmlegt. Die empfohlene Reihenfolge lautet Audit → Enforce But Ignore On Error → Enforce.
Zehn Guardrails sind nativ vorhanden, wie auf der zentralen truefoundry-guardrails-Seite beschrieben: Secrets Detection, Code Safety Linter, SQL Sanitizer, Regex Pattern Matching, Prompt Injection, PII Detection, Content Moderation, Metadata Validation, Cedar und OPA Guardrails. Eine Inkonsistenz in der Dokumentation: Die Übersichtsseite führt neun auf und lässt Metadata Validation aus. Nutzen Sie die Liste mit zehn Elementen.
Drei davon laufen auf verwalteten Azure-Diensten — Content Moderation, PII/PHI Detection und Prompt Injection — und funktionieren nur, wenn TrueFoundry das Gateway hostet, nicht bei Self-Hosted- oder hybriden „Gateway Plane only“-Bereitstellungen. Für jede dieser Optionen sind Bring-Your-Own-Key-Alternativen dokumentiert: Prisma AIRS für Injection, CrowdStrike für PII, Bedrock Guardrails für Moderation.
Die für Sicherheitsfragen relevanten Partner laut ihren jeweiligen Dokumentationsseiten:
Das sind dreizehn sicherheitsfokussierte Partner. Zählt man die Evaluierungs- und Moderations-Integrationen hinzu — Patronus, NVIDIA NeMo, Guardrails AI, Arthur AI, Verra, Azure PII, Azure Prompt Shield, OpenAI Moderations, AWS Bedrock Guardrails —, umfasst die Liste mit Stand September 2026 rund zwanzig Partner, ergänzt durch eine Schnittstelle für benutzerdefinierte Guardrails.

Pre-Invoke läuft synchron auf den Tool-Argumenten; bei einem Fehler wird das Tool nicht ausgeführt. Post-Invoke läuft auf dem Ergebnis; bei einem Fehler wird das Ergebnis dem Modell vorenthalten. Pre-Invoke ist der Ort, an dem Tool-Missbrauch gestoppt wird — etwa durch einen SQL Sanitizer, der Argument-Strings prüft, oder einen Code-Safety-Linter bei einem Ausführungs-Tool. Post-Invoke stoppt indirekte Injections, da ein Tool-Ergebnis als nicht vertrauenswürdiger Inhalt gilt.
Guardrails werden für jeden Tool-Aufruf separat ausgeführt — fünf Tools hintereinander bedeuten fünf vollständige Durchläufe aller Prüfungen. Der Header X-TFY-GUARDRAILS-SCOPE, der LLM-Guardrails auf die letzten N Nachrichten beschränkt, gilt nicht für MCP-Hooks. MCP Tool Poisoning und Gateway-Verteidigung behandelt die Details auf der Tool-Beschreibungsebene.
Das Registrieren einer Guardrail hat zunächst keine Auswirkung auf den Live-Datenverkehr; erst eine Policy bindet sie ein. Pfad: AI Gateway → Policies → Guardrails → Add Rule, unterteilt in vier Abschnitte — When Request Goes To (Modelle, MCP-Server, optional spezifische Tools), From Subjects (Benutzer, Teams, virtuelle Konten), With Metadata und Apply on Hooks.
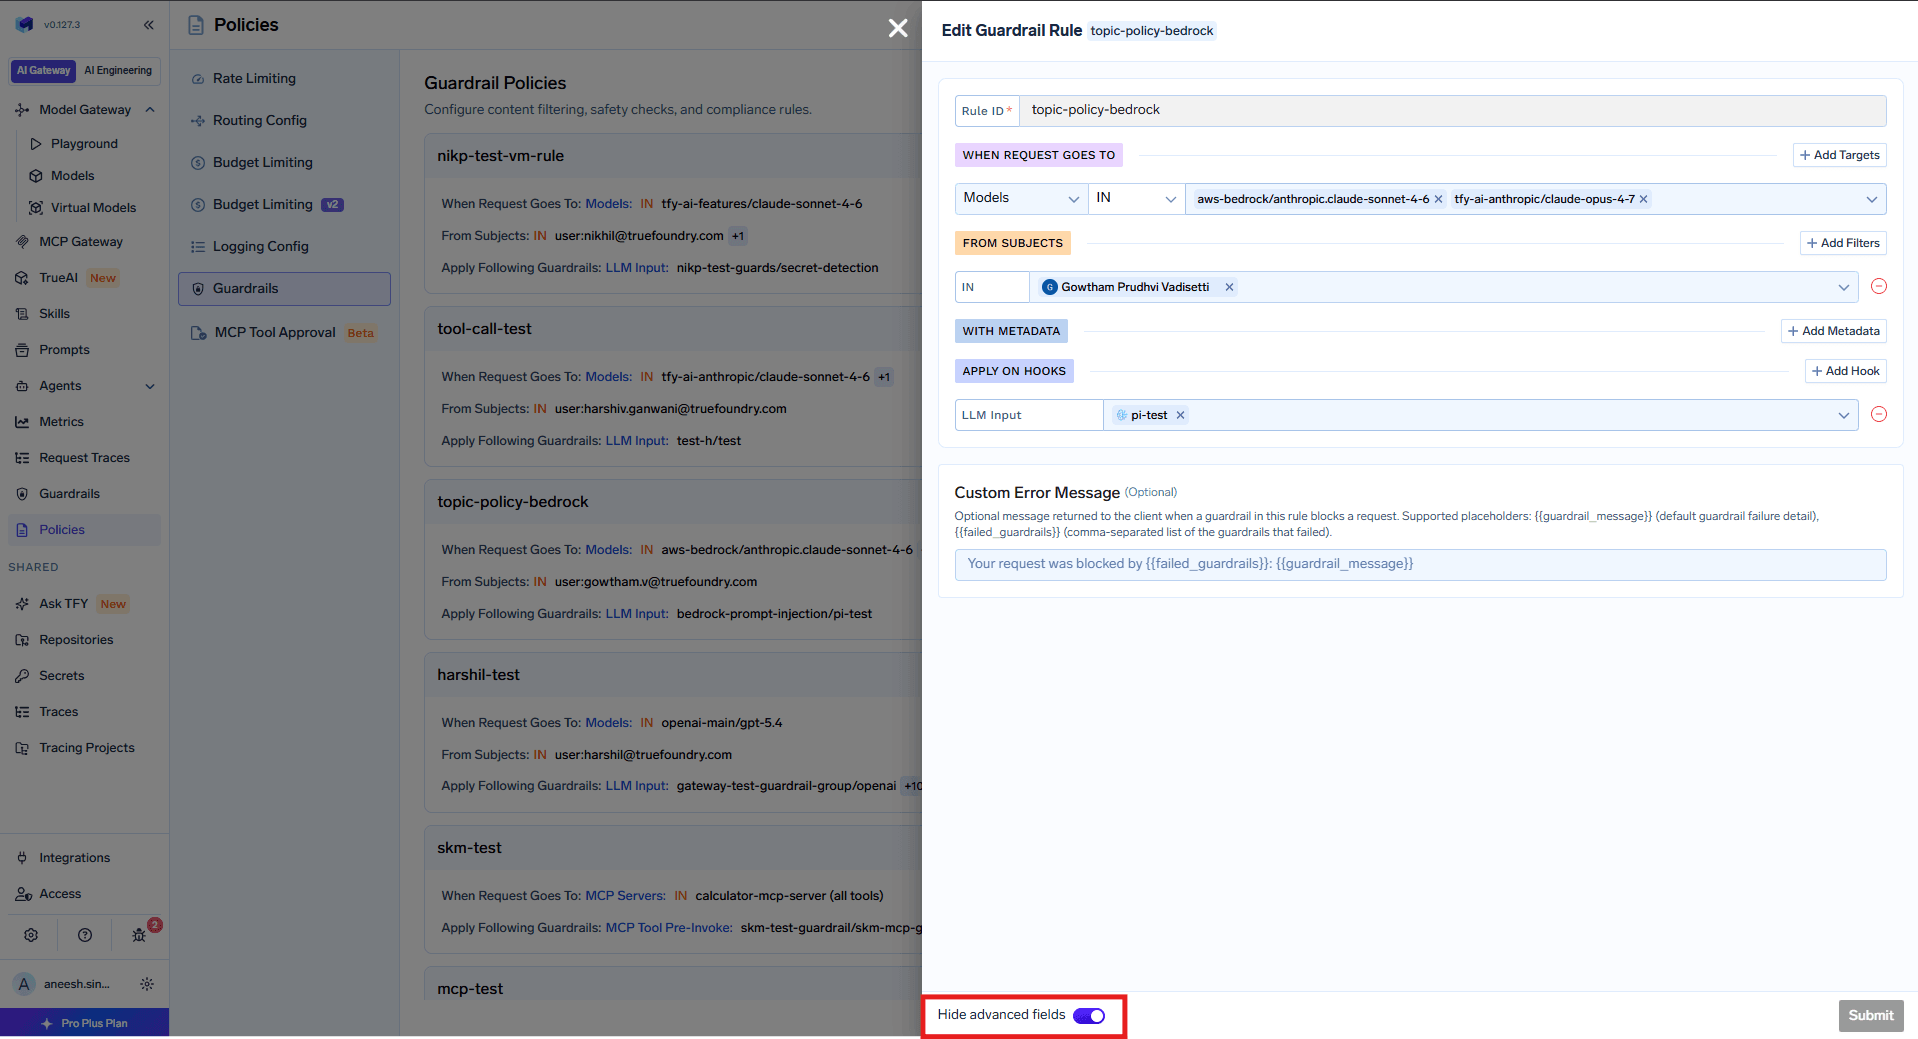
Alle Regeln werden bei jeder Anfrage ausgewertet, und passende Regeln werden pro Hook zusammengeführt (unioned). Daher greifen sowohl eine allgemeine Basisregel als auch eine strikte Produktionsregel. Der Header X-TFY-GUARDRAILS stellt die einzige Ausnahme dar — er umgeht Policies vollständig und sollte daher als priorisiertes Recht behandelt werden.
Eine Einschränkung des Funktionsumfangs mit Stand September 2026: Policy-Subjekte sind Benutzer, Teams und virtuelle Konten — keine Agenten. Policies, die auf Agenten-Identitäten basieren, kontextbezogene Bedingungen über Delegierungsketten hinweg sowie Hooks auf dem Agent Gateway selbst sind laut Dokumentation in Vorbereitung.
Die Guardrail-Ansicht des Metrics Dashboards zählt die ausgewerteten (Requests evaluated), veränderten (Mutated) und blockierten (Flagged) Anfragen. Sie visualisiert die Anfragen pro Sekunde nach Ergebnis — allowed, blocked, mutated, audit_mode_blocked — sowie die Block- und Mutations-Raten pro Guardrail und die Latenz bei P50 / P75 / P90 / P99, filterbar nach Guardrails, Benutzern, virtuellen Konten oder Teams.
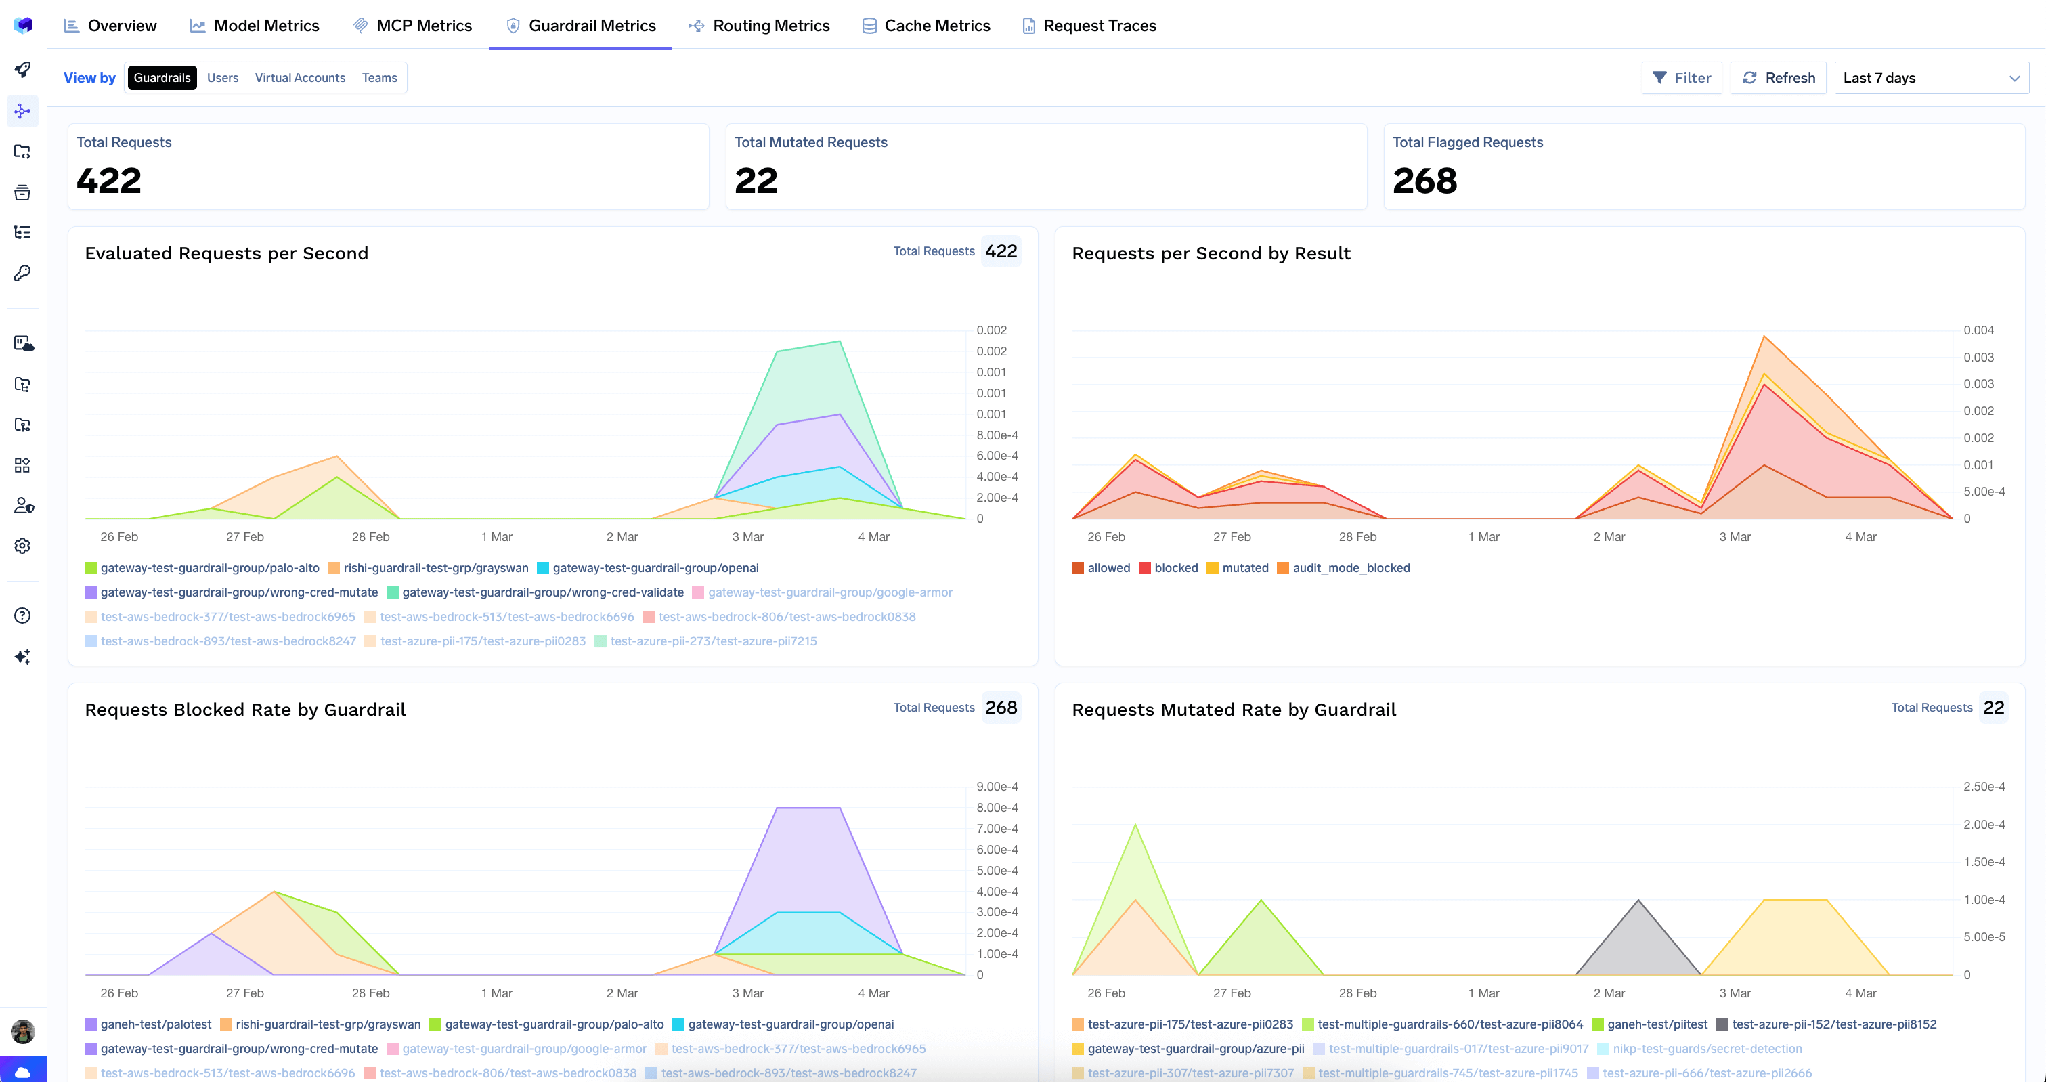
audit_mode_blocked ist die entscheidende Kennzahl für eine schrittweise Einführung über den Audit-Modus: Sie zählt, was blockiert worden wäre, sodass Sie den Auswirkungsbereich vor der endgültigen Durchsetzung analysieren können.
Eine Kampagne gegen einen Kundensupport-Agenten liefert drei Erkenntnisse: Eine indirekte Injection in einem Wissensdatenbank-Artikel bringt den Agenten dazu, ein internes Tool aufzurufen, das er nicht nutzen sollte; der Agent gibt eine Kunden-Telefonnummer in einer Zusammenfassung aus; eine gezielte Anfrage führt zu einer Schleife aus zwölf Tool-Aufrufen.
Erkenntnisse den Hooks zuordnen. Die dokumentierte Basis für Agenten-Datenverkehr bildet den Ausgangspunkt: PII-Schwärzung (Mutate) und Prompt-Injection-Erkennung (Validate) beim Input; Secrets Detection beim Output; SQL Sanitizer und Code-Safety-Linter vor dem Tool-Aufruf; PII- und Secrets-Schwärzung nach dem Tool-Aufruf. Für den Injection-Befund ist der Post-Tool-Hook entscheidend, da hier der präparierte Artikel in den Kontext gelangt.
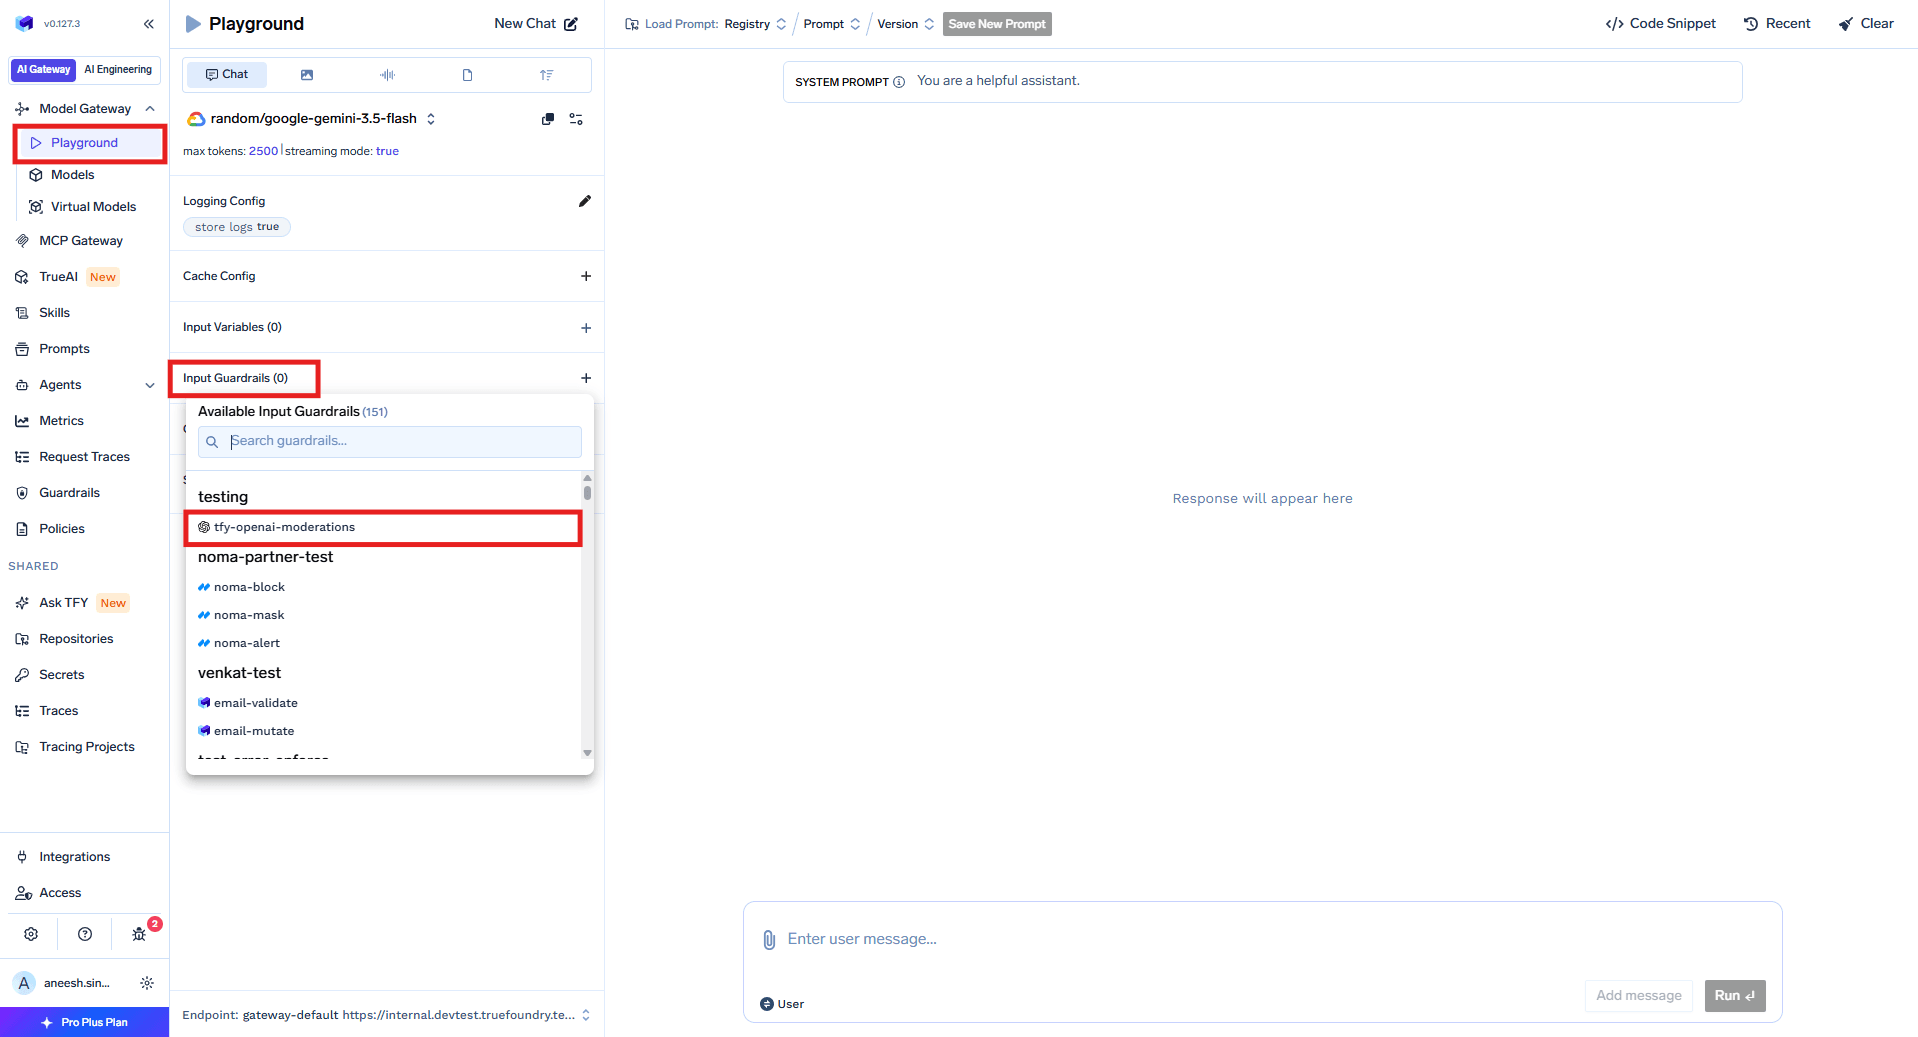
Zuerst im Playground testen. Alle vier Hooks lassen sich unter AI Gateway → Playground testen; die Schaltfläche Code generiert ein Snippet mit vorausgefülltem X-TFY-GUARDRAILS-Header.
Binden Sie eine Policy im Audit-Modus ein, beschränkt auf die Modelle und MCP-Server dieses Agenten, und beobachten Sie diese eine Woche lang — ein Detektor, der bei 8 % der legitimen Tickets anschlägt, kann noch nicht durchgesetzt werden. Stufen Sie dann auf Enforce But Ignore On Error hoch und legen Sie eine benutzerdefinierte Fehlermeldung fest (hinter der Option Hide advanced fields), die {{guardrail_message}} und {{failed_guardrails}} unterstützt.
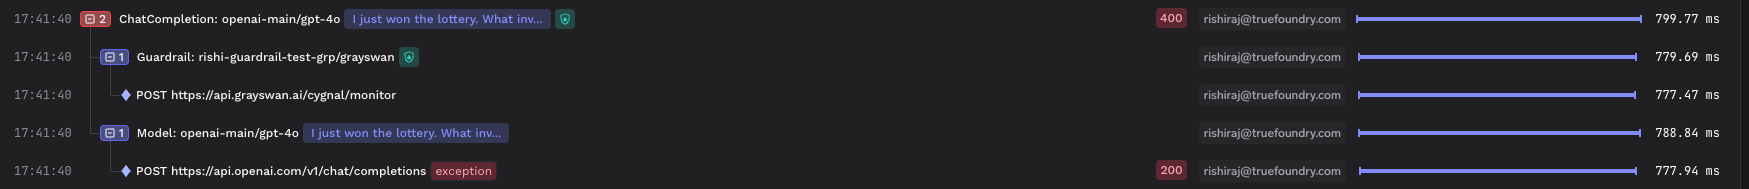
In den Traces verifizieren. Jede Guardrail wird als eigener Span unter Monitor → Request Traces mit Ausführungszeit, Ergebnis, Scope und Mutation angezeigt. Blockierungen liefern HTTP 400 mit error.type = "guardrail_checks_failed".

Beheben Sie das Schleifen-Problem an anderer Stelle. Die Schleife aus zwölf Tool-Aufrufen ist ein Rate-Limit- und Budget-Problem. Keine Guardrail schützt vor einer Schleife, deren einzelne Iterationen jeweils korrekt formatiert sind.
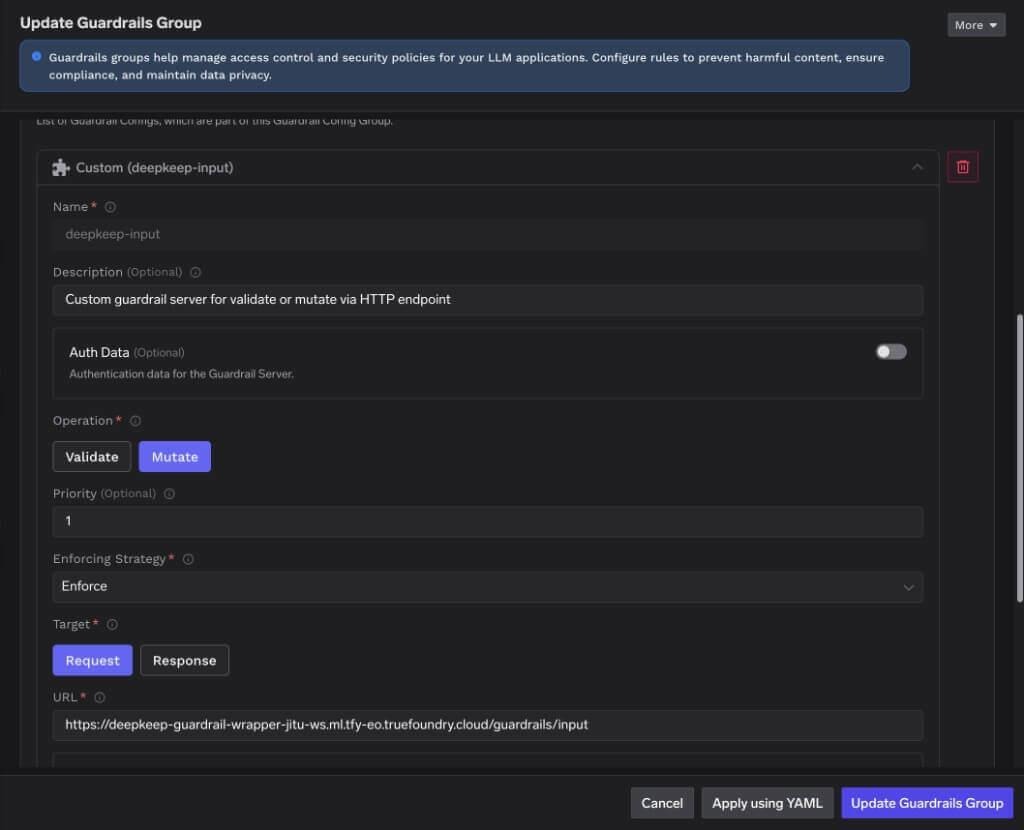
Die Reihenfolge der Regelausführung kann eine Blockierung in ein Zulassen verwandeln. DeepKeep wendet Priorität nach der erstgenannten Regel unter den angeschlagenen Regeln an — nicht nach der schwerwiegendsten Aktion. Wichtig: Ordnen Sie den PII Detector vor der Adversarial Prompt Defense ein, wird ein Jailbreak, der zusätzlich PII enthält, geschwärzt und durchgelassen, anstatt blockiert zu werden: Die Schwärzung gewinnt, weil sie an erster Stelle stand, und der Jailbreak passiert das System mit einer unkenntlich gemachten Telefonnummer. Die dokumentierte Lösung ist die empfohlene Reihenfolge — Credentials Leakage → PII → Adversarial → Toxic — oder noch besser die Aufteilung auf zwei Firewalls: Adversarial Prompt Defense ausschließlich auf der Pre-Firewall, Zugangsdaten und PII auf der Post-Firewall.
Output-Guardrails werden bei Streaming-Antworten übersprungen. Bei stream: true werden sie überhaupt nicht ausgeführt, da für die Auswertung einer Antwort der vollständige Text vorliegen muss. Input-Guardrails laufen hingegen immer. Da fast alle Chat-Oberflächen standardmäßig streamen, deaktiviert dies die outputseitigen Schutzmaßnahmen dort, wo Benutzer sie direkt sehen.
System-Prompts werden niemals überprüft. Das Gateway entfernt sie, bevor der Inhalt an eine Guardrail gesendet wird; CrowdStrike AIDR bildet die einzige dokumentierte Ausnahme und nimmt ebenfalls keine Änderungen daran vor. Die Aussage „Wir scannen den gesamten Prompt“ trifft somit technisch nicht zu.
Wenn Sie einen eigenen Detektor schreiben, geben Sie HTTP 2xx zurück. Die Schnittstellenvereinbarung für benutzerdefinierte Guardrails ist eindeutig: HTTP 2xx bedeutet, dass die Guardrail vollständig ausgeführt wurde, wobei das Ergebnis im Response-Body als verdict: false übergeben wird. Das Signalisieren einer Blockierung über einen 400-Fehler ist ein dokumentierter Fehlerfall — das Gateway wertet dies möglicherweise als Systemfehler und lässt die Anfrage passieren.
Es handelt sich um zwei Bausteine, die einander ergänzen. Kampagnen decken auf: punktuell, aufwendig und der einzige Weg, eine Schwachstellenkategorie zu entdecken, für die noch kein Detektor existiert. Durchsetzung schützt dauerhaft: kontinuierlich, kostengünstig pro Anfrage, jedoch wirkungslos gegen Angriffe, die dem System unbekannt sind. Ein Sicherheitskonzept, das nur auf dem ersten Baustein basiert, erzeugt lediglich Berichte; ein Konzept, das sich nur auf den zweiten stützt, wiegt sich in trügerischer Sicherheit.
TrueFoundry ordnet sich eindeutig in der zweiten Hälfte ein, und wir sagen das lieber direkt, anstatt es nur anzudeuten. Das Gateway bietet Ihnen einen zentralen Ort, um die Erkenntnisse über jedes Modell, jedes Team und jeden MCP-Tool-Aufruf hinweg durchzusetzen. Wo es aufhört, ist bei der Generierung der Angriffe. Wenn ein Anbieter behauptet, seine Firewall mache Red Teaming überflüssig, fragen Sie ihn, auf welche Angriffsklassen seine Detektoren trainiert wurden und wann – führen Sie die Kampagne dann trotzdem aus und setzen Sie durch, was sie zutage fördert.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.




Adversariales Testen eines KI-Systems – Modell, Prompts, abgerufener Kontext und Tools zusammen –, um Eingaben zu finden, die es gegen Ihre Absicht handeln lassen. Die Klassen sind Jailbreaks, direkte und indirekte Prompt Injection, Datenexfiltration, Tool-Missbrauch und ressourcenerschöpfende „Sponge“-Angriffe. Es unterscheidet sich vom Penetrationstest, weil die Angriffsfläche natürliche Sprache ist, die Ergebnisse probabilistisch sind und ein Modell-Upgrade eine bereits geschlossene Klasse wieder öffnen kann.
Nein. Eine LLM-Firewall ist Durchsetzung zur Laufzeit: Inline-Guardrails, die jede Anfrage prüfen, umschreiben oder blockieren. Red Teaming ist Offline-Erkennung: Kampagnen, die Angriffe erzeugen und berichten, was funktioniert hat. Kampagnen zeigen Ihnen, was durchzusetzen ist; die Durchsetzung sorgt dafür, dass der Befund Sie nichts mehr kostet.
Nicht im Sinne von Kampagnen. Es liefert die Hälfte der Durchsetzung zur Laufzeit: Guardrails an vier Hooks, zehn native integrierte Guardrails, rund zwanzig Partnerintegrationen, Richtlinienbindung nach Modell, MCP-Server, Tool, Nutzer, Team oder virtuellem Konto sowie Metriken pro Guardrail. Angriffsgenerierung, ein adversariales Korpus, geplante Scans oder Red-Team-Berichte sind nicht dokumentiert. Mehrere Partner sind Sicherheitsanbieter mit eigenen Kampagnenfunktionen.
Ja. TrueFoundry läuft in Ihrer VPC, On-Prem, Air-Gapped oder hybrid, sodass Prompts und Antworten Ihre Domäne nie verlassen, auch wenn Sie über viele Anbieter hinweg routen.
Ja. Es umfasst ein MCP Gateway, ein Agent Gateway und eine MCP & Agents Registry mit Zugriffskontrolle auf Tool-Ebene. Agenten auf Basis von LangGraph, CrewAI, AutoGen oder einem eigenen Framework lassen sich alle zentral steuern.
Ja. Das Gateway ist OpenTelemetry-kompatibel und lässt sich in Grafana, Datadog, Prometheus oder Ihren bevorzugten Stack integrieren. Es verfolgt jede Anfrage vom Prompt bis zur Ausführung von Tools und Modellen, sodass Sie eine einheitliche Protokollierung erhalten, ohne Ihre bestehenden Systeme entfernen zu müssen.



Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet


















