



November 20, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Human in the Loop (HITL) für MCP ist eine Gateway-Policy, die ausgewählte Tool-Aufrufe pausiert, bis eine benannte Person diese genehmigt oder ablehnt. So können Unternehmen AI-Agenten echte Autonomie gewähren, ohne jede unumkehrbare Aktion in ein unkontrolliertes Risiko zu verwandeln.
Authentifizierung weist nach, wer der Agent ist. Autorisierung weist nach, was er aufrufen darf. HITL beantwortet die finale Frage, die keine von beiden beantworten kann: Sollte diese spezifische Aktion jetzt ausgeführt werden? Ohne HITL kann ein einziger autorisierter Fehler zu einem P1-Vorfall führen, einen pauschalen Entzug des Schreibzugriffs für Agenten auslösen und das gesamte Agenten-Programm stoppen.
Der Unterschied zwischen TrueFoundry und Kong läuft darauf hinaus, wo die menschliche Genehmigung stattfindet. Kong agiert als zustandsloses API Gateway: Es evaluiert jeden MCP Tool-Aufruf und autorisiert oder lehnt ihn synchron ab, ohne den für das Pausieren und Fortsetzen einer Anfrage erforderlichen Workflow-Status zu verwalten. TrueFoundry kann einen Tool-Aufruf am Gateway halten, zugewiesene Genehmiger benachrichtigen und eine zweckgebundene, zeitlich begrenzte Freigabe erteilen. Unternehmen, die Kong nutzen, müssen diesen menschlichen Genehmigungs-Workflow selbst entwickeln und betreiben.
Stellen Sie sich das Platform-Team eines Finanzdienstleisters vor. Seine Agenten greifen nur über ein MCP Gateway auf interne Systeme zu. Identität, RBAC und Audit-Logging sind bereits eingerichtet. Ein Cleanup-Agent hat Zugriff auf Kubernetes, Cloud-Accounts und Slack, einschließlich eines destruktiven Datenbank-Tools.
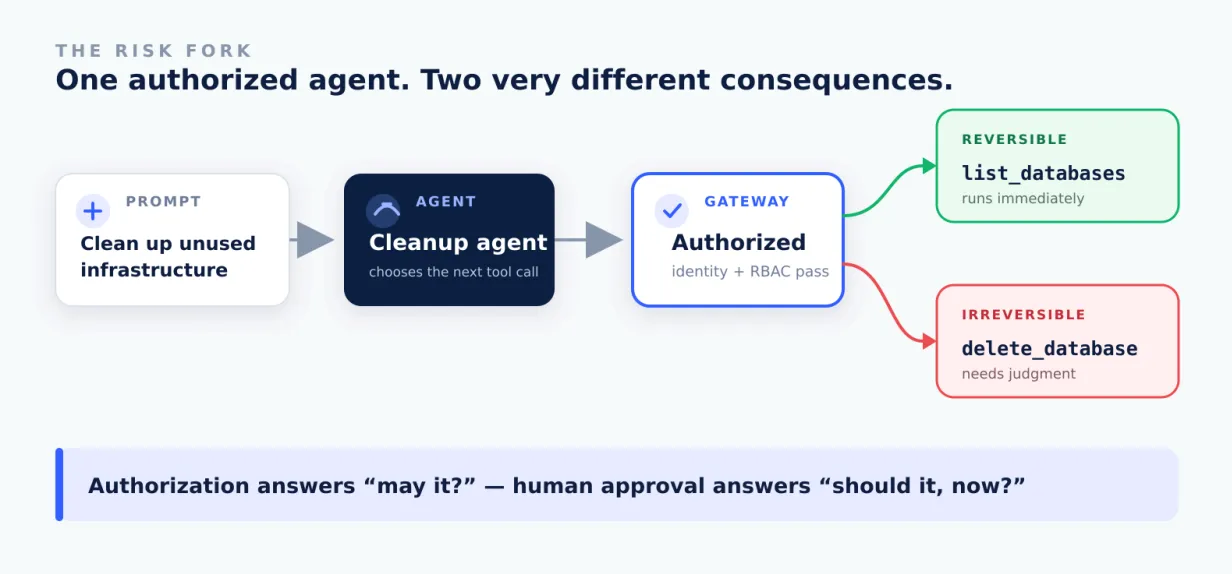
Geben Sie diesem Agenten nun einen plausiblen Prompt zum Quartalsende: „Räume ungenutzte Infrastruktur auf.“ Das Risiko wird sichtbar, wenn man die Anfrage von der Berechtigung bis zur Konsequenz verfolgt.
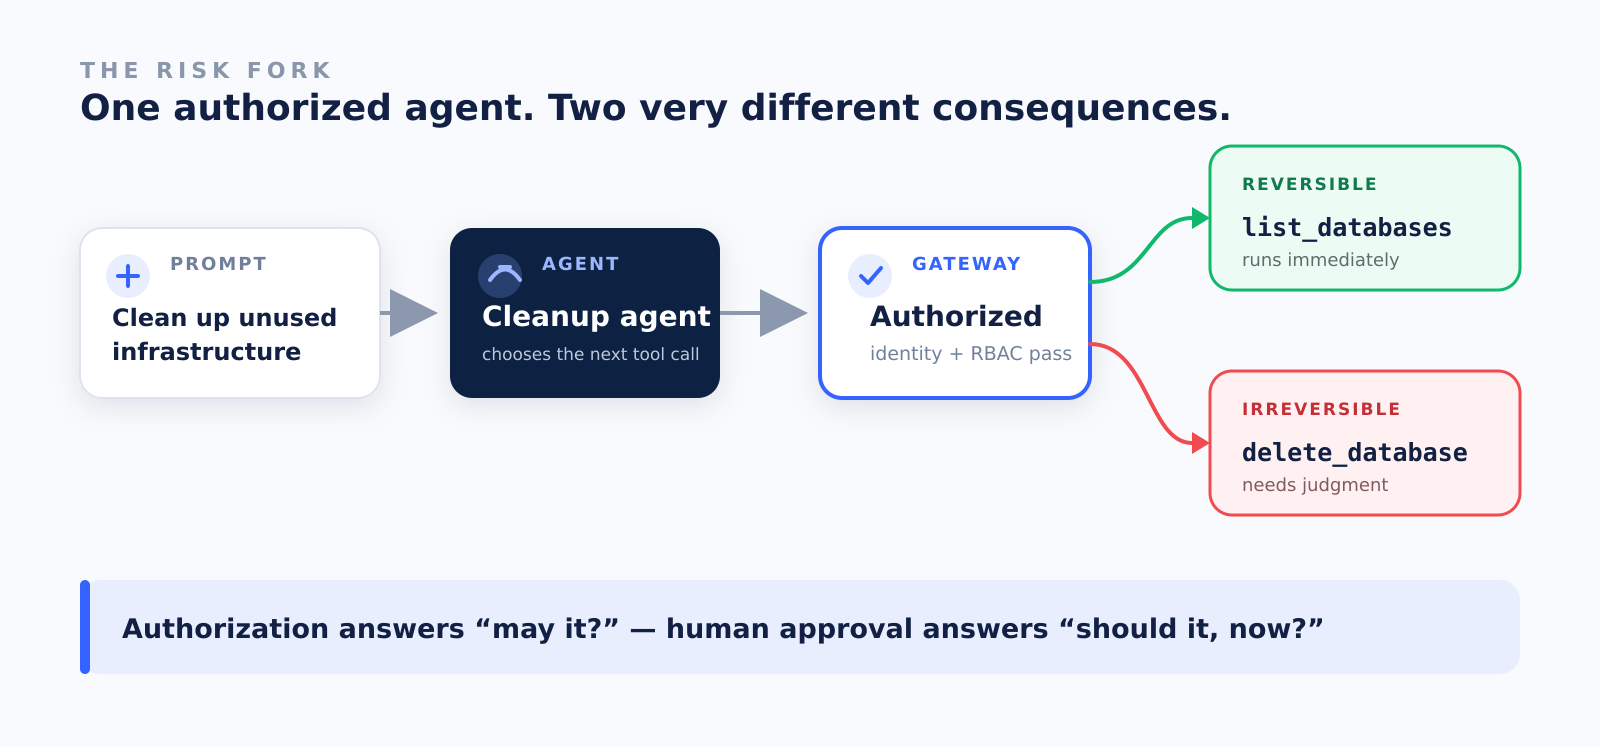
Abb. 01 · Eine Identität und ein Gateway autorisieren beide Pfade. Der Unterschied liegt nicht im Zugriff, sondern in der Konsequenz.
Der Agent beginnt mit harmloser Arbeit: Pods auflisten, inaktive Deployments skalieren und Datenbanken inventarisieren. Dann findet er db-fin-rpt-01, seit 34 Tagen ungenutzt. Die Heuristik meldet veraltet, also ruft er delete_database auf.
Der Aufruf ist gültig, authentifiziert, autorisiert und protokolliert. Das ist genau das Problem: Jede herkömmliche Kontrolle beantwortet die Frage, ob der Aufruf zulässig ist, während keine fragt, ob diese unumkehrbare Aktion jetzt sinnvoll ist.
Sobald der Aufruf ausgeführt wird, ist der technische Fehler behebbar. Der Vertrauensverlust in die Autonomie des Agenten ist es nicht.
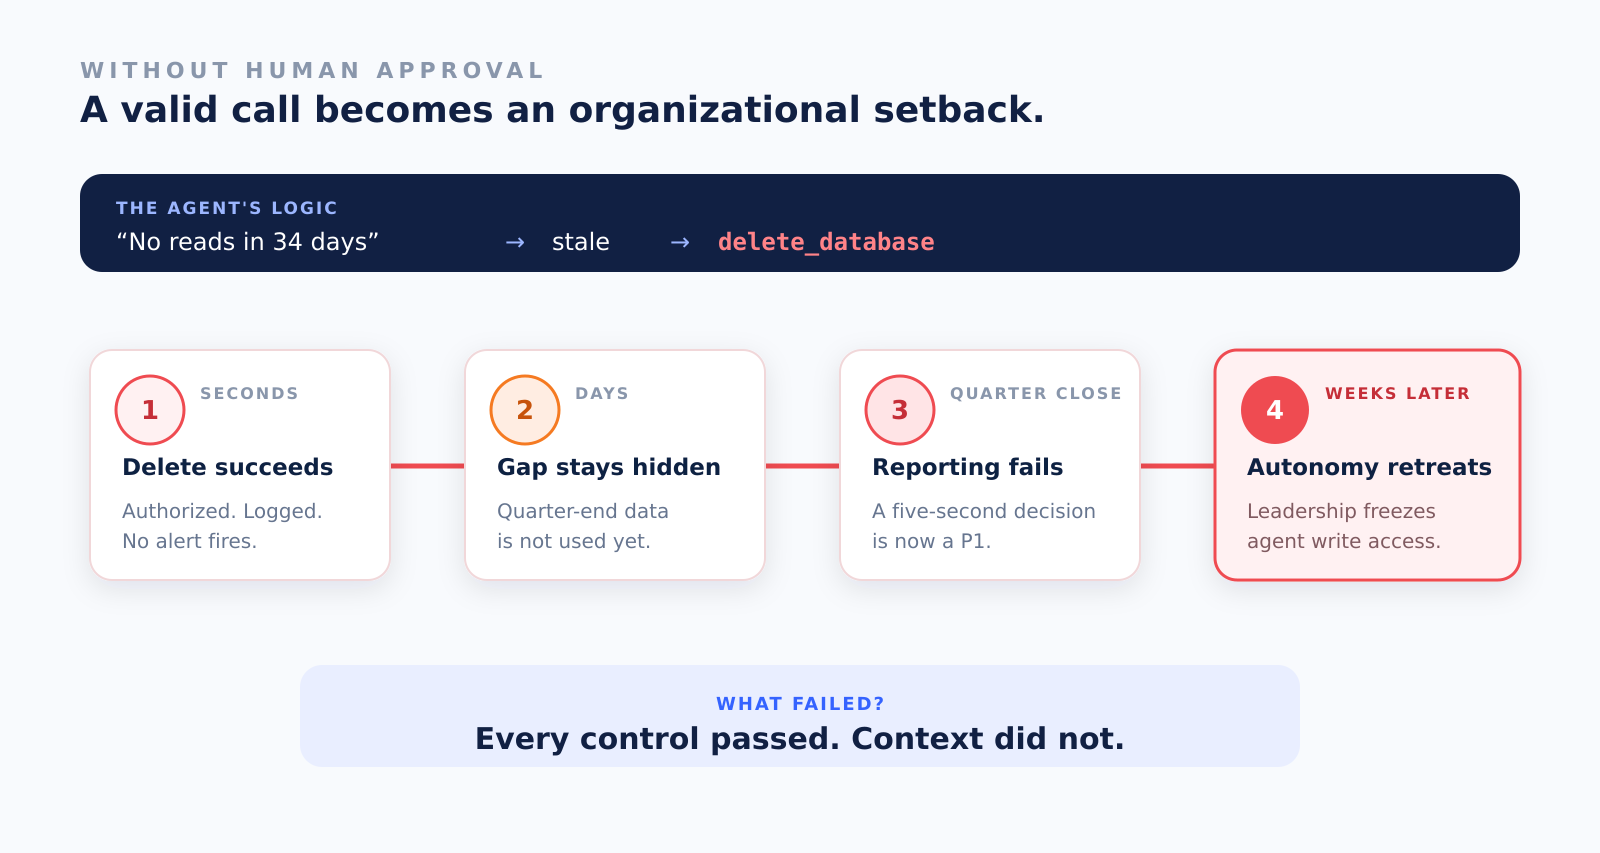
Abb. 02 · Eine gültige Löschung entwickelt sich von unsichtbar zu dringend und endet mit einem Stopp für den Schreibzugriff von Agenten.
Aus Sicht des VP Engineering lautet die Lektion nicht, dass dem Agenten Kontrollen fehlten – er hatte alle. Der Fehler war die fehlende Entscheidung zwischen Zulassen und Ablehnen. Eine kurze Genehmigung vor delete_database hätte sowohl den P1-Vorfall zum Quartalsende als auch den anschließenden Rückzug auf Read-Only-Agenten verhindern können.
Human-in-the-loop (HITL) schafft diesen dritten Pfad. Routinemäßige Lesezugriffe und umkehrbare Änderungen werden weiterhin mit Maschinengeschwindigkeit ausgeführt; Löschen, Bezahlen, Senden und Deployen warten auf eine benannte Person. Das Beispiel wird so zu einem Gateway-Policy-Problem und nicht zu einer Wiederherstellungslogik, die jedes Agenten-Team neu erfinden muss.
TrueFoundry macht diesen dritten Pfad zu einer First-Class MCP Gateway Policy. Platform-Teams definieren einmalig, welche Tools eine Genehmigung erfordern, und die Regel gilt übergreifend für alle Agenten, Clients und Frameworks.
Wendet man dies auf db-fin-rpt-01 an: Wenn der Agent delete_database aufruft, hält das Gateway die Anfrage vor der Ausführung an, benachrichtigt einen zugewiesenen Genehmiger und gibt eine Antwort mit ausstehender Genehmigung zurück, die der Agent sicher erneut versuchen kann. Eine Genehmigung erstellt eine zeitlich begrenzte Freigabe, die auf den Anforderer, den Server und das Tool beschränkt ist.
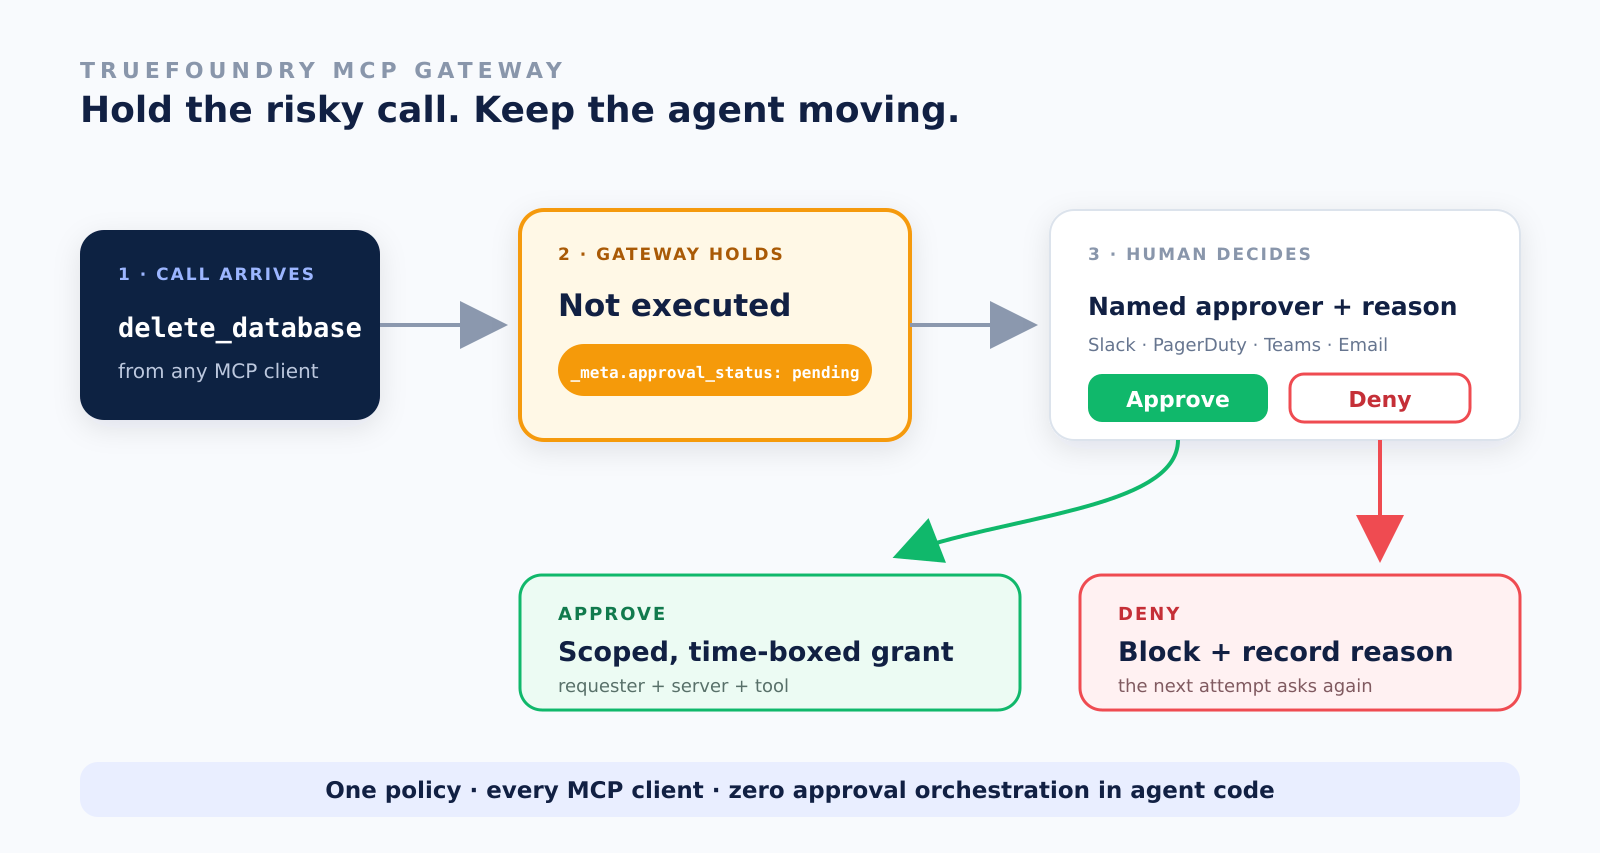
Da der Genehmigungsstatus am Gateway liegt, müssen Anwendungsteams Logiken für Pausieren, Fortsetzen, Benachrichtigungen, Ablehnungsbehandlung und Audits nicht für jeden Agenten neu implementieren. Nur Mandanten-Admins und zugewiesene MCP Server Approver können entscheiden.
Für das Platform-Team bleibt die Einrichtung eine reine Policy-Konfiguration: Server und Tools auswählen, Gültigkeitsfenster festlegen, Benachrichtigungskanal wählen und speichern. Wenn sich Regeln überschneiden, greift die restriktivste Policy. Diese Workflow-Grenze ist der Punkt, an dem der Vergleich mit Kong ansetzt.
Die MCP-Steuerungen von Kong authentifizieren Agenten, setzen Tool-ACLs durch und erlauben oder verweigern Aufrufe. Sie unterstützen jedoch keinen nativen Genehmigungs-Workflow, der einen ansonsten zulässigen Tool-Aufruf anhalten kann, während eine Person entscheidet.
Das ist die fehlende Schicht. HITL ist zustandsbehaftet: Das Gateway muss eine ausstehende Anfrage speichern, autorisierte Genehmiger benachrichtigen, die Entscheidung aufzeichnen und eine zweckgebundene, ablaufende Freigabe erteilen. Eine binäre Erlauben/Ablehnen-Entscheidung pro Anfrage kann diesen Workflow von sich aus nicht bieten.
Diese Kosten resultieren alle aus derselben architektonischen Grenze: Kong steuert die Anfrage, während das Unternehmen den Genehmigungs-Lebenszyklus darum herum selbst bauen muss. Der folgende Vergleich verdeutlicht diese Grenze.
Die Funktionstabelle lässt sich auf einen einzigen Live-Test reduzieren. Fragen Sie jeden Anbieter: „Ein autorisierter Agent fordert eine unumkehrbare Aktion auf einem MCP an. Zeigen Sie mir die menschliche Genehmigung, die Policy, die sie ausgelöst hat, und den resultierenden Audit-Trail.“
Wenn die Demo von benutzerdefiniertem Workflow-Code in jedem Agenten abhängt, ist die Genehmigung keine Plattform-Funktion, sondern Anwendungs-Technische Schulden.
Buchen Sie eine Demo und sichern Sie Ihren risikoreichsten Tool-Aufruf an einem Nachmittag ab, oder lesen Sie die Dokumentation zum Agent Gateway und MCP Gateway.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet

















