


November 13, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Jede andere KI-Workload läuft auf einer Infrastruktur, die Ihnen gehört – Ihrem Cluster, Ihrer Netzwerkrichtlinie, einem Anmeldeinformationssatz, den Sie rotieren können. Codex ist ein CLI-Prozess auf dem Laptop eines Entwicklers, der eine TOML-Datei im Home-Verzeichnis liest und direkt mit einem Modellanbieter kommuniziert. Fünf Eigenschaften machen dies zu einer völlig neuen Art von Problem:
Der übliche Reflex ist ein Richtliniendokument. Es scheitert aus einem Grund: Alles, was darin gefordert wird, steht in einer Datei, die der Entwickler bearbeiten kann.
Vier Eigenschaften müssen bei jeder Anfrage erfüllt sein:
Ein Gateway bietet Ihnen alle vier – aber nur, wenn der Client darauf verweist und auch weiterhin darauf verweistDafür gibt es drei Ansätze, aber nur einer davon ist eine echte Durchsetzung:
Das Sperren der Datei ohne Rotation des Tokens schützt zwar vor Manipulation, ignoriert aber den Diebstahl von Anmeldedaten; eine Rotation ohne Sperrung bewirkt das Gegenteil. Sie benötigen beides.
Das Konto des Modellanbieters als Kontrollpunkt zu betrachten. Identität, SSO, Workspace-Mitgliedschaft und die Admin-Konsole-Richtlinien für Codex liegen in der OpenAI-Konsole, nicht in Ihrem Gateway – ebenso wie die Aufbewahrung von Prompts und Ausgaben, die „durch Ihre Vereinbarung mit OpenAI geregelt“ wird. Ein Gateway steuert Routing, Ausgaben, Sicherheitsvorgaben und seine eigene Protokollierung, nicht Ihren Anbietervertrag.
Die Annahme, dass ein MDM-Push einer dauerhaften Durchsetzung gleichkommt. Clients ändern die Konfigurationspriorität zwischen Releases. Codex v0.149.0 hat die managed_config.toml unter Windows komplett entfernt – die Datei wird nun ignoriert und eine Warnung beim Start ausgegeben (Ignoring deprecated managed config file), ohne ein Äquivalent in der Registry. Eine Flotte, die vor diesem Release konfiguriert wurde, ist nicht mehr geschützt und meldet keinen Fehler.
Die Verwendung eines gemeinsamen API-Schlüssels. Das ist der schnellste Weg, um dreißig Entwickler arbeitsfähig zu machen, zerstört aber sofort jede nachgelagerte Kontrolle. Sie können weder eine Person raten-limitieren noch die Frage „Wer hat diesen Prompt gesendet?“ anhand von mandantenweiten Anmeldedaten beantworten.
Codex behandelt das TrueFoundry AI Gateway als Modellanbieter; alles Weitere ergibt sich daraus, dass der Datenverkehr an einem Ort ankommt, den Sie kontrollieren. Die Gateway-Details finden Sie im Code-Schnipsel in der Benutzeroberfläche.
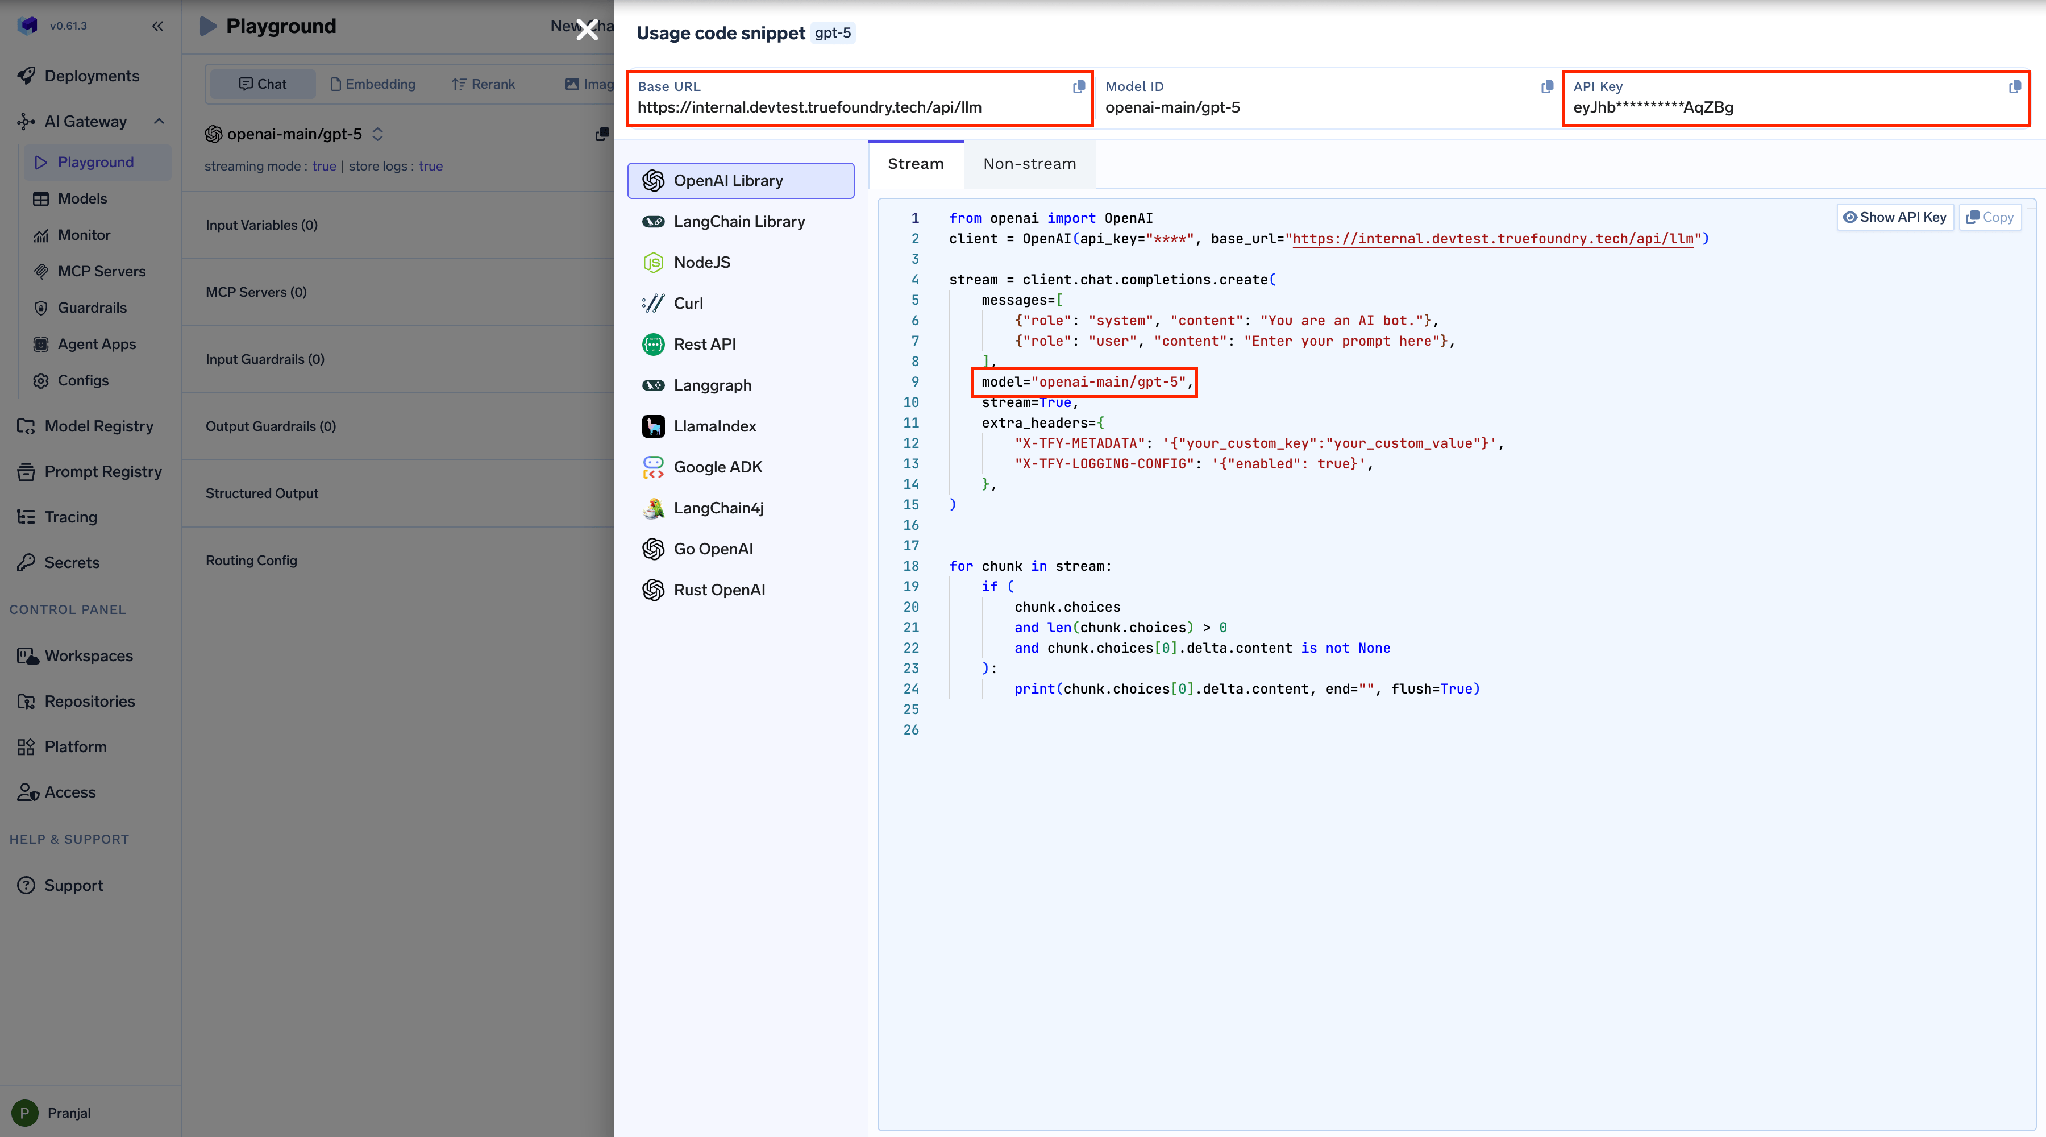
Die Form für Einzelentwickler: Das Token wird unter Authorization eingetragen und das Gateway ordnet es einer Person zu.
model = "gpt-5.2-codex"
model_provider = "truefoundry"
[model_providers.truefoundry]
name = "TrueFoundry AI Gateway"
base_url = "{GATEWAY_BASE_URL}"
wire_api = "responses"
[model_providers.truefoundry.http_headers]
Authorization = "Bearer TFY_API_KEY"
Das ChatGPT-Abonnement des Entwicklers deckt die Inferenzkosten ab, während das Gateway weiterhin den Datenverkehr steuert. Zwei Dinge ändern sich: requires_openai_auth = true und der TrueFoundry-Anmeldeinformation wird von Authorization in x-tfy-api-key verschoben, da Codex das Feld Authorization für sein eigenes ChatGPT-OAuth-Token benötigt.
model = "gpt-5.2-codex"
model_provider = "truefoundry"
[model_providers.truefoundry]
name = "TrueFoundry AI Gateway"
base_url = "{GATEWAY_BASE_URL}"
wire_api = "responses"
requires_openai_auth = true
[model_providers.truefoundry.http_headers]
x-tfy-api-key = "TFY_API_KEY"
Erstellen Sie auf der Gateway-Seite einen Anbieter unter Integrationen → Anbieter vom Typ OpenAI, Basis-URL https://chatgpt.com/backend-api/codex und lassen Sie das Feld für den API-Schlüssel leer.
Das leere Feld ist ein bewusstes Signal, kein Versehen. Wenn ein gespeicherter Schlüssel vorhanden ist, verwendet das Gateway diesen anstelle der ChatGPT-Anmeldedaten des Entwicklers – dies unterbricht den Abonnement-Ablauf und führt möglicherweise dazu, dass der Datenverkehr über das falsche Konto geleitet wird. Ein Administrator, der dieses Feld „hilfsbereit“ ausfüllt, fasst dreißig individuell zugeordnete Entwickler zu einem einzigen anonymen API-Schlüssel-Nutzer zusammen, ohne dass dabei eine Fehlermeldung erscheint.
Bleibt das Feld leer, erhalten Sie eine doppelte Zuordnung: TrueFoundry erfasst den Entwickler über den x-tfy-api-key, und OpenAI ordnet die Nutzung dem jeweiligen ChatGPT-Konto zu. Modell-IDs sehen dann wie chatgpt-codex/gpt-5.2-codex aus.
Da die Anmeldedaten an ein einzelnes ChatGPT-Konto gebunden sind, ergeben sich daraus zwei Einschränkungen. Nur eines der Ziele eines virtuellen Modells kann ein Konto mit ChatGPT-Abonnement sein; Ziele, die auf API-Schlüsseln basieren, können parallel dazu existieren. Zudem führt ein 401-, 403- oder 429-Fehler eines einzelnen Entwicklers nicht dazu, dass das gemeinsam genutzte Ziel in den Load-Balancer-Cooldown versetzt wird, sodass das aufgebrauchte Kontingent eines Entwicklers keine Auswirkungen auf andere hat.
(Die Dokumentation widerspricht sich bezüglich der Tarifberechtigung: Die Seite zur Unternehmenssicherheit nennt Business oder Enterprise, die CLI-Seite führt auch Personal auf. [ÜBERPRÜFEN] Sie dies, bevor Sie einen Tarif zusagen.)
Dies ist die Zeile, die Teams häufig falsch kopieren und dann einen Nachmittag lang debuggen. Das Gateway hängt den Endpunkt /responses nur an den Responses-Wire an. Wenn Sie wire_api = "chat" setzen, geht die Anfrage an /chat/completions unter derselben Basis-URL, was für Codex-Datenverkehr kein gültiger Endpunkt ist. Dies sorgt auch dafür, dass sich die Thinking-Tokens bei gpt-5.x-codex korrekt verhalten.
Die Codex-CLI-Seite drückt es etwas vorsichtiger aus – responses für gpt-5.x-codex, chat für andere Modelle. Beides lässt sich vereinbaren: Für Modelle der Codex-Familie ist der Responses-Wire zwingend erforderlich.
Codex sendet Thinking-Tokens an bestimmte Modelle und identifiziert diese durch Abgleich der Modell-Zeichenfolge. Vollqualifizierte Namen – wie openai-main/gpt-5 oder azure-openai/gpt-5 – stimmen nicht überein, wodurch die Funktionserkennung fehlschlägt.
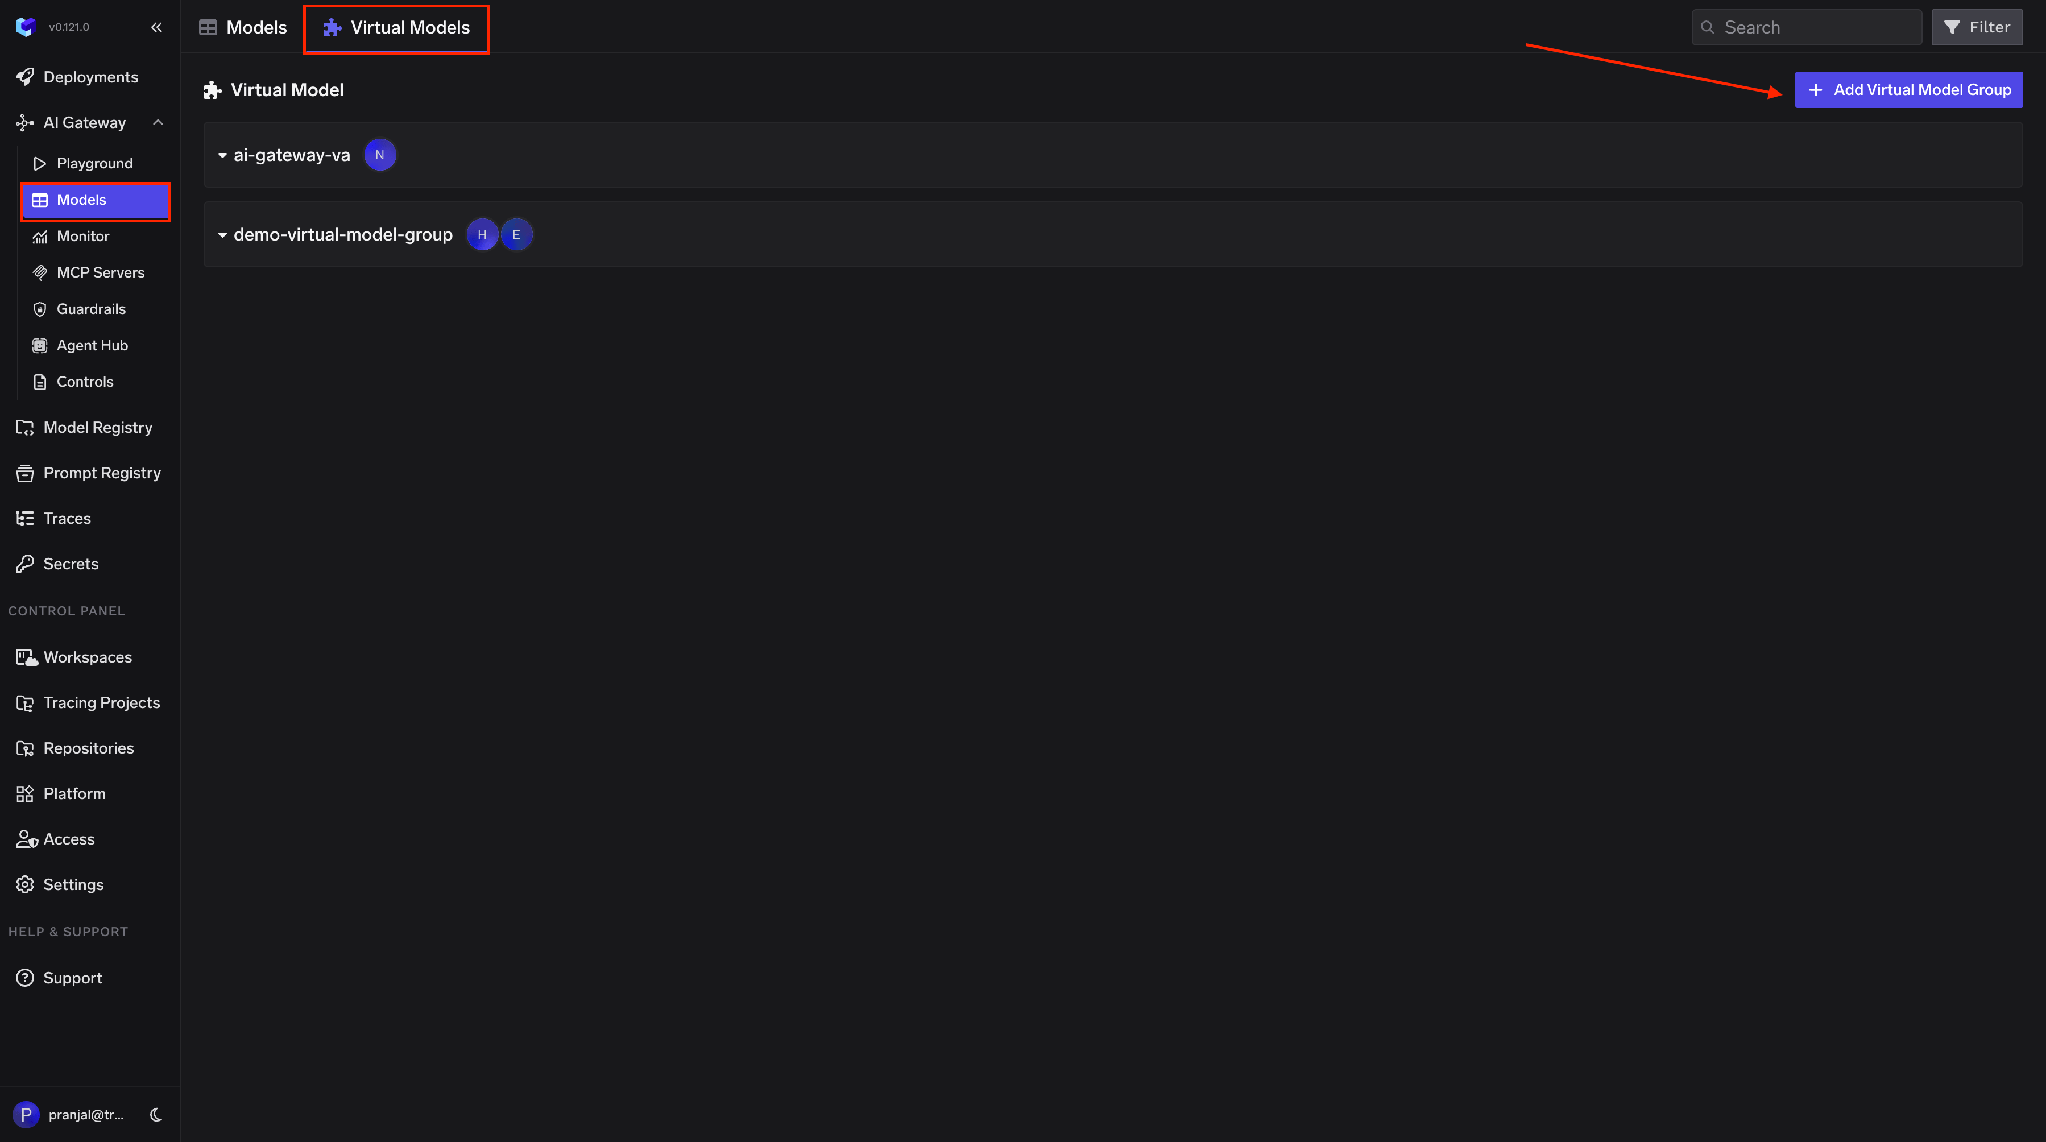
Liste der virtuellen TrueFoundry-Modelle mit den konfigurierten Slugs und ihren Provider-Zielen
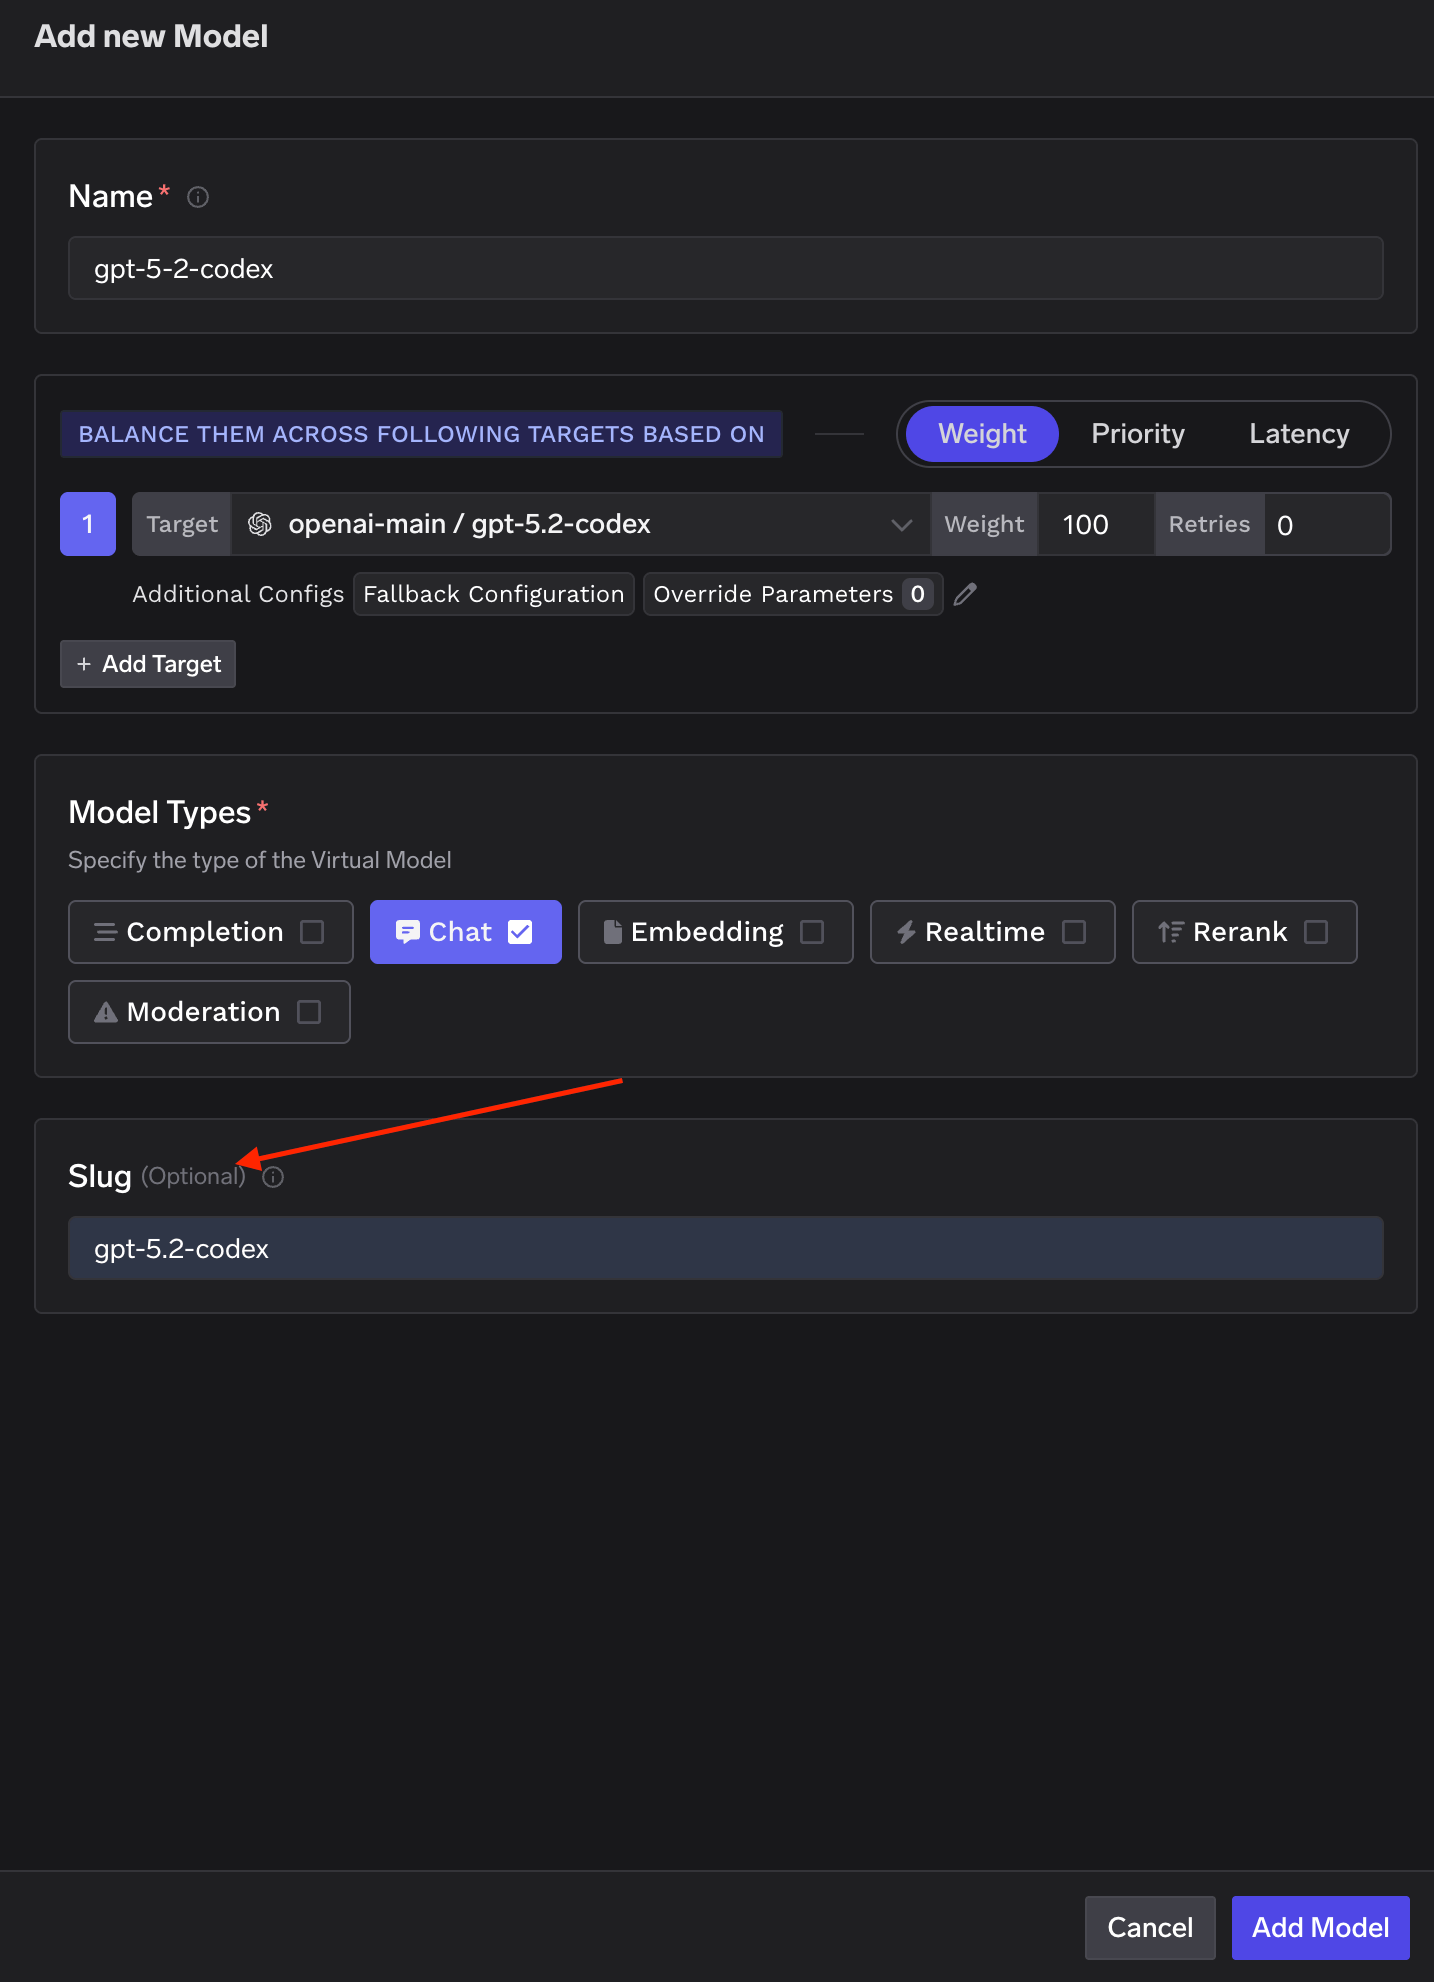
Die Regel lautet: verwenden Sie einen Slug, der der tatsächlichen Modell-ID entspricht, z. B. gpt-5.2-codex. Codex erkennt diese IDs und aktiviert die entsprechenden Funktionen. Geben Sie nicht den voll qualifizierten Namen in der Codex-Konfiguration an.
Detailansicht des virtuellen Modells mit dem Slug und seinen lastverteilten Provider-Zielen
Slugs sind mandantenweit eindeutig und werden festgelegt in Einstellungen der Virtual Model Provider Group. Sowohl der Slug als auch der vollständige Gruppen-/Modellpfad funktionieren im Request-Body; Codex benötigt jedoch das Slug-Format.
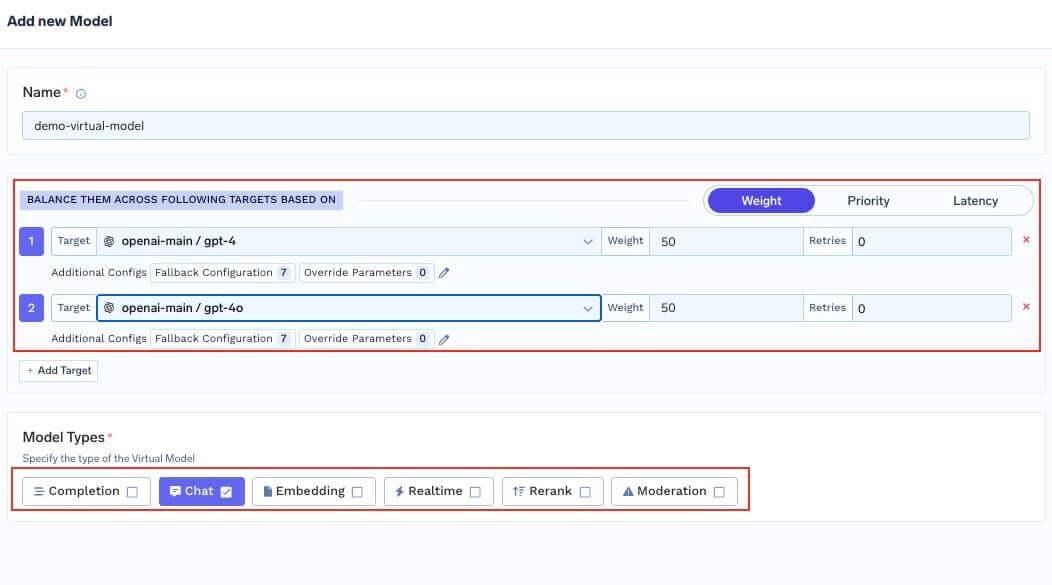
Navigation zum Konfigurationsbildschirm für virtuelle Modelle innerhalb einer Provider-Gruppe
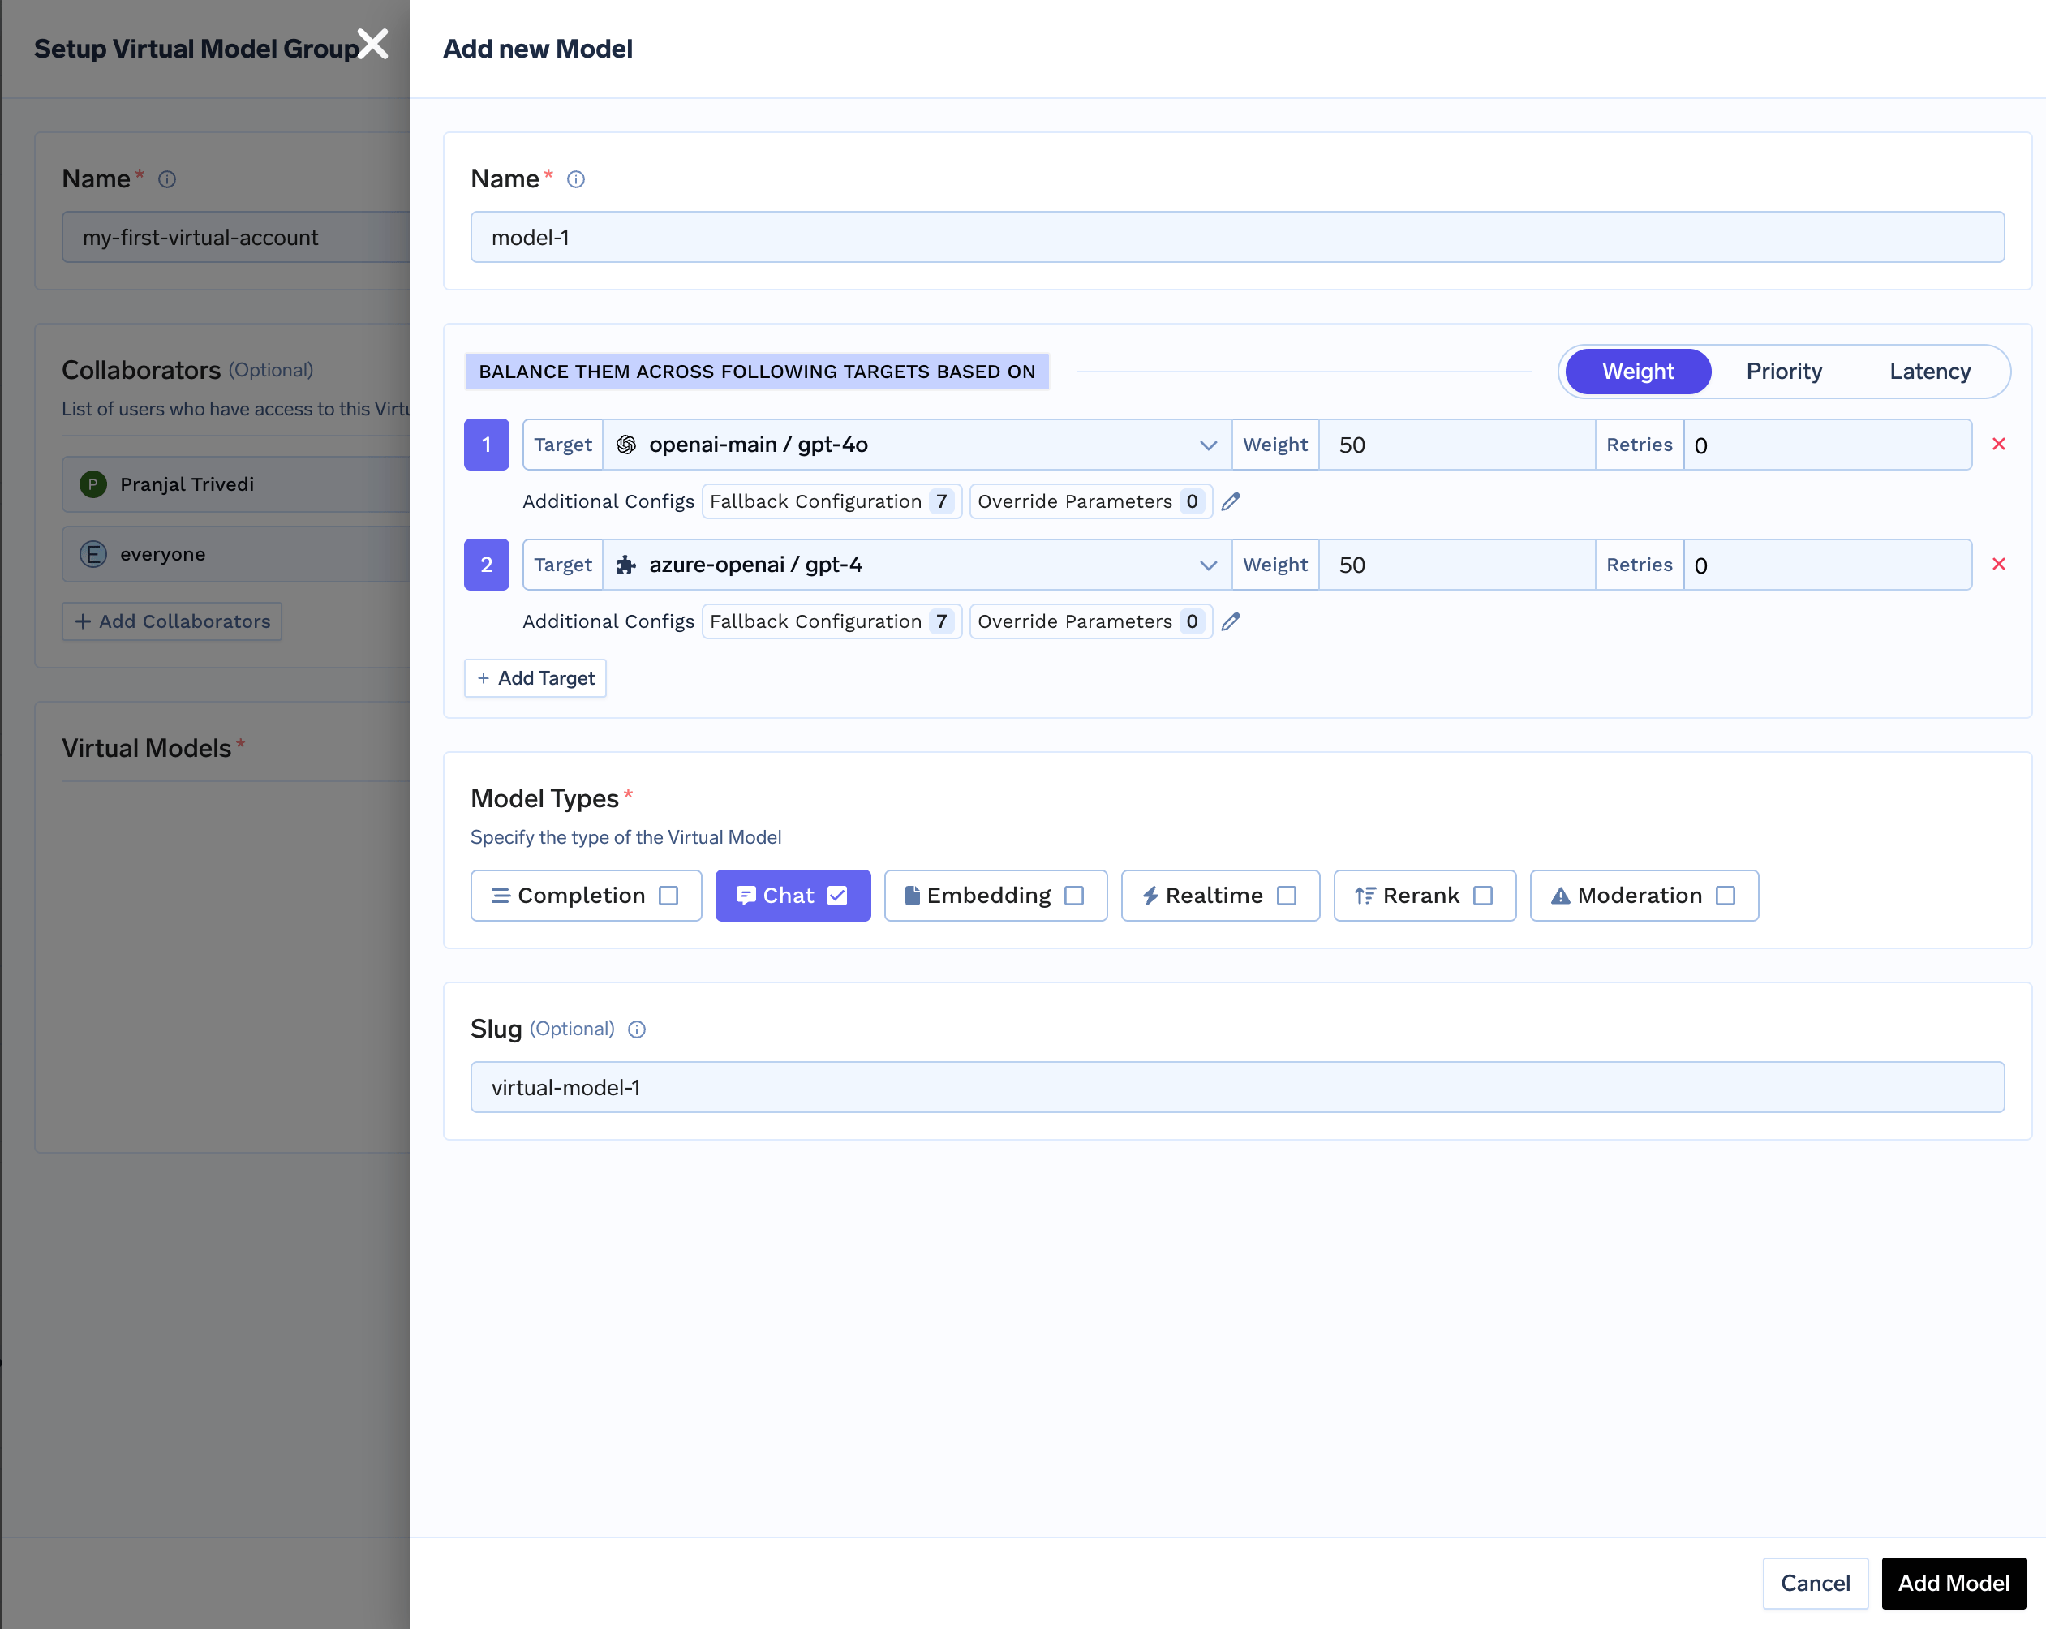
Slug-Feld für virtuelle Modelle im Formular für erweiterte Einstellungen
Hinter einem Slug können Sie Ziele gewichten – openai-main/gpt-5 mit 70, azure-openai/gpt-5 mit 30 – und die Mischung ändern, ohne einen Laptop anzufassen, wie bei Modell-Deprecations und schrittweisen Umstellungen.
Bei der Slug-Benennung unterscheiden sich Clients zudem stark. Cursor wählt sein Request-Format anhand von Slug-Schlüsselwörtern aus und wechselt das Format automatisch, wenn der Slug anthropic, claude, openai, gpt, gemini oder vertex enthält. Codex benötigt die Modell-ID im Slug; Cursor benötigt diese Schlüsselwörter außerhalb.
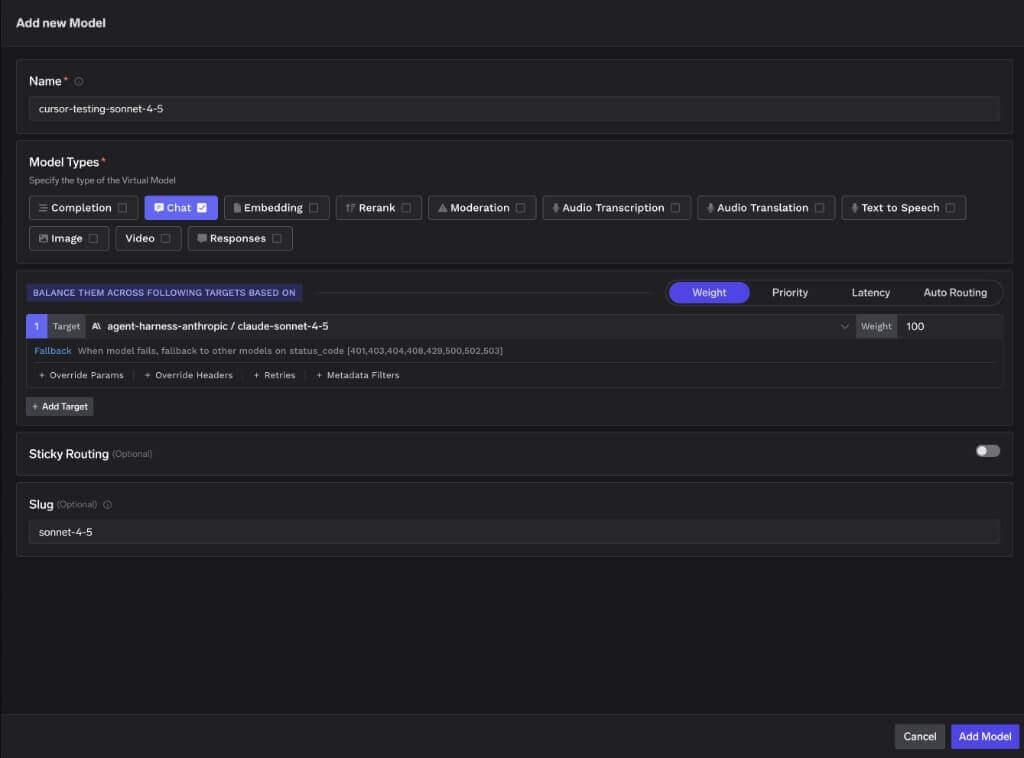
Konfigurationsformular für Cursor-Slugs virtueller Modelle
Eine Konfiguration pro Entwickler ist ein dokumentiertes Setup, keine Kontrolle. Die flottenweite Durchsetzung nutzt tfy-local-ai-setup, eine Binärdatei, die von Ihrem MDM übertragen und als Root ausgeführt wird (Administrator unter Windows) auf einem empfohlener stündlicher Rhythmus, von github.com/truefoundry/tfy-local-ai-setup/releases; die Codex-Skripte legen RELEASE_TAG="v1.3.5" fest. Jeder Durchlauf führt vier Schritte aus:
Schritt drei ist am wichtigsten. Der Laptop speichert niemals ein langlebiges Gateway-Token: Das Refresh-Token ist gültig für 30 Tage ab der letzten Ausstellung. Jeder erfolgreiche Durchlauf rotiert es, und die Anmeldedaten in der verwalteten Konfiguration werden neu abgerufen und auf die Identität des jeweiligen Benutzers beschränkt.
Erforderliche Konfiguration: GATEWAY_URL, CONTROL_PLANE_URL, TENANT_NAME. Optional: CODEX_GATEWAY_URL, CODEX_AUTH_MODE, CODEX_DEFAULT_MODEL, CODEX_SETTINGS_FILE. CODEX_AUTH_MODE="api-key" ist der Standard; "chatgpt-subscription" veranlasst die Binärdatei dazu, requires_openai_auth = true zu schreiben und das Token nach x-tfy-api-key zu verschieben. Rechner ohne Codex bleiben unberührt – die Binärdatei überspringt diese und wird beendet.
Auf macOS und Linux hat die Administrator-Datei Vorrang und wird bei jedem Start neu angewendet:
/etc/codex/managed_config.toml → ~/.codex/config.toml → CLI-Flags
model_provider = "truefoundry"
model = "gpt-5.2-codex"
[model_providers.truefoundry]
name = "TrueFoundry Gateway"
base_url = "https://<your-truefoundry-gateway-url>"
wire_api = "responses"
[model_providers.truefoundry.http_headers]
Authorization = "Bearer <freshly-fetched-tfy-token>"
Der übergeordnete Modellschlüssel wird nur geschrieben, nur wenn CODEX_DEFAULT_MODEL festgelegt ist; ist er nicht gesetzt, bleibt die Modellwahl beim Entwickler, während der Anbieter erzwungen bleibt.
Unter Windows ändern sich die Datei, die Reihenfolge und das Schema.
C:\ProgramData\OpenAI\Codex\requirements.toml → ~/.codex/config.toml → CLI flags → C:\ProgramData\OpenAI\Codex\config.toml
Beachten Sie die letzte Position: Die Windows-config.toml ist der maschinenweite Standard mit der niedrigsten Priorität der vier, sodass die eigene Datei eines Entwicklers Vorrang hat. requirements.toml hat Vorrang vor allem. Der Anbieterblock entspricht dem von macOS; die Modellfixierung jedoch nicht:
# C:\ProgramData\OpenAI\Codex\requirements.toml
model_provider = "truefoundry"
# ... gleicher [model_providers.truefoundry] und http_headers Block ...
[models.new_thread]
model = "gpt-5.2-codex"
Das Anforderungsschema besitzt keinen Modellschlüssel auf oberster Ebene. CODEX_DEFAULT_MODEL gehört stattdessen unter [models.new_thread]. Kopieren Sie den macOS-Block unverändert auf Windows; die Modellfixierung bleibt dort wirkungslos.
Zwei Versionsnummern entscheiden darüber, ob dies unter Windows tatsächlich greift. v0.149.0 führte dort managed_config.toml ein. v0.156.0 ist das Minimum für die Durchsetzung – Codex berücksichtigt model_provider in requirements.toml erst ab diesem Build; ältere Builds greifen auf die config.toml mit der niedrigsten Priorität zurück, die ein Entwickler von seinem Home-Verzeichnis aus überschreibt. Prüfen Sie codex --version, bevor Sie Windows als kontrolliert betrachten. Die Windows-Codex-Verwaltung im Setup-Binary ist ab tfy-local-ai-setup verfügbar v1.3.5.
Durch das Sperren wird die Datei zu einem Steuerelement:
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.




Vier Kontrollen, die ohne Mitwirkung der Entwickler greifen: eine Identität pro Entwickler bei jeder Anfrage, Admin-Kontrolle über die erreichbaren Modelle, Ausgaben, die einer Person und einem Team zugeordnet werden, und ein Audit, das auf dem Netzwerkpfad entsteht. In der Praxis: eine vom Admin verwaltete Konfigurationsdatei, die mit höherer Priorität gelesen wird als die des Entwicklers, eine Dateisperre und kurzlebige Anmeldedaten.
Ja. Setzen Sie requires_openai_auth = true, verschieben Sie die Gateway-Anmeldedaten nach x-tfy-api-key, damit Codex Authorization für sein eigenes ChatGPT-OAuth-Token verwenden kann, und legen Sie den Gateway-Provider mit leerem API-Key-Feld an – ein gespeicherter Schlüssel überschreibt die ChatGPT-Anmeldedaten des Entwicklers und unterbricht den Ablauf. So erhalten Sie die Identität des Entwicklers auf der Gateway-Seite und seinen ChatGPT-Seat auf der OpenAI-Seite.
Erst ab Codex v0.156.0. v0.149.0 hat die Unterstützung für managed_config.toml ohne Entsprechung in der Registry entfernt; die Durchsetzung wurde nach requirements.toml verlagert, ein anderes Schema ohne model-Schlüssel auf oberster Ebene. Unterhalb von v0.156.0 gilt nur die config.toml mit der niedrigsten Priorität, die von der eigenen Konfiguration eines Entwicklers überschrieben wird.
Ja. TrueFoundry läuft in Ihrer VPC, On-Prem, Air-Gapped oder hybrid, sodass Prompts und Antworten Ihre Domäne nie verlassen, auch wenn Sie über viele Anbieter hinweg routen.
Ja. Es umfasst ein MCP Gateway, ein Agent Gateway und eine MCP & Agents Registry mit Zugriffskontrolle auf Tool-Ebene. Agenten auf Basis von LangGraph, CrewAI, AutoGen oder einem eigenen Framework lassen sich alle zentral steuern.
Ja. Das Gateway ist OpenTelemetry-konform und lässt sich an Grafana, Datadog oder Prometheus anbinden. Jeder Aufruf des LLM-Klassifikators erzeugt einen eigenen Span, sodass die Latenz des Klassifikators getrennt von der des ausgelieferten Modells sichtbar ist.



Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet



















