October 12, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Published: October 8, 2026
Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Eine bedeutende Studie aus dem Jahr 2026 zur Sicherheit von LLM-Agenten kommt zu einem Schluss, den Unternehmen ernst nehmen sollten: Sobald ein Modell Werkzeuge nutzen, Zustände speichern und im Namen Dritter handeln kann, ist Sicherheit kein reines Problem der Prompt-Filterung mehr. Es wird zu einem Systemproblem, das folgende Bereiche umfasst: Informationsfluss, delegierte Befugnisse und persistenter Zustand.
Die Studie geht von einer einfachen architektonischen Tatsache aus: Ein LLM-Agent tut mehr, als nur Text zu generieren. Er kann planen, Werkzeuge aufrufen, im Web surfen, Code ausführen, Zustände aktualisieren und sich mit anderen Agenten koordinieren. Diese Fähigkeiten machen Modellausgaben zu Eingaben für den Software-Kontrollfluss.
Das verändert die Fehleranfälligkeit. Eine bösartige Anweisung, die auf einer Webseite versteckt ist, kann einen späteren Werkzeugaufruf beeinflussen. Ein manipuliertes Werkzeugergebnis kann zum Kontext für eine weitere Entscheidung werden. Ein kompromittierter Speichereintrag kann die ursprüngliche Sitzung überdauern. Ein delegierter Berechtigungsnachweis kann aus einem schlechten Plan eine reale Auswirkung machen. In einem Multi-Agenten-System können sich dieselben kontaminierten Informationen über den Agenten hinaus verbreiten, der sie zuerst empfangen hat.
Die Studie definiert Agenten-Sicherheit daher über drei interagierende Eigenschaften:
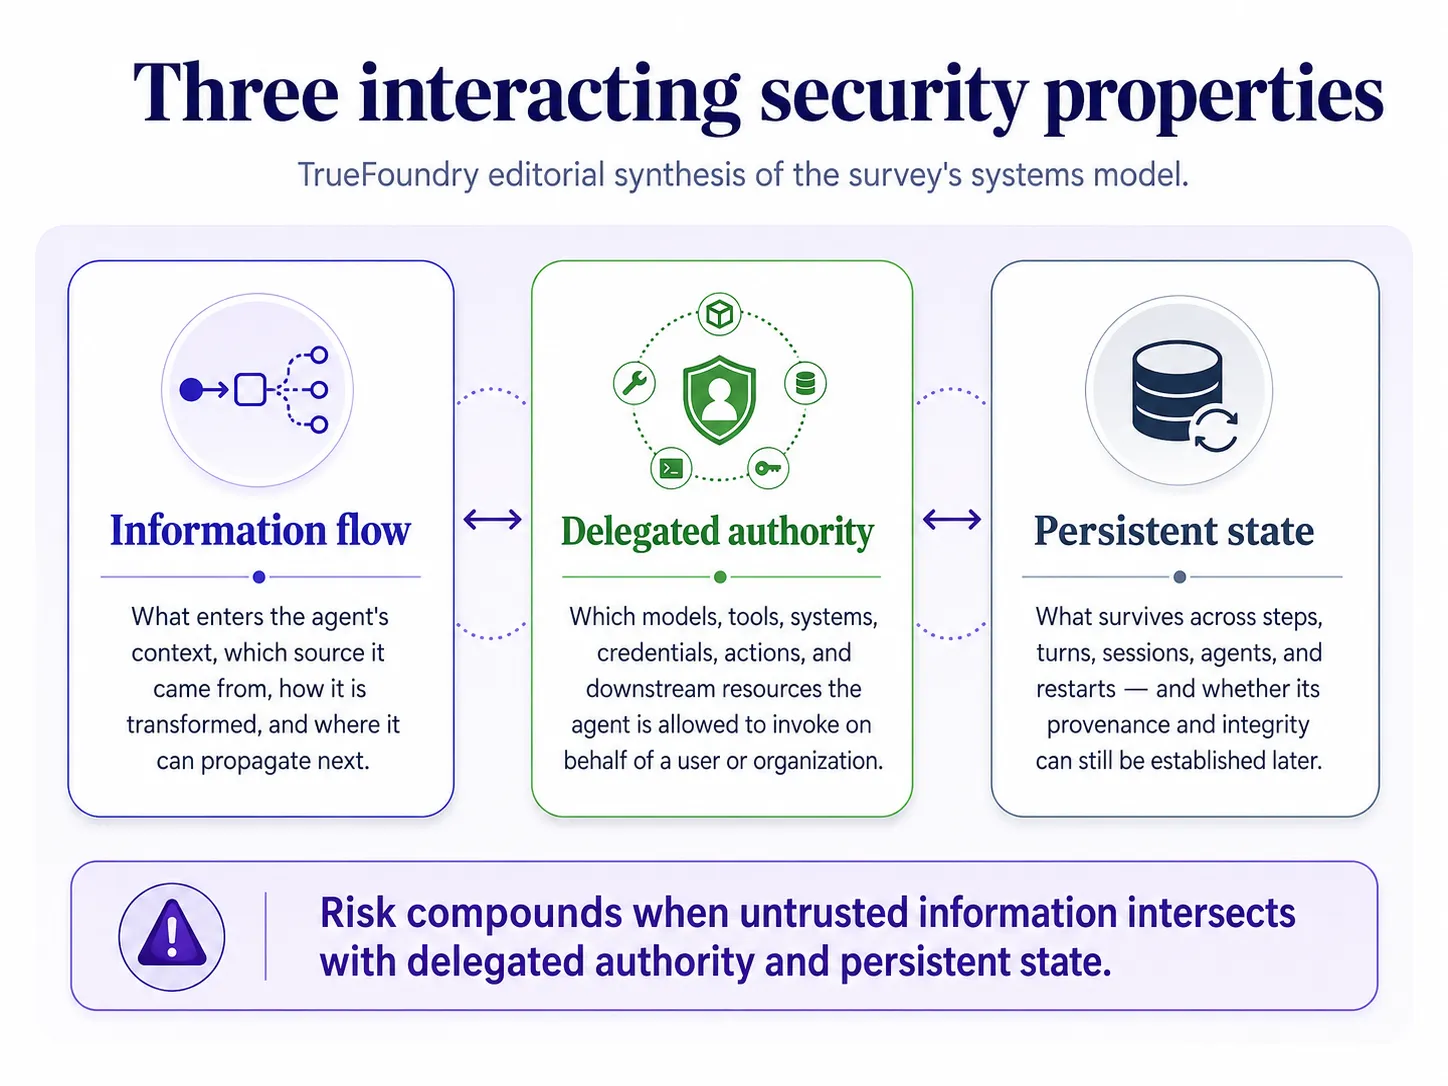
Die nützliche Schlussfolgerung daraus ist, dass eine sichere Agenten-Architektur nicht nur fragen sollte: „Haben wir den bösartigen Prompt blockiert?“ Sie sollte auch fragen: Was könnte dieser Inhalt beeinflussen, welche Befugnisse könnte der resultierende Ablauf ausüben und welchen Zustand könnte dieser Ablauf hinterlassen?
Ling und seine Koautoren verwenden ein lebenszyklusbasiertes, systemorientiertes Framework anstelle einer einfachen Liste von Angriffsnamen. Operativ ist es sinnvoll, den Kern-Aktionspfad – Eingabe, Planung, Entscheidung, Werkzeugausführung und Ausgabe – von übergreifenden Ebenen wie Speicher, Überwachung und Multi-Agenten-Koordination zu trennen, da diese Ebenen mehrere Phasen des Ablaufs beeinflussen oder beobachten können.
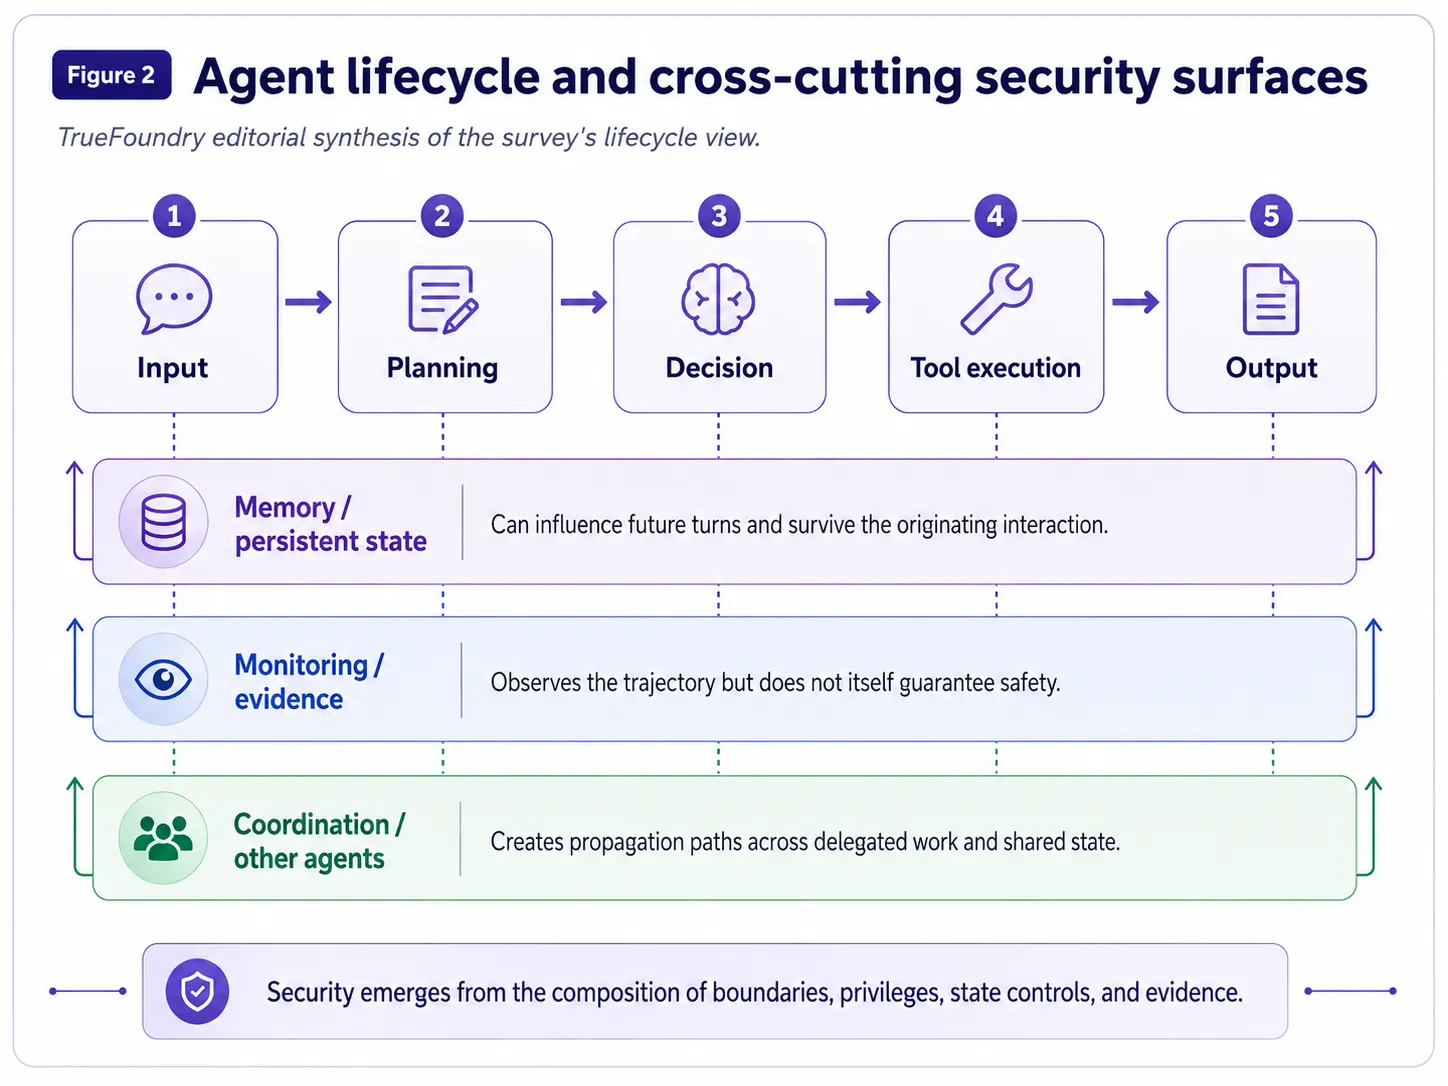
Diese Lebenszyklus-Perspektive erklärt auch, warum Abwehrmechanismen laut der Studie nur „schwach kompositionell“ sein können. Ein Inhaltsfilter blockiert möglicherweise eine Klasse bösartiger Texte, bewirkt aber nichts gegen überprivilegierte Anmeldedaten. Eine Sandbox kann die Codeausführung isolieren, aber einen autorisierten API-Aufruf nicht verhindern. Ein Freigabegate kann eine Auswirkung stoppen, aber keinen manipulierten Schreibvorgang im Speicher verhindern. Ein Trace kann einen Vorfall zwar beobachtbar machen, ihn aber nicht verhindern.
Sicherheit ergibt sich daher aus der Komposition von Grenzen, Privilegien, staatlichen Kontrollen und Nachweisen.
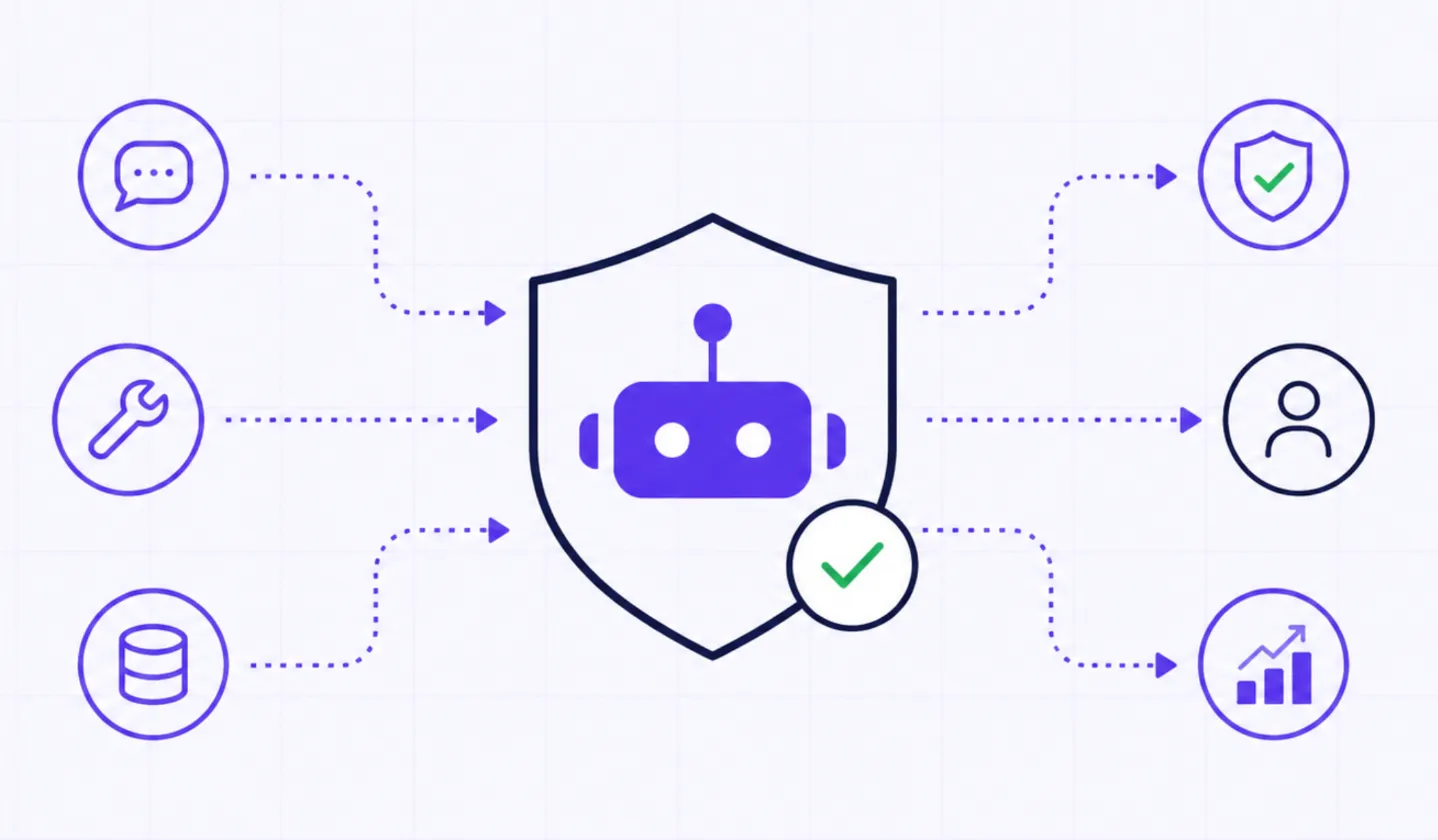
Die sauberste Produktzuordnung lautet nicht „TrueFoundry löst das Problem der Agentensicherheit“. Stattdessen sollte man fragen, welchen Teil des Systemmodells der Umfrage die jeweilige Ebene realistisch steuern kann.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet