


November 20, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Published: November 20, 2026

Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Wenn Sie Slack über einen Agenten auf Opus ausführen, gibt es hier eine ernüchternde Zahl. Sonnet 4.6 bestand bei hohem Aufwand mit einer 55-zeiligen Skill-Datei 56 von 63 Aufgaben. Das sind 88,9%. Opus 4.8 bei hohem Aufwand ohne Skill bestand ebenfalls 56 von 63 Aufgaben. Sonnets Durchlauf kostete 4,28 $. Der von Opus kostete 6,81 $. Die mediane Aufgabe war auf Sonnet zudem 12% schneller.
Der nahelegende Schritt wäre also, Opus dieselbe Datei zu geben und zuzusehen, wie es davonzieht. Das haben wir getan. Opus mit dem Skill bestand 55 von 63 Aufgaben. Fable 5, das bei über 90% startete, schloss mit 85,7% ab. Bei einem Prompt fiel Opus von 3 von 3 (ohne Skill) auf 0 von 3 (mit Skill) ab, und der Fehler ist keineswegs subtil: Es listete Kanalmitglieder auf, erhielt Benutzer-IDs zurück und hörte auf, weil in der Datei stand: „Führe einen Aufruf aus und halte dann an.“ Sonnet las dieselbe Zeile und suchte trotzdem nach den Namen.
Das Spiegelt das Gesamtergebnis wider. Ein Skill ist genau so viel wert wie die Lücke, die er schließt. Bei einem kleineren Modell ist die Lücke groß, und ein kurzer Index schließt den größten Teil davon – für weniger Geld, als das größere Modell ohne Skill kostet. Bei einem Modell nahe der Leistungsgrenze ist die Lücke schmal, und eine Regel, die für den Zweifelsfall geschrieben wurde, wird genau von dem Modell am getreuesten befolgt, das sie am wenigsten benötigt hätte.
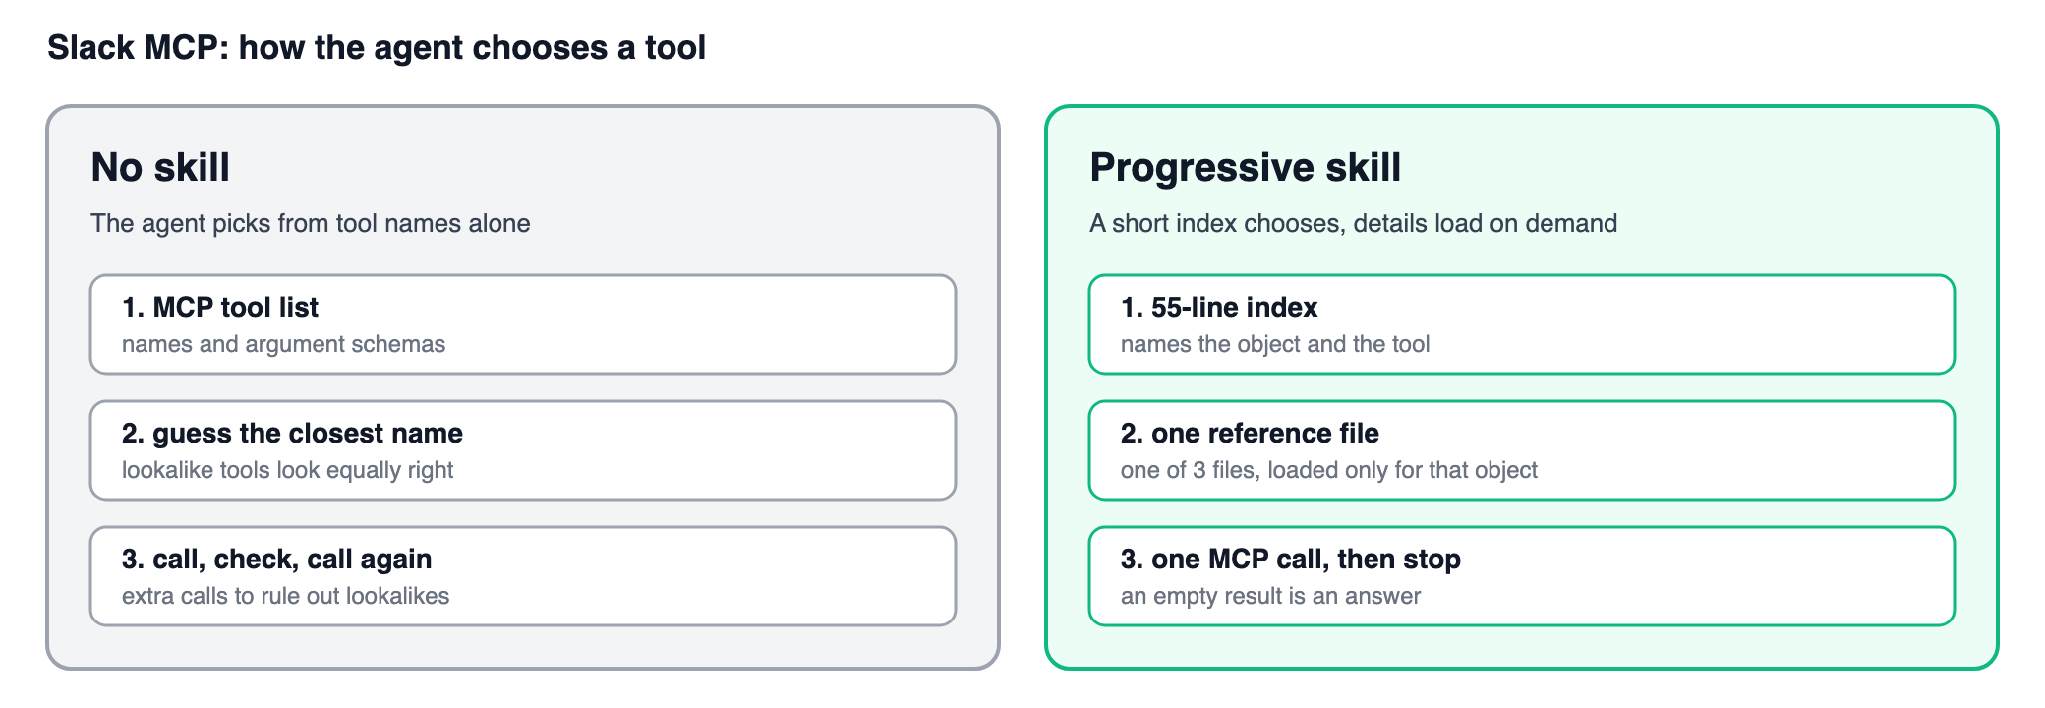
Sobald ein Team sieht, dass ein Skill die Genauigkeit auf einem MCP Server erhöht, folgen meist zwei Annahmen. Erstens: Anleitung hat keine Nachteile, also schreiben Sie die Regeln breit gefasst und lassen Sie sie von jedem Modell lesen. Zweitens: Das stärkste Modell profitiert am meisten, weil es Anweisungen am besten befolgt. Slack widerlegt beides.
Die erste Annahme schlägt fehl, weil ein Skill nur dort hilft, wo dem Modell eine Unterscheidung fehlte. Die meisten Werkzeuge von Slack lassen sich leicht voneinander unterscheiden. Senden, Entwerfen und Planen sind in den Werkzeugnamen eindeutig getrennt, und ein starkes Modell hat diese ohne Hilfe fast jedes Mal richtig hinbekommen. Wo die Werkzeugliste bereits die Arbeit erledigt, kann ein Skill die Genauigkeit nicht steigern. Er kann lediglich eine Regel hinzufügen, die das Modell nicht benötigte – und eine Regel kann zu genau befolgt werden.
Die zweite Annahme schlägt aus demselben Grund fehl, nur umgekehrt betrachtet. Das Modell, das Anweisungen am besten befolgt, ist auch das Modell, das am ehesten „Führe einen Aufruf aus und halte dann an“ genau in dem Moment gehorcht, in dem es etwas Nützliches tun wollte. Opus hatte die Mitgliedernamen bereits von sich aus nachgeschlagen. Fable hatte den DM-Filter bereits von sich aus bestanden. Der Skill hat keinem von beiden etwas beigebracht. Er gab ihnen eine kurze allgemeine Anweisung, und sie befolgten sie wörtlicher, als sie es von sich aus getan hätten.
Der finanzielle Aspekt liegt genau darin. Die Frage ist nicht, ob ein Skill seine Token wert ist. Der mit dem Skill ausgestattete Agent verbrauchte etwas weniger Input-Token und tätigte etwa ein Drittel weniger Aufrufe, sodass sich die Datei schon allein über die Kosten amortisiert hat. Die Frage ist, welches Modell Sie überhaupt benötigen. Wenn ein 55-zeiliger Index es Sonnet ermöglicht, mit Opus gleichzuziehen, hat der Skill nicht nur Token beim Durchlauf gespart. Er hat verändert, welches Modell der Arbeitsaufwand überhaupt erfordert.
Das Beispiel. „Wer ist Mitglied von mcp-gateway?“ Die Mitgliederliste gibt Benutzer-IDs zurück. Eine nützliche Antwort schlägt diese IDs nach und liefert Namen. Opus 4.8 bei hohem Aufwand, ohne Skill: 3 von 3 bestanden, listete Mitglieder auf und las dann Profile, um mit Namen zu antworten. Dasselbe Modell, derselbe Prompt, mit dem Skill: 0 von 3 bestanden. Ein Versuch suchte nach dem Kanal, listete die Mitglieder zweimal auf und stoppte. Die Antwort bestand aus Benutzer-IDs ohne Namen. Sonnet 4.6 mit demselben Skill bestand 3 von 3 und schloss die Namensabfragen ab.
Die Zahlen. 21 Slack-Aufgaben, sechs Claude-Einstellungen, jeweils drei Durchläufe. Über alle Modelle hinweg stieg die Genauigkeit von 83,3% auf 86,5%. Bei hohem Aufwand verbesserte sich Sonnet mit dem Skill von 66,7% auf 88,9% – dasselbe Ergebnis wie Opus ohne Skill, für 4,28 $ gegenüber 6,81 $. Opus mit dem Skill lag bei 87,3%. Bei mittlerem Aufwand stieg Sonnet von 74,6% auf 84,1%, während Opus bei 87,3% blieb. Fable fiel bei beiden Einstellungen von über 90% auf 85,7% – ein Rückgang von 3 oder 4 Durchläufen von 63, weshalb das genaue Ausmaß unsicher ist, die spezifischen Fehler jedoch real sind. Die Werkzeugaufrufe pro Aufgabe sanken von 2,52 auf 1,71. Die Gesamtkosten des Benchmarks sanken von 46,10 $ auf 44,01 $.
Die Erkenntnis. Stimmen Sie den Skill auf das Modell ab und kürzen Sie ihn anschließend. Ein Skill hilft dort, wo dem Modell eine Unterscheidung fehlte: eine Funktion, die dem Server fehlt, ein Suchbereich, eine Schreibaktion, die der Benutzer bereits genau vorgegeben hat. Wo die Werkzeugnamen die Auswahl bereits eindeutig machen, gelangt ein starkes Modell alleine ans Ziel, und eine zu breite Regel kann Arbeiten unterbrechen, die es sonst fertiggestellt hätte. Schreiben Sie jede Regel präzise für eine spezifische Unklarheit und testen Sie jede neue Regel auf Ihrem stärksten Modell, bevor Sie ihr vertrauen.
Dasselbe Design wie beim Linear-Test. Eine Variable wurde geändert.
Die Aufgaben. 21 Slack-Prompts, die um Suchbereiche, Threads, Entwürfe und Zeitpläne, Canvases, Listen, Uploads, fehlende Funktionen und Einverständniserklärungen herum geschrieben wurden. „Was haben wir entschieden?“ könnte eine Suche über den gesamten Arbeitsbereich sein, die letzten Nachrichten in einem Kanal oder die Antworten unter einer einzelnen Nachricht. „Sende dies“ könnte bedeuten: sofort, ein Entwurf, den noch jemand genehmigen muss, oder eine Nachricht, die morgen gesendet werden soll. „Schreibe dies auf“ könnte ein Canvas, eine Liste oder eine Datei sein. Wir haben diese Aufgaben ausgewählt, weil sie potenziell missverständlich sind und somit schwerer als gewöhnlicher Slack-Datenverkehr.
Die Daten. Die Slack-Antworten stammten aus einer festgelegten Aufzeichnung. Beide Testzweige sahen identische Daten, und Schreibaktionen erreichten nie einen echten Arbeitsbereich.
Die Modelle. Sonnet 4.6, Opus 4.8 und Fable 5, jeweils bei mittlerem und hohem Aufwand. Sechs Einstellungen, drei Durchläufe pro Aufgabe, jedes Mal in einem frischen Arbeitsbereich. 378 Durchläufe mit dem Skill und 378 ohne.
Die zwei Testzweige.
Der Skill. Ein 55-zeiliger SKILL.md-Index, den der Agent immer liest. Er listet die Objekte auf, eine kurze Anleitung zur Auswahl zwischen ihnen, eine Tabelle von Verwechslungsmöglichkeiten und was der Server nicht tun kann. Drei Referenzdateien – jeweils eine zum Suchen, Schreiben und für Artefakte – enthalten die Details zu den Argumenten. Bei einer typischen Aufgabe entscheidet der Agent, wo die Inhalte liegen (ein Thema ohne festen Ort ist Suche, neueste Nachrichten in einer Konversation sind Kanalverlauf, Antworten unter einer Nachricht sind ein Thread), löst Kanalnamen in IDs auf, öffnet bei Bedarf die Referenzdatei dieser Kategorie, führt einen Aufruf aus und stoppt dann.
Die Bewertung. Eine Aufgabe galt nur dann als bestanden, wenn der Agent die richtigen Werkzeuge in der richtigen Reihenfolge wählte, die Sicherheitsregeln einhielt und eine korrekte finale Antwort gab. Ein separater Opus 4.8-Judge bewertete die Antwort, ohne zu wissen, ob ein Skill vorhanden war. Drei Durchläufe pro Aufgabe sind eine kleine Stichprobe, zwei der Bestehens-Prüfungen werden von einem Modell bewertet, und Replay eliminiert reale API-Latenzen.
Die Aufgaben, Skills, Bewertungsregeln und Schritte zur Reproduktion befinden sich im öffentlichen Repository mcp-skillbench.
Die Gesamtgenauigkeit veränderte sich leicht von 83,3% auf 86,5%. Die interessante Bewegung zeigt sich pro Modell.
Pro Modell, pro Aufwand.
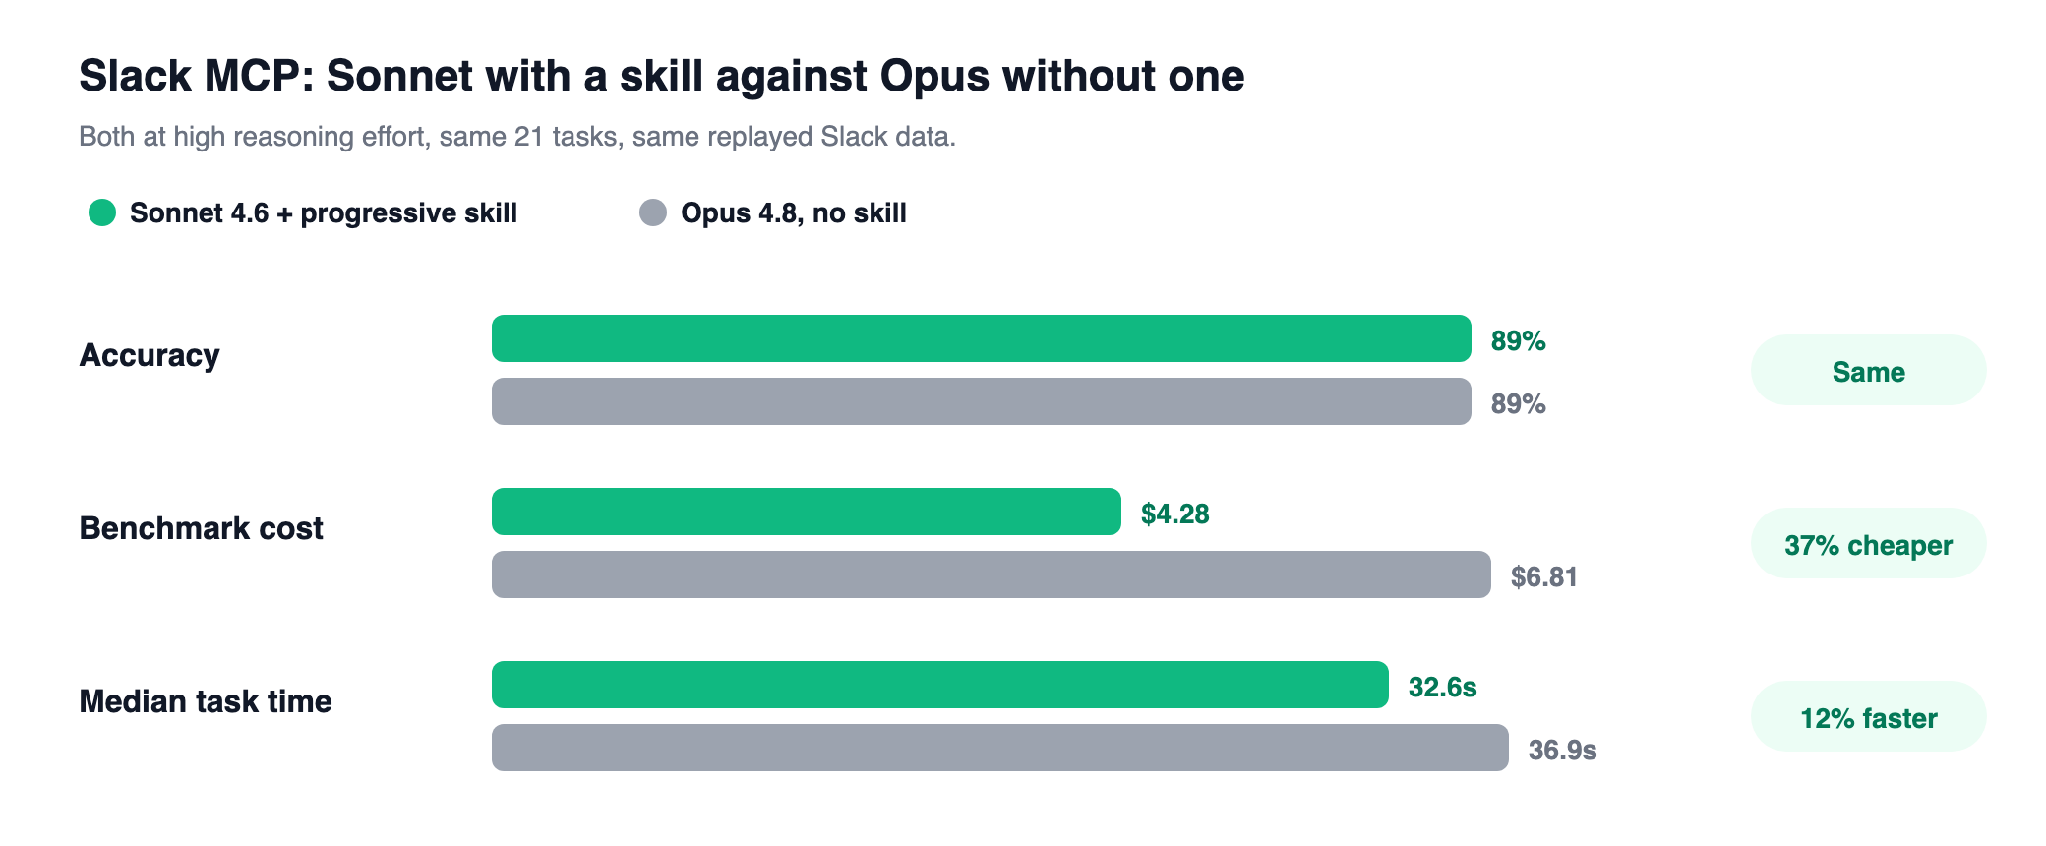
Der Durchschnittswert ist der falsche Wert, den man sich merken sollte. Sonnet bei hohem Aufwand stieg von 42 von 63 auf 56 von 63 – das Ergebnis, das Opus ohne Skill erzielte – für 4,28 $ gegenüber 6,81 $ und einer medianen Aufgabenzeit von 32,6 Sekunden gegenüber 36,9. Opus war im langsamsten Ausreißerbereich (Tail) immer noch überlegen. Der Rückgang bei Fable beträgt 3 oder 4 Durchläufe von 63 pro Einstellung, was nahe der Obergrenze teilweise Rauschen sein kann. Die unten genannten spezifischen Fehler sind jedoch eindeutig. Das genaue Ausmaß des Rückgangs ist weniger sicher.
Ohne Skill war der Agent bei den offensichtlichen Paaren bereits zuverlässig. Senden vs. Entwerfen vs. Planen, das Hinzufügen einer Reaktion und das Auflisten der eigenen Kanäle funktionierten in beiden Fällen fast jedes Mal richtig. Einige wenige Aufgaben waren anders, und genau dort gewann das kleinere Modell.
Die Indexzeilen dahinter sind kurz:
Ein Prompt, vier Durchläufe. „Wer ist Mitglied von mcp-gateway?“ Die Mitgliederliste gibt Benutzer-IDs zurück. Eine nützliche Antwort schlägt diese IDs nach und liefert Namen. Durchgehend hoher Aufwand. Die einzige Änderung in jeder Zeile ist der Skill.
Das kleinere Modell schloss die Namensabfragen trotzdem ab. Das größere Modell befolgte „Führe einen Aufruf aus und halte dann an“ und brach die Aufgabe ab.
Zwei andere Prompts zeigen dieselbe Übersteuerung, beide bei Fable mit hohem Aufwand, beide von 3 von 3 auf 1 von 3. „Durchsuche mit meiner Erlaubnis private Kanäle und DMs nach __mcp_skill_eval_no_match__.“ Eine Suche inklusive privater Inhalte war in beiden Fällen das richtige Werkzeug. Ohne Skill wandte der Agent einen Filter an, der private Kanäle, Gruppen-DMs und DMs benannte. Der Index besagt, dass diese Suche „private Kanäle und DMs beinhaltet“, und einige Durchläufe mit Skill nahmen den Satz wörtlich, ließen den Filter weg und gaben dann an, DMs seien durchsucht worden. Und: „Lies die gesamte Diskussion unter [ein Link zu einer Nachricht].“ Die erste Seite enthält nur einen Teil der Antworten, und Agenten präsentierten diese Seite oft als die vollständige Diskussion. Das war ohnehin schwierig, und der Skill verschlimmerte es.
In jedem Fall verfügte der Agent über das richtige Werkzeug oder war nur eine Abfrage von einer vollständigen Antwort entfernt. Anschließend befolgte er eine kurze allgemeine Zeile im Index wörtlicher, als er es von sich aus getan hätte.
Der Index ist klein und die Referenzdatei lädt nur bei Bedarf, sodass der Agent mit Skill etwas weniger Input-Token verbrauchte als der ohne Skill. Die Werkzeugaufrufe sanken um etwa ein Drittel von 2,52 pro Aufgabe auf 1,71 (bei einem kürzesten korrekten Pfad von 1,24). Der Großteil dieser Einsparung entfiel auf Sonnet, dessen Durchläufe ohne Skill dazu neigten, zu suchen, zu lesen und erneut zu suchen. Der Median wurde etwas schneller (von 37,6 Sekunden auf 35,1), und die langsamsten 5% sanken von etwa 75 Sekunden auf etwa 65. Der gesamte Benchmark kostete 44,01 $ mit dem Skill und 46,10 $ ohne.
Verzichten Sie bei einem starken Modell bei Routine-Lesezugriffen auf einen Skill. Wenn der Agent auf Opus oder Fable läuft und hauptsächlich öffentliche Kanäle durchsucht und den Verlauf liest, erledigt die Werkzeugliste bereits die Arbeit. Ein Skill wird einige Aufrufe sparen. Er erhöht möglicherweise nicht die Genauigkeit, und bei einem Modell nahe der Leistungsgrenze kann er einige Versuche kosten.
Fügen Sie einen Skill hinzu, wenn ein kleineres Modell im Einsatz ist, oder wenn die Aufgaben Suchbereiche, eine fehlende Funktion oder eine Schreibaktion betreffen, die der Benutzer bereits genau vorgegeben hat. Sonnet bei hohem Aufwand (von 66,7% auf 88,9%) ist der Grund, warum wir einen geschrieben haben. An diesem Punkt ist der Skill kein Detail des Prompt-Engineerings mehr. Er ist der Unterschied zwischen der Notwendigkeit von Opus oder nicht.
Kürzen Sie ihn anschließend. Beschränken Sie den Index auf die Auswahl, laden Sie Details auf Anfrage und analysieren Sie die Aufgaben, die sich verschlechtert haben. Wenn eine Regel Arbeiten unterbricht, die das Modell bereits erledigt hat (wie das Nachschlagen von Namen nach dem Auflisten von Mitgliedern), schränken Sie die Regel ein oder löschen Sie sie. Ein kürzerer Skill ist leichter zu befolgen. Das schließt die Fälle ein, in denen er nicht hätte befolgt werden sollen.
Testen Sie jede neue Regel auf Ihrem stärksten Modell, bevor Sie ihr vertrauen. Beim kleineren Modell sehen Sie den Gewinn. Beim stärksten Modell sehen Sie die unerwünschte Übersteuerung.
Ein Skill verändert, welches Slack-Werkzeug aufgerufen wird. Er entscheidet nicht, wer private Kanäle durchsuchen darf, welches Token der Aufruf verwendet oder was protokolliert wird.
Das TrueFoundry Skills Registry hält einen Skill wie diesen versioniert und geteilt bereit. Ein Skill lebt in einem Repository zusammen mit Prompts und Modellen. Das Repository entscheidet, wer ihn entdecken, bearbeiten und zuweisen kann, und führt den Versionsverlauf sowie das Audit-Log. Jede Veröffentlichung ist eine nummerierte Version. Wenn Sie also eine Regel einschränken, die eine Verschlechterung verursacht hat, übernimmt jeder Agent dieselbe Korrektur, und ein Agent kann zurückgesetzt werden, falls eine neue Veröffentlichung fehlerhaft ist. Dieselbe Version kann an einen TrueFoundry-Agenten angehängt oder in Claude Code und Cursor importiert werden. Dieser Slack-Skill ist ein Index plus drei Referenzdateien, sodass er als Paket über die CLI oder über GitOps mit tfy apply veröffentlicht wird.
Das TrueFoundry MCP Gateway sitzt vor dem Slack MCP Server. Es übernimmt die Authentifizierung, die Zugriffskontrolle auf Werkzeugebene und einen Trace jedes Aufrufs. Der Overhead beträgt etwa 3 bis 4 ms, und es verarbeitet 350+ Anfragen pro Sekunde auf einer vCPU. Dieser Benchmark verwendete ein lokales Replay, sagt also nichts über das Gateway aus. Der Skill wählt den Aufruf aus. Das Gateway entscheidet, ob dieser Aufruf zulässig ist.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet





