October 15, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Published: October 7, 2026
Blazingly fast way to build, track and deploy your models!
Esta comparação é uma decisão arquitetural prática para equipes de engenharia que executam LLMs em produção. Ambas as ferramentas ajudam as equipes a controlar solicitações de LLM, entender o uso e reduzir pontos cegos operacionais. Elas operam próximas à camada de proxy, mas resolvem partes diferentes do mesmo problema de produção.
A definição mais clara é direta: o LiteLLM ajuda as equipes a padronizar o acesso entre diferentes modelos por meio de um proxy em Python. O Helicone ajuda as equipes a inspecionar o que suas chamadas de LLM fazem em relação a custo, latência e comportamento de prompt. Nenhuma das ferramentas substitui totalmente um(a) Gateway de IA, que governa modelos, ferramentas e agentes a partir de um único plano de controle.
Ambas resolvem problemas reais para aplicações de IA em produção. A escolha se resume ao problema que sua equipe precisa resolver primeiro. A decisão também depende do que a plataforma precisará suportar daqui a seis meses.
A orientação arquitetural direciona cada compromisso na comparação entre LiteLLM e Helicone. O LiteLLM é uma biblioteca Python de código aberto e um servidor proxy para mais de 100 provedores de LLM. Ele oferece às equipes uma interface única e unificada via formato OpenAI. Isso inclui OpenAI, Anthropic, Gemini, Bedrock, Azure e outros, tudo através do formato OpenAI.
Seu valor central é a abstração prática de provedores para equipes de engenharia. Uma equipe pode escrever o código uma vez usando o formato OpenAI e, em seguida, rotear para qualquer provedor suportado apenas alterando a configuração. A camada de proxy adiciona balanceamento de carga, fallbacks, chaves virtuais, limitação de taxa (rate limiting) e rastreamento de custos. Ele também difere de um Kong AI Gateway, que estende os padrões de API gateway para o tráfego de modelos.
O Helicone é uma plataforma focada em observabilidade que atua como um proxy entre sua aplicação e um provedor de LLM. Seu valor central é a visibilidade: solicitações, respostas, contagem de tokens, métricas de latência, taxas de erro e estimativas de custo aparecem dentro de painéis. O Helicone lançou um AI Gateway baseado em Rust em junho de 2025, adicionando roteamento, cache, limitação de taxa e observabilidade.
Aqui está a distinção que a maioria das comparações subestima. O Helicone atende equipes que desejam visibilidade sem alterar a forma como fazem chamadas de modelo. O LiteLLM atende equipes que desejam trocar de provedores de IA sem alterar o código da aplicação. Isso torna a decisão uma questão de profundidade de roteamento versus profundidade de observabilidade.
A comparação começa com o design de tempo de execução. O LiteLLM é construído em Python, e isso molda seu envelope de desempenho. Em throughput mais alto, a latência e o consumo de memória exigem um ajuste mais fino do que em serviços de gateway compilados. Essa preocupação torna-se relevante quando o proxy lida com tráfego sustentado entre os principais provedores de LLM.
Para a maioria das equipes, a sobrecarga pode ser pequena. Se o tráfego estiver na casa das centenas de solicitações por minuto, a inferência do modelo domina a experiência do usuário. Uma chamada de chat completion geralmente gasta mais tempo dentro do endpoint do modelo do que no servidor proxy. O compromisso muda quando o throughput, as tentativas de repetição (retries) e os fallbacks aumentam simultaneamente.
A diferença operacional importa mais frequentemente para equipes de plataforma. A adoção do proxy hospedado do Helicone dá às equipes acesso imediato aos logs com apenas uma alteração na URL base. Os recursos completos de proxy do LiteLLM exigem Postgres, Docker, chaves de provedor e responsabilidade pela implantação. As equipes também precisam gerenciar o endpoint do gateway, configurações, definições de callback e exportações de OpenTelemetry entre ambientes.
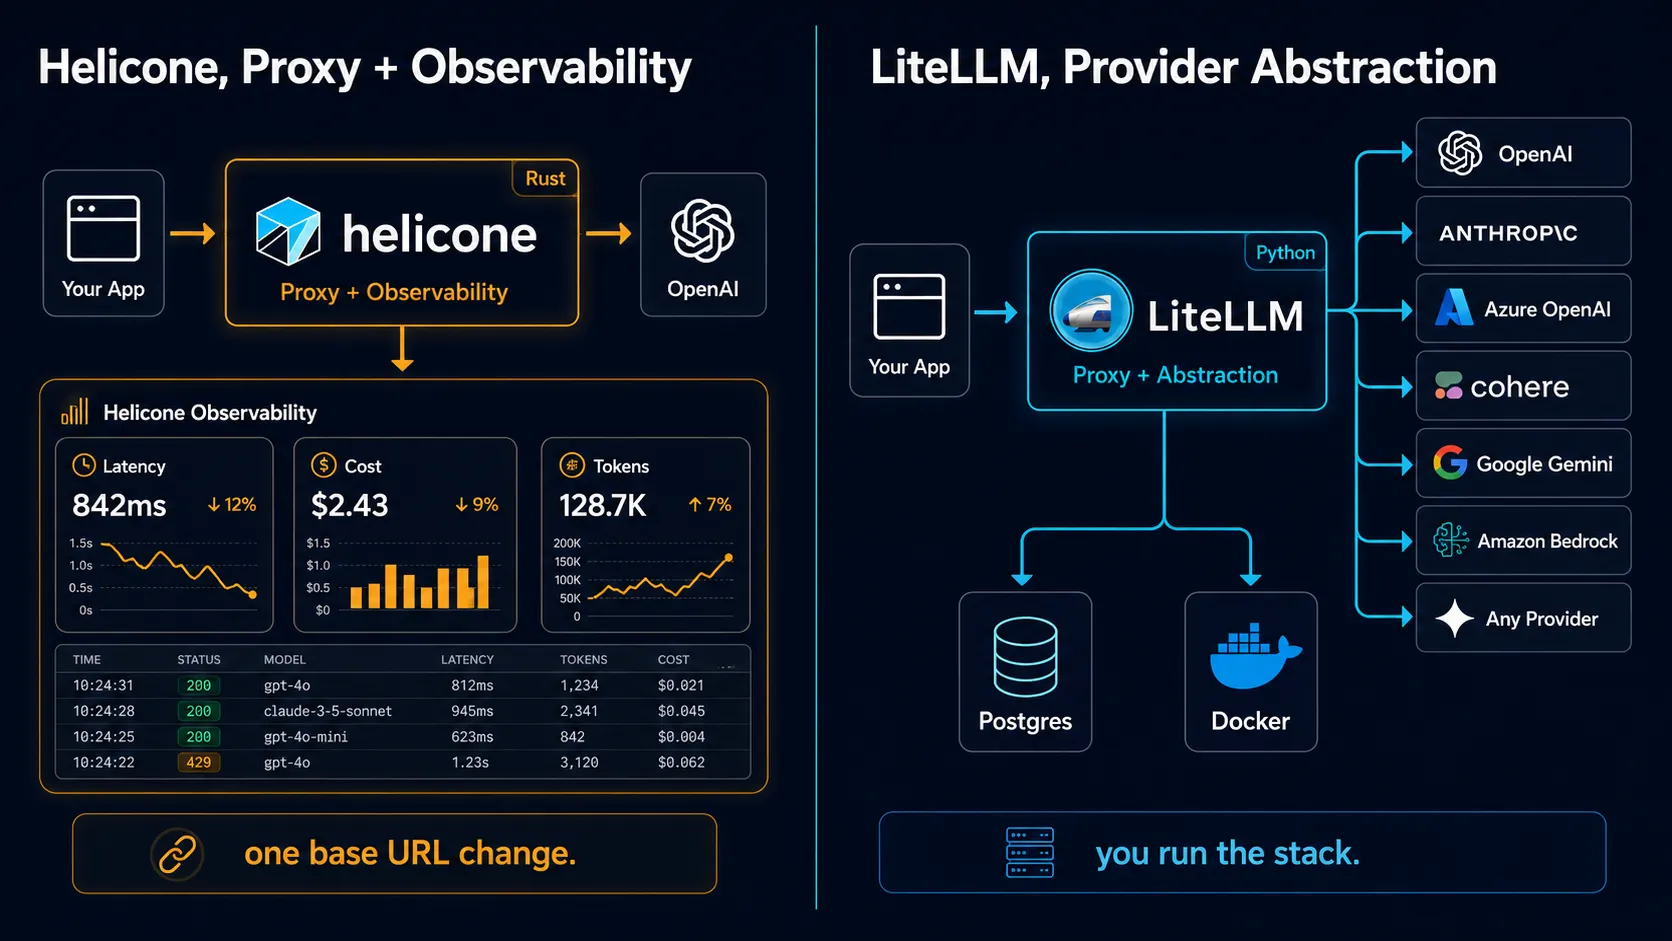
O Helicone é mais rápido de adotar. Altere a URL base na sua chamada existente do SDK da OpenAI, adicione o cabeçalho Helicone-Auth e você poderá registrar as solicitações. Essa configuração captura latência, custos, prompts e comportamento do modelo sem grandes alterações no código. Equipes que precisam de visibilidade rapidamente costumam escolher o Helicone por esse motivo.
Adotar o LiteLLM por completo exige mais das equipes de engenharia. O rastreamento de gastos, a gestão de equipes, as chaves virtuais e a aplicação de orçamentos exigem que o proxy com suporte a Postgres seja executado no Docker. Antes que orçamentos utilizáveis apareçam, alguém precisa provisionar o armazenamento e configurar as credenciais dos provedores. Esse responsável também gerencia a implantação do proxy a partir de então.
Para equipes de ML que usam Python, isso pode parecer natural. Para equipes de plataforma que suportam várias linguagens, os custos operacionais precisam de um responsável claro. Usar o SDK do LiteLLM dentro de uma aplicação Python é simples. Executar a camada de proxy centralizada para aplicações de LLM torna-se uma responsabilidade mais ampla da plataforma.
Vencedor: O Helicone é ideal para uma observabilidade rápida com esforço mínimo de engenharia. O LiteLLM atende equipes que já operam infraestrutura em Python. A escolha deve seguir a prontidão operacional, não capturas de tela de recursos.
O LiteLLM vence em abrangência de provedores por design. Ele suporta mais de 100 provedores de LLM por trás de um formato de API unificado, com lógica de fallback, balanceamento de carga e novas tentativas entre eles. Uma equipe que faz roteamento entre vários provedores de IA pode consolidar integrações separadas em um único roteador e interface.
O Helicone cobre um caso de uso relacionado, embora a abstração de provedores não seja seu foco histórico. Seu AI Gateway agora suporta mais de 100 modelos via uma única API, enquanto a plataforma Helicone mais ampla ainda lidera em visibilidade de solicitações. A escolha torna-se menos sobre a contagem de modelos e mais sobre o modelo operacional.
Vencedor: LiteLLM, para equipes que precisam de amplo acesso a provedores, roteamento flexível e análise de desempenho dos provedores. O Helicone atende equipes que valorizam visibilidade, análise e menos etapas de adoção assim que as escolhas de modelos são definidas.
Esta comparação segue o caminho inverso. Registro em nível de prompt, análise por usuário, propriedades personalizadas e atribuição de custos estão no centro do Helicone. Filtros de metadados e rastreamento de sessões fortalecem ainda mais a visibilidade em produção. O Helicone relata 10,2 bilhões de solicitações processadas, 2,6 trilhões de tokens por mês e 68 milhões de usuários rastreados.
O LiteLLM também apresenta dados de custo e uso entre as solicitações. Seus logs podem fluir para ferramentas por meio de callbacks, OpenTelemetry e sistemas de observabilidade externos. No entanto, a observabilidade permanece como uma capacidade de suporte dentro da camada de gateway. O Helicone foi criado para tornar a visibilidade a experiência principal para depuração de aplicações de IA.
Vencedor: Helicone, para equipes que precisam de insights profundos sobre solicitações, análise de prompts e atribuição de custos. Para critérios de avaliação mais detalhados, consulte o guia da TrueFoundry sobre observabilidade de gateway de IA.
Em 24 de março de 2026, duas versões maliciosas do LiteLLM, 1.82.7 e 1.82.8, foram publicadas no PyPI. O LiteLLM afirma que a janela afetada cobriu instalações via pip entre 10:39 UTC e 16:00 UTC. O projeto também declara que os usuários da imagem Docker oficial do proxy LiteLLM não foram impactados.
Pesquisadores de segurança descobriram que a versão 1.82.8 incluía um arquivo .pth malicioso. Esse arquivo poderia ser executado quando o Python iniciasse, mesmo sem uma importação explícita. O payload visava credenciais e ambientes Kubernetes, o que aumentou o risco para equipes que executam o LiteLLM próximo a segredos de produção.
Isso não torna o LiteLLM inadequado para uso corporativo. A resposta do projeto foi transparente e as versões afetadas foram removidas. Isso eleva o nível operacional para equipes de produção. Equipes que executam o LiteLLM em produção devem fixar versões, verificar dependências, isolar o proxy, rotacionar segredos expostos e fortalecer os fluxos de trabalho de build.
Vencedor: Helicone é para equipes que buscam um caminho de adoção com menor necessidade de manutenção. O LiteLLM continua sendo uma opção sensata para equipes com governança de dependências madura e práticas consolidadas de auto-hospedagem. A perspectiva de segurança é fundamental em qualquer avaliação corporativa séria.
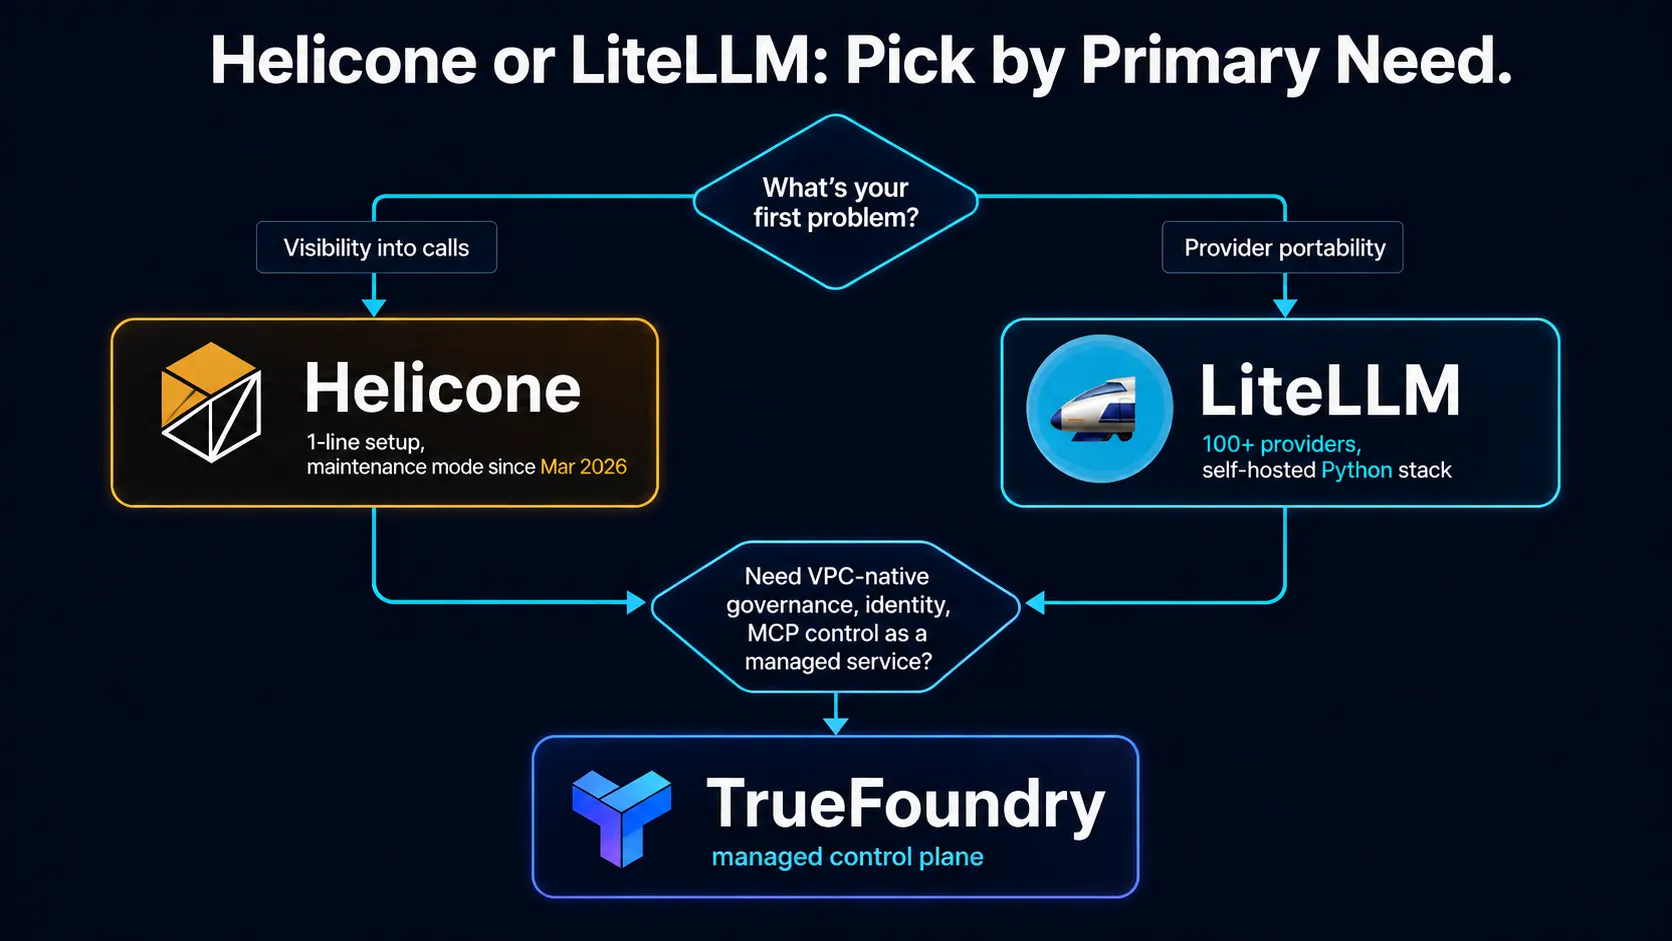
Escolha o Helicone quando sua principal necessidade for visibilidade das chamadas de LLM. Ele funciona bem quando sua equipe utiliza um ou poucos provedores, oferecendo insights rápidos sobre prompts, custos, latência e erros. A ressalva é estratégica: o Helicone entrou em modo de manutenção após ser adquirido pela Mintlify em março de 2026.
Escolha o LiteLLM quando sua principal necessidade for portabilidade entre provedores. Suas mais de 100 integrações, chaves virtuais, limites de orçamento e recursos de roteamento resolvem a complexidade de lidar com múltiplos provedores. Esse valor é essencial quando as equipes utilizam OpenAI, Anthropic, Azure, Google, Gemini e modelos auto-hospedados através de uma interface única.
Muitas equipes utilizam essas duas ferramentas em conjunto na produção. O LiteLLM gerencia o roteamento, enquanto o Helicone registra e rastreia as respostas. Essa combinação funciona, mas adiciona duas plataformas ao caminho da requisição. Cada plataforma possui seus próprios modos de falha, logs, alertas, comportamento de cache e responsável operacional.
Para um contexto de mercado mais amplo, consulte um guia abrangente sobre alternativas ao LiteLLM . A melhor resposta depende
Esta parte determina se qualquer uma das ferramentas será sua parada final ou apenas uma camada inicial. O LiteLLM possui recursos reais de governança, incluindo orçamentos, limites de taxa, chaves virtuais e gerenciamento de permissões MCP por chave, equipe ou usuário. Sua versão Enterprise também é voltada para equipes que precisam de SSO, logs de auditoria, controle de acesso refinado e suporte profissional.
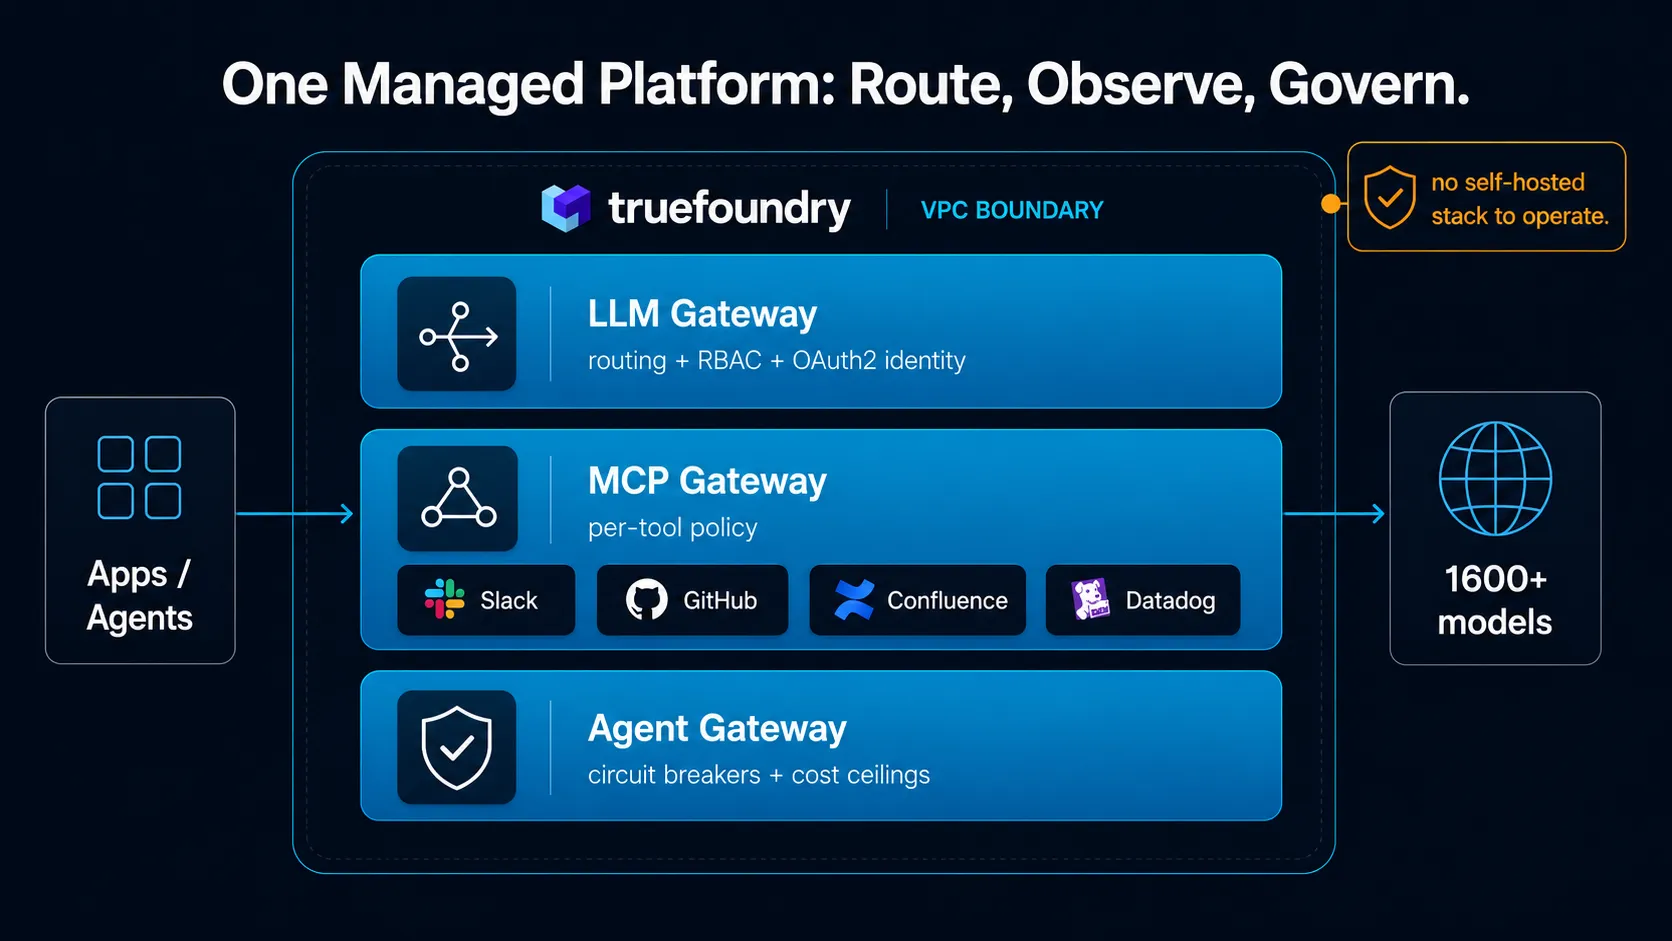
É aqui que TrueFoundry se encaixa. Nossa plataforma atende à camada que ambas as ferramentas deixam aberta. Ela oferece acesso governado a IA como uma plataforma gerenciada dentro da sua própria nuvem. As equipes podem executar o TrueFoundry junto com o Helicone ou o LiteLLM. Elas também podem usar roteamento, cache, rastreamento e aplicação de políticas integrados para consolidar ambos os trabalhos.
O AI Gateway realiza o roteamento entre mais de 1600 modelos com controle de políticas, monitoramento em tempo real e redução de custos de até 30 por cento. Ele também gerencia chaves de API, autenticação, limitação de taxa, roteamento inteligente, comportamento de fallback, controles de uso e observabilidade em nível de solicitação. O TrueFoundry relata mais de 10 bilhões de solicitações processadas mensalmente por meio deste gateway.
A camada de governança vai além de qualquer uma das ferramentas. O MCP Gateway governa o acesso às ferramentas, aplica OAuth 2.0, oferece suporte a RBAC e rastreia chamadas de servidor MCP. Ele também fornece integrações para Slack, Confluence, Sentry e Datadog, ao mesmo tempo em que oferece suporte a serviços internos personalizados.
OGateway de Agentes adiciona controle para fluxos de trabalho de agentes. Ele monitora a latência do agente, taxas de erro, novas tentativas, invocações de ferramentas, uso de tokens e custo do fluxo de trabalho. Ele também impõe cotas baseadas em custo ou em tokens por agente, fluxo de trabalho ou ambiente antes que atividades descontroladas se acumulem.
O TrueFoundry também oferece suporte a recursos avançados para otimização consciente do provedor e economia de custos. Por exemplo, o cache de prompt independente de provedor ajuda a normalizar o comportamento do cache entre os provedores.
Tudo isso pode ser executado dentro do seu ambiente AWS, GCP, Azure, VPC, on-premise ou isolado (air-gapped). O Gartner também reconheceu o TrueFoundry como um Fornecedor Representativo de AI Gateways em seu Guia de Mercado de 2025. Se você quiser testar isso com o seu tráfego, agende uma demonstração hoje mesmo para começar.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada