



novembro 20, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Published: novembro 20, 2026

Blazingly fast way to build, track and deploy your models!
Escolha quase qualquer produto de LLM lançado nos últimos três anos e inspecione sua API. A probabilidade é alta de que ele aceite uma requisição com um campo model, um array messages de objetos {role, content} e temperature, e retorne um array choices com um bloco usage contando tokens. Esse formato não veio de um órgão de padronização. Veio da API Chat Completions da OpenAI — e venceu.
Para uma equipe de plataforma, "compatível com OpenAI" é uma expressão estrutural. É a razão pela qual você pode avaliar um novo modelo de código aberto (open-weight) na sexta-feira e tê-lo servindo tráfego na segunda-feira sem reescrever sua aplicação. É também uma expressão que promete mais do que cumpre silenciosamente: dois endpoints podem ser ambos "compatíveis com OpenAI" e ainda assim divergir sobre como as chamadas de ferramentas são retornadas, como os tokens são contados e se o parâmetro que você definiu realmente faz alguma coisa.
Este post explica o que o padrão realmente é, o que a "compatibilidade" garante e o que não garante, e como um gateway transforma muitos provedores parcialmente compatíveis em um único endpoint no qual você pode construir com confiança.
Quer um único endpoint compatível com OpenAI em todos os provedores, com failover e rastreamento de custos? Agende uma demonstração.
Os padrões geralmente vencem por uma de duas razões: ou são impostos, ou chegam primeiro e são adotados antes que alguém projete uma alternativa. O esquema Chat Completions pertence firmemente ao segundo caso.
A OpenAI publicou o endpoint /v1/chat/completions e, fundamentalmente, lançou SDKs oficiais em Python e JavaScript que o encapsulavam. Esses SDKs foram incorporados em tutoriais, modelos iniciais, integrações de frameworks e bases de código de produção em toda a indústria. Quando os provedores concorrentes tiveram modelos que valiam a pena servir, a superfície de integração já estava padronizada na prática: milhões de linhas de código já sabiam como chamar client.chat.completions.create(...).
Um novo provedor enfrentava então uma escolha: definir sua própria API elegante e pedir a todo o ecossistema que a aprendesse, ou implementar o esquema da OpenAI e herdar todos os SDKs, frameworks e ferramentas gratuitamente. Quase todos escolheram o segundo caminho. As pilhas de servimento open-weight o adotaram para que qualquer coisa executada neles ficasse instantaneamente acessível a partir do código existente. O resultado é um padrão de fato sem um documento formais de padrões: o esquema é "qualquer coisa que o SDK da OpenAI envia e espera de volta".
É por isso que a expressão é mais importante do que parece. A compatibilidade não é um recurso que um fornecedor adiciona por capricho. É o bilhete de entrada para um ecossistema e molda como você pode arquitetar sua escolha de modelos.
Simplificando, a compatibilidade é um contrato sobre quatro coisas: o endpoint, o formato da requisição, o formato da resposta e o streaming.
O endpoint. Um serviço compatível aceita POST /v1/chat/completions com um cabeçalho Authorization: Bearer <key>. Muitos também implementam /v1/models, /v1/embeddings e /v1/completions. A URL base muda por provedor; o caminho não.
O formato da requisição. No mínimo: uma string model e um array messages de objetos com um role (system, user, assistant, tool) e content. Parâmetros opcionais que o cliente pode enviar incluem temperature, top_p, max_tokens (modelos mais novos da OpenAI usam max_completion_tokens), stream, stop, tools, tool_choice e response_format.
O formato da resposta. Um objeto JSON com um array choices; cada escolha possui um index, uma message com role e content (e tool_calls quando o modelo chama uma função) e um finish_reason (stop, length, tool_calls, content_filter). Um objeto usage informa prompt_tokens, completion_tokens e total_tokens.
Streaming. Com stream: true, a resposta é um text/event-stream de eventos enviados pelo servidor (server-sent events). Cada linha data: carrega um trecho cujo choices[].delta contém o(s) token(s) incremental(is). A transmissão termina com um data: [DONE] literal.
Aqui está o retorno concreto. Este corpo de requisição tem como alvo a OpenAI:
POST https://api.openai.com/v1/chat/completions
Authorization: Bearer sk-...

{
  "model": "gpt-4.1",
  "messages": [
    {"role": "system", "content": "You are a terse assistant."},
    {"role": "user", "content": "Summarize MCP in one sentence."}
  ],
  "temperature": 0.2,
  "stream": false
}
Para executar o mesmo prompt em um provedor diferente por meio de um endpoint compatível, você altera duas coisas: a URL base e o valor de model. Os campos messages, temperature e stream permanecem intocados. Seu código de parsing, que lê choices[0].message.content e usage.total_tokens, não muda absolutamente nada. Essa é toda a proposta de valor em uma única diferença: a escolha do modelo se torna uma string, não uma reescrita de código.
A resposta, independentemente do backend que a serviu, retorna como:
{
  "id": "chatcmpl-...",
  "choices": [
    {"index": 0,
     "message": {"role": "assistant", "content": "MCP is an open protocol..."},
     "finish_reason": "stop"}
  ],
  "usage": {"prompt_tokens": 24, "completion_tokens": 18, "total_tokens": 42}
}
Aqui é onde as equipes se prejudicam. "Compatível com OpenAI" é uma alegação sobre o esquema, não uma garantia de comportamento idêntico. O envelope é igual; o conteúdo pode diferir de maneiras que só surgem sob carga ou em casos de borda.
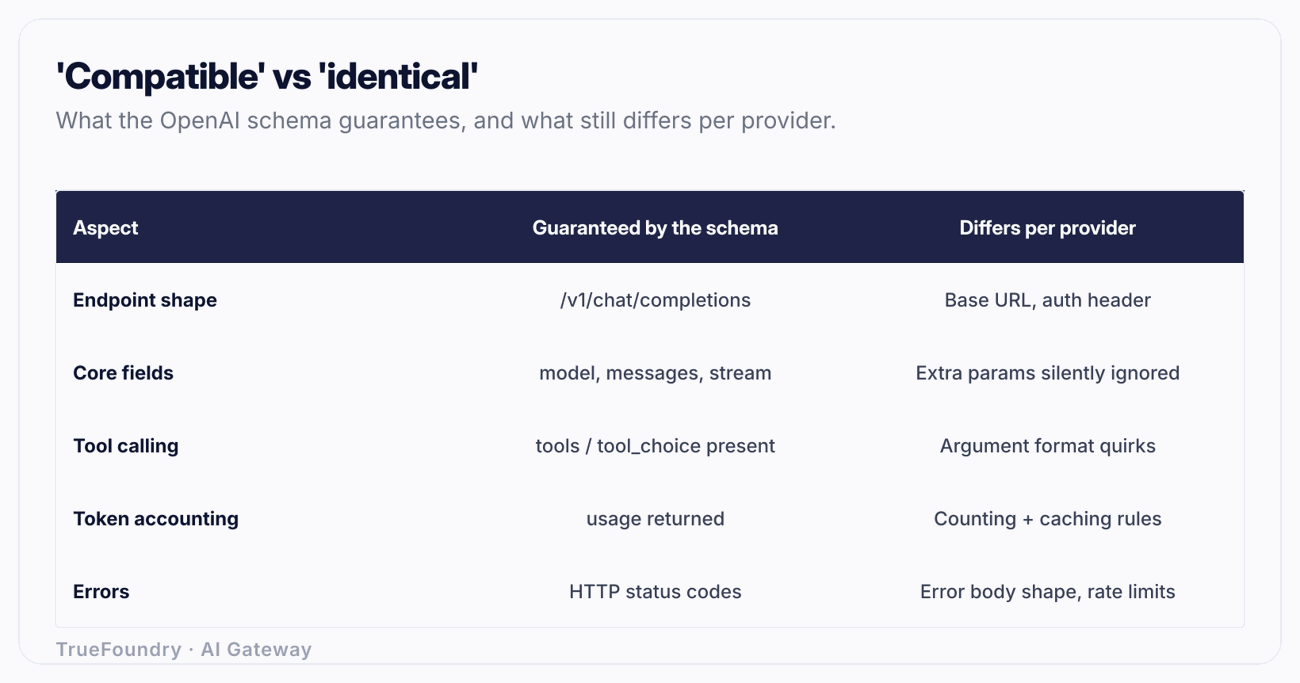
Dialetos de chamada de ferramentas (tool-calling). A maior divergência. A OpenAI retorna chamadas de função em message.tool_calls, cada uma com um id, um type e um objeto function cujo arguments é um blob JSON convertido em string que você deve analisar. Alguns backends compatíveis retornam argumentos como um objeto já analisado, emitem o campo único function_call mais antigo, transmitem deltas de chamada de ferramenta de forma diferente ou lidam com chamadas de ferramentas paralelas de forma inconsistente. Código que faz JSON.parse nos argumentos de forma cega lançará um erro em um backend que já os analisou.
Contagem de tokens. As contagens de usage são calculadas pelo próprio tokenizador de cada provedor. O mesmo prompt enviado a dois modelos gera prompt_tokens diferentes porque os tokenizadores diferem. Pior, alguns backends omitem usage completamente em respostas de streaming, a menos que você defina uma flag, fazendo com que o rastreamento de custos que depende disso leia zero silenciosamente.
Parâmetros no-op silenciosos. Você pode enviar seed, logit_bias, frequency_penalty, presence_penalty ou response_format: {type: "json_schema"} para um endpoint compatível e receber um 200 OK de volta, com o parâmetro completamente ignorado. O endpoint aceitou o campo porque o esquema permite; o backend simplesmente não o implementa. Esta é a classe mais nociva de bug porque nada gera erro. Seu pipeline "determinístico" que depende de seed é silenciosamente não determinístico.
Manipulação de prompt do sistema e de papéis. Alguns backends incorporam a mensagem system no primeiro turno do usuário, ou suportam apenas uma mensagem do sistema, ou tratam um content vazio de forma diferente. O comportamento em conversas de vários turnos pode desviar.
Semântica de finish-reason. Quando um modelo para porque deseja chamar uma ferramenta, a OpenAI informa finish_reason: "tool_calls". Nem todo backend usa a mesma string, o que quebra loops de agentes que fazem desvios com base nisso.
A tabela abaixo separa o que o padrão oferece de forma confiável do que você deve verificar por provedor.
A lição não é "a compatibilidade é falsa". É "a compatibilidade lhe dá 90% de graça e você deve testar os últimos 10% por provedor". Esses últimos 10% são precisamente o trabalho que um gateway pode absorver para que sua aplicação nunca precise lidar com isso.
Veja como a TrueFoundry permite trocar modelos pelo nome sem tocar no código da aplicação. Agende uma demonstração.
Se cada provedor é quase compatível, mas sutilmente diferente, a arquitetura limpa é parar de fazer sua aplicação falar com cada provedor diretamente. Coloque um endpoint compatível com OpenAI na frente de todos eles e deixe essa camada cuidar da tradução e da normalização.
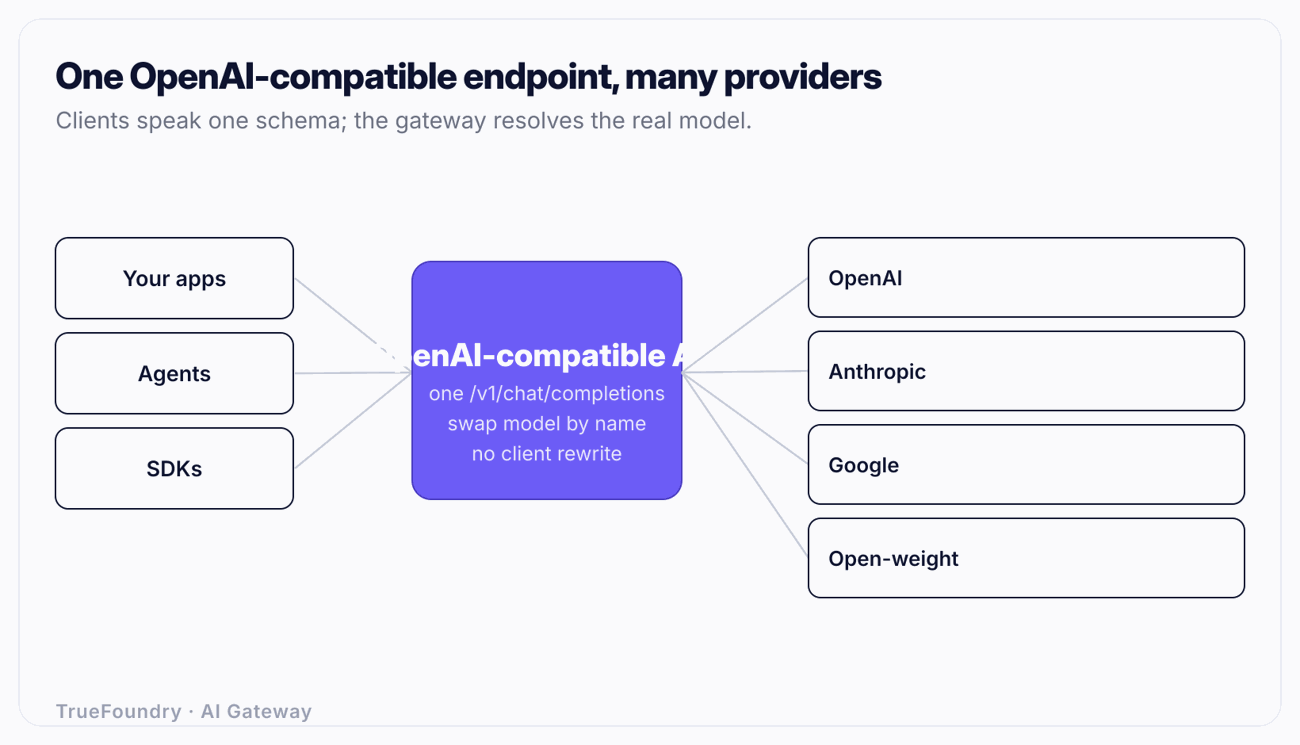
É isso que um AI gateway faz, e é estruturalmente a mesma ideia de um proxy LLM: uma única porta de entrada lógica, muitos backends atrás dela. A TrueFoundry expõe uma API unificada compatível com OpenAI na frente de cada provedor. Sua aplicação continua enviando o formato Chat Completions que já conhece. Para alternar modelos, você altera o valor de model para um nome lógico que o gateway resolve; todo o resto — corpo da requisição, SDK, parsing — permanece constante.
Como o gateway normaliza as diferenças descritas acima, seu código deixa de se importar se um determinado backend converte argumentos de chamada de ferramenta em string ou informa usage em transmissões. O gateway apresenta um dialeto consistente. Bibliotecas de código aberto como o LiteLLM popularizaram essa camada de tradução em código; nosso texto explicativo sobre o que é o LiteLLM cobre essa abordagem e onde um gateway gerenciado vai além.
Mas o motivo para adotar o padrão não é apenas uma interface organizada. Uma vez que cada requisição flui por um endpoint, você desbloqueia recursos que são impossíveis de adicionar a integrações dispersas por provedor:
Roteamento. Um nome lógico de modelo pode ser respaldado por vários destinos reais, e o gateway escolhe entre eles por latência, peso ou prioridade. Veja o que é um roteador LLM para seleção de modelos consciente de custo e qualidade.
Fallback. Se um provedor retornar um erro 500 ou expirar o tempo limite, o gateway tenta novamente na mesma requisição contra um destino de fallback, de modo que uma falha em um único provedor não surja como um erro para o usuário. Esse é o tema do fallback de LLM.
Caching. Caching exato e semântico no gateway reduzem a latência e os gastos para prompts repetidos ou quase duplicados, de forma transparente, atrás do mesmo endpoint.
Observabilidade e atribuição de custos. Como toda requisição passa por um só lugar, você obtém métricas de custo, token e latência por requisição, etiquetadas por usuário, equipe e modelo, alimentando a observabilidade de LLM e a atribuição de custos para orçamentos de equipe. Uma integração direta por provedor não oferece nada disso sem instrumentação personalizada em cada um.
Nenhum desses recursos exigiu que você adotasse uma nova API. Eles vieram da padronização na interface que você já usa. Se você está avaliando opções, o guia como escolher um AI gateway apresenta os critérios.
A decisão não é dogmática; é sobre com quantos provedores você lida e o quanto se importa com resiliência e visibilidade de custos.
A integração direta é defensável quando você chama exatamente um provedor e nunca chamará outro. No momento em que deseja um segundo modelo, resiliência contra uma queda ou uma única fonte da verdade para os custos, o gateway se paga.
Assumir que compatível significa idêntico. O esquema é igual; o comportamento nem sempre. As equipes portam um prompt para um backend mais barato, veem que "funciona" e lançam em produção, apenas para descobrir semanas depois que seed foi ignorado e as saídas nunca foram reprodutíveis. Teste os parâmetros dos quais você realmente depende em cada backend.
Confiar nousagepara custos sem verificar o streaming. Vários backends omitem o bloco usage em respostas transmitidas a menos que explicitamente solicitado. Painéis de custo baseados nele marcam zero e parecem ótimos até que a fatura real chegue. Verifique se o uso está presente no estilo exato de requisição que você executa em produção.
Definir a URL base e o SDK de forma rígida (hardcoded) por provedor. Isso recria a dispersão que o padrão deveria eliminar. Cada novo modelo se torna um projeto de integração e cada queda de provedor se torna a sua queda. Padronize em um único endpoint e faça da escolha do modelo uma configuração, não código.
Analisar argumentos de chamada de ferramenta sem proteger o formato. Alguns backends retornam arguments como uma string, outros como um objeto. Um JSON.parse cego gera erro no segundo caso. Normalize o formato antes de analisar, ou deixe que um gateway o normalize para você.
Tratar o gateway como mero encanamento de TI. O endpoint é a parte fácil. O valor está no que um único ponto de controle permite: roteamento, fallback, caching, orçamentos e atribuição de custos, que você não consegue adaptar de forma barata em N integrações diretas.
O esquema Chat Completions da OpenAI tornou-se o padrão não por decreto, mas por chegar primeiro e ser adotado em todos os lugares. "Compatível com OpenAI" é o ingresso para esse ecossistema: envie o formato de requisição familiar, analise a resposta familiar. Isso lhe dá uma enorme vantagem — a escolha do modelo como uma string de configuração —, desde que você respeite que compatível não é idêntico e teste os comportamentos dos quais realmente depende.
A maneira mais limpa de obter essa vantagem sem os pontos críticos é padronizar em um único endpoint compatível com OpenAI na frente de cada provedor. Sua aplicação mantém a interface que já conhece e o gateway absorve as particularidades de cada provedor, adicionando roteamento, fallback, caching, orçamentos e atribuição de custos que você nunca conseguiria acoplar em integrações dispersas. Uma interface na entrada; todos os modelos atrás dela.
Unifique todos os provedores de LLM atrás de uma API compatível com OpenAI. Agende uma demonstração.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada


