



novembro 20, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Published: novembro 20, 2026

Blazingly fast way to build, track and deploy your models!
Pergunte a um líder de plataforma para quantos LLMs distintos sua empresa está pagando agora e você geralmente obterá uma pausa, seguida de um palpite. A resposta honesta costuma ser "mais do que pensamos", porque qualquer engenheiro com um cartão de crédito e uma chave de API pode conectar um novo modelo a um serviço em uma tarde. Cada uma dessas integrações é uma fatura separada, um conjunto separado de credenciais e um caminho separado para dados confidenciais saírem da empresa, nada disso visível de um único lugar.
Um catálogo de modelos é o controle que fecha essa lacuna. É a resposta única e governada para a pergunta "quais modelos nossas equipes têm permissão para chamar e sob quais regras?" Não uma planilha de fornecedores aprovados, mas uma lista executável onde cada entrada carrega a política que se aplica a ela.
Este artigo define o catálogo de modelos com precisão, traça uma linha clara entre um catálogo e um registro de modelos (eles são constantemente confundidos), explica por que a dispersão é perigosa e cara, e mostra como um catálogo implementado em um gateway vincula políticas reais a um nome lógico de modelo.
Quer um catálogo governado de modelos aprovados com orçamentos e políticas por modelo? Agende uma demonstração.
Um catálogo de modelos é um conjunto curado de entradas lógicas de modelos. Cada entrada tem duas metades.
A primeira metade é a vinculação (binding): um nome lógico (por exemplo, summarizer-prod) mapeado para um ou mais alvos reais (um provedor específico, versão do modelo e endpoint). Esta é a mesma indireção que um nome de modelo lógico/virtual oferece: as aplicações chamam o nome, não o provedor bruto.
A segunda metade é a política anexada a essa entrada:
Uma entrada está "no catálogo" apenas quando ambas as metades existem. Essa é a distinção entre um catálogo e uma lista de nomes de modelos em uma wiki: o catálogo executa a política, porque ela viaja com a entrada e é aplicada a cada chamada.
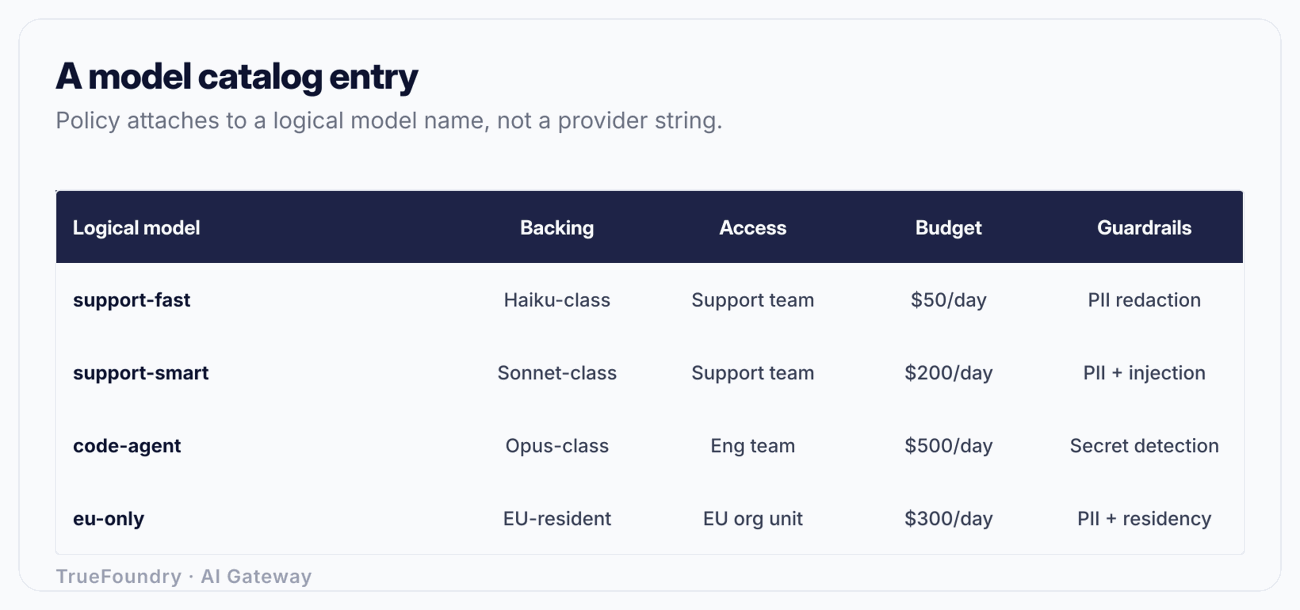
Como a política se vincula ao nome lógico e não ao código da aplicação, alterá-la é uma operação de um único lugar. Reduza o orçamento de uma equipe, troque a versão do modelo subjacente, adicione um guardrail de PII e cada serviço que chama esse nome lógico herdará a alteração na próxima requisição. Sem reimplantações, sem busca em repositórios por strings de modelos codificadas de forma rígida (hardcoded).
Este é o esclarecimento mais importante do artigo, porque os termos são usados de forma intercambiável e se referem a sistemas completamente diferentes.
Um registro de modelos (model registry) (pense nos registros de artefatos em ferramentas de MLOps) gerencia artefatos de modelos treinados. Sua unidade é um modelo que você produziu: um conjunto de pesos, com versões, linhagem até a execução do treinamento e dataset, métricas e um ciclo de vida (staging, produção, arquivado). Você usa um registro quando seus cientistas de dados treinam modelos e você precisa rastrear, promover e implantar esses artefatos de forma reproduzível.
Um catálogo de modelos gerencia o acesso aos modelos que suas equipes consomem, a maioria dos quais você não treinou, como APIs de LLM de terceiros e modelos de pesos abertos que você serve. Sua unidade é uma entrada aprovada e vinculada a políticas. Você usa um catálogo para controlar quem pode chamar qual modelo, a que custo, em qual região e sob quais guardrails.
A confusão é compreensível porque ambos lidam com "modelos", mas respondem a perguntas diferentes. Um pergunta: "qual versão do modelo de fraude implantamos e de qual execução de treinamento ela veio?" O outro pergunta: "a equipe de suporte tem permissão para enviar dados de clientes para este LLM e estamos acima do orçamento este mês?" Uma plataforma madura geralmente tem ambos, e eles se situam em camadas diferentes.
Se você absorver apenas uma coisa desta seção: um registro é sobre a oferta de modelos que você constrói; um catálogo é sobre a demanda governada por modelos que suas equipes usam. Escolher a ferramenta errada para um problema de governança deixará você com um repositório de artefatos lindamente versionado e nenhum controle sobre a fatura da OpenAI.
Sem um catálogo, o uso do modelo cresce organicamente, o que parece saudável, mas é na verdade o problema. Três modos de falha se seguem e se agravam.
Modelos fantasma (Shadow models). Um engenheiro adiciona um novo provedor para lançar um recurso. Funciona, então permanece. Ninguém o aprovou, a segurança nunca o revisou e ele não está em nenhum inventário. Multiplique isso por cada equipe ao longo de um ano e você terá uma frota de integrações desconhecidas, cada uma um caminho potencial de exfiltração de dados, que nenhuma pessoa consegue enumerar. Você não pode governar o que não pode ver.
Faturas surpresa. Quando cada serviço possui sua própria chave de API, os gastos são distribuídos pelas faturas dos provedores sem tags comuns. A fatura mensal chega como um número grande, e ninguém consegue responder "qual equipe causou o aumento de 40%?" sem um exercício forense. Custos que não podem ser atribuídos não podem ser controlados, o que é toda a premissa do FinOps para IA.
Lacunas de conformidade. Esta é a falha que encerra carreiras. Uma integração não governada envia dados de clientes da UE para um modelo executado em uma região dos EUA, violando um compromisso de residência. Ou prompts brutos contendo PII chegam a um provedor sem redação no caminho. Ou uma aplicação vaza um segredo em um prompt e ele é registrado no lado do provedor. Cada lacuna existe porque não havia um ponto de execução entre a aplicação e o modelo.
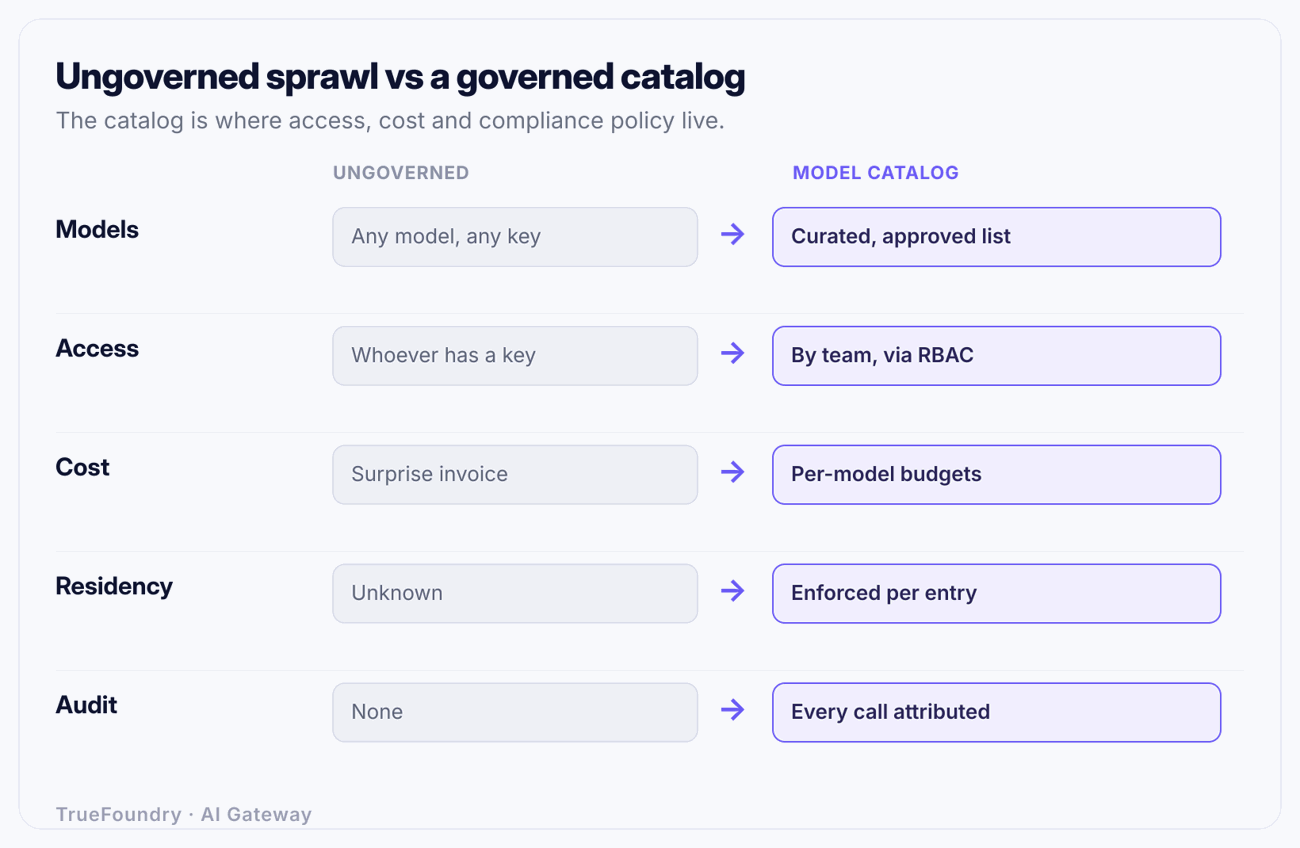
A causa raiz comum é a ausência de um ponto de controle (chokepoint). A conexão direta entre aplicação e provedor significa que não há um lugar único para ver o uso, atribuir custos ou aplicar políticas. Um catálogo, implementado em um gateway, reintroduz esse ponto de controle sem tirar a escolha de modelos das equipes: elas ainda atendem a si mesmas, mas a partir de um conjunto aprovado e governado.
Veja como a TrueFoundry anexa políticas de acesso, custo e residência a cada modelo. Agende uma demonstração.
O catálogo é tão útil quanto sua capacidade de execução, e a execução é a razão pela qual ele pertence ao AI gateway e não a um documento. Estruturalmente, este é o mesmo ponto de controle que um proxy LLM oferece: cada requisição passa por um único lugar, para que a política possa ser aplicada a cada chamada.
Aqui está o que acontece em uma única requisição quando o catálogo reside no gateway. Um serviço chama o modelo lógico support-assistant. O gateway:
support-assistant. Se não for permitido, a requisição é recusada.Cada uma dessas etapas referencia a política da entrada, não o código no serviço chamador. Esse é o ponto. A aplicação envia um nome; o gateway executa tudo aquilo a que o nome está vinculado. Altere a vinculação (nova versão do modelo) ou a política (orçamento menor, guardrail adicionado) no catálogo, e a próxima requisição a obedecerá, sem necessidade de alteração na aplicação.
Isso também torna o catálogo o lar natural para os controles documentados em ferramentas de governança. Limites de taxa e orçamentos são detalhados em limites de taxa de tokens LLM e orçamentos; a atribuição que torna os orçamentos significativos está em atribuição de custos LLM e orçamentos de equipe; as verificações de segurança estão em guardrails de IA; e a aplicação de residência está em residência de dados. O catálogo é onde essas políticas são anexadas a modelos específicos e se encaixa no conjunto mais amplo de ferramentas de governança de IA.
A TrueFoundry implementa exatamente isso: um catálogo de modelos onde cada nome lógico de modelo carrega seu controle de acesso, orçamento, limites de taxa, residência e guardrails, aplicados no gateway a cada requisição, com observabilidade por requisição identificada por usuário, equipe e modelo. Como o plano de dados pode ser executado em sua própria VPC, on-premise ou air-gapped, a residência não é uma promessa em um painel, mas uma propriedade de onde o tráfego flui fisicamente.
Concretamente, a entrada para support-assistant pode ser lida como: nome lógico support-assistant, sustentado por uma versão específica do modelo do provedor; acesso limitado às equipes de Suporte e CX; orçamento de 2.000 USD/mês; limite de taxa de 50.000 tokens/minuto por equipe; residência fixada na UE; guardrails de redação de PII e detecção de prompt injection, ativos tanto para entrada quanto para saída. Um desenvolvedor na equipe de Suporte chama support-assistant e obtém um modelo governado com zero conhecimento do provedor, da região ou dos limites. Um desenvolvedor de outra equipe que chamar o mesmo nome será recusado. Isso é autoatendimento e governança ao mesmo tempo.
Veja como é um catálogo pequeno, mas realista. Cada linha é uma entrada lógica; as colunas são a política vinculada a ela. Os números são ilustrativos.
Leia qualquer linha e você poderá responder, para esse modelo, a todas as perguntas de governança: quem, quanto, quão rápido, onde e com que segurança. Leia uma coluna de cima para baixo e você poderá auditar uma única dimensão em todos os modelos, por exemplo, "quais modelos estão fixados na UE?" Essa legibilidade bidirecional é o que um catálogo proporciona e o que uma pilha de chaves de API espalhadas nunca poderá fornecer.
Confundir um catálogo com um registro. As equipes configuram um registro de modelos, versionam tudo perfeitamente e ainda assim não conseguem controlar quem chama a API da OpenAI ou quanto ela custa, porque um registro governa artefatos que você treina, não o acesso a modelos que você consome. Decida qual problema você tem antes de escolher uma ferramenta.
Tratar o catálogo como uma lista estática. Uma página de modelos aprovados em uma wiki não é um catálogo; é uma documentação que ninguém executa. O valor está na execução a cada requisição. Se a lista não bloquear uma chamada não autorizada ou um prompt que viole a residência, ela é uma sugestão, não um controle.
Anexar políticas ao código da aplicação em vez do nome do modelo. Codificar rigidamente uma verificação de orçamento ou uma região em cada serviço gera políticas espalhadas, inconsistentes e inauditáveis que se desviam no momento em que alguém esquece de adicioná-las. Vincule a política ao modelo lógico no catálogo para que cada chamador a herde e as alterações se propaguem em um só lugar.
Governar custos, mas não dados. Orçamentos e limites de taxa são a metade fácil. As falhas caras são as de conformidade: dados cruzando uma região, PII chegando a um provedor sem redação. Um catálogo que controla gastos, mas não a residência e os guardrails, deixa abertas as lacunas que encerram carreiras.
Falta de atribuição por requisição. Se o uso não for marcado por usuário, equipe e modelo no momento da chamada, os orçamentos se tornam inexequíveis e a fatura mensal torna-se um mistério. A atribuição precisa acontecer por onde o tráfego flui, no gateway, e não ser reconstruída posteriormente a partir das faturas do provedor.
Um catálogo de modelos transforma a pergunta "quais modelos temos permissão para usar e sob quais regras?" de uma dúvida que ninguém consegue responder em uma lista governada e executável. Cada entrada é um nome lógico de modelo que carrega seu próprio controle de acesso, orçamento, limites de taxa, residência e guardrails. Como a política se vincula ao nome, você a altera em um só lugar e todos os chamadores a obedecem. Fundamentalmente, um catálogo não é um registro de modelos: um governa o acesso aos modelos que você consome, o outro versiona os artefatos que você treina.
A razão para implementá-lo em um gateway é a execução. Uma lista em uma wiki documenta a intenção; um catálogo no ponto de controle por onde passa cada requisição realmente recusa a chamada não autorizada, limita a equipe que ultrapassou o orçamento, mantém os dados da UE na UE e redige a PII antes que ela saia. É assim que você dá às equipes acesso em autoatendimento aos modelos enquanto mantém custo, acesso, residência e segurança sob controle, em vez de descobrir as lacunas na fatura ou em uma auditoria.
Governe quais modelos suas equipes podem usar a partir de um único catálogo. Agende uma demonstração.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada


