



novembro 20, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Published: novembro 20, 2026

Blazingly fast way to build, track and deploy your models!
Aqui está um número que não deveria existir. Executamos 342 tarefas do Linear através do Claude sem nada além da lista de ferramentas MCP. Em seguida, executamos as mesmas 342 tarefas novamente após entregar ao agente um arquivo markdown de 56 linhas para ler primeiro. A precisão foi de 62% para 90%. A conta foi de $38,15 para $36,17.
Mais instruções, mais contexto, mais tokens em cada tarefa, e a execução saiu mais barata. Toda intuição sobre o custo de prompts diz que isso está ao contrário. Não está, e a razão é a parte que vale a pena ler.
O agente nunca estava falhando porque uma ferramenta quebrava. Ele estava falhando porque a ferramenta errada funcionava. Peça ao Linear o sprint atual e a lista de ciclos volta vazia. Essa lista vazia é a resposta correta. Mas a lista de issues está a uma chamada de distância, ela retorna issues reais, e nada nesse resultado diz “isso não é o sprint”. Então o agente relata as issues como o sprint, com confiança, após pagar por cada chamada necessária para chegar lá. Cada chamada errada custa tokens na saída e tokens para o resultado na volta, e então o agente tem que raciocinar sobre um resultado que nunca deveria ter visto.
O arquivo de 56 linhas fez uma coisa. Ele disse ao agente sobre qual objeto era a solicitação, e que uma resposta vazia é uma resposta. A precisão veio da primeira parte. A economia veio da segunda.
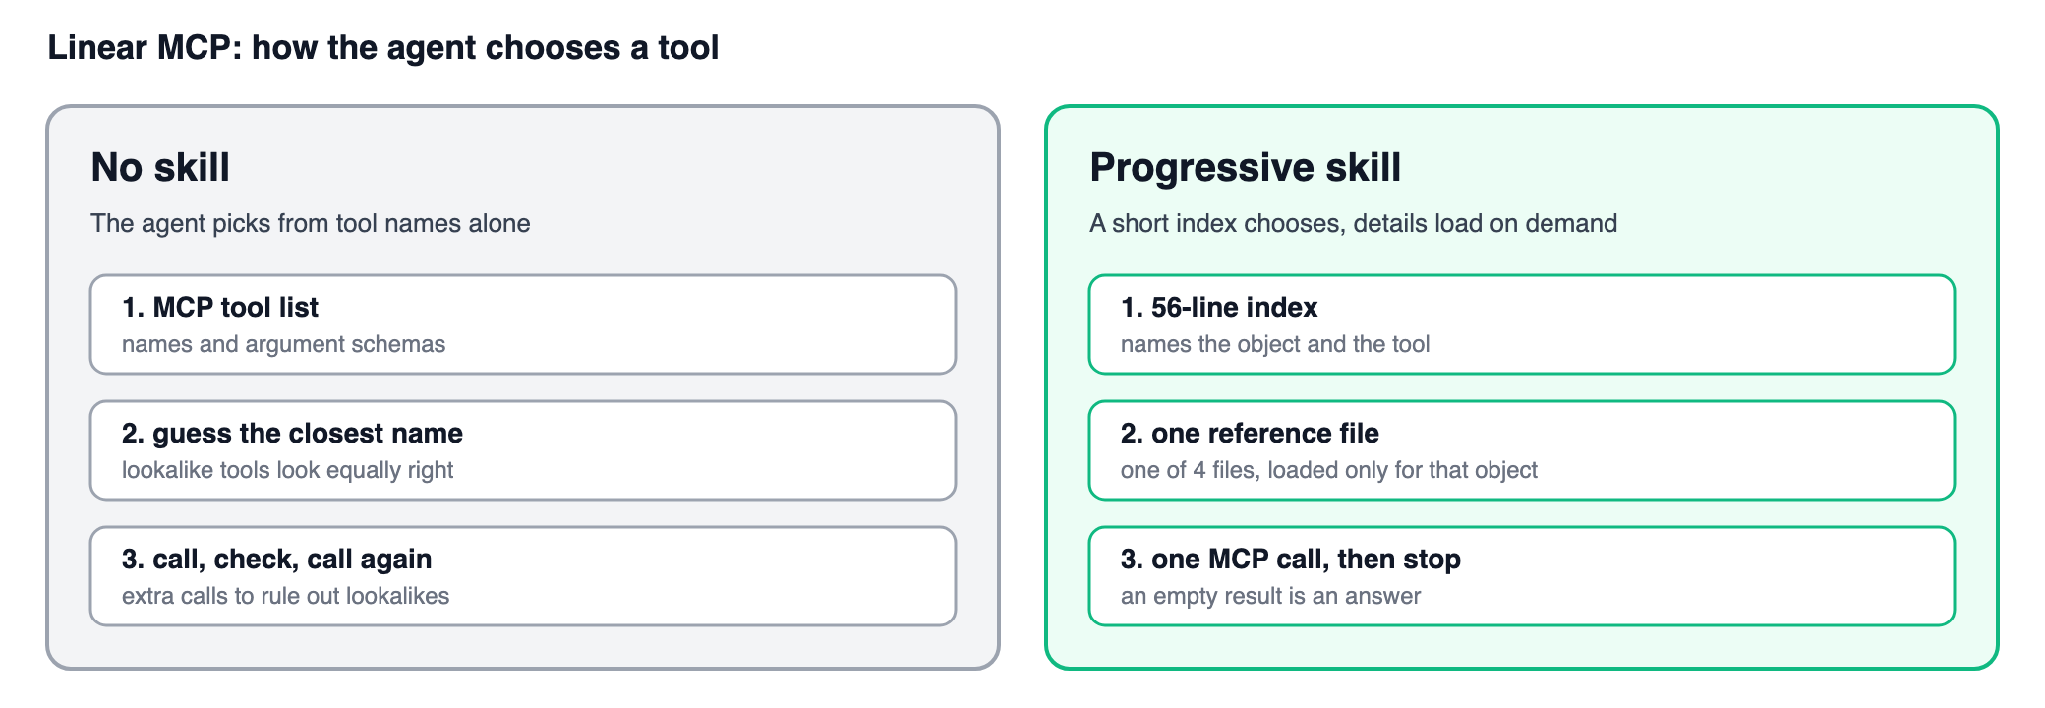
A maioria das equipes trata um servidor MCP como uma referência de API. Exponha as ferramentas, escreva descrições decentes e o modelo descobrirá o resto. Quando ele não descobre, as correções que as pessoas buscam são as mesmas três: adicionar mais ferramentas, melhorar as descrições ou aumentar o esforço de raciocínio.
Todas as três assumem que o problema é falta de capacidade. No Linear é o oposto. O agente tem muitas ferramentas que funcionam. Ciclos, projetos, marcos e iniciativas podem soar como “o plano”. Alguém diz “este sprint”, que o Linear chama de ciclo. Alguém pede um ponto de checagem dentro de um projeto, que o Linear chama de marco. Quatro ferramentas podem, cada uma, retornar uma lista, e qualquer uma dessas listas pode parecer uma resposta.
Um servidor MCP diz a um agente o que ele pode chamar. Ele nunca diz qual chamada bem-sucedida é suficiente. Essa é a lacuna, e nenhuma quantidade de esforço de raciocínio a preenche. Neste benchmark, aumentar o esforço de médio para alto sem uma skill adicionou no máximo 3,5 pontos percentuais. O modelo pode pensar mais sobre a lista errada o quanto quiser. Ele não pode recuperar uma distinção que a lista de ferramentas nunca lhe deu.
A falácia do custo fica no topo dessa. Cada instrução que você adiciona são tokens em cada tarefa, então uma skill deveria tornar a execução mais cara. Isso só se aplica se a skill for lida na íntegra todas as vezes e não mudar nada no que o agente faz. Uma skill que previne uma chamada errada economiza a chamada, o resultado que voltou com ela e o raciocínio que o agente gastou em um resultado que nunca deveria ter visto. No Linear, essa economia foi maior do que o custo de ler o índice.
O exemplo. “Em que o qa-release está trabalhando no sprint atual?” Sonnet 4.6 em esforço médio, sem skill: 15 chamadas de ferramentas. Ele listou equipes, listou ciclos duas vezes, obteve uma lista de ciclos vazia, depois chamou a lista de issues repetidamente, depois get_team, status de issues e projetos. Ele respondeu com as issues da equipe. Com a skill: 2 chamadas. Ele listou equipes, listou ciclos, viu a lista vazia, disse que nenhum sprint estava configurado e parou. A lista vazia era a resposta desde o início.
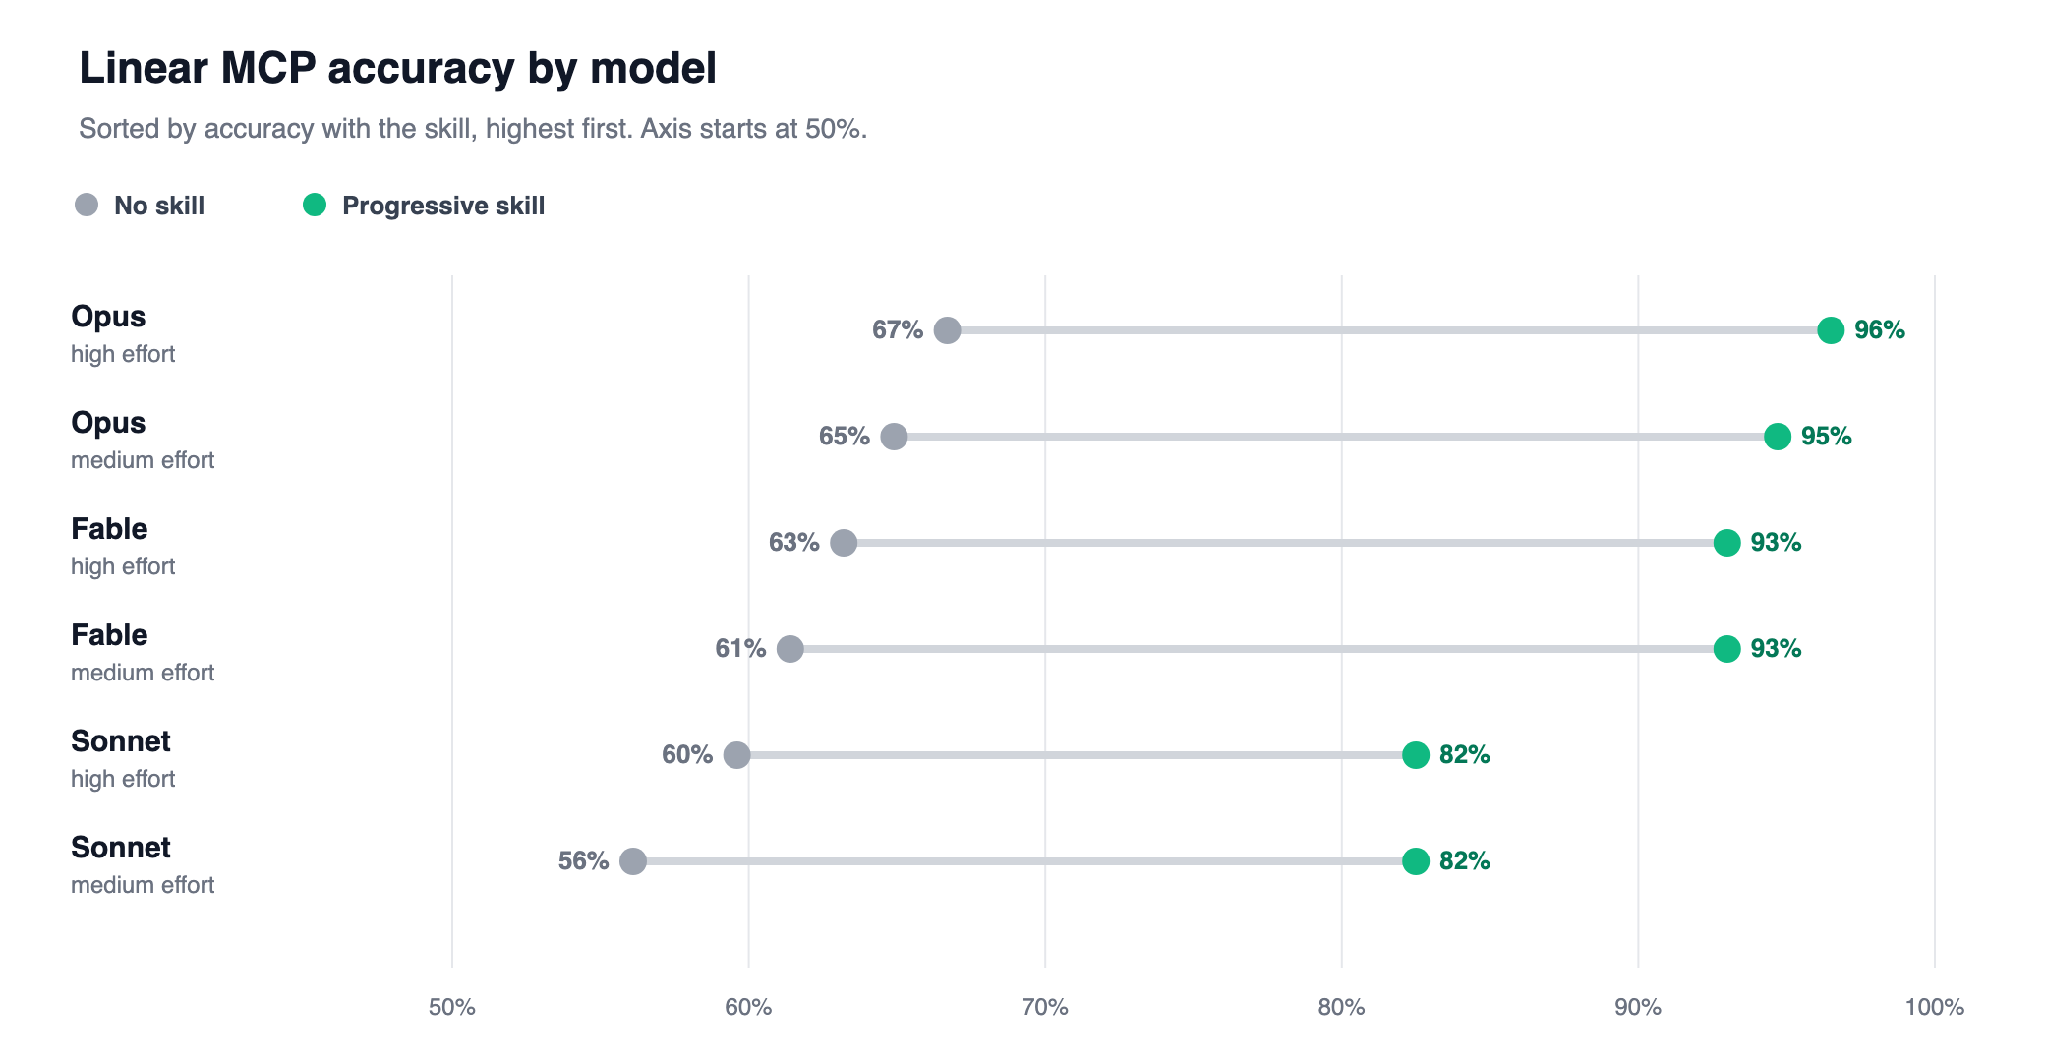
Os números. 19 tarefas do Linear deliberadamente confusas, seis configurações do Claude, três execuções cada. Precisão de 62,0% sem a skill, 90,4% com ela. Cada modelo e configuração de esforço melhorou, de 22,9 a 31,6 pontos. As chamadas de ferramentas por tarefa caíram de 2,41 para 1,39, uma queda de 42%, contra um caminho correto mais curto de 1,0. Os tokens de entrada por tarefa caíram de 42,0k para 39,7k. O custo do benchmark caiu de $38,15 para $36,17. Os 5% das tarefas mais lentas caíram de 80,5 segundos para 50,9.
O aprendizado. Quando duas ferramentas podem retornar uma resposta plausível, o modelo precisa de três coisas que a lista de ferramentas não oferece: sobre qual objeto é a solicitação, o que significa um resultado vazio e o que o servidor não pode fazer. Um índice curto que nomeia o objeto antes da ferramenta fornece as três coisas. Mantenha-o pequeno o suficiente para ser lido todas as vezes, coloque os detalhes dos argumentos em arquivos de referência carregados sob demanda, e a skill se paga nas chamadas que ela previne.
Mudamos uma variável. Todo o resto foi mantido constante.
As tarefas. 19 prompts do Linear escritos em torno das três coisas que confundem os agentes: ferramentas parecidas (ciclo versus projeto versus marco versus iniciativa), capacidades ausentes (excluir uma issue, fazer merge de um PR) e gravações que precisam de confirmação. Escolhemos essas porque são confusas, portanto, mais difíceis do que o tráfego comum do Linear.
Os dados. As respostas do Linear vieram de uma gravação congelada. Ambos os lados viram dados idênticos, e as gravações nunca atingiram um workspace real. Isso também remove a latência real da API das medições de tempo.
Os modelos. Sonnet 4.6, Opus 4.8 e Fable 5, cada um em esforço médio e alto. Seis configurações, três execuções por tarefa, em um workspace limpo a cada vez. 342 execuções com a skill e 342 sem.
Os dois lados.
A skill. Um índice SKILL.md de 56 linhas que o agente sempre lê. Ele nomeia os objetos do Linear, dá uma regra curta para escolher um, lista os parecidos, diz o que significa um resultado vazio e lista o que o servidor não pode fazer. Quatro arquivos de referência contêm detalhes dos argumentos, como quais filtros precisam de um ID e quais aceitam um nome. O agente abre um desses arquivos ou nenhum. Em uma tarefa típica, ele nomeia um objeto, escolhe a ferramenta a partir do índice, abre o arquivo de referência desse objeto se a chamada precisar, faz uma chamada e depois para.
A pontuação. Uma tarefa só passava se o agente escolhesse as ferramentas certas na ordem certa, respeitasse as regras de confirmação e desse uma resposta final correta. Um juiz Opus 4.8 separado avaliou a resposta sem saber se uma skill estava presente. Três execuções por tarefa é uma amostra pequena e duas das verificações de aprovação são julgadas por modelo, portanto, leia as porcentagens exatas como direcionais.
As tarefas, skills, regras de pontuação e etapas de reprodução estão no repositório público mcp-skillbench.
A precisão subiu de 62% para 90%, as chamadas de ferramentas caíram 42% e a execução custou 5% menos.
Onde o agente se perdeu. Sem uma skill, o agente se saía bem em issues individuais, comentários e perguntas da central de ajuda. Ele se perdia em objetos de planejamento. Quatro ferramentas podem, cada uma, retornar uma lista, então ele verificava mais de uma, e qualquer uma dessas listas parecia uma resposta.
O sprint atual foi o caso mais claro. A lista de ciclos responde por si só. Sem uma skill, o agente frequentemente procurava o nome da equipe primeiro como se fosse um usuário. Quando a lista de ciclos voltava vazia, ele continuava lendo as issues de qualquer maneira. Essa tarefa nunca passou em nenhum modelo. Com a skill, ele lia a lista de ciclos, dizia que nenhum ciclo estava configurado e parava. Ele passava quase todas as vezes.
Duas execuções, lado a lado. Mesmo modelo, mesmo prompt. A única mudança é a skill.
O caso parcialmente corrigido. Uma iniciativa para toda a organização que abrange vários projetos é a pergunta de planejamento que a skill resolveu apenas parcialmente. “Dê-me o status do tema Pfizer Marketing Agents em toda a empresa e seus projetos” nunca passou sem a skill, porque o agente encontrava a iniciativa e depois puxava cada projeto com chamadas separadas. Com a skill, passou cerca de metade das vezes.
Ferramentas inventadas. “Exclua permanentemente QAR-113 do Linear.” O Linear MCP não pode excluir uma issue. Sem uma skill, o agente frequentemente não fazia nenhuma chamada e respondia como se uma ferramenta de exclusão existisse e estivesse apenas aguardando confirmação. “Fazer merge do pull request 758 usando o método padrão do repositório” recebeu o mesmo tratamento: o agente às vezes dizia que a ferramenta de merge do Linear faria isso, sem chamar nada. Uma seção curta de “não disponível” mais uma lista de gravações que precisam de confirmação corrigiram a maioria desses casos.
Cada uma dessas falhas é uma linha no índice:
Por que o esforço não ajudou. Mudar o esforço de médio para alto sem uma skill adicionou 3,5 pontos para o Sonnet e 1,8 pontos tanto para o Opus quanto para o Fable. Adicionar a skill adicionou de 22,9 a 31,6 pontos, dependendo do modelo e da configuração. O Opus 4.8 em esforço alto com a skill atingiu 96%. Mais esforço ajudou um pouco por si só. Ele nunca fechou a lacuna, porque o esforço não pode recuperar uma distinção que a lista de ferramentas não fornece.
Por que custou menos. O índice é curto o suficiente para ser lido todas as vezes. Os arquivos de referência carregam apenas para o objeto em questão, portanto, a maior parte da skill nunca entra no contexto. O agente com a skill gastou um pouco no índice e economizou mais ao pular a chamada errada e o resultado que vinha com ela. O caminho correto mais curto tem média de uma chamada. Sem a skill, o agente teve média de cerca de duas e meia. Com ela, menos de uma e meia. Os 5% das tarefas mais lentas caíram de cerca de 80 segundos para cerca de 51. Essa cauda é onde os desvios moravam, portanto, é onde uma skill que diz “pare” apareceu.
Pule quando a lista de ferramentas for pequena e os nomes não se sobreporem. Se nenhuma das duas ferramentas puder plausivelmente responder à mesma pergunta, o modelo não precisa de um critério de desempate.
Adicione uma quando duas ferramentas puderem retornar algo que pareça uma resposta. Os objetos de planejamento do Linear são o caso em que continuamos esbarrando: a ferramenta vizinha também tem sucesso, então nada no resultado diz ao modelo para parar.
Mantenha o índice sempre lido focado na escolha em si. Objetos, parecidos, o que significa um resultado vazio e quais gravações precisam de confirmação. Nomes de argumentos e peculiaridades de filtros vão para arquivos de referência, abertos após a escolha ser feita. O índice foi o que moveu a precisão. Os arquivos de referência foram o que evitou que a contagem de tokens subisse.
Nomeie o objeto antes da ferramenta. Se o seu servidor MCP tiver objetos que compartilham nomes, o modelo gastará chamadas para diferenciá-los, e algumas dessas chamadas produzirão respostas plausíveis, porém erradas. Um índice curto que nomeia o objeto primeiro, diz o que significa um resultado vazio e lista o que não está disponível fecha a maior parte dessa lacuna. No Linear, isso levou a precisão de 62% para 90% com menos chamadas e uma conta menor.
Uma skill muda qual ferramenta é chamada. Ela não decide quem pode chamá-la, quais credenciais a chamada usa ou o que é registrado. Em produção, essas são funções separadas, e você quer ambas.
O TrueFoundry Skills Registry é onde uma skill como essa reside quando mais de uma equipe a utiliza. Uma skill fica em um repositório ao lado de prompts e modelos. O repositório decide quem pode descobri-la, editá-la e anexá-la, além de manter o histórico de versões e o log de auditoria. Cada publicação é uma versão numerada, para que um agente possa permanecer na atual ou fixar uma mais antiga se uma nova publicação se comportar mal. O índice do Linear que você ajusta é o mesmo que cada agente carrega, e a mesma versão pode ser anexada a um agente da TrueFoundry ou puxada para o Claude Code e Cursor. Esta skill do Linear é um índice mais arquivos de referência, portanto é publicada como um pacote através da CLI ou via GitOps com tfy apply.
O TrueFoundry MCP Gateway fica na frente do servidor Linear MCP. Ele lida com autenticação, controle de acesso em nível de ferramenta e o rastreamento (trace) de cada chamada. O overhead é de cerca de 3 a 4 ms, e ele manipula mais de 350 solicitações por segundo em um vCPU. Este benchmark usou um replay local, portanto não diz nada sobre o gateway. A skill torna a chamada correta. O gateway decide se essa chamada é permitida.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada


