



November 4, 2026
|
5 min read

Blazingly fast way to build, track and deploy your models!
単一のツール呼び出しループは、4ステップで完了するタスクには適していますが、1時間かかるような作業では破綻してしまいます。モデルは作業の筋道を失い、会話履歴はコンテキストウィンドウから溢れ出し、巨大なツール実行結果が後続のすべての処理を汚染してしまいます。
デモと実用的なエージェントを分かつものは「ハーネス」です。エージェントが自らの作業を分解・追跡するための計画機能、メッセージ履歴以外の場所へ中間状態を保存する機能、サブタスクにクリーンなコンテキストを渡すための委譲機能、そして長時間実行でも破綻しないための圧縮機能。LangGraph Deep Agentsは、これら4つの課題に対するLangChainのパッケージ化された回答です。
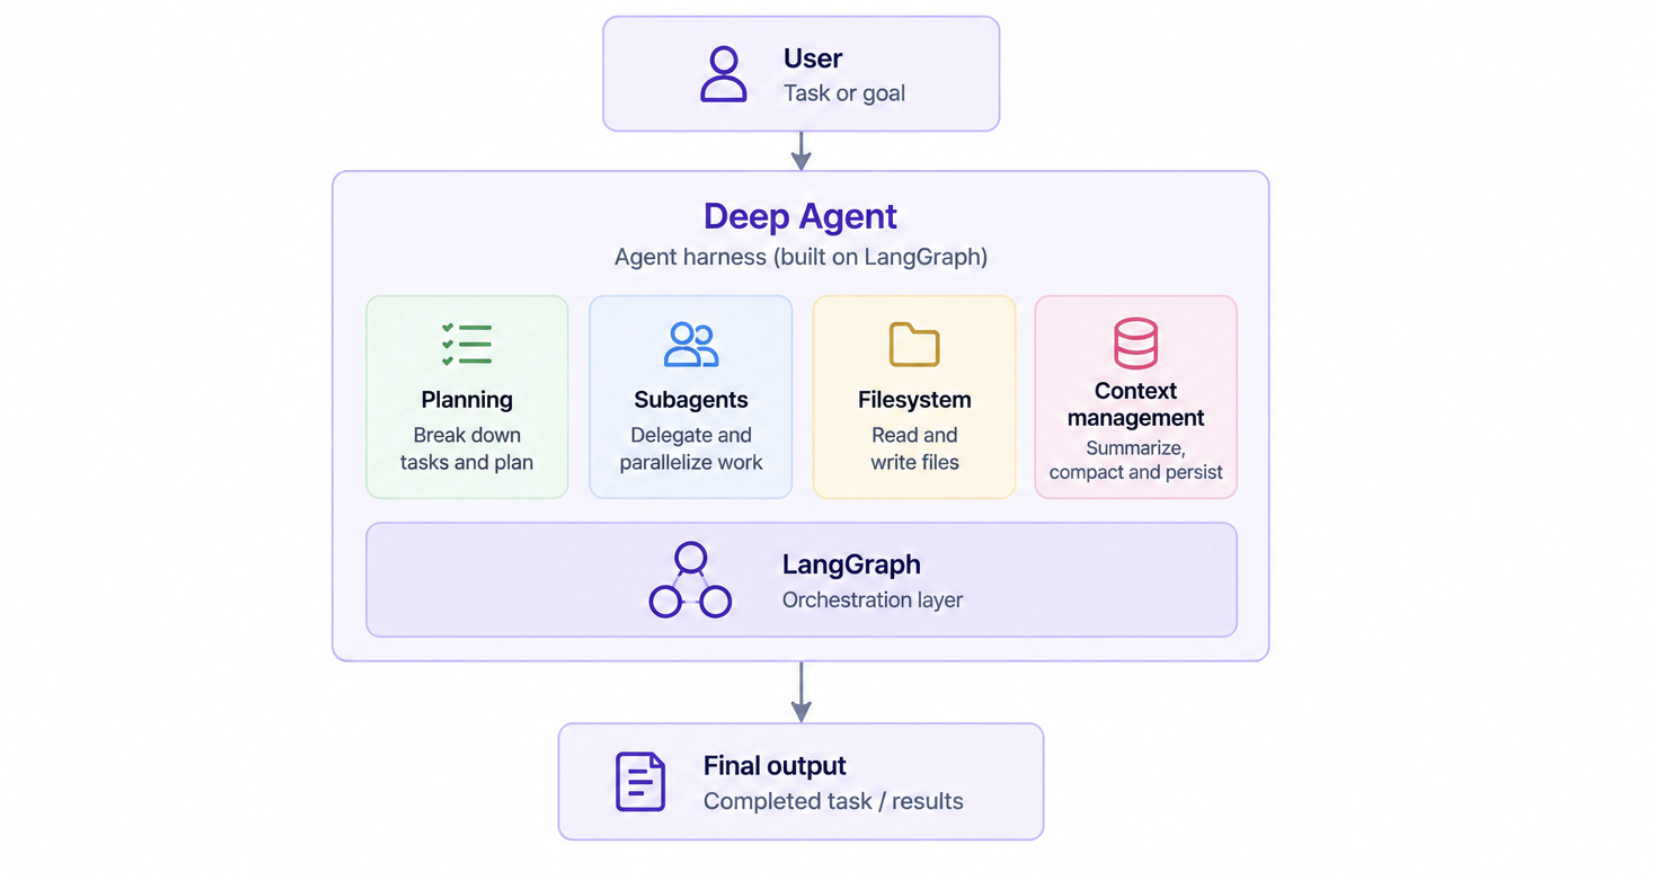
Deep Agentsは、LangChainチームが提供するオープンソースのMITライセンス下にあるエージェント用ハーネスです。Pythonでは deepagents パッケージとして、JavaScriptおよびTypeScriptでは deepagents としてnpmで配布されており、リリース以来、GitHubで約15,000のスターを獲得しています。
エントリーポイントは単一の関数です:
この呼び出しにより、呼び出しやデプロイが可能なコンパイル済みのLangGraphグラフが返されます。その背後で、ハーネスはすでに計画ツール、ファイルシステムアクセス、サブエージェント機能、要約機能、そしてそれらすべてをモデルに活用させるための組み込みシステムプロンプトを付与しています。ユーザーはモデルとドメイン固有のツールを提供するだけで、ハーネスがそのための足場(スキャフォールディング)を提供します。
JavaScriptパッケージは環境ごとのエントリーポイント(deepagents はNode用、 deepagents/browser はブラウザでの安全な使用用)を提供し、LangChainランタイムパッケージをピア依存関係として宣言しているため、アプリケーション側でバージョンを制御し、すべてを単一の共有コピーに解決できます。
Deep Agentsはミドルウェアによって構成されています。各パーツがエージェントにツールやプロンプトの指示を追加しており、それらはすべて上書きや削除が可能です。デフォルトのセットを理解することが、何が得られるのかを把握する最も早い方法です。
追加します: write_todos 計画ツール。エージェントは目標をタスクに分解して記録し、進捗に応じて更新します。一見単純に思えますが、そうではありません。明示的で書き込み可能な計画こそが、モデルが20回ものツール呼び出しの後に迷走することなく、元の作業位置を復帰させるための鍵となります。
追加します: ls、 read_file、 write_file、 edit_file、 glob、 grep および delete、さらにオプションで execute ツール(バックエンドが対応している場合)。ファイルシステムはエージェントの作業メモリとして機能します。40,000トークンものスクレイピング結果をメッセージ履歴に保持する代わりに、エージェントはそれをファイルに書き込み、後で必要な部分をgrepで抽出します。
追加します。 task ツール。サブエージェントに作業を委任するためのもので、各サブエージェントは独立したコンテキストウィンドウで実行されます。親エージェントは、探索の全過程ではなく結果のみを受け取ります。これは、コンテキストを制御する上で最も効果的な手法です。
Agent Protocolを介した非同期サブエージェントもサポートしており、サブエージェントはタスクIDを即座に返し、メインエージェントは実行中も処理を継続できます。これらのタスクIDはエージェントの状態として以下に保持されます。 async_tasksこれにより、コンテキストの圧縮やオフロードが行われても状態が維持されます。LangGraph Platformや、Agent Protocol仕様を実装した任意のセルフホストサーバーで動作します。
会話がコンテキスト制限を超えた際にメッセージ履歴を圧縮します。これは多くのチームが手動で実装して失敗しがちな部分であり、通常は先頭から切り捨てることで元の指示が失われてしまいます。
Anthropicモデルにおける冗長なトークン処理を自動的に削減します。システムプロンプトやツール定義がステップごとに再送信されるような長時間の実行において、コスト削減に直結します。
ツール呼び出しが結果を返す前に中断またはキャンセルされた場合、メッセージ履歴を修復します。地味ですが、実行途中でプロバイダー側のバリデーションエラーが発生するのを防ぐ重要な修正です。
関連機能を使用すると、さらに2つのミドルウェアが追加されます。 MemoryMiddleware はセッション間でコンテキストを永続化し、エージェントのメモリを以下から読み込みます。 AGENTS.md ファイル、および SkillsMiddleware は、カスタムスキルを有効にします。
ファイルシステムは、他の多くの機能が依存しているため、独立したセクションとして解説する価値があります。スキル、メモリ、コード実行、コンテキスト管理のすべてが同じ仮想ファイルシステムを介して読み書きを行っており、独自のカスタムツールやミドルウェアも同様に利用可能です。
このシステムはプラグイン可能です。バックエンドには、インメモリ状態、ローカルディスク、LangGraphストア、複数のバックエンドにまたがる複合ルーティング、分離実行のためのサンドボックスバックエンドなどがあります。バックエンドを切り替えることで、エージェントのコードを変更することなくファイルの物理的な保存場所を変更できるため、同じエージェントをノートブック、CI、本番環境のすべてで実行可能にしています。
また、このハーネスは、エージェントが読み書きできるファイルやディレクトリを制御する宣言的な権限ルールもサポートしています。ルールはエージェント作成時にリストとして渡され、宣言された順序で評価され、最初に一致したルールが適用される仕組みとなっており、組み込みのファイルシステムツールに適用されます。最小権限のエージェントを設計する際に注意すべき点として、宣言的なサブエージェントは親のファイルシステム制限を継承しません。サブエージェントを個別に制限するには、独自の FilesystemMiddleware インスタンスを与える必要があります。
このトピックに関する解説の多くが誤解を招いているため、明確にしておく必要があります。「Deep Agents vs LangGraph」という検索は、2つの選択肢から選ぶような印象を与えますが、実際にはそのような選択肢は存在しません。create_deep_agent() はLangGraphのグラフを返します。Deep Agentsとは、ハーネスがあらかじめ組み込まれたLangGraphのことです。
LangChainは、同じスタックの3つのレイヤーを次のように説明しています。
create_agent バンドルされたミドルウェアを含まない、より軽量なハーネスが必要な場合これらのレイヤーは競合するものではなく、構成されるものです。あらゆる LangGraph CompiledStateGraph は、Deep Agentのサブエージェントとして渡すことができるため、カスタムオーケストレーションをハーネスのデフォルト機能と並行して組み込むことができます。まずは create_deep_agent() で開始し、標準的なループでは処理が難しいワークフローに直面した際に、その部分だけを LangGraph グラフとして構築し、サブエージェントとしてハーネスに渡すといった使い方が可能です。既存の資産を無駄にすることはありません。
LangGraphがLangChainエコシステム全体の中でどのような位置付けにあるのかを整理したい場合は、こちらの LangChainとLangGraphの比較解説 をご覧ください。
重要なのは機能の優劣ではなく、どの程度の制御を自前で行いたいかという点です。デフォルト設定をそのまま利用すれば構築の手間は省けますが、その分、より深いレイヤーに踏み込まない限りカスタマイズはできなくなります。
Deep Agentsの利用シーン 長期にわたるオープンエンドなタスクに適しています。数十のソースにまたがる調査、複数ファイルにわたるコード変更、エージェントがドラフトを保持する必要があるドキュメント生成などが該当します。また、来月ではなく今週中に信頼性の高いエージェントを稼働させる必要がある場合にも最適です。
create_agentの利用シーン 必要なツールが明確で、数ステップで完了するタスクに適しています。3ステップで終わる分類エージェントに計画ツールや仮想ファイルシステムを組み込むと、プロンプトのオーバーヘッドやレイテンシが増大するだけでメリットがありません。
LangGraphを直接利用するシーン 制御フローそのものが課題となる場合に適しています。明示的な分岐、決定論的なルーティング、特定のノードでの人間による承認ゲート、ツール呼び出しループ以外のサイクルなどが必要な場合です。既存のフレームワークでフローを表現することに限界を感じたら、次のステップへ進む時期です。単一エージェントを超えたマルチエージェントパターンについては、こちらの マルチエージェントオーケストレーション ガイドで詳しく解説しています。
LangChainのDeep Agentsは、計画、サブエージェント、ファイルシステムツール、スキル、メモリ、長時間実行など、個々のエージェント内部の複雑な処理の多くを解決します。しかし、複数のチームでエージェントを運用する段階になると、課題は「エージェントの構築」から 「エージェント群の運用」へと移行します。
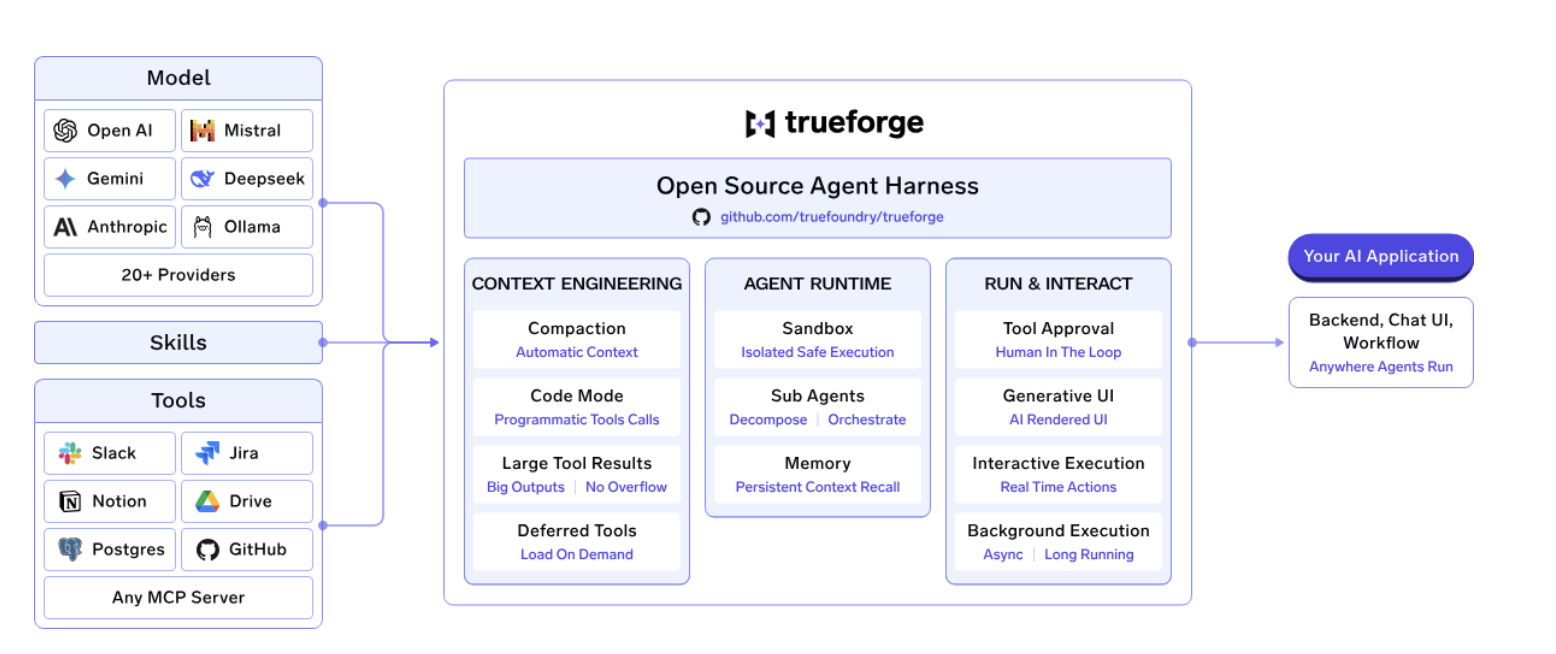
TrueForge は、TrueFoundryが提供するオープンソースかつベンダーニュートラルなエージェントハーネスであり、このランタイムレイヤーを支えます。計画、ツール呼び出し、コンテキスト管理、承認、セッション状態管理を含むエージェントループを実行しつつ、独自のモデル、MCPサーバー、サンドボックスプロバイダーを自由に組み合わせて利用可能です。
ローカル環境で実行するには、以下のコマンドを使用します。 npx @truefoundry/trueforge、またはDocker ComposeやHelmを使用してチーム向けに同じハーネスをデプロイすることも可能です。 TrueForgeのドキュメントをご覧ください。
TrueForgeには、モデルに渡されるコンテキストやツールデータの量を制御するためのメカニズムがいくつか用意されています。
ツールの遅延読み込み は、MCPツールスキーマを事前にウィンドウへ読み込むのではなく、必要な時に読み込む仕組みです。「コードモード」では、エージェントが1つのサンドボックススクリプト内で複数のツール呼び出しを連鎖させることができるため、すべての中間結果ではなく、出力された要約のみがコンテキストに入ります。 サイズが大きすぎるツール応答は サンドボックスファイルにオフロードされ、パスとプレビューに置き換えられます。コンパクション(圧縮)はモデルのコンテキスト長が80%に達した時点で実行され、古い履歴を構造化された要約に置き換えます。これはリプレイに対する直接的な回答となります。サブエージェントはそれぞれ独立したクリーンなコンテキストで実行され、結果のみを返します。
サンドボックスモデルも重要な制御要素です。多くのハーネスはセッション全体をコンテナでラップしますが、TrueForgeはサンドボックスをツールとして扱い、エージェントが実際にコードを実行する必要がある時のみ起動します。そのため、1台のサーバーで多数のエージェントを同時に実行でき、コードに触れないタスクのコストを低く抑えられます。
TrueForgeは、単なるライブラリインターフェースではなく、ランタイムとして構成されています。
その コアサーバー は、エージェントループを実行し、ストリーミング、承認ゲート、サブエージェントの委任、コンパクション、永続セッションを提供します。また、 HTTP APIおよびTypeScript SDK (@truefoundry/trueforge-sdk)プログラムから同じ機能を利用できます。独立した チャットUIおよびUI SDK (@truefoundry/trueforge-ui)は、そのまま使用することも、テーマを適用することも、他の製品に組み込むことも可能です。
これにより、チームはPythonエージェントの定義そのものにとどまらないデプロイ環境を手に入れることができます。つまり、同じランタイムでアプリケーション、API、あるいは組み込み型エージェント体験を動かせるようになるのです。
モデル、MCPサーバー、サンドボックスプロバイダーはすべて「持ち込み(BYO)」形式です。より安価なモデルが登場すれば、エージェントを書き直すことなくそのモデルに切り替えることができます。実際、GLM-5.2で実行した同じベンチマークでは、1回あたり2.90ドルで14タスク中約11タスクを解決しました。
エージェントフレームワークとエージェントランタイムの違いは、同じワークロードで比較するとより明確になります。TrueFoundryは TrueForgeとDeep Agents をDevRevのEnterprise-Benchでベンチマークしました。このベンチマークは、14のシステム横断的なエンタープライズタスクで構成されています。各タスクにおいて、エージェントは計画を立て、CRM、プロジェクト管理ツール、ドキュメントストアにまたがるMCPツールを呼び出し、結果を統合して、評価基準を満たす回答を返す必要があります。両方のハーネスで同じタスクを同じMCPサーバーを使用して実行し、回答はブラインドLLMジャッジによってスコアリングされました。
Opus 4.8を固定した場合、両ハーネスのタスク精度は同程度でしたが、実行コストには違いが見られました。
このベンチマークでは、タスク精度には比較的小さな差しかありませんでしたが、実行コストには大きな開きがありました。TrueForgeは トークン使用量が4分の1未満 であり、Deep Agentsと比較して 1回あたりの実行コストが約2.5倍安く なりました(同一モデル使用時)。
この違いの主な要因は、両ランタイムのオーケストレーションとコンテキストの処理方法にあります。Deep Agentsは計画立案、仮想ファイルシステム、サブエージェントといった機能を提供しますが、これらは各ターンにおいてオーケストレーションやコンテキストのオーバーヘッドを増大させる可能性があります。一方、TrueForgeはより軽量なアプローチを採用しており、ターゲットを絞ったツール呼び出しとコンテキストの圧縮を行うことで、膨大な履歴やツール応答をモデルに繰り返し送信することを回避しています。これが重要な理由は、 エージェントのコストは、モデルの価格だけで決まるものではありません。同じモデルを実行する2つのエージェントシステムであっても、計画、ツール利用、コンテキスト管理、サブエージェントの実装方法によって、トークン消費量は大きく異なります。
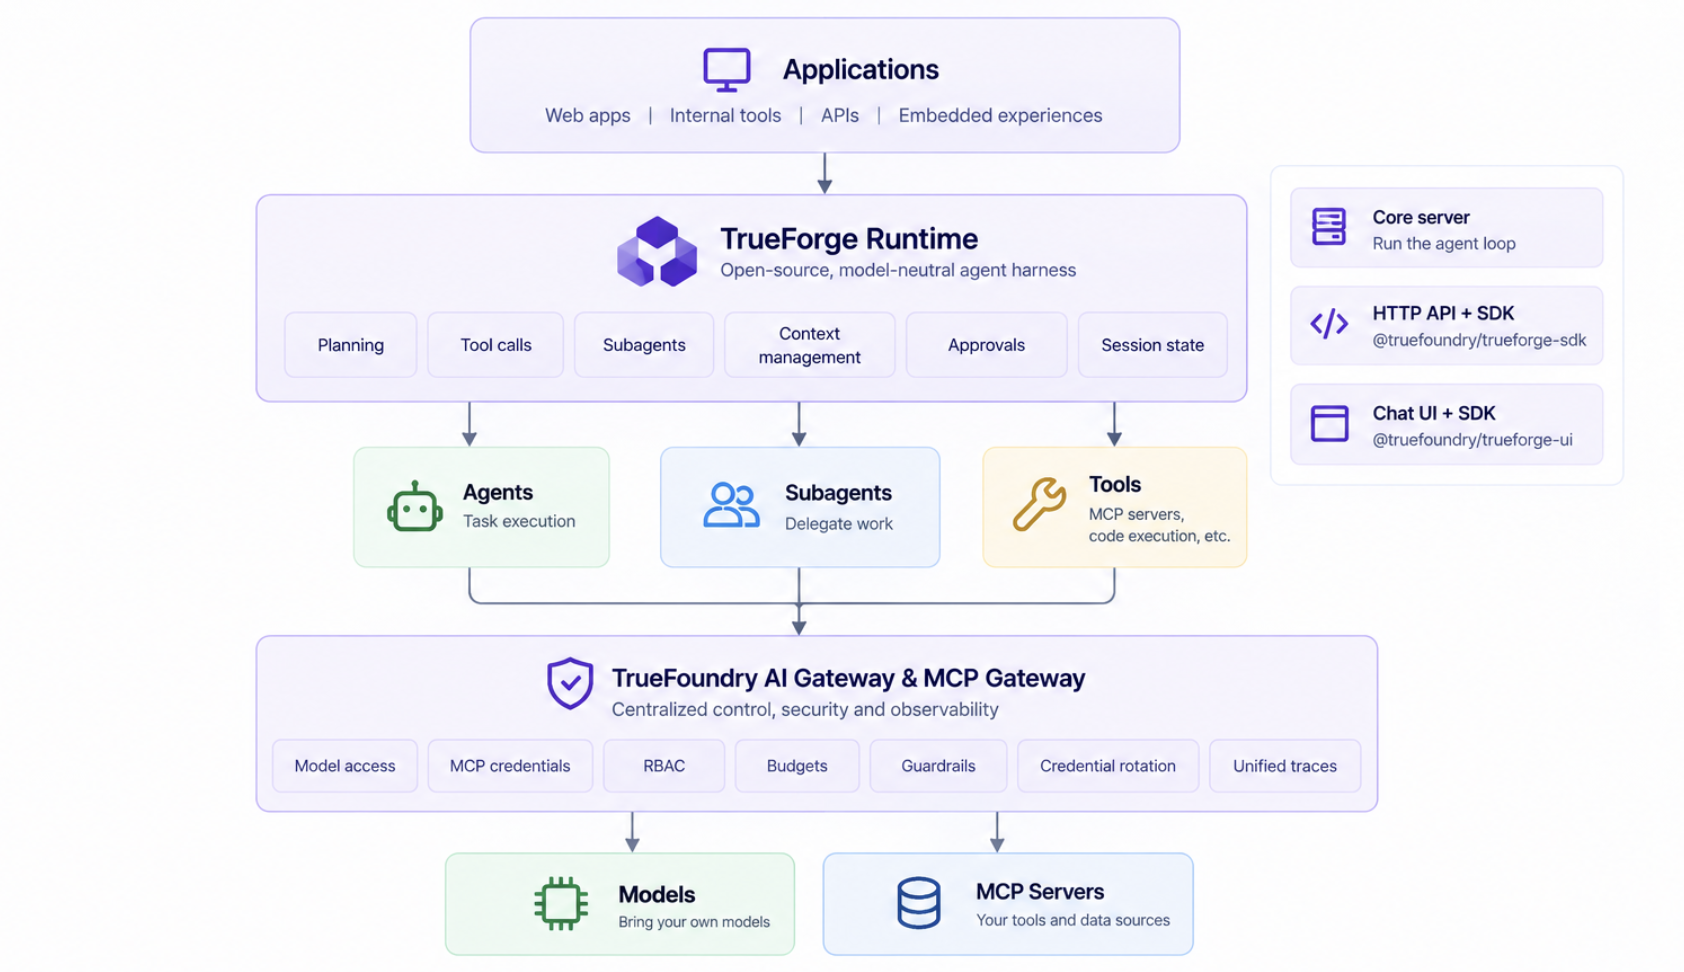
TrueForgeは、TrueFoundryのAI GatewayおよびMCP Gatewayと接続することも可能です。これにより、エージェントが単なる独立したプロジェクトではなくなった際に重要となる、以下のような制御機能を提供します。 一元化されたモデルアクセス、MCP認証情報、RBAC(ロールベースアクセス制御)、予算管理、ガードレール、認証情報のローテーション、統合トレースこれにより、これらの懸念事項を個々のエージェント定義から切り離し、共有プラットフォーム層へと移行できます。
Deep Agentsを本番環境への導入に向けて評価しているチームにとって、このベンチマークは、フレームワークがスタックの一部に過ぎないことを再認識させる有益な指標となります。 エージェントを取り巻くランタイムアーキテクチャは、トークン使用量、レイテンシ、コストに大きな影響を与える可能性があります。TrueForgeは、モデルやインフラの選択肢を制限することなく、そのランタイム層を提供するように設計されています。
Deep Agents、 create_agent、そしてLangGraphは、LangChainエージェントスタックにおいてそれぞれ異なる抽象化レベルに位置しています。 create_agent は軽量なエージェントループを提供し、LangGraphは実行フローを自ら定義する必要がある開発者のために、基盤となるグラフプリミティブを提供します。Deep AgentsはLangGraphの上に構築されており、計画、サブエージェント、コンテキスト管理、ファイルシステム機能などを備えた、より包括的なエージェントハーネスを提供します。
したがって、選択の基準は エージェントランタイムをどの程度制御したいかにかかっています。標準的なエージェントループと組み込み機能で十分であれば、Deep Agentsを利用することで構築すべきインフラの量を削減できます。軽量なループが必要な場合は、 create_agent がよりシンプルな出発点となります。実行フローそのものが重要な要件である場合には、LangGraphがそれを明示的に設計するためのプリミティブを提供します。
LangChainエコシステム以外の選択肢を検討しているチームにとって、 TrueForge は別のアプローチをとっています。モデルや基盤となるインフラを自社で管理しつつ、ランタイム層を提供するオープンソースのモデル中立的なエージェントハーネスです。
Q: LangGraph Deep Agentsとは何ですか?
A: Deep Agentsは、LangGraph上に構築されたLangChainのオープンソース(MITライセンス)エージェントハーネスです。 create_deep_agent() を呼び出すと、プランニング、仮想ファイルシステム、サブエージェントへの委任、要約、プロンプトキャッシュがミドルウェアとして組み込まれた、コンパイル済みのLangGraphグラフが返されます。これは、長時間稼働するエージェントに必要な基盤をチームがゼロから構築する手間を省くために存在します。
Q: Deep AgentsはLangGraphの代替品ですか?
A: いいえ。Deep AgentsはLangGraphの上に構築されており、LangGraphグラフを返します。これらは競合する選択肢ではなく、同じスタックの異なるレイヤーです。デフォルトのエージェント構成がタスクに適している場合はDeep Agentsを使用し、カスタムの制御フローが必要な場合はLangGraphを直接使用してください。どのようなLangGraphグラフでも、サブエージェントとしてDeep Agentに渡すことができます。
Q: Deep Agentにはデフォルトでどのようなミドルウェアが含まれていますか?
A: 以下の6つです。 TodoListMiddleware (プランニング用)、 FilesystemMiddleware (ファイル操作用)、 SubAgentMiddleware 独立したコンテキストでの委任には、 SummarizationMiddleware コンテキストの圧縮には、 AnthropicPromptCachingMiddleware Anthropicモデルのトークン節約には、そして PatchToolCallsMiddleware 中断されたツール呼び出しの修復には、 MemoryMiddleware および SkillsMiddleware は、メモリやスキルを使用する際にアタッチされます。
Q: TrueFoundryはMCPやAIエージェントに対応していますか?
A: はい。TrueFoundryには、MCPゲートウェイ、エージェントゲートウェイ、およびツールレベルのアクセス制御を備えたMCP & エージェントレジストリが含まれています。Deep Agents、LangGraph、CrewAI、AutoGen、またはカスタムフレームワークで構築されたエージェントはすべて、一元的にデプロイおよび管理可能です。
Q: TrueFoundryを自分のVPCやオンプレミスにデプロイできますか?
A: はい。TrueFoundryは、お客様のVPC、オンプレミス、エアギャップ環境、ハイブリッド環境、またはマルチクラウド環境で実行でき、データがドメイン外に出ることはありません。これが、規制の厳しい企業がSaaS専用ゲートウェイではなくTrueFoundryを選択する主な理由です。
Q: 既存のオブザーバビリティスタックと統合できますか?
A: はい。このゲートウェイはOpenTelemetryに準拠しており、Grafana、Datadog、Prometheusなど、すでにお使いのツールと連携可能です。プロンプトからツール、モデルの実行に至るまで、すべてのリクエストをトレースします。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.























