



November 16, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
20以上のプロバイダーをプロキシするAI Gatewayの計装は、通常のOTelよりも複雑です。本記事では、gen_ai.*セマンティックコンベンション、Gatewayのスパン階層(ルート、プロバイダー、ガードレール)、トレースツリーにおけるフォールバックの表現、Anthropic/OpenAI/Bedrockにわたるエラーの正規化、トレースごとのコスト属性付与、アプリケーションコードからのコンテキスト伝播、ストリーミングとTTFT、Datadog、Tempo、Jaeger向けのエクスポーター設定について詳しく解説します。
水曜日の午後2時14分、Northwind社にて。 Cargo Copilotが同時に12人のエンジニアに対してエラーを返し始めました。オンコールエンジニアがGatewayのダッシュボードを開きます。90秒以内に彼らは以下の状況を把握しました:過去5分間のAnthropic Sonnet 4リクエストの22%が529 overloaded_errorを返していたこと、Gatewayはそのうちの78%でAzure OpenAI gpt-5にフォールバックしたこと、フォールバックパスで1.8秒のレイテンシが加算されたこと、そしてこの時間枠での再試行とフォールバックにより会社に14ドルの追加コストが発生したこと。プロバイダーAのスパンは赤く、その隣のプロバイダーBのスパンは青く表示されています。ルートスパンは緑色です。オンコールエンジニアはダッシュボードを閉じます。他に対応すべき操作はありません。これこそが、あるべき優れたLLMの可観測性(Observability)の姿です。
本記事では、そのようなシステムを構築する方法を説明します。すでにサービス向けにOpenTelemetryが稼働していることを前提とし、それを前段にあるマルチプロバイダーAI Gatewayへどのように拡張するかについて解説します。
OpenTelemetryのGenAIセマンティックコンベンションは、gen_ai.*ネームスペースの下でLLM呼び出しを計装するための標準語彙を定義しています。OTel semconv v1.36.0の時点において、このコンベンションはまだ開発中(Development)ステータスです。これは運用上重要であり、属性名が最近変更されたため、現在利用されている多くのSDKでは古い変種が出力される可能性があります。
以下は、成功したAnthropic Sonnet 4の呼び出しにおける実際のプロバイダースパンの属性セットの例です:
JSON — 成功した呼び出しにおけるプロバイダースパンの属性セット
注目すべき3つの詳細があります。gen_ai.request.modelはクライアントが要求したモデルであり、gen_ai.response.modelはプロバイダーが実際に提供したモデルです(これらは異なる場合があります。例えばclaude-sonnet-4は、特定の日付付きバージョンに解決されるエイリアスです)。トークン数には仕様通りキャッシュされたトークンが含まれます:gen_ai.usage.input_tokensが合計であり、キャッシュされた部分が別途分解されて記録されます。そしてgen_ai.usage.cost_usdは、標準のsemconvの上に重ねてTrueFoundryが出力する独自属性です。仕様ではトークンまでがカバーされていますが、コストの計算はGatewayの責務となります(§5を参照)。
Gatewayへのインバウンドリクエストは、それぞれ1つのルートスパンを生成します。そのルートスパンには、Gatewayが実行する各作業単位(入力ガードレール、アウトバウンドのプロバイダー呼び出し、出力ガードレール)に対応する子スパンが紐付きます。フォールバックが発生した場合は、同じルート配下に2つ目のプロバイダースパンが作成されます(§3を参照)。
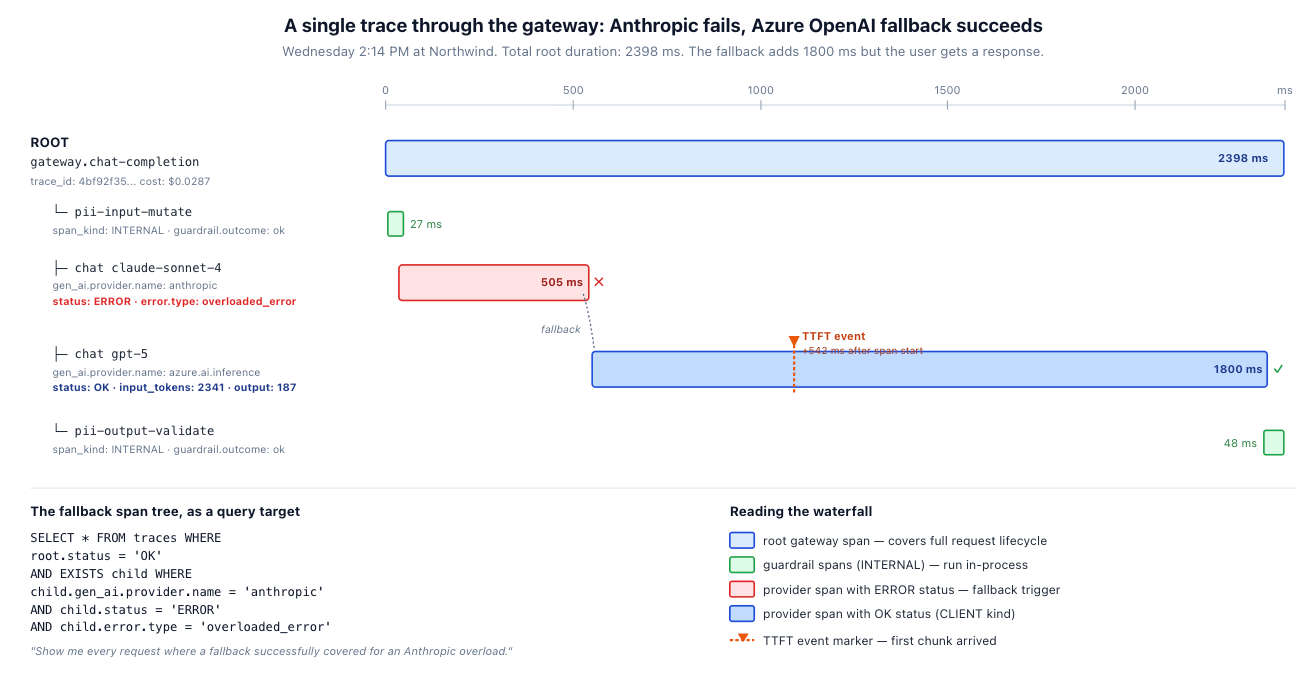
スパン種別(SpanKind)の定義は重要です。OpenTelemetry GenAI仕様に基づき、外部プロバイダーの呼び出しはCLIENTスパンとなります。ガードレールスパン(PIIの伏字化、スキーマ検証、Gatewayプロセス内で実行される処理全般)はINTERNALです。ルートスパン自体はSERVERとなります(Gatewayはクライアントから見てサーバーであるため)。
スパン名は定められた形式に従います:推論スパンには {operation} {model}(したがって chat claude-sonnet-4 と命名し、claude-sonnet-4-call や LLM call などとはしません)。ルートスパンやガードレールスパンにはフリーフォーマットの名前を使用します。このレイヤーでの一貫性が、チーム間で共通して利用可能なダッシュボードを実現する鍵となります。
フォールバックはOTelにおいて独立した概念ではなく、単に2つ目の兄弟スパンに過ぎません。Anthropicが529を返し、GatewayがAzure OpenAIにルーティングすると、トレースには同じSERVERルートの下に2つのCLIENTプロバイダースパンが表示されます。最初のアウトバウンド呼び出しはステータスがERRORとなり、エラー属性が付与されます。2つ目はステータスがOKとなります。ルートのステータスはクライアントが最終的に受け取った結果を反映するため、フォールバックが成功すればOKとなります。
この構成により、フォールバックの検索や分析が可能になります。TempoやJaegerにおいて、「Anthropicの過負荷をフォールバックでカバーし、成功したすべてのリクエストを表示する」という検索は、トレースツリーに対する以下のようなクエリになります:
可観測性バックエンド全体でのフォールバックパターンのクエリ
このクエリは運用上非常に有用です。アップストリームプロバイダーの調子が悪くなった場合、同じクエリを実行するだけで、フォールバックのヒット率、追加されたレイテンシ、合計のコスト影響をチーム別、モデル別、あるいは時間枠別にグループ化して取得でき、より深いLLMの可観測性を提供します。トレース構造そのものがこの役割を果たします。
各LLMプロバイダーは独自のエラーフォーマットを持っています。Gatewayの役割は、これらをダッシュボードやアラートが信頼して利用できる小規模で一貫した語彙に正規化しつつ、フォレンジック(原因究明)のために生のプロバイダー詳細を保持することです。
基本原則:正規化された少数のerror.type値(RATE_LIMITED、QUOTA_EXCEEDED、OVERLOADED、PROVIDER_UNAVAILABLE、TIMEOUT、INVALID_REQUEST、CONTENT_FILTERED)が、プロバイダーを横断したダッシュボードやアラートルールを駆動します。プロバイダー固有の属性(gen_ai.anthropic.error_type、gen_ai.openai.error_code)はフォレンジックのために保持されます。正規化フィールドは低カーディナリティ、生のフィールドは高カーディナリティに保たれます。どちらも重要です。
コストはプロバイダーから直接出力されるものではなく、計算によって導出される属性です。Gatewayは、プロバイダーから報告された使用トークン数と、Gateway自身が維持する価格表を使用して、各プロバイダースパンの終了時にコストを計算します。
Python — 各プロバイダースパンにgen_ai.usage.cost_usdとして格納されるコスト計算式
大規模運用において、注意すべき2つのポイントがあります。第一に、仕様ではgen_ai.usage.input_tokensにすでにcache_read.input_tokensとcache_creation.input_tokensの両方が含まれていると規定されています。全input_tokensを通常の入力レートで課金した上で、さらにキャッシュ行の費用を加算すると、キャッシュ読み取り部分を過剰請求し、キャッシュ書き込み部分を二重計上することになります。入力レートを適用する前に両方を差し引いてください。第二に、フォールバックコストは加算されます:Anthropicが失敗してGatewayがAzure OpenAIを呼び出した場合でも、一部処理されたAnthropicのリクエストに対して課金される可能性があります(出力が返されなかった場合でも入力トークンは送信されているため)。両方のプロバイダースパンにcost_usdを付与し、ルートスパンでそれらを合計します。この合計値が、実際のトレースコストとなります。
ここから各種の集計が可能になります:チーム別コスト(呼び出し元の識別情報でスパンをタグ付け)、モデル別コスト、機能別コスト(アプリケーションが設定するservice.*属性でタグ付け)、トレースタグ別コスト(例:「support-ticket」対「code-generation」)。OTel側の実装はシンプルであり、主な作業は価格表を常に最新の状態に維持することです。
Gatewayのトレースを有用なものにするには、その上流にあるアプリケーションのトレースと接続する必要があります。OpenTelemetryはW3C Trace Context仕様を使用します。これは、サービスの境界を越えてトレースIDと親スパンIDを伝達するtraceparent HTTPヘッダーです。Gatewayはインバウンドリクエストでこのヘッダーを読み取り、アプリケーションのスパンの子として自身のスパンを生成します。
OpenAI SDKを使用してGatewayを指すように設定されたPythonコードでは、伝播は次のようになります:
Python — アプリケーションがtraceparentを設定し、Gatewayがトレースを継続する
アプリケーションのタグ(northwind.team、northwind.feature)は、Gatewayがバゲージ(Baggage)および親スパンのカスタム属性を維持するため、ツリーの下位へと伝播します。これにより、Gateway側でNorthwind社のチーム構造に関する知識を持っていなくても、単一のコストダッシュボードで「先月サポートチームがエスカレーションの下書きにいくら費やしたか」という問いに答えることができます。
LLMプロバイダー自体はトレースを拡張しません — OpenAI、Anthropic、Bedrockは内部のトレースIDをクライアントに公開していません。取得できるのは、プロバイダー呼び出しに関するGateway側のビュー(Time-to-First-Byte、合計所要時間、トークン数)です。通常はこれで十分ですが、不十分な場合は、タイムスタンプを使用してプロバイダー独自の管理テレメトリと照合・関連付けを行います。
ストリーミングでは、レスポンスが単一のポイントインタイムのイベントではなく、数百年ミリ秒以上にわたって届くチャンクのシーケンスとなるため、スパンのタイミング測定が複雑になります。OTel GenAI仕様は、専用のメトリクスとスパンイベントパターンによってこれに対応しています。
GenAIメトリクス仕様で必須とされている関連メトリクスには、gen_ai.client.operation.duration(リクエスト全体から最後のチャンクまで)、gen_ai.client.operation.time_to_first_chunk(応答性の体感に最も影響するTTFT指標)、gen_ai.client.operation.time_per_output_chunk(チャンク間の間隔)があります。スパン自体には、TTFTをスパンイベントとして記録します:
Python — ストリームが開いている間にTTFTをスパンイベントとして記録する
運用上、2つのパターンが重要になります。スパンはストリーム全体が完了するまで開いたままにします — TTFTの時点で終了してしまうと、残りのタイミング情報が失われます。また、トークン数はストリームが閉じた時にのみ記録されます。これは、ほとんどのプロバイダーが最後のチャンク(Anthropic、OpenAI)または末尾のmessage_stopイベント内で最終的な使用量ブロックを送信するためです。早期にフラッシュするスパンエクスポーターを使用すると出力トークン数がゼロとなり、コスト属性付与が正しく行われません。
TrueFoundryのGatewayは、OTLP/HTTPを介してOTelスパンを出力します。NATSを介してリクエストパスから分離されているため、バックエンドの障害が推論の利用可能性に影響を与えることはありません。Gatewayトレーシングドキュメントで統合パスがカバーされています。エクスポーターの設定はOTLP標準に準拠しており、互換性のある任意のバックエンドで動作します。
Datadogは2025年12月以降、GenAIセマンティックコンベンションをネイティブでサポートしています。インテークパスは3つあります:直接OTLP、OTLPインジェストが有効化されたDatadog Agent、またはOpenTelemetry Collector(Datadog Distribution)です。
Datadog OTLPインテーク — 環境変数
Grafana Tempo — gRPC OTLPエクスポーター
Jaeger — OTLP gRPC
開発段階および本番運用最初の1ヶ月間は100%のサンプリングで問題ありません。ボリュームが増加するにつれてのガイドライン:高ボリュームの正常系パスにはヘッドベースサンプリング(確率を例えば0.1に設定)を使用し、コレクター層でのテールベースサンプリングによって、ヘッドレートに関わらずエラーや遅延の発生したトレースを100%保持します。この組み合わせにより、障害発生時に重要なデータを失うことなく、ストレージコストを管理可能なレベルに抑えることができます。
高カーディナリティの属性(ユーザー識別子、リクエストID、プロンプトの全文など)については、スパン属性ではなくイベントやログを使用することを推奨します。OTelの属性カーディナリティバジェットは無視できず、10K文字のプロンプトをスパン属性として保持すると、予期せぬ高額なコストにつながる可能性があります。
自前のコレクターを自由に持ち込むことができます。Gatewayは、互換性のある任意のバックエンドに対してOTLP標準のデータを出力します。TrueFoundryはDatadog、Honeycomb、Middleware、LangSmith、Grafana Tempoとの統合ドキュメントを提供しています。TrueFoundryがホストするコレクターは利便性のために提供されているものであり、ベンダーロックインを強いるものではありません。スパン上で完全なプロンプトやコンプレッション(出力結果)をキャプチャすべきですか?
デフォルトでは、キャプチャすべきではありません。現在の仕様では、gen_ai.promptやgen_ai.completion属性は非推奨となっており、コンテンツキャプチャが有効化されている場合は、イベント(スパン属性ではなく)として記録されるgen_ai.input.messagesおよびgen_ai.output.messagesの使用が推奨されています。その場合でも、キャプチャはオプトイン制にする必要があります。プロンプトにはPIIが含まれる可能性があり、巨大なプロンプトはスパンサイズを肥大化させます。すべてのトレースではなく、サンプリングされたトレースに対してキャプチャを行ってください。
GenAI仕様では、エージェントスパンを別途カバーしています:create_agent、invoke_agent、execute_tool。特にMCPツールの実行は、MCP計装によってトレース可能です。Gatewayはその境界上にあるすべての処理をキャプチャし、アプリケーションはその内部のすべての処理をキャプチャします。そしてトレースコンテキストがそれらを結合します。その結果、ツール呼び出しをINTERNALスパン、プロバイダー呼び出しをCLIENTスパンとして含む、エージェントループをエンドツーエンドでカバーする単一のウォーターフォールが得られます。
所有者を識別する属性(northwind.team、northwind.cost_center、gen_ai.agent.name、あるいはその全て)をルートスパンにタグ付けします。コストはバックエンド側でそのタグごとに集計されます。タグの設定はアプリケーション側の責任であり、Gatewayはそれを保持して伝播させます。機能別や顧客別のコスト割り当てにも同じ仕組みが適用できます。
バージョンの変更に留意すれば、概ね安全です。仕様がDevelopmentステータスであることは、非互換の変更が発生する可能性があることを意味します(最近のgen_ai.systemからgen_ai.provider.nameへの名称変更はまさにその例です)。緩和策として、OTEL_SEMCONV_STABILITY_OPT_IN環境変数が用意されており、計装ライブラリは古いコンシューマーを破壊することなく最新の実験的属性を選択的に利用できます。アップグレード時にはこれを意識して設定し、デフォルトの挙動がそのまま維持されることに依存しないようにしてください。
TrueFoundry AI Gatewayは、すべてのリクエストに対してOTel準拠のトレースを出力し、前述のスパン階層と最新仕様に沿ったgen_ai.*属性を設定します。トレースのエクスポートは非同期(NATS経由)で行われるため、可観測性バックエンドの状態が推論の利用可能性に影響を与えることはありません。また、Gatewayは§§5, 4, 3で説明したコスト計算、エラーの正規化、フォールバックトレースツリーの構築も処理します。自前のバックエンドをそのまま利用できる統合がファーストクラスでサポートされており、OTLP互換の任意の送信先が利用可能です。
現在LLMワークロードが可視化されていない場合、最も効果的な最初のステップは、Gatewayが稼働している場所からOTLP互換の任意のバックエンドにOTelデータをエクスポートすることです。これは週末の作業で完了できるレベルであり、スパンが流れ始めればダッシュボードの構築は容易です。
ここから始める: TrueFoundryトレーシングドキュメント。または、弊社のチームとの可観測性アーキテクチャレビューをご予約ください。
引用文献は本文全体にリンクされています。以下のリストは、印刷およびリンク切れ対策としてすべてのURLをまとめたものです。
注:Northwind Logisticsは、設計を具体的なデプロイ例で説明するために使用された架空の企業です。§2の水曜日午後2時14分のトレースはスパンツリーを説明するために作成されたものであり、実際の本番環境のトレースはタイミングや稼働しているプロバイダーによって異なります。OTel GenAIセマンティックコンベンションは、OTel semconv v1.36.0の時点で開発中(Development)ステータスであり、属性名は今後も変更される可能性があります。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



























