


November 17, 2026
|
5 min read



Blazingly fast way to build, track and deploy your models!
大規模言語モデル(LLM)は重要かつ新しい段階に入りました。孤立した実験やパイロットプロジェクトとして始まった取り組みは、今やエンタープライズシステム全体に組み込まれた本番ワークロードへと進化しています。カスタマーサポート、社内ナレッジ検索、ソフトウェア開発、アナリティクス、自律型エージェントなどは、LLMを単なるオプションの強化機能としてではなく、コアビルディングブロックとして依存する傾向を強めています。
この変化により、新たなクラスのインフラ課題が浮き彫りになりました。LLMワークロードは、従来のアプリケーションサービスとは大きく異なる動作をします。コストはリクエスト数ではなくトークン数に応じて拡大し、レイテンシはプロバイダーや地域によって大幅に変動します。さらに、タイムアウト、ハルシネーション(幻覚)、部分的な応答といったエラーモードは、しばしば不透明です。組織が異なるプロバイダーの複数のモデルを採用するにつれて、これらの問題は急速に複雑化します。
多くの企業において、初期のLLM統合は直接的なAPI呼び出しとアプリケーションレベルのロジックによって構築されていました。しかし、このアプローチは規模が拡大すると破綻します。チームはすぐに、予測不可能な推論コスト、使用状況の限定的な可視性、プロバイダーロックイン、そして増大するガバナンス上の懸念に直面することになります。各アプリケーションが独自のルーティング、リトライ、コスト管理、ロギングを個別実装している場合、LLMワークロードの最適化はますます困難になります。
AIの導入がチームを横断して水平方向に拡大し、環境を越えて垂直方向に拡大するにつれ、LLMワークロードの最適化はアプリケーションの問題からインフラの問題へと移行します。企業には、モデルがどのように使用されているかを一貫して、かつ大規模に観察、制御、最適化できる集中型の層が必要です。このニーズが、現代のAIインフラストラクチャの基盤コンポーネントとしてのAI Gatewayの台頭を促進しました。
LLMワークロードの最適化は、従来のコンピューティングやマイクロサービスの最適化とは根本的に異なります。課題は局所的なものではなく、システム全体に及ぶためです。
第一に、コスト動態が非線形である点です。プロンプト構造、リトライロジック、コンテキストサイズにおけるわずかな変更が、トークン消費量と支出を著しく増加させることがあります。集中型の可視化と構造化されたLLMコスト追跡ソリューションがなければ、コストが急増するまでこれらの変更が見過ごされがちです。アプリケーションレベルの管理には、予算を適用したり、チームやユースケース間で効率を比較したりするために必要なグローバルなコンテキストが欠けています。
第二に、固有のパフォーマンス変動性がある点です。これは LLM inferencingの過程でより顕著になります。レイテンシとスループットはモデル、プロバイダー、地域ごとに異なり、負荷や利用可能性に応じて変動します。単一のプロバイダーやモデルをアプリケーションにハードコーディングすると、脆弱性が生じます。障害やレート制限が発生した場合、チームは事前対策的な最適化ではなく、事後対応的な修正を余儀なくされます。
第三に、マルチモデルの採用が運用の複雑さを引き起こす点です。企業は、重要なワークフローにはプレミアムモデルを使い、大ボリュームまたは非クリティカルなタスクには低コストモデルを使うといった組み合わせを増やす傾向にあります。この組み合わせを効率的に管理するには、コスト、品質、レイテンシのバランスをとるルーティング決定が必要ですが、そうした決定はアプリケーションコード内に存在すべきではありません。
最後に、ガバナンスおよびコンプライアンスの圧力が引き続き高まっている点です。組織はアクセス制御を実施し、使用状況を監視し、監査ログを保持し、地域をまたがるデータレジデンシーを担保しなければなりません。これらの要件はすべてのAIワークロードを横断するものであり、アプリケーション単位で効果的に対処することはできません。
これらの要因を総合すると、LLMワークロードの最適化を個別に解決することは不可能であると明白になります。すべてのAIトラフィックに対する可視性を持ち、ポリシーを一貫して適用できる集中型コントロール層が必要です。
AI Gatewayは、LLMワークロードのコントロールプレーンとして機能することで、この課題に対処します。アプリケーションとモデルプロバイダーの間に配置されるAI Gatewayは、LLMリクエストがどのようにルーティングされ、観察され、ガバナンスされ、最適化されるかを一元化します。
従来のAPI Gatewayとは異なり、AI GatewayはLLMワークロードの特性に合わせて専用設計されています。モデル固有の動作、トークンベースの価格設定、レイテンシのトレードオフ、そしてきめ細かな可観測性の必要性を理解しています。これにより、最適化戦略をインフラ層で一度実装すれば、すべてのアプリケーションに一律に適用することが可能になります。
ハイレベルで見ると、AI Gatewayは以下の方法でLLMワークロードの最適化を可能にします:
このアーキテクチャアプローチにより、アプリケーションロジックとモデル管理が分離されます。開発者はAIを活用した機能の構築に集中し、プラットフォームチームはパフォーマンス、コスト、リスクの制御権を保持します。
企業がLLMの使用規模を拡大するにつれて、この分離は不可欠になります。これがないと、最適化の取り組みは断片化され、受動的になり、維持が困難になります。これがあれば、組織は関与するモデル、チーム、アプリケーションの数に関わらず、LLMワークロードを効率的に実行するための貫性があり、測定可能で、再現可能な方法を手に入れることができます。
組織がLLMの使用において成熟するにつれて、最適化戦略はよりシステム化され、インフラ駆動型になりつつあります。2026年までに、大規模にLLMワークロードを実行する企業の間で、いくつかのパターンが標準的なプラクティスとして定着しつつあります。
モデルの選択を固定的な選択肢として扱うのではなく、企業はコスト意識型のオーケストレーションを採用しています。このモデルでは、AI Gatewayが各リクエストのコンテキストに基づいて、コスト、品質、レイテンシのバランスを動的に調整します。
例えば:
このアプローチにより、組織はユーザーエクスペリエンスを損なうことなく支出を最適化できます。時間を経るにつれて、実際の使用データがより優れたオーケストレーションの決定につながるフィードバックループも形成されます。
規制要件や地政学的現実は、AIシステムのデプロイ方法を再形成しています。企業は、データレジデンシー、主権、およびコンプライアンス要件を満たすために、LLMワークロードが地域ごとに分離された地理的に分離されたAIスタックを運用する傾向を強めています。
実際には、これは以下を意味します:
AI Gatewayは、地域間で統一された運用モデルを提供しながら、これらの制約を強制する中心的な役割を果たします。
LLMの使用規模が拡大するにつれて、組織はモデルに大規模なコンテキストを繰り返し送信する手法から離れつつあります。代わりに、制御されたインターフェースを介してモデルが必要に応じて情報を取得するツール駆動型AIシステムを採用しています。
この変化により:
AI Gatewayは、モデルの呼び出しだけでなく、ツールやAPIの実行も仲介する役割を増しており、AIシステムが制御された監査可能な方法で企業データと相互作用することを担保します。
自律型および半自律型エージェントの台頭は、新たな最適化の課題をもたらします。エージェントはしばしば複数のモデル呼び出しを行い、ツールを起動し、長期間実行されるワークフローを実行します。
先進的な組織は、以下の方法により最適化戦略をエージェント層へと拡張しています:
AI Gatewayは、モデル推論とエージェント実行の両方の調停層として機能し、この移行をサポートするように進化しています。
Gateway評価のための主要メトリクス
| 基準 | 何を評価すべきか? | 優先度 | TrueFoundry |
|---|---|---|---|
| レイテンシ | 最初のトークン生成時間(time-to-first-token)に対するオーバーヘッドはp95で10ms未満か? | 必須 | ✅ サポート済み |
| データレジデンシー | ログを指定地域(EU/米国)内に保持できるか? | ユースケースによる | ✅ サポート済み |
| レイテンシベースルーティング | リアルタイムのレイテンシや障害に基づいて自動的に再ルーティングされるか? | 必須 | ✅ サポート済み |
| キーのローテーションと失効 | ダウンタイムなしでキーのローテーションや失効が可能か? | 必須 | ✅ サポート済み |
| キーのローテーションと失効 | ダウンタイムなしでキーのローテーションや失効が可能か? | 必須 | ✅ サポート済み |
| キーのローテーションと失効 | ダウンタイムなしでキーのローテーションや失効が可能か? | 必須 | ✅ サポート済み |
| キーのローテーションと失効 | ダウンタイムなしでキーのローテーションや失効が可能か? | 必須 | ✅ サポート済み |
| キーのローテーションと失効 | ダウンタイムなしでキーのローテーションや失効が可能か? | 必須 | ✅ サポート済み |

AI Gatewayの選択は単なるツールの決定ではなく、インフラストラクチャに対するコミットメントです。多くの企業にとって、この層はすべてのLLM駆動型アプリケーションのクリティカルパスに位置することになるため、設計上の選択を後から変更することは困難です。したがって、評価においては表面的な機能よりも、アーキテクチャ上の適合性、運用の成熟度、および長期的な柔軟性に焦点を当てる必要があります。
以下は、技術責任者が特にLLMワークロードの最適化という観点からAI Gatewayを評価するために使用できる実践的なフレームワークです。
先進的なAI Gatewayは、モデルやプロバイダーが変更された場合でもアプリケーションの変更を強いることなく、真のマルチモデル利用を可能にする必要があります。
確認すべき主な質問:
モデルの選択がアプリケーションロジックに漏れ出している場合、最適化のスピードは鈍化し、脆弱になります。
コストの可視性がなければLLMの最適化は不可能です。Gatewayは、意思決定が行われるレベルでの洞察と強制力を提供する必要があります。
求めるべき要素:
集計された使用状況のみを報告するGatewayでは、真の最適化には不十分です。
Gatewayはホットパスに配置されるため、パフォーマンス特性が重要になります。
評価項目:
わずかなパフォーマンス低下であっても、大規模環境では蓄積して大きな影響を及ぼします。
最適化はフィードバックループに依存します。GatewayはLLMのアクティビティにおける信頼できる唯一の情報源(System of Record)として機能する必要があります。
Gatewayが以下を提供するかどうかを評価します:
可観測性が後付けのように感じられる場合、最適化は体系的ではなく受動的なものになります。
最適化は、企業のリス管理コントロールと共存しなければなりません。
主な考慮事項:
最適化とコンプライアンスの間でトレードオフを求めるGatewayは、規制のある環境ではスケールしません。
最後に、Gatewayが既存のインフラストラクチャや運用モデルにどのように適合するかを評価します。
検討すべき点:
Gatewayがプラットフォームスタックとより密接に統合されているほど、長期的運用は容易になります。
TrueFoundryのアーキテクチャは、「LLMワークロードの最適化はインフラストラクチャの問題であり、アプリケーションの責任ではない」という明確な前提に基づいて構築されています。そのため、そのAI Gatewayは、エンタープライズAIスタックの中心に位置するファーストクラスのコントロールプレーンとして設計されています。
TrueFoundryの構成では、アプリケーションやエージェントがモデルプロバイダーと直接やり取りすることは決してありません。代わりに、すべてのLLMトラフィックはAI Gatewayを経由し、これが推論、ルーティング、可観測性、ガバナンスのための統一された安定したインターフェースとして機能します。
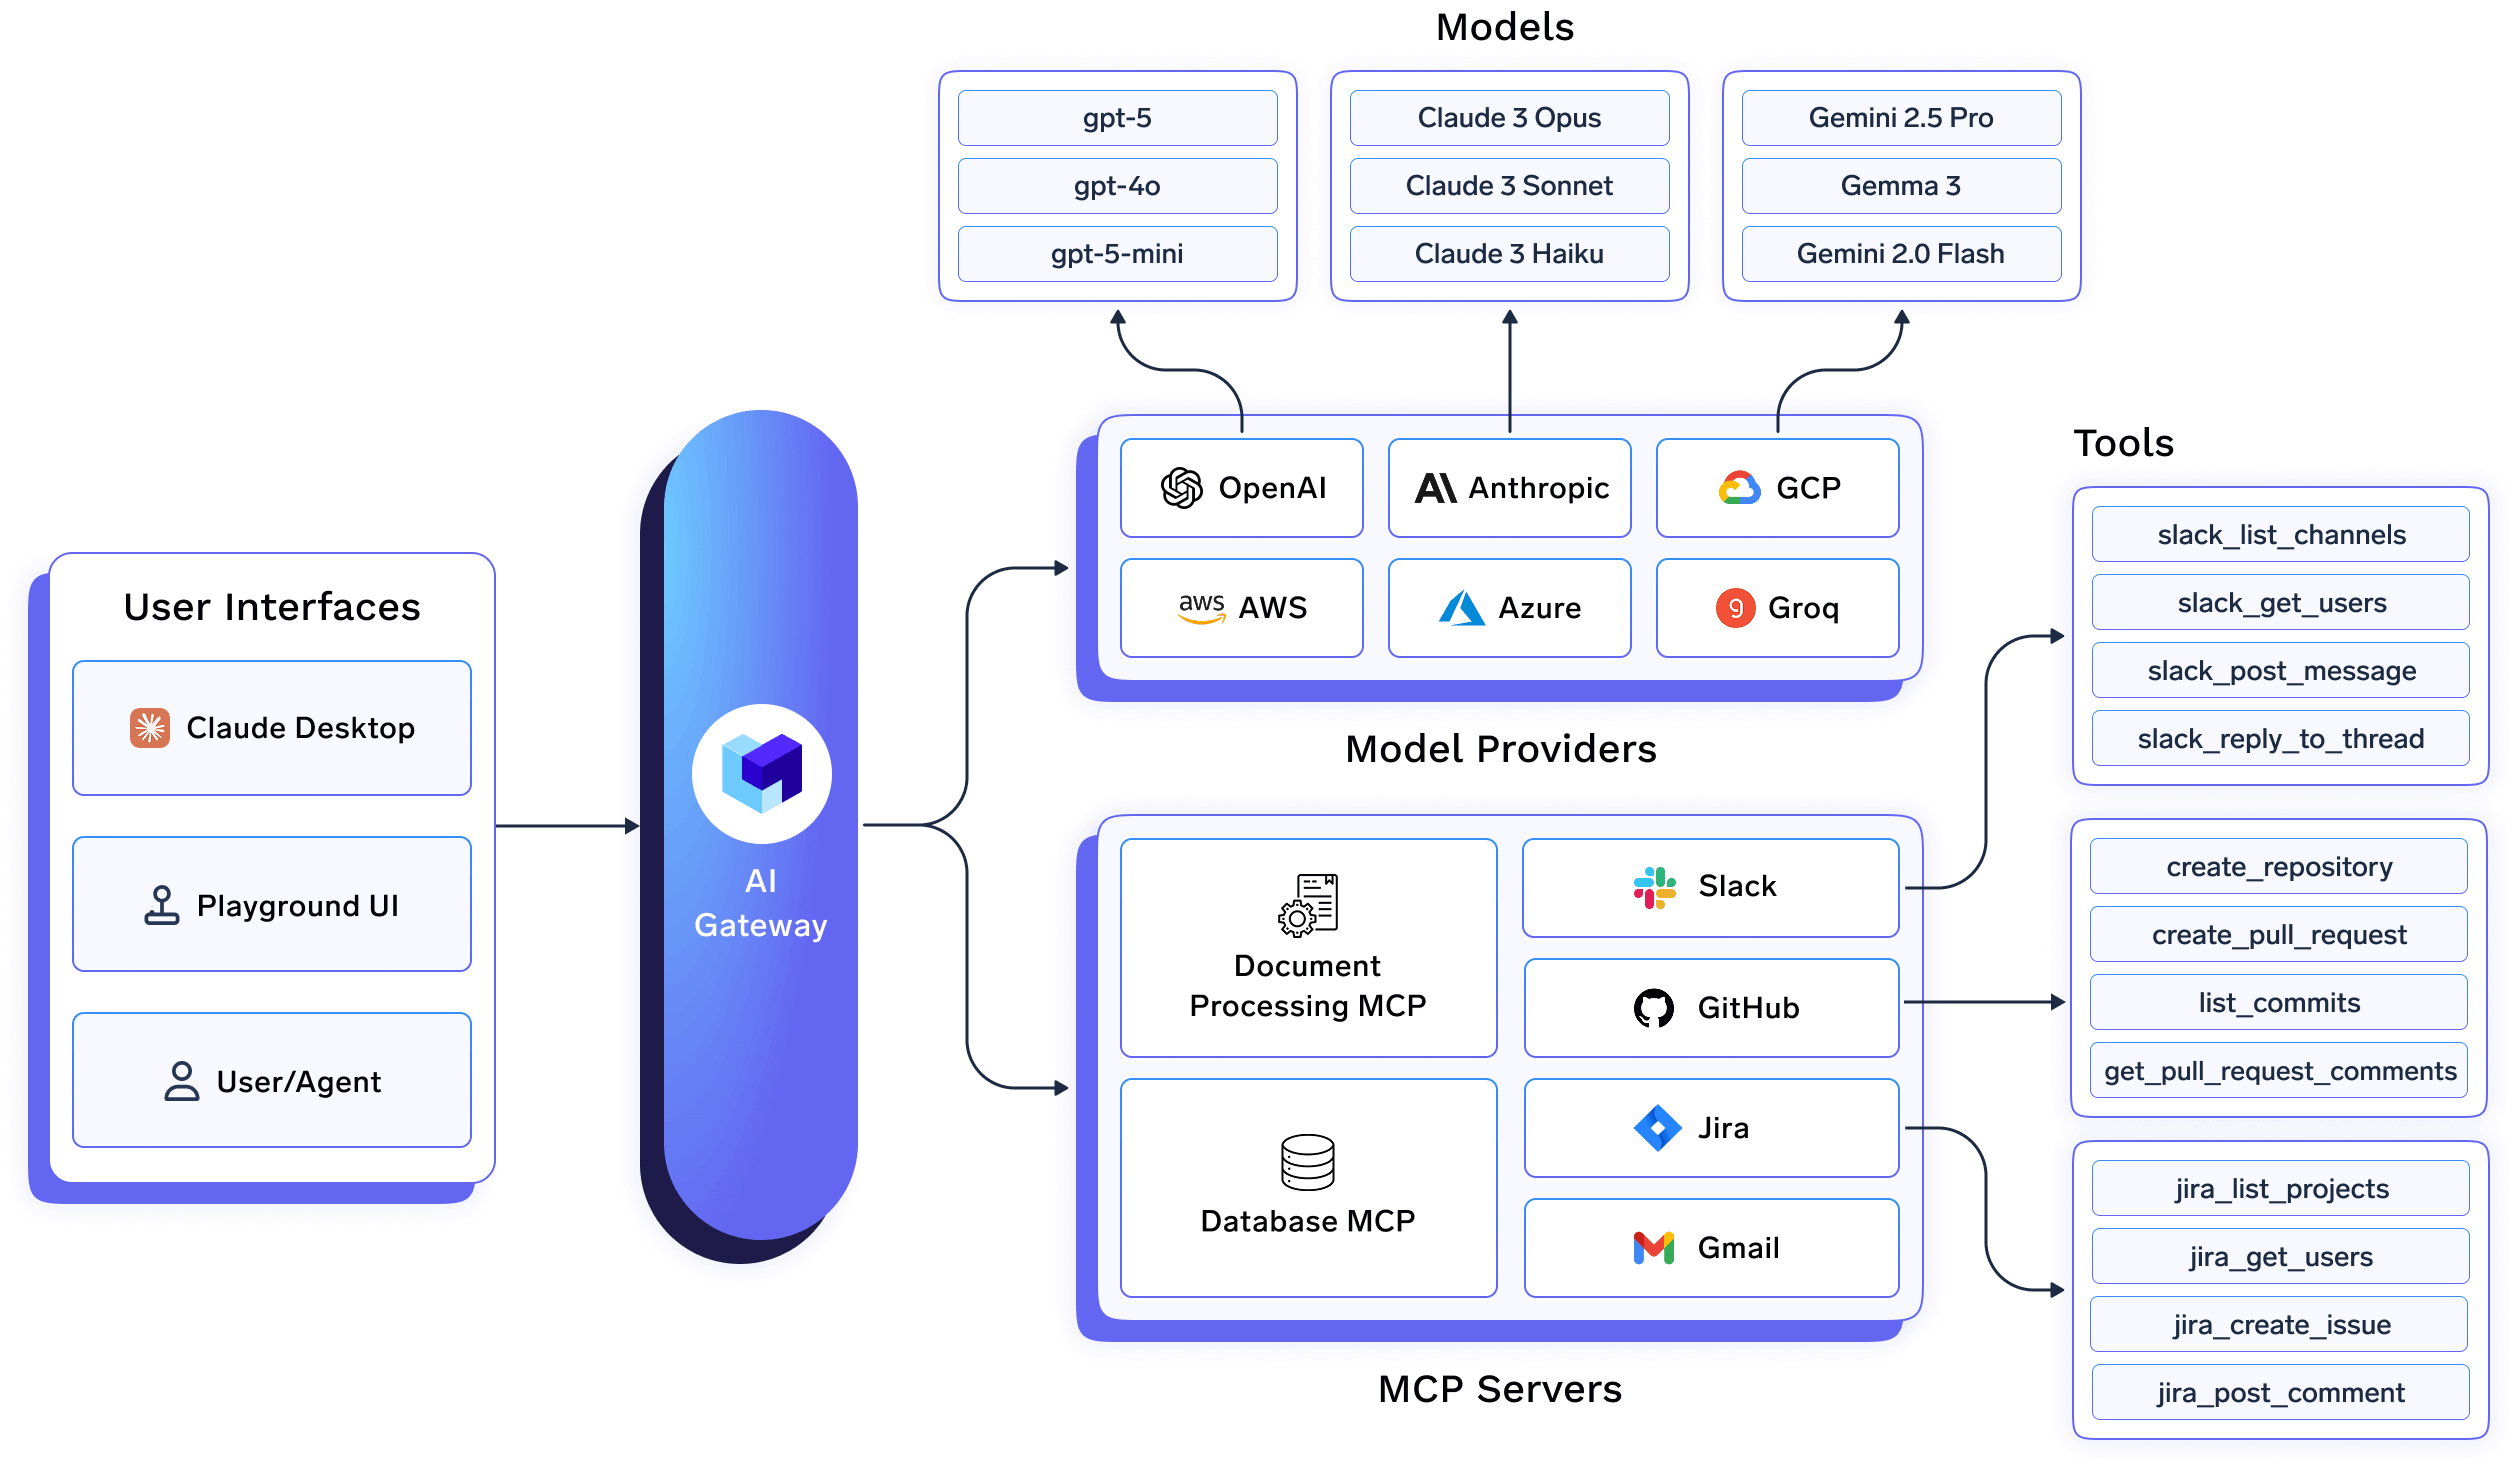
アーキテクチャレベルでは、これは以下を意味します:
この設計により、アプリケーションコードからモデル固有の懸念事項が排除され、最適化戦略を独立して進歩させることが可能になります。
TrueFoundryのAI Gatewayは、プロバイダー固有のAPIを単一の仕様の背後に抽象化することで、真のマルチモデル運用を実現します。どのモデルを使用するか、いつフォールバックするか、コストとレイテンシのバランスをどのように取るかといったルーティングの決定は、Gateway側で集中処理されます。
実際には、これによりプラットフォームチームは以下を行うことができます:
ルーティングがGatewayで処理されるため、価格、パフォーマンス、またはプロバイダーの利用可能性の変化に対して、アプリケーションレベルの変更を必要とせずに即座に対処できます。
TrueFoundryアーキテクチャの核となる原則は、AI GatewayがすべてのLLMアクティビティに対するSystem of Recordとして機能することです。Gatewayを通過するすべてのリクエストは、モデル選択、トークン使用量、レイテンシ、リクエストコンテキストなどの詳細なメタデータとともにキャプチャされます。
ベンダー管理のシステムにこのデータを集約する多くのプラットフォームとは異なり、TrueFoundryの設計では以下が保証されます:
このアプローチにより「ブラックボックス」問題を回避し、組織が自社のデータを使用して長期的最適化のフィードバックループを構築できるようにします。
TrueFoundryのAI Gatewayは、コスト管理とガバナンスコントロールをリクエストパスに直接埋め込んでいます。ダウンストリームの請求レポートや外部ツールに頼るのではなく、リアルタイムで最適化と強制が行われます。
主なアーキテクチャ上の機能:
これらのコントロールが一元化されているため、すべてのLLM駆動型アプリケーションはこれらを自動的に継承します。これにより、ガバナンスロジックを重複させることなく、チーム全体でAI利用を拡張することが可能になります。
TrueFoundryのAI Gatewayは、企業のデータが既に存在する場所にデプロイできるように設計されています。プライベートVPC、オンプレミス環境、または指定されたクラウドリージョンで実行できるため、組織は厳しいデータレジデンシーや規制要件を満たすことができます。
アーキテクチャ的には、以下をサポートします:
この設計は、データの移動を厳格に制御しなければならない、複数法域で事業を展開する企業に適合します。
TrueFoundryのGateway中心のアーキテクチャは、エージェントベースのAIシステムへの移行とも整合しています。エージェントが複数ステップのワークフローを調整し、ツールやAPIを呼び出すことが増えるにつれて、Gatewayは自然なポリシー適用ポイントになります。
このモデルにおいて、AI Gatewayは以下を行うことができます:
これにより、Gatewayは単なる推論層としてだけでなく、インテリジェントシステムのためのより広範な実行管理プレーンとして位置づけられます。
TrueFoundryのアプローチを定義する特徴は、最適化、ガバナンス、可観測性がインフラストラクチャ層で一度だけ実装され、あらゆる場所で再利用される点です。これにより、運用の複雑さが軽減され、一貫性が向上し、組織は制御を失うことなくLLMワークロードを拡張できるようになります。
より広範なポイントとして、TrueFoundryのAI Gatewayはアドオンとしてではなく、コアAIインフラストラクチャとして位置づけられていることです。Gatewayを長期的なアーキテクチャ層として扱うことで、TrueFoundryは企業がAPI Gateway、データプラットフォーム、コンピュートオーケストレーションなどの重要システムについてすでに持っている考え方と整合させています。
LLMの導入規模が拡大するにつれて、最適化はもはやプロンプト調整やモデル選択の問題ではなく、インフラストラクチャ上の決定事項となります。コストの変動性、パフォーマンスのバラつき、ガバナンス要件に対処するには、モデル、チーム、アプリケーションを横断して機能する集中型コントロール層が必要です。
AI Gatewayはそのような層として台頭しました。ルーティング、可観測性、コスト管理、ポリシー適用を統合することで、LLMの最適化を、継続的な運用の負担から体系的な機能へと変化させます。
TrueFoundryのようなプラットフォームは、AI GatewayをエンタープライズAIインフラの核となるピースとして扱うことで、この転換を反映しています。技術リーダーへのメッセージは明確です。持続可能なLLMの拡張は、適切なモデルを選択することよりも、それらを稼働させるための適切な基盤を構築することに依存しているのです。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



























