



November 5, 2026
|
5 min read

Blazingly fast way to build, track and deploy your models!
エージェントの構築には、LLMをいくつかのツールに接続する以上の作業が必要です。エージェントがどのように状態を管理し、コンテキストを処理し、ツールを呼び出し、タスクを実行し、次に何をすべきかを決定するかを決める必要があります。
LangGraphとDeep Agentsは、異なる抽象化レベルでこれらの問題を解決します。 LangGraphはエージェントの実行フローを定義・制御するためのプリミティブを開発者に与え、Deep AgentsはLangGraphの上に事前に構築されたハイレベルなエージェントハーネスを提供します。
両者とも根本的な同じ問題を解決します。モデルは推論を行いますが、行動することはできません。ファイルをオープンしたり、APIを呼び出したり、作成したばかりのコードを実行したり、4ターン前に決定した内容を記憶したりすることはできません。誰かがモデルの周囲に介在してそのギャップを埋め、タスクが完了するまで埋め続けなければなりません。LangGraphはその仕組みを構築するためのパーツを提供します。Deep Agentsはそれを組み立てた状態で提供します。
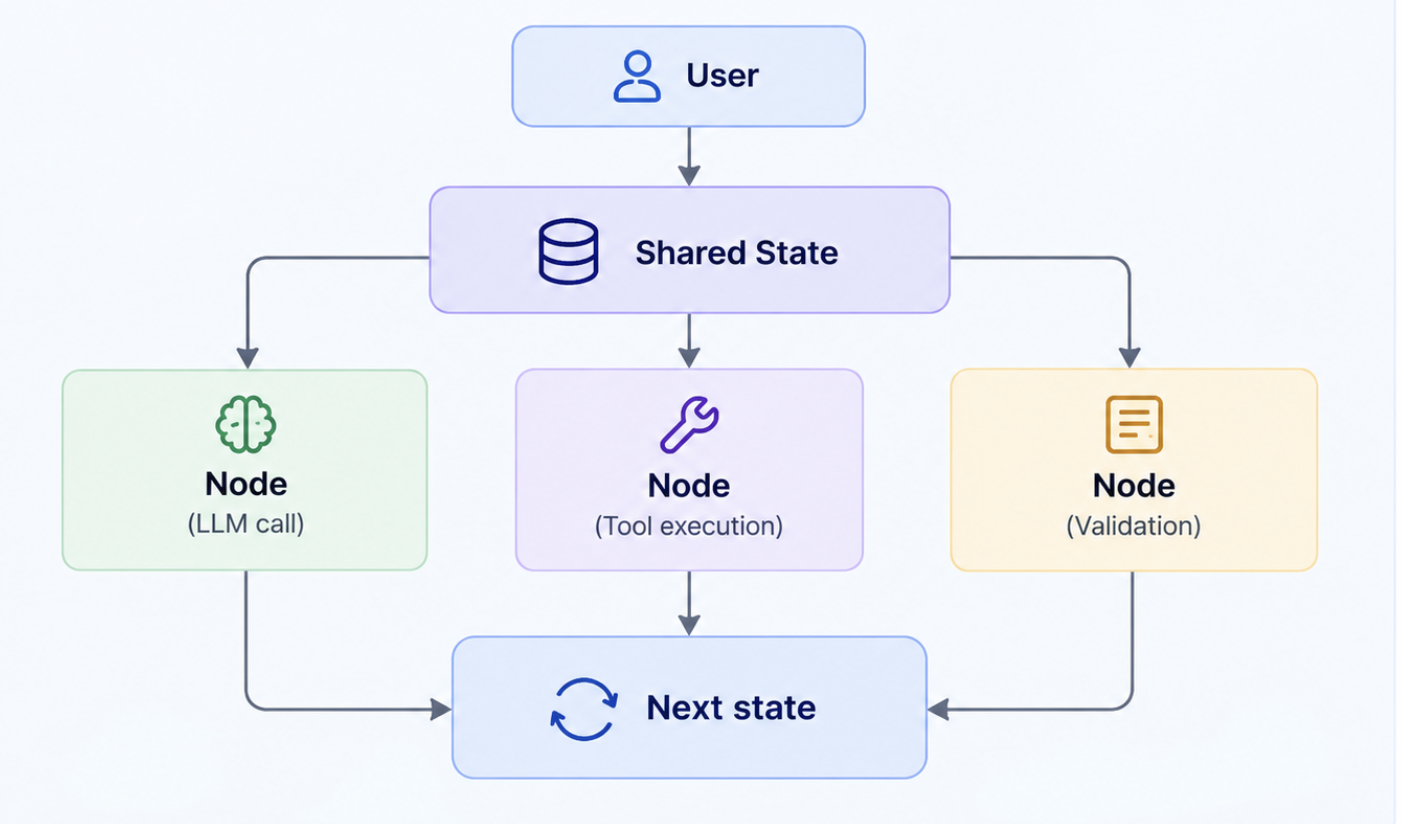
LangGraphはエージェントランタイムです。ワークフローを有向グラフとしてモデル化します。ノードは個別の操作であり、エッジは次に何を実行するかを定義し、型定義された状態スキーマがすべてのステップを貫きます。実行はノードがENDを返すまで構造を巡回します。
LangGraphの構築は通常、以下のようになります。
チェックポインタと割り込みは真の差別化要因であり、LangGraphがLangChainエコシステムのほぼすべての下層に位置する理由でもあります。LangChainのcreate_agentもDeep Agentsもその上で動作しています。
LangChain独自の例として、賃貸申込パイプラインがあります。ドキュメントから収入と信用履歴を抽出し、家主の基準に基づいてスコアリングし、自動承認、拒否、または保留ケースの昇格を行います。LLMにアクセスするのは最初のステップのみです。残りは固定コードであり、固定コードのままであるべきです。
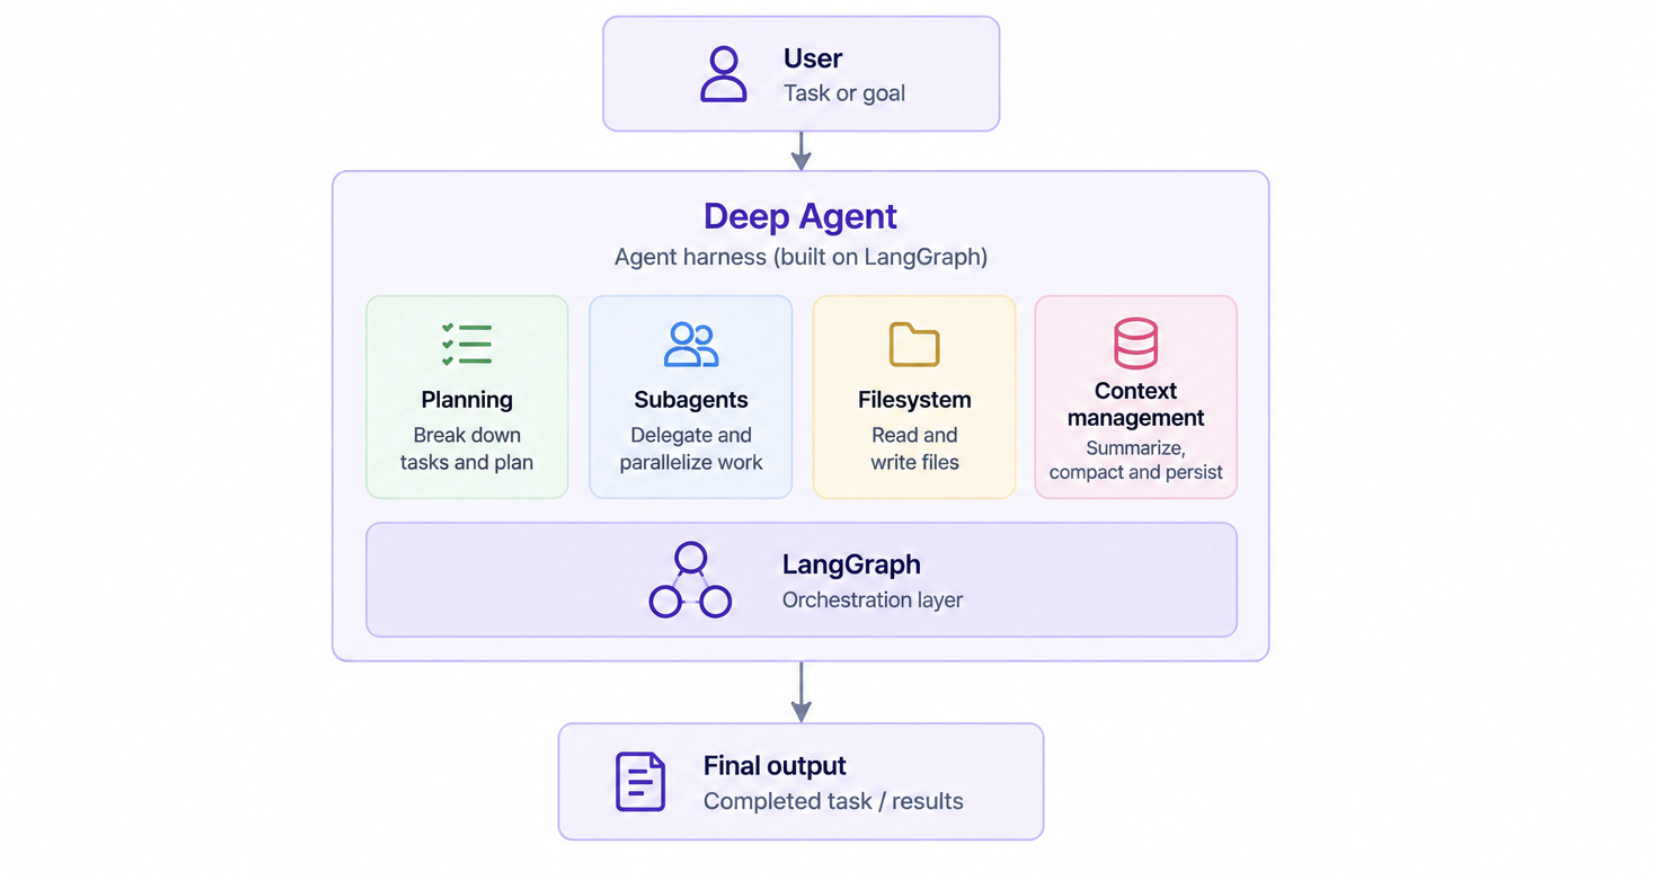
Deep Agentsはエージェントハーネスです。LangChainのcreate_agentと同じコアループを持っていますが、コンテキストエンジニアリングのプラクティスがデフォルトでバンドルされた、意図の明確な構成になっています。LangChainはこれをコアエージェントとミドルウェアのセットとして説明しており、内部的には依然としてLangGraphのグラフです。
出荷時に含まれるもの:
モデル、ツールセット、システムプロンプトを備えたエージェントをcreate_deep_agentから取得できます。グラフを自分で作成する必要はありません。
LangGraphとの決定的な違いは、「誰がループを書くか」にあります。LangGraphではノードと条件を宣言し、制御フローは開発者が所有します。Deep Agentsではツールと指示を提供して実行を開始すると、他人が書いたループの中でモデルが次に何が起こるかを決定します。これについての詳細な解説は、agent harness vs agent frameworkで別途まとめています。
両者とも同じ成果を目指しており、同じスタックの異なる高さに位置しています。そのため「どちらが優れているか」という単純な比較は意味をなしません。片方はエージェントの振る舞いを設計することを求めます。もう片方は振る舞いの大部分を自動決定し、寛大に決定された部分の代金をトークン費用として請求します。
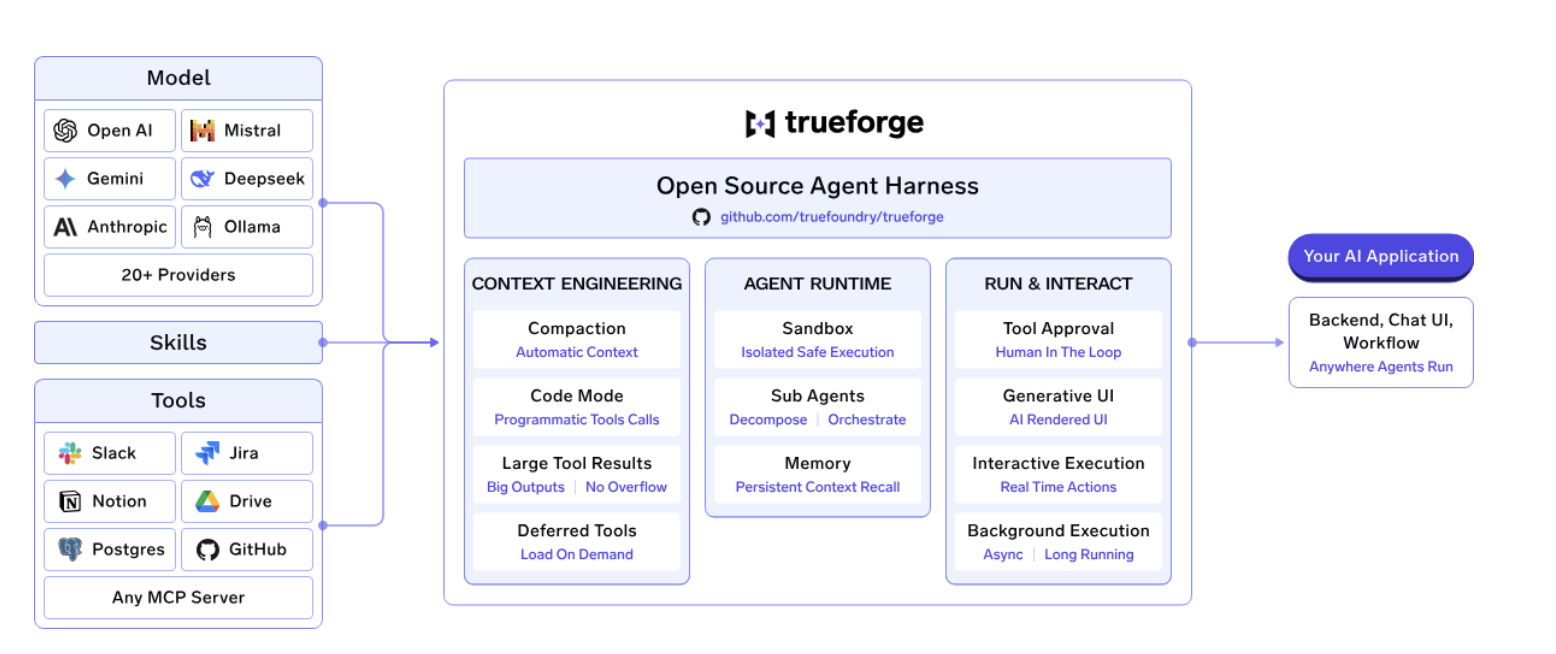
LangChain Deep Agentsは、計画立案、サブエージェント、ファイルシステムツール、スキル、メモリ、長期間の実行など、個別エージェント内部の複雑な作業の多くを解決します。しかし、複数のチームにわたってエージェントを運用し始めると、問題は「エージェントの構築」から「フリート(エージェント群)の運用」へと移行します。
TrueForgeは、そのランタイムレイヤーに向けたTrueFoundryのオープンソースかつベンダーニュートラルなエージェントハーネスです。自前のモデル、MCPサーバー、サンドボックスプロバイダーを持ち込みながら、計画立案、ツール呼び出し、コンテキスト管理、承認、セッション状態を含むモデル周辺のエージェントループを実行します。
npx @truefoundry/trueforgeを使用してローカルで実行することも、Docker ComposeやHelmを使用してチーム向けに同じハーネスをデプロイすることもできます。TrueForgeのドキュメントをご覧ください。
TrueForgeは、モデルに到達するコンテキストとツールデータの量を制御するための複数のメカニズムも提供します。
遅延ツールロード(Deferred tool loading)により、MCPツールスキーマは最初にウィンドウを埋めるのではなく、オンデマンドでロードされます。Code Modeでは、エージェントが1つのサンドボックススクリプト内で複数のツール呼び出しをチェーンできるため、すべての中間結果ではなく出力されたサマリーのみがコンテキストに入ります。サイズオーバーのツールレスポンスは代行オフロードされてサンドボックスファイルに保存され、パスとプレビューに置き換えられます。コンパクション(圧縮)はモデルのコンテキスト長の80%で発動し、古い履歴を構造化されたサマリーと入れ替えます。これはリプレイに対する直接的な回答です。サブエージェントは独自のクリーンなコンテキストで実行され、結果のみを返します。
サンドボックスモデルも強力な要素です。ほとんどのハーネスはセッション全体をコンテナ内にラップします。TrueForgeはサンドボックスをツールとして扱い、エージェントが実際にコードを実行する必要がある場合にのみ起動するため、1台のサーバーで多数のエージェントを同時に実行でき、コードに触れないターンは低コストのまま維持されます。
TrueForgeは単なるライブラリインターフェースではなく、ランタイムとして構造化されています。
コアサーバーはエージェントループを実行し、ストリーミング、承認ゲート、サブエージェント委任、コンパクション、永続セッションを提供します。HTTP APIとTypeScript SDK(@truefoundry/trueforge-sdk)は、プログラムによって同じ機能を公開します。分離されたチャットUIとUI SDK(@truefoundry/trueforge-ui)は、直接使用したり、テーマを変更したり、別のプロダクトに埋め込んだりできます。
これにより、チームにはPythonエージェント定義自体を超えたデプロイ面が提供されます。同じランタイムでアプリケーション、API、または組み込みエージェント体験を駆動できます。
モデル、MCPサーバー、サンドボックスプロバイダーはすべて自由に選択できます。より安価なモデルが出荷された場合は、エージェントを書き換えることなくそれを指定するだけで済みます。これが、GLM-5.2で実行された同じベンチマークが、1回あたり2.90ドルで同じ14タスク中約11タスクを解決した理由です。
エージェントフレームワークとエージェントランタイムの違いは、同じワークロードで比較するとより明確になります。TrueFoundryは、14のクロスシステム企業タスクで構成されるDevRevのEnterprise-BenchにおいてTrueForgeとDeep Agentsのベンチマークを実施しました。各タスクでは、エージェントが計画を立て、CRM、プロジェクトトラッカー、ドキュメントストアにわたるMCPツールを呼び出し、結果を結合し、評価ルーブリックを満たす回答を返す必要があります。両方のハーネスは同じMCPサーバーを使用して同じタスクを実行し、回答はブラインドLLMジャッジによってスコアリングされました。
Opus 4.8を固定値とした場合、2つのハーネスは同様のタスク精度を示しましたが、実行コストは大きく異なりました。
ベンチマーク結果は、タスク精度の差が比較的小さいのに対し、実行コストには非常に大きな差があることを示しています。TrueForgeが消費したトークン数はDeep Agentsの4分の1未満であり、同じモデルにおいて1実行あたり約2.5倍安価でした。
この違いは、主に2つのランタイムがオーケストレーションとコンテキストをどのように処理するかから生じています。Deep Agentsは計画立案、仮想ファイルシステム、サブエージェントなどの機能を提供しますが、これらは各ターンにより多くのオーケストレーションとコンテキストを追加する可能性もあります。TrueForgeはより無駄のないアプローチを採り、絞り込まれたツール呼び出しとコンテキスト圧縮を使用して、大規模な履歴やツールレスポンスがモデルへ繰り返し送り返されるのを防ぎます。これが重要なのは、エージェントのコストはモデルの価格だけでは決まらないからです。同じモデルを実行する2つのエージェントシステムであっても、計画立案、ツール利用、コンテキスト管理、サブエージェントの実装方法によって、トークン消費量が大幅に変わる可能性があります。
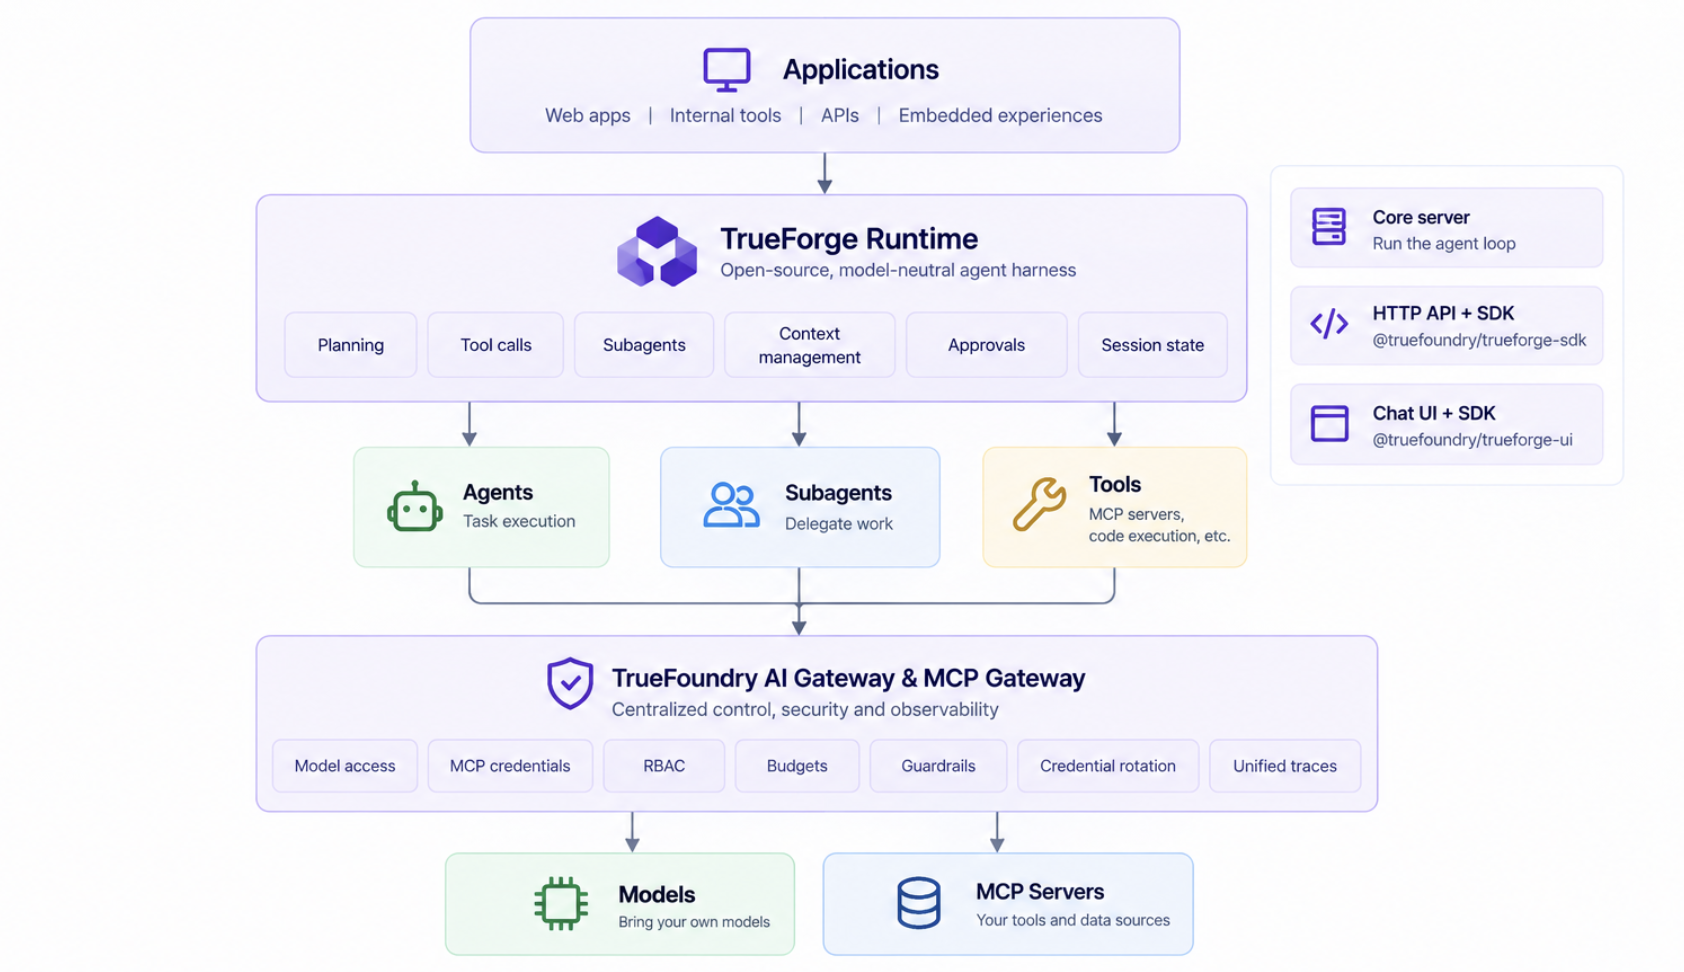
TrueForgeは、TrueFoundryのAI GatewayおよびMCP Gatewayと接続することもでき、エージェントが隔離されたプロジェクトではなくなった際に重要となるコントロールを提供します。これには、一元化されたモデルアクセス、MCP資格情報、RBAC、バジェット、ガードレール、資格情報のローテーション、統合トレースが含まれます。これにより、これらの懸念事項が個々のエージェント定義から移動し、共有プラットフォームレイヤーへと集約されます。
本番環境向けにDeep Agentsを評価しているチームにとって、このベンチマークは、フレームワークがスタックの一部に過ぎないことを示す有益な指標となります。エージェントを取り巻くランタイムアーキテクチャは、トークン使用量、レイテンシ、コストに重大な影響を与える可能性があります。 TrueForgeは、モデルやインフラストラクチャの選択肢を開放したまま、そのランタイムレイヤーを提供するように設計されています。
グラフの形状そのものが価値を生む場合は、LangGraphを選択してください。特定のノードでのコンプライアンスゲート、以前のステージへの条件付きループバック、1つのステップだけがモデルにアクセスするパイプラインなどがこれに該当します。すでにLangGraphを使用しており、フローが本質的にグラフの形状をしているのであれば、そのまま使い続けましょう。
すでにどこかに存在するループを手動で作成していることに気づいた場合は、ハーネスを選択してください。その場合の問いは「どのハーネスか」だけであり、それはコンテキスト管理の問題となります。したがって、導入を決定する前に、コンパクション、オフロード、遅延ロードに関するドキュメントを確認してください。それらについて一切記載がなければ、ハーネスのラベルを貼った単なるフレームワークを見ている可能性があります。
LangChainのエコシステムと抽象化を好み、トークンプロファイルがワークロードに対して許容できる場合は、特にdeepagentsを選択してください。実行時間が短い場合は、コスト差をほとんど感じないでしょう。
実行時間が長いケースが通常である場合、ライブラリではなくHTTP APIや組み込みUIが必要な場合、MITライセンスを希望しエコシステムへの拘束を避けたい場合、または財務部門からの質問に1実行あたりのコストで耐える必要がある場合は、TrueForgeを選択してください。フレームワークレイヤーが実際に必要なレイヤーである場合は、当社のLangGraph alternativesの分析でフレームワークレイヤーの選択肢をカバーしています。
そして、多くの場合、答えは「両方」です。フレームワークはエージェント間のオーケストレーションや、ハーネス駆動のエージェントが配置される決定論的なワークフローを処理します。ハーネスはエージェント自体を実行します。避けるべき2つの失敗パターンは、「引き継ぐことができたはずのループを再構築するためにフレームワークを使用すること」と、「プロンプト内に記述して上手くいくことを祈るだけで、厳格なコンプライアンスシーケンスにハーネスを無理やり従わせようとすること」です。
Q: Deep AgentsとLangGraphの違いは何ですか?
A: LangGraphはエージェントランタイムであり、Deep Agentsはその上に構築されたエージェントハーネスです。LangGraphでは、ノード、エッジ、状態を宣言し、制御フローを自身で記述します。Deep Agentsでは、ファイルシステム、サブエージェント、スキル、メモリとともにループがすでに作成されているため、代わりにツールと指示を提供します。Deep Agentsは内部的にLangGraphのグラフへとコンパイルされます。
Q: Deep AgentsはLangGraphの代替となりますか?
A: いいえ、LangGraph上で動作しているため代替にはなり得ません。ハーネスは、モデルが駆動する固定ループを提供します。ワークフローに任意のトポロジ、指定ノードでの検証ゲート、または以前のステージへの条件付きループが必要な場合、それを表現できるハーネスは存在せず、LangGraphが適切なツールのままとなります。多くの本番システムでは、異なるレイヤーで両方を実行しています。
Q: deepagentsと他のハーネスでは、どちらが安価に実行できますか?
A: 当社のEnterprise-Bench実行において、Opus 4.8上のdeepagentsは16.5Mトークンと1実行あたり21ドルを消費したのに対し、同じモデルと同じ14タスクにおけるTrueForgeは3.8Mトークンと8.50ドルであり、精度差は1タスク以内でした。この差は、蓄積されたコンテキストを圧縮せずにリプレイすることや、毎ターン保持される構造(Scaffolding)から生じています。
Q: これらを自身のVPCやオンプレミスで実行できますか?
A: はい。どちらもセルフホスト可能なオープンソースです。TrueForgeはローカルの単一npxコマンドから実行できるほか、Postgres、Redis、レプリカ、OIDCログインを含むチームデプロイメント向けのDocker ComposeおよびHelm経由でも実行できます。TrueFoundryの管理プラットフォームもセルフホスト、オンプレミス、エアギャップ、またはハイブリッドで動作するため、データがドメイン外に出ることはありません。
Q: 多数のエージェントにわたるモデルやMCPサーバーはどのようにガバナンスすればよいですか?
A: 自己管理型のキーではスケールしなくなった段階で、ゲートウェイレイヤーを通じて管理します。TrueFoundryのAI Gatewayは、1,000以上のLLMを1つのOpenAI互換APIの背後に配置し、単一vCPU上で約3〜4msの追加レイテンシと350以上のRPSを実現します。RBAC、バジェット、ガードレール、資格情報のローテーションに加え、Grafana、Datadog、PrometheusへのOpenTelemetryトレースも備えています。LangGraph、deepagents、その他何で構築されたエージェントであっても、同様にガバナンスされます。
Deep AgentsかLangGraphかの選択は、問題がどのレイヤーに存在するかに行き着きます。これは「エージェントの進む道筋に自ら作成したい形状があるか、それとも実行が進むにつれて発見されるか?」という1つの質問で解決できます。
明確な形状がある場合はLangGraphです。ない場合はハーネスが必要であり、その際の差別化要因は「そのハーネスが40ターン目にコンテキストウィンドウに対して何をするか」となります。構築を始める前に、これを計測しておく価値があります。
npx @truefoundry/trueforgeを使用すると約1分で稼働するエージェントを取得できます。またはTrueForgeが長い実行でコンテキストをどのように処理するかをご覧ください。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.


























