



November 16, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
多くのエンジニアは、Claude Codeを「より賢いオートコンプリート」として使い始めます。関数を書くよう指示すれば、関数が返ってくる。しかし、実際に使い始めると、それとは異なる何かが起きていることに気づくはずです。
Claude Codeは単なるオートコンプリートを超えた存在です。ファイルを読み込み、コードベース全体を推論し、編集を提案し、シェルコマンドを実行し、結果に基づいて調整を行います。これは予測ではなく「実行」です。モデルが実行可能になった今、プロンプトは物語の一部に過ぎません。
このことにいち早く気づいたチームは、「Claude Codeで何ができるか?」と問うのをやめ、より本質的な問いを立て始めます。ワークフローは実際にどう動いているのか?どのようなコンテキストを使っているのか?どのツールを呼び出しているのか?テストが途中で失敗したらどうなるのか?再試行をどう判断しているのか?
プロンプトだけでは、これらの問いに答えられません。答えはワークフローの中にあります。
本ガイドでは、Claude Codeワークフローの構造、失敗する原因、チーム全体への展開方法、そしてデモを超えた本番環境での活用について解説します。これらを理解するために、まずはClaude Codeワークフローとは何かを明確にしましょう。
Claude Codeの Claude Code ワークフローはプロンプトではありません。プロンプトはワークフローの始まりに過ぎないのです。
ワークフローとはプロセス全体を指します。モデルが指示を受け取り、コードベースからコンテキストを抽出し、使用するツールを選択し、変更を加え、結果を読み取り、次に何をすべきかを判断する。この「解釈・実行・観察・調整」のループこそがワークフローです。
これらは相互に関連する5つの要素で構成されています。
具体的な例で説明します。Claude Codeに「ログインハンドラーに入力バリデーションを追加して」と指示したとします。実際に起こることは以下の通りです。
この一連の流れがワークフローです。プロンプトは1行ですが、実行は5つのステップにわたって行われます。各段階がどのように展開されるのか、ワークフローをステップごとに詳しく見ていきましょう。
構造化された実行ループは、単一の指示から展開されます。各ステップには独自のロジックと失敗のパターンがあります。
ワークフローは、関連ファイルの読み込みから始まります。Claude Codeはソースファイルを読み取り、モジュール構造を調査し、コードベースの全体像を把握します。このステップは見た目以上に重要です。読み込むファイルが間違っていたり、不足していたりすると、モデルは歪んだ視点で作業を開始することになります。その歪みは、その後のすべての工程に影響を及ぼします。
コンテキストウィンドウの制限があるため、これは常に全体の一部でしかありません。重要なのは、その切り出しが適切かどうかです。
指示がアクションプランに変換されます。「不安定なテストを修正して」という指示だけではまだ実行できません。モデルは範囲を推論し、どのファイルが関連しているか、これがデバッグ作業なのか、テストの書き直しなのか、あるいはフィクチャの問題なのかを特定する必要があります。この段階での曖昧さは、後々の作業のズレとして現れやすくなります。
タスクが定義されると、ツールの呼び出しが始まります。ファイルの読み取り、シンボルの検索、パッチの生成、シェルコマンドの実行などです。この時点で、ワークフローは受動的な状態から脱します。モデルは単に推論するだけでなく、リポジトリに対して直接アクションを起こします。ここからは、権限の境界やツールの設定が重要になってきます。
提案された変更が適用されると、ワークフローは実際の状況を読み取ります。テストの実行、ビルドのコンパイルや失敗、リンターによる指摘などがこれにあたります。実行によってフィードバックが生成され、このフィードバックこそが、単発の生成をエージェント的なループへと変える鍵となります。モデルは差分を出力した時点で完了するわけではありません。フィードバックループが閉じて初めて、タスクが完了します。
モデルは得られた結果に基づいて調整を行います。パッチの修正、別のファイルのオープン、アプローチの変更、あるいはタスク完了の判断などを行います。明確に定義されたタスクであれば、このループはすぐに終了します。しかし、タスクの範囲が曖昧な場合、特に実行中にコンテキストが悪化すると、ループが制御不能に陥る可能性があります。
大まかな実行パスは以下の通りです。
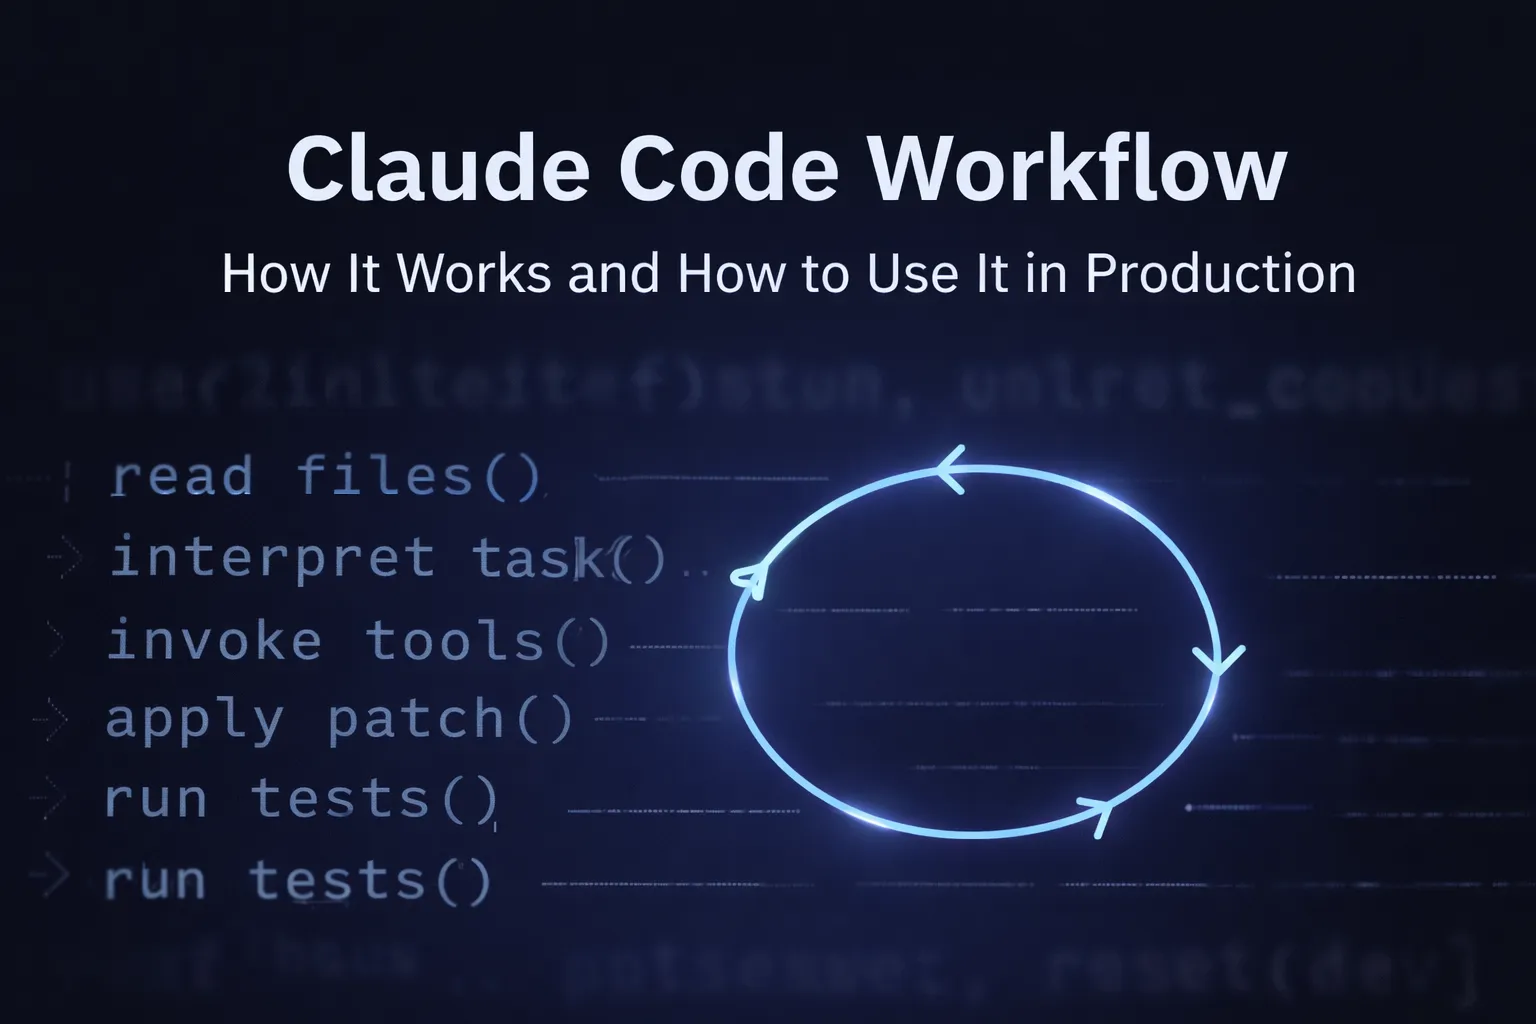
ファイルの読み込み → タスクの解釈 → ツールの呼び出し → パッチの適用 → テストの実行 → 出力の確認 → 反復または終了
このパスを理解することは、Claude Codeのワークフローを支えるアーキテクチャを明確にする助けとなります。
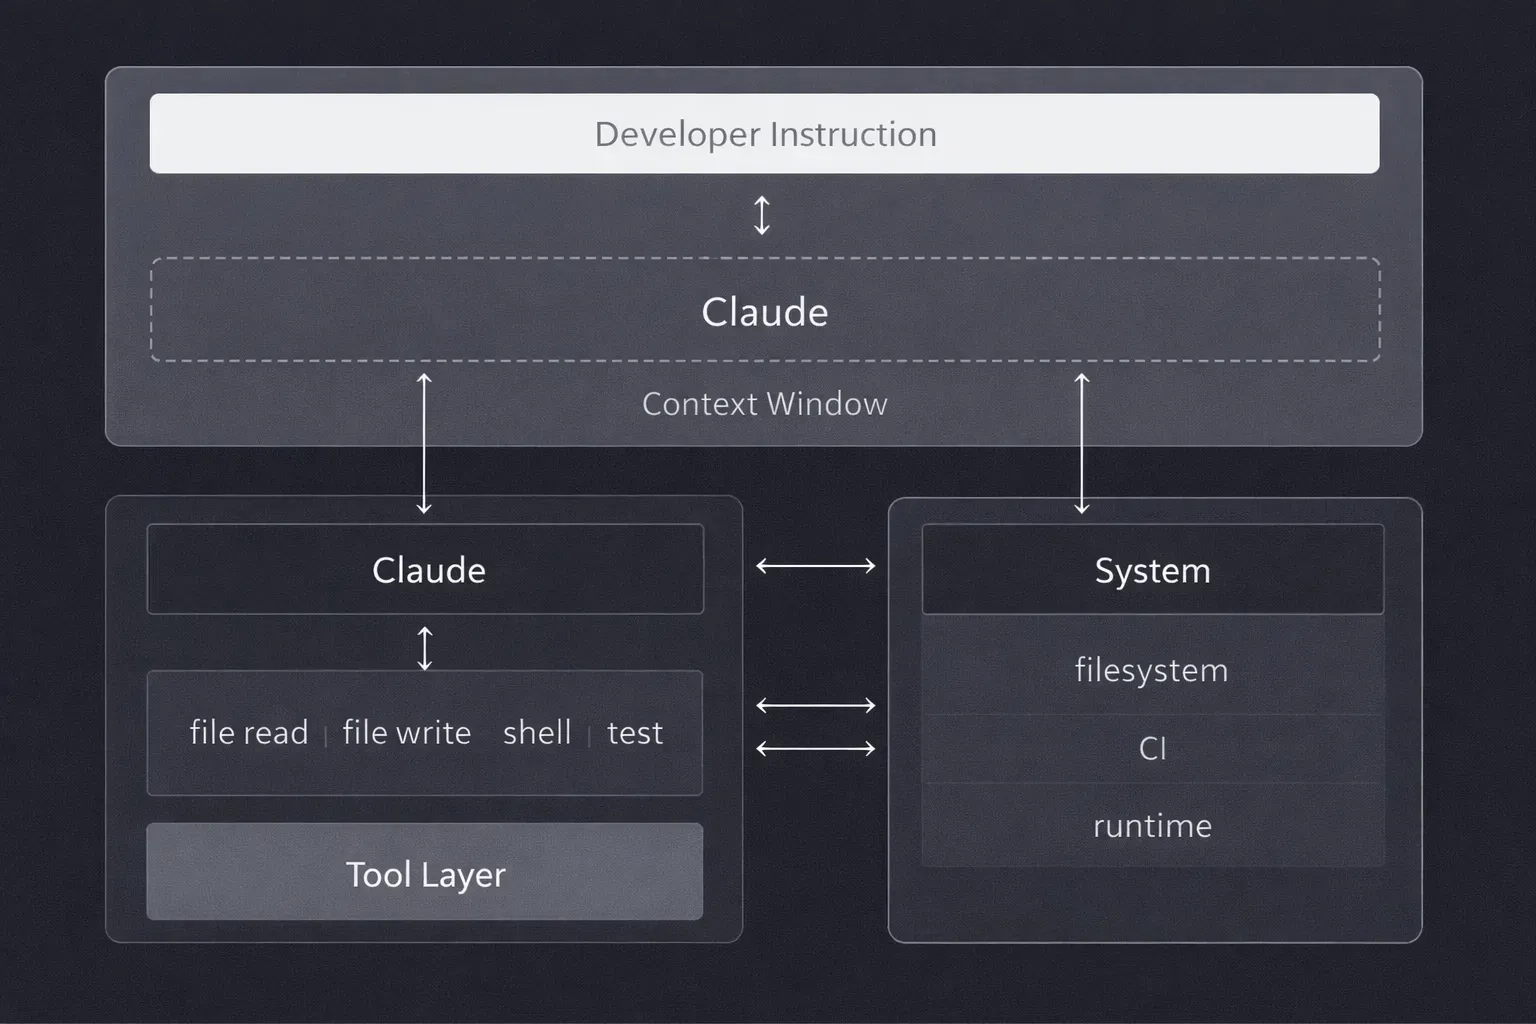
最上位レベルにおいて、アーキテクチャはシンプルなパスに従います。
開発者の指示 → Claude → ツールレイヤー → ファイルシステムおよびランタイム
しかし、各境界にはワークフローの実際の挙動を左右する制約が存在します。
ステップバイステップのワークフローは、Claude Codeが何を行うかを説明するものです。このセクションでは、それらのステップの裏側で何が起きているのかを解説します。
Claudeは限られたコンテキストウィンドウ内で動作します。コードベース全体を一度に読み込むことはできません。実行開始時に読み込まれたものと、実行中に蓄積されたものから選択された一部のみを参照します。これはバグではなく、根本的な特性です。つまり、モデルが行うすべての決定は、外部からはそう見えなくても、不完全な情報に基づいているということです。
Claudeは直接ファイルを変更したりコマンドを実行したりするわけではありません。それらを行うツールを呼び出します。ファイルの読み込み、編集、シェル実行は、構造化されたインターフェースとして公開されています。原則として、この抽象化によりワークフローの構成可能性と監査可能性が保たれ、モデルが何を要求したかを検証できます。しかし、ツールレイヤーでの障害(タイムアウト、部分的な書き込み、予期しない出力形式など)が、実際にはインフラの問題であっても、モデルの挙動の問題として現れることもあります。
状態は2つの場所に存在します。推論が進むにつれてコンテキストウィンドウ内に蓄積される「暗黙的な状態」と、実行中にファイル、ログ、コマンド出力に書き込まれる「明示的な状態」です。コンテキストウィンドウがいっぱいになったりトリミングされたりすると、暗黙的な状態は劣化します。モデルは実行を継続しますが、開始時とは異なる内部状況に基づいて判断を下すことになります。
Claude Codeは、いくつかの一般的な開発ワークフローに適合します。複数のツールを切り替えることなく、既存コードの理解、変更の実施、問題の調査、作業の検証を行うことができます。
リポジトリを使い始めたばかりのときは、Claude Codeに機能や関数の仕組みを追跡させてみましょう。コードに触れる前に、関連ファイルの検索、依存関係の追跡、既存の実装の解説を行わせることができます。
新しい機能を追加する際は、まず要件をClaude Codeに伝え、コードベースを調査して実装計画を作成するよう依頼してください。方針が適切であれば、そのまま変更を実行し、関連するチェックを実行させることができます。
エラーや失敗したテスト、予期しない動作をClaude Codeと共有してください。問題を追跡して原因を特定し、修正案を作成した上で、問題が実際に解決されたかどうかをテストさせることができます。
複数のファイルにまたがるリファクタリングや、繰り返し作業が必要な場合はClaude Codeを活用しましょう。既存のパターンに従って変更を適用できるため、その後で差分を確認し、テストを実行するだけで済みます。
Claude Codeは新しい動作に対するテストを作成したり、変更後に既存のテストを実行したりできます。テストが失敗した場合は、その原因を調査し、実装を改善させることが可能です。
プルリクエストを作成する前に、Claude Codeにバグやテストの不足、不整合がないかレビューを依頼しましょう。また、作業内容を要約させ、人間が特に注意して確認すべき箇所をハイライトさせることもできます。
Claude Codeには、これらのワークフローを管理・自動化し、繰り返しやすくするための機能がいくつか備わっています。それぞれが開発プロセスの異なる部分を解決します。
CLAUDE.mdは、Claude Codeに対してプロジェクト固有の指示やコンテキストを与えるためのファイルです。コーディング規約、共通コマンド、アーキテクチャに関するメモ、エージェントが従うべきルールなどを定義できます。
スキルを使用すると、特定のタスクに対する繰り返し可能な手順をパッケージ化できます。毎回同じプロセスをプロンプトで説明する代わりに、特定のタスクが発生した際にClaude Codeが利用できるスキルを作成しておけます。
サブエージェント機能を使うと、Claude Codeは特定のタスクを別のエージェントに委任できます。並行調査や専門的な分析、あるいは独立して処理可能なタスクを含むワークフローにおいて非常に有効です。
フックを使用すると、Claude Codeのワークフロー内の特定のタイミングでコマンドを自動的に実行できます。フォーマット、バリデーション、ログ記録など、一貫して実行すべきタスクやチェックに活用できます。
Gitワークツリーを使用すると、同じ作業ツリーを何度も切り替えることなく、別々のディレクトリで複数のブランチを同時に扱うことができます。Claude Codeが並行タスクや実験的な作業を行う際に役立ちます。
MCPはClaude Codeを 外部ツールやデータソースに接続します。 MCPサーバーを利用することで、データベース、API、課題管理システムなど、開発ワークフローで使用するさまざまなサービスにClaude Codeからアクセスできるようになります。
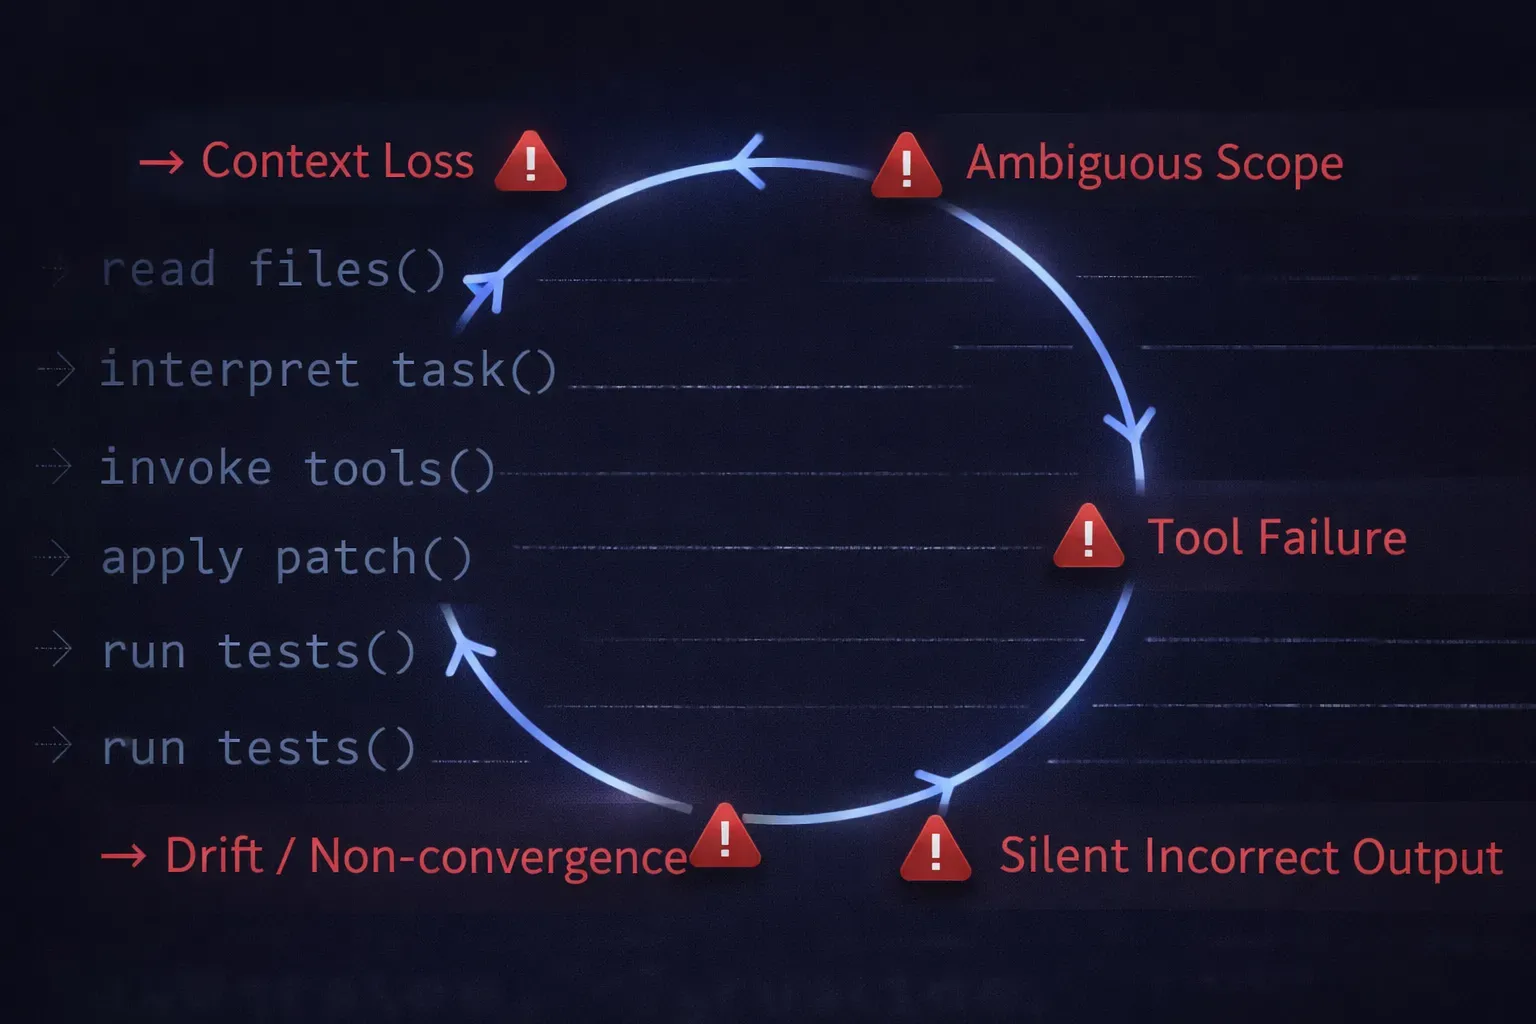
これはチームが見落としがちな部分です。失敗の仕方は、劇的なものではありません。Claude Codeが明らかにひどいコードを出力することは稀です。その代わり、一見正しそうに見えて実は微妙に間違っている修正、テストは通るものの意図を汲み取れていない変更、そして明確な兆候がないまま実行中に推論がずれていくといった、静かな失敗をします。
ワークフローは適切なファイルから始まります。しかし、コンテキストが読み込まれ、ツールの出力や中間パッチ、コマンドの結果が増えていくうちにコンテキストウィンドウが埋まり、何かが脱落します。モデルは推論を続けますが、内部で保持している状況認識が食い違ってしまいます。見た目には何も壊れていないように見えることこそが、この問題の危険な点です。
生成されたパッチ内の関数呼び出しが、存在しないオブジェクトを参照している。リファクタリングによって、本来不要な依存関係が追加されている。差分はあまりにもきれいに読み取れ、正しいコードのようにフォーマットされて届きます。だからこそ、レビューをすり抜けてしまうのです。
最終的な差分は確認できても、それを生成するに至った読み込みや再試行の順序までは見えません。出力が間違っている場合、なぜモデルが脱線したのかを説明する信頼できる痕跡は残りません。デバッグは、前向きな計測ではなく、過去を遡る考古学のような作業になってしまいます。 AIエージェントの可観測性ツール が役立ちます。
同じタスクを2回実行しても、結果が食い違うことがあります。劇的な違いではないにせよ、デバッグのパターンを追うのが面倒になるには十分な差です。実行ごとにコンテキストはわずかに異なり、ツールの出力も変わります。モデルは同じ問題に対して異なるアプローチをとるのです。再現性は過小評価されがちな運用要件ですが、こうしたワークフローが基幹コードに触れるようになると、その重要性は増します。
モデルはツールが返す結果に基づいて動作します。シェルコマンドがタイムアウトしたり、テストランナーが不完全な出力で終了したり、ファイルの書き込みは成功しても内容が切り詰められたりすることがあります。モデルは「本来あるべき結果」ではなく「実際に得られた結果」に対して反応します。ローカルでのテストでは堅牢に見えたものが、実際のインフラが関わるとすぐに崩れてしまうのです。
デモで確認できる堅牢性は、実際のインフラ環境では脆さに取って代わられます。こうした崩壊は、より大規模なチームやシステム全体でワークフローを拡張する際の障壁となります。
開発者が1人でワークフローを実行するのは生産性の実験に過ぎませんが、エンジニアチームが共有コードベースに対して重複するワークフローを実行するようになると、それは運用上の問題となります。規模が大きくなれば失敗は容易に特定できるようになりますが、その原因を切り分けることはより困難になります。
単一のリポジトリであれば、モデルはコードの全体像を把握できます。しかし、サービスメッシュ、複数のリポジトリ、共有ライブラリ、バージョン固定された依存関係などが加わると、その全体像は崩れます。あるリポジトリ内では正しく見える変更が、別のリポジトリでは微妙な不整合を生むのです。ワークフローは、自分が見ることのできない範囲については知る由もありません。
2人のエンジニアがそれぞれ独立してClaude Codeに同様の変更を依頼したとします。返ってくるパターンはそれぞれ異なります。どちらも間違いではありませんが、コードベースには同じ問題を解決するための2つの方法が混在することになります。共有された状態や、エージェントがすでにどこに手を加えたかという可視性がなければ、連携はコードレベルだけでなく、ワークフローレベルでも破綻します。
シェルコマンドを実行できるエージェント型ワークフローは、本番環境の境界線に近い場所に存在します。権限が広すぎれば被害範囲が拡大し、狭すぎれば予測不能な失敗を引き起こします。どちらの問題もプロンプトの調整だけでは解決できません。慎重なツールの設定と、インフラレベルでのアクセス制御が必要です。
いずれ、「どのワークフローがこのファイルを変更したのか?」「そのタスクの一部としてどのコマンドが実行されたのか?」「誰が承認したのか?」といった問いが必ず投げかけられます。システムがこれらの問いに答えられなければ、それはガバナンスが欠如している状態です。単に活動しているというだけでは不十分です。こうしたワークフローが金銭、認証、データを扱うコードに触れる場合、この区別は極めて重要になります。私たちの記事「 AIエージェントのガバナンス 」で、この概念について詳しく解説しています。
単一の失敗した実行のデバッグでさえ、実行トレースが不完全であるために困難です。多数の実行にわたるパターンをデバッグするのはさらに困難です。実行ごとに出力はわずかに異なり、コンテキストも異なり、ツールの挙動も変化します。安定した構造化された実行ログがなければ、失敗の再現は調査ではなく、いたちごっこになってしまいます。
本番環境での利用は、何が重要かを一変させます。デモでは出力の品質が目標ですが、本番環境では信頼性、監査可能性、そして再現性のある実行が目標となります。それを実現するためのプラクティスは、モデルそのものではなく、モデルを囲むシステムをどのように構築するかという点に集約されます。
「認証モジュールをリファクタリングして」というのは単なる指示です。「重複するトークン検証ロジックを統合するように認証モジュールをリファクタリングせよ。ただし、公開メソッドのシグネチャは変更せず、マイグレーションディレクトリには一切触れないこと」というのは制約条件です。制約条件は、熱意よりもはるかに有用です。ワークフローに対して、単なる目的地ではなく、守るべき具体的な指針を与えるからです。
コンテキストは多ければ良いというものではありません。古いログや無関係な出力ファイルと一緒にリポジトリの半分を読み込ませても、精度は上がらずノイズが増えるだけです。効果的なワークフローとは、選択的であるべきです。モデルがタスクを推論するために十分な情報を与えるのであって、関連がありそうなものすべてを詰め込む必要はありません。ここで求められるのは、情報を追加することではなく、削ぎ落とすという規律です。
ワークフローがテストを生成している場合、デプロイ用スクリプトへのアクセス権はおそらく不要です。アプリケーションコードをリファクタリングしている際に、広範なシェルアクセス権も必要ありません。ツールへのアクセスを制限することで、影響範囲を抑え、モデルが推論すべき範囲を絞り込むことができます。制限は厳しくするほど、信頼性は高まります。
差分のレビュー、ドライラン(空実行)フラグ、変更適用前の確認ゲートを設けること。これらはワークフローをわずかに遅くしますが、不確かな前提がコミットされる前に食い止めることができます。エージェントシステムにおいて、チェックポイントは官僚的な手続きではなく、人間の判断と自動実行を統合するための重要な場所です。これを排除することは、モデルが決して迷走しないという賭けに出るようなものです。
最終的なコードがコンパイルできたという事実だけでは不十分です。どのファイルが読み込まれ、どのコマンドが実行され、何回再試行が発生し、中間状態がどうであったかを知る必要があります。ワークフローは正しい出力を生成していても、不安定な状態である可能性があります。その不安定さは、インシデントになる前に実行トレースに現れるのが常です。
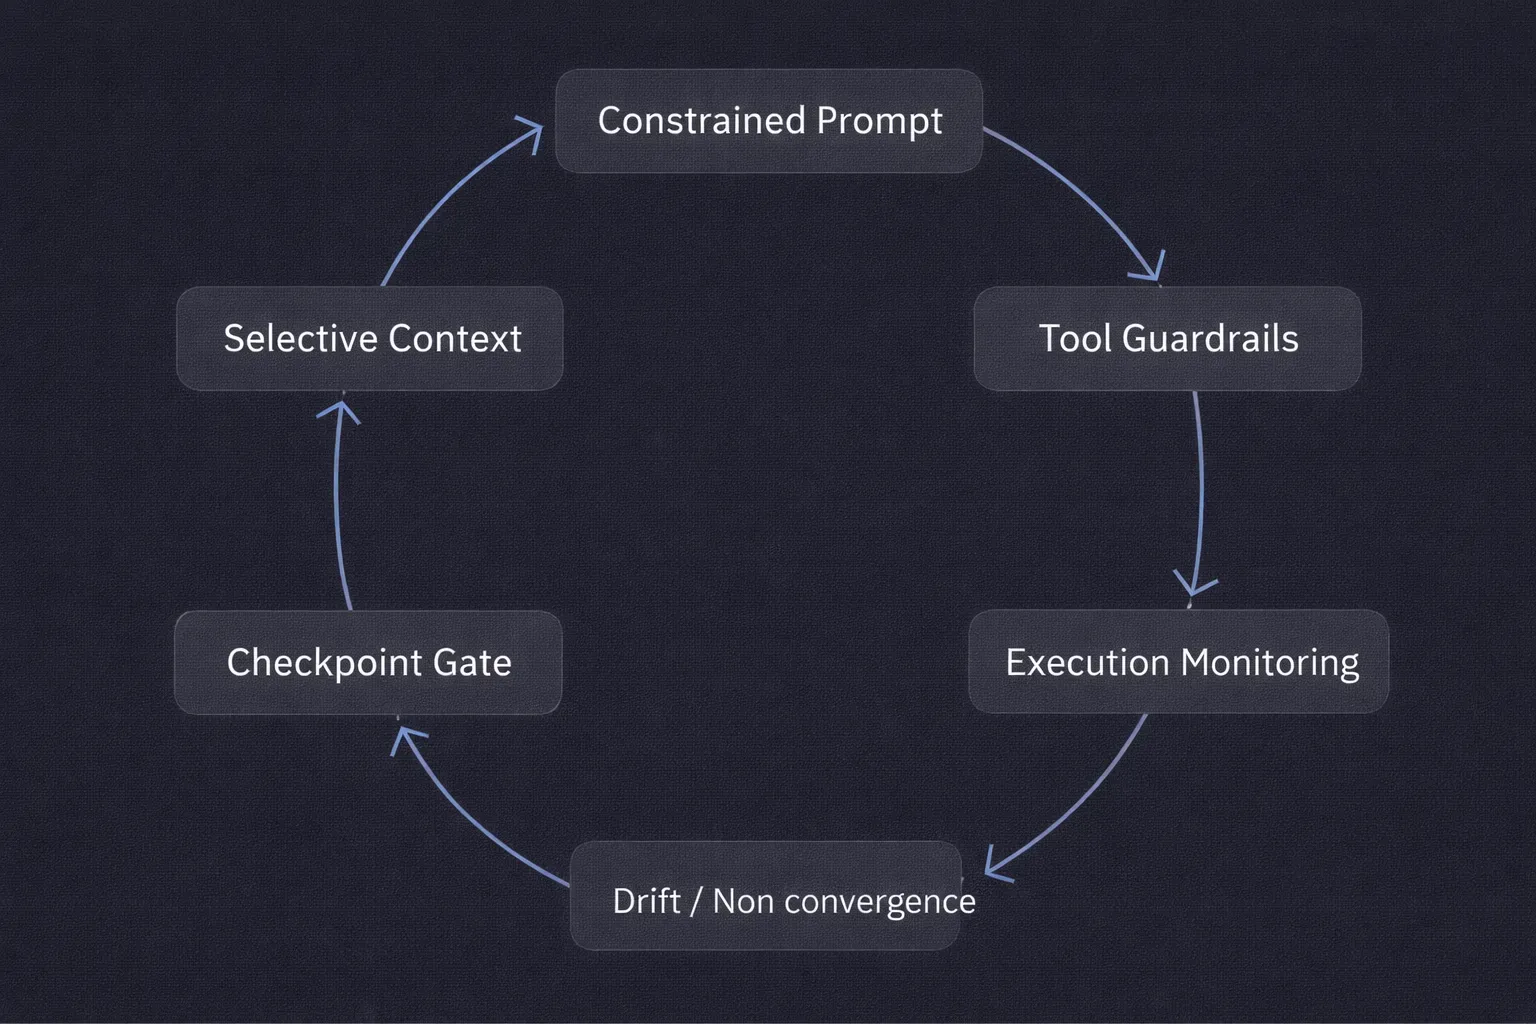
検証を最後の手動ステップとして扱わないでください。ビルド、テスト、リンティング、その他の関連チェックをワークフロー自体に組み込み、すべての変更が先に進む前に検証されるようにします。これにより、エージェントは即座にフィードバックを得ることができ、成功した実行結果を再現しやすくなります。
Claude Codeワークフローは、自動化できるほど構造化されているものの、退屈で後回しにされがちなタスクに役立ちます。これは非常に限定的なカテゴリーですが、対象を明確にすることで時間を節約できます。
重要なのは「Claude Codeを使うか使わないか」ではありません。「適切な範囲でClaude Codeを使うか」、それとも「信頼できる制約を課すことができないタスクにClaude Codeを無理やり使うか」という点です。
オートコンプリートからエージェントによる実行への移行はすでに始まっています。Claude Codeは単なる賢いサジェストエンジンではなく、読み取り、実行、観察、調整を行う実行システムです。この違いが「信頼性」の意味を根本から変えています。
適切に運用されたClaude Codeのワークフローは、機械的なリファクタリングに費やす時間の削減、テストカバレッジの迅速な向上、バックログに埋もれがちな移行タスクの解消といった確かな成果をもたらします。ただし、ここで重要なのは「適切に運用された」という点です。コンテキストの慎重な制御、ツール権限の定義、構造化されたプロンプト、実行前のチェックポイント、そして実際に何が実行されたかの計測が不可欠です。
これを理解しているチームは、ワークフローを単なる気の利いたプロンプトとしてではなく、境界が定義された実行システムとして扱っています。本番コードに触れる他のインフラストラクチャと同様の運用規律が求められるからです。
ワークフローがリポジトリの変更、コマンドの実行、実際の環境内での動作を開始した時点で、それは実験ではなくインフラストラクチャとなります。その際、周囲のシステムが安全性を確保するために十分な可視性と制御を提供できているかどうかが問われます。
TrueFoundry Claude Codeのワークフローを本番環境へ移行する際、エージェントの実行、ツールアクセス、可観測性、AIガバナンスを一元管理するための基盤を提供します。Claude Codeワークフローを大規模に構築されている場合、TrueFoundryを活用することで、これらすべてを単一のプラットフォームから管理・統制することが可能です。
デモを予約する お客様の環境への適合性をご確認いただけます。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.




Claude skills are reusable capabilities or instructions for specific tasks, while workflows describe the broader sequence of steps used to complete a task. A workflow can use one or more skills as part of its execution.
There is no single best workflow. A practical approach is to first understand the codebase, plan the change, implement it, run tests, review the diff, and then verify the final result.
Yes. Claude can create flowcharts from a process or set of instructions, including formats such as Mermaid. You can describe the workflow you want to visualize, and Claude can structure the steps and relationships into a flowchart.
No. Claude Code workflows are structured development processes for tasks such as coding, testing, and debugging. Dynamic workflows generally adapt their steps or behaviour based on changing inputs, conditions, or results during execution.
Yes. Claude Code can use subagents to delegate specific tasks. This allows a workflow to split work such as research, code analysis, testing, or review into separate tasks that can be handled independently.
Yes. Independent tasks can be delegated to multiple subagents and run concurrently where the workflow supports it. Parallel execution can reduce overall time, although tasks with dependencies still need to run sequentially.
Not automatically in their entire runtime state. However, project instructions, skills, configuration, and other persistent files can carry context across sessions. You should explicitly store important workflow instructions or state that Claude Code needs to reuse.
Start by defining the task and constraints, then give Claude Code the required context, allow the appropriate tools, execute the changes, and verify the result through tests or other checks























