Built for Speed: ~10ms Latency, Even Under Load Blazingly fast way to build, track and deploy your models!
Handles 350+ RPS on just 1 vCPU — no tuning needed Production-ready with full enterprise support はじめに Retrieval-Augmented Generation (RAG) は、検索システムの強みと生成モデルの強みを組み合わせ、極めて関連性の高い文脈に応じた出力を生成します。データベースや検索インデックスなどの外部ナレッジソースにクエリを実行して関連情報を取得し、それを生成モデルによって精緻化します。
なぜRAGなのか? 非常に関連性が高く、文脈に応じた出力 が可能。 動的で最新のナレッジ を取り入れることで、RAGシステムは生成モデルにおける静的な事前学習の限界を克服し、質問応答、知識集約型タスク、パーソナライズされたコンテンツ生成などのアプリケーションで非常に効果的になります。RAGのモジュール構造 により、検索ステージと生成ステージの両方で最適化が可能になり、システム設計における柔軟性と拡張性が向上します。 Cognita by TrueFoundry: スケーラブルなアプリケーションのためのRAGの簡素化 その可能性にもかかわらず、RAGの実装は複雑になることがあり、モデルの選定、データの構築、ベストプラクティスの適用が必要となります。既存のツールはプロトタイピングをシンプルにしますが、スケーラブルなデプロイのためのオープンソーステンプレートが不足していました。そこで登場するのがCognita です。
Cognitaは、スケーラブルなアプリケーションの構築とデプロイを簡素化するオープンソースのRAGフレームワークです。RAGをモジュール単位のステップに分割することで、容易なメンテナンス、他のAIツールとの相互運用性、カスタマイズ性、コンプライアンスを確保します。Cognitaは、将来の発展に向けた拡張性を維持しながら、適応性と使いやすさのバランスをとっています。
Cognitaのメリット パーサー、ローダー、エンベッダー、リトリーバーが管理された、再利用可能な中央リポジトリ。 非技術者ユーザーでもUIを操作可能 - 開発チームが構築したモジュールを使用して、ドキュメントのアップロードやQnAを実行。 完全なAPI駆動 - 他のシステムとの統合が可能。 Large Language Models (LLMs) により、OpenAIのGPT、Hugging Faceモデル、その他のLLM APIなどの生成モデルと容易に連携。 Pinecone、Weaviate、ChromaDB、MongoDB Atlas Vector Searchに簡単に接続できる事前構築済みインテグレーション。 なぜRAGにMongoDBなのか? Retrieval-Augmented Generation (RAG) アプリケーションのベクトルデータベースとしてMongoDB を使用することは、要件に応じて非常に有益です。MongoDBが優れた選択肢となる理由は以下の通りです:
1. ネイティブなベクトル検索サポート MongoDBは、Atlas Vector Searchを通じてベクトルインデックス作成 をサポートしています。これにより、RAGワークフローの中心となる高次元データに対する効率的な類似性検索が可能になります。主なメリット:
MongoDBのクエリ言語との統合 : ベクトル検索と従来のクエリを組み合わせ、より柔軟で強力なクエリの構築が可能。ハイパフォーマンスな検索 : HNSW (Hierarchical Navigable Small World) などの近似最近傍 (ANN) アルゴリズムを使用し、スケーラブルで高速なベクトル取得を実現。2. 統合されたデータ管理 RAGアプリケーションでは、非構造化データ (テキストや埋め込みなど)と構造化データ (メタデータ、ユーザー設定など)の両方を管理することがよく求められます。
ドキュメントデータベースであるMongoDBを使用すると、埋め込みとそれに関連するメタデータを単一のレコード内に一緒に保存できます。例:
これにより、埋め込みを別個のシステムで管理する複雑さを回避できます。
3. 柔軟性と拡張性 スキーマレス設計 : MongoDBの柔軟なスキーマにより、RAGアプリケーションの進化に合わせてデータモデルを簡単に繰り返し更新できます。
水平スケーリング: MongoDBは複数のサーバーにデータを分散するデータベースシャーディング をサポートしており、アプリケーションが大規模なデータセットを扱い、成長に合わせて拡張するのを支援します。
クラウドネイティブ機能 : MongoDB Atlasは、スケーリング、バックアップ、モニタリングを含む完全管理型サービスを提供します。
TrueFoundryについて詳しく知る
デモを予約
Cognita + MongoDBによるRAGの実装 ステップ1: MongoDBのセットアップ 無料のMongoDB Atlasクラスターを取得する方法のビデオチュートリアルを見るには、ここ をクリックしてください。
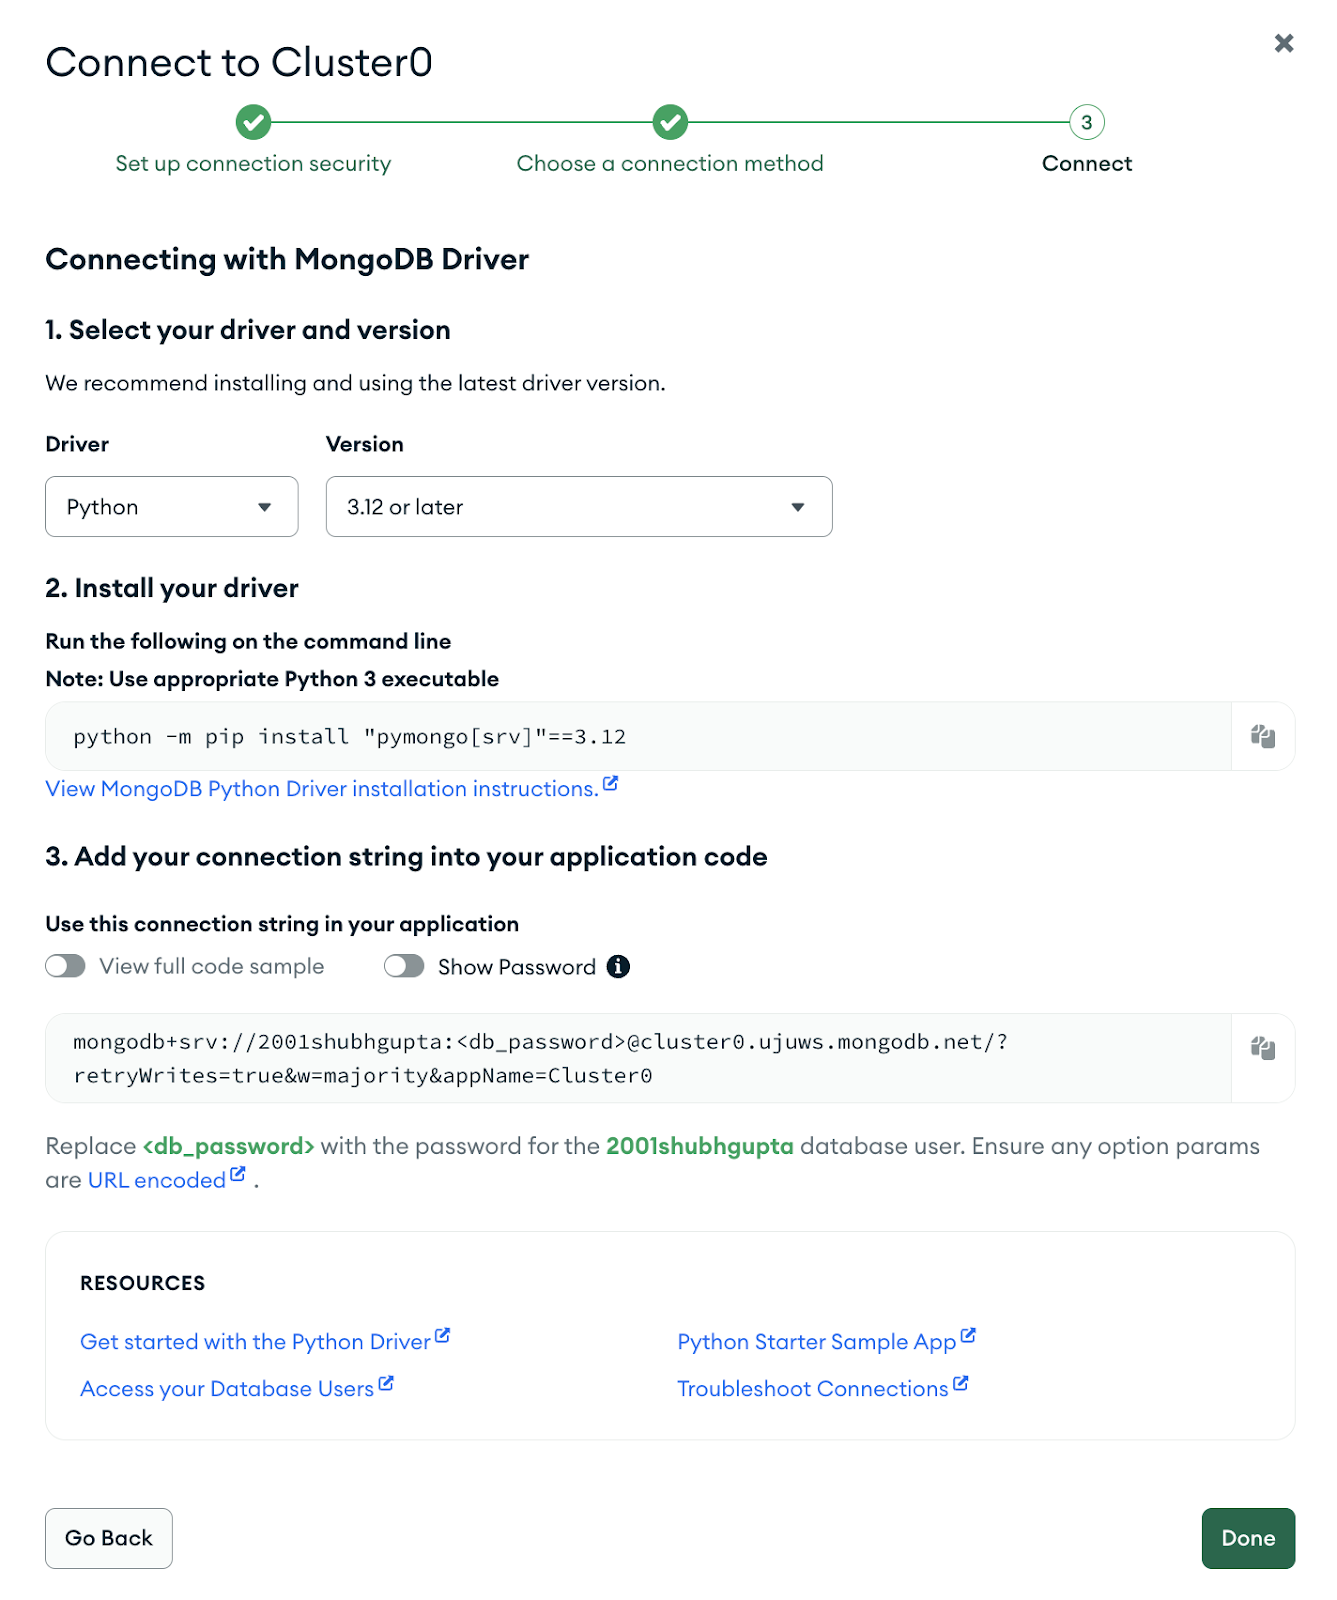
アカウントをまだお持ちでない場合は、登録 ページにアクセスしてMongoDB Atlasアカウントをセットアップします。 Overviewタブでクラスターをセットアップするには、「Create」をクリックし、要件に応じてクラスターを選択して「Create Deployment」を押します。 必要な認証を追加するために、「Connect to Cluster」ウィンドウでデータベースユーザーを作成します。 MongoDBドライバーで接続します Pythonのバージョンを選択します 接続文字列にはユーザー名とパスワードが含まれます。接続文字列をコピーします。これは次のステップで使用します。 ステップ2: MongoDBを使用するためのCognitaのセットアップ CognitaのGitHubリポジトリをクローンします: https://github.com/truefoundry/cognita/tree/main サービスを開始する前に、埋め込みや回答生成に必要なモデルプロバイダーを設定する必要があります。まず、models_config.sample.yamlをmodels_config.yamlにコピーします。 cp models_config.sample.yaml models_config.yaml
新規作成したデータベース(例: 「cognita」)内にMongoDBコレクションを作成します。これは、すべてのチャンクが保存され、検索プロセスで使用されるコレクションです。 composeファイルは環境変数にcompose.envファイルを使用します。必要に応じて変更できます。 環境ファイルの「VECTOR_DB_CONFIG」キーを編集します。この設定は、実行時間全体を通じてMongoDBがベクトルストアとして使用されることを保証するために、ブートストラッププロセスで使用されます。ここではMongoDBの接続文字列が使用されます。以下は設定例です: VECTOR_DB_CONFIG='{"provider":"mongo","url":"mongodb+srv://username:password@clustername.mongodb.net/?retryWrites=true&w=majority&appName=Cluster0", "config": {"database_name": "cognita"}}'
デフォルトでは、設定でローカルプロバイダーが有効になっており、ローカルで埋め込みとLLMを実行するためにinfinityとollamaサーバーが必要です。ただし、OpenAI API Keyをお持ちの場合は、models_config.yaml内のopenaiプロバイダーのコメントアウトを解除し、compose.env内のOPENAI_API_KEYを更新できます。これで、次のコマンドを実行してサービスを開始できます: docker-compose --env-file compose.env --profile ollama --profile infinity up
composeファイルにより以下のサービスが開始されますcognita-db - コレクションとデータソースのメタデータを保存するために使用されるPostgresインスタンス。 cognita-backend - CognitaのFastAPIバックエンドサーバーを開始するために使用。 cognita-frontend - Cognitaのフロントエンドを開始するために使用。 サービスが立ち上がると、http://localhost:5001でフロントエンドにアクセスできます。 ステップ3: Cognitaでデータコレクションをセットアップする Cognitaのセットアップが完了したら、以下の手順でUIを使用してドキュメントを照会する方法を説明します:
1. Data Sourceの作成
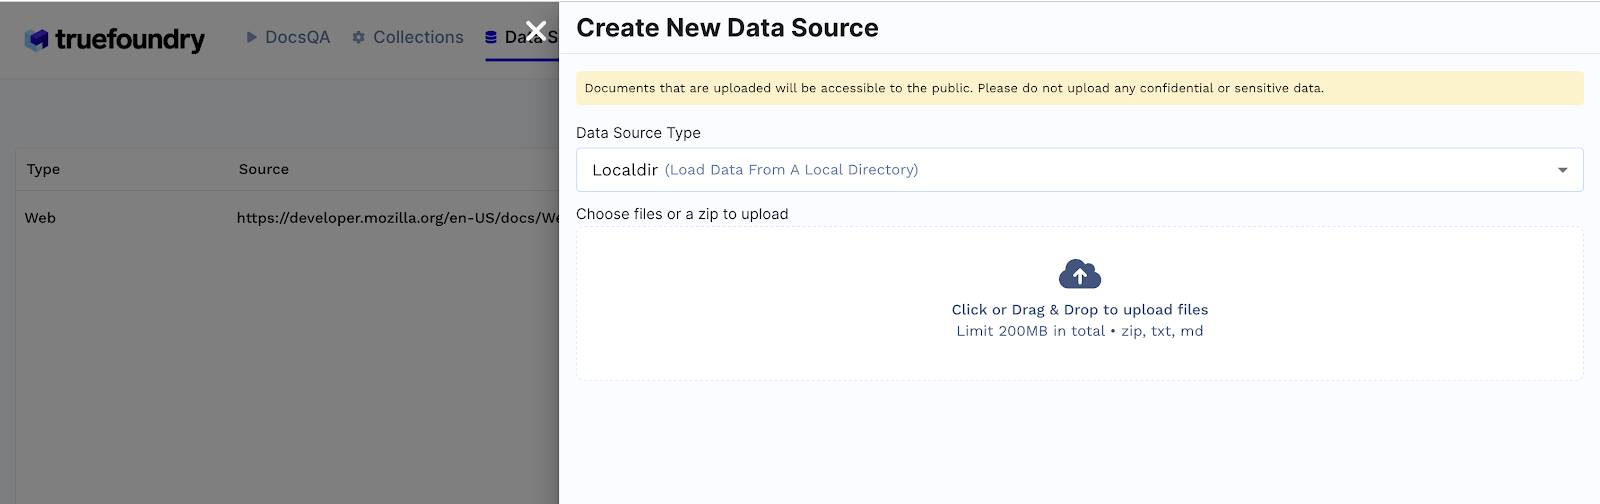
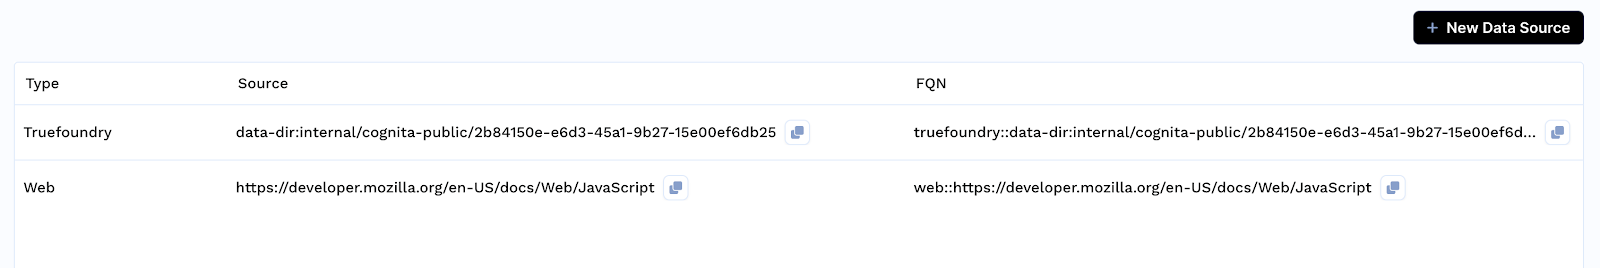
Data Sourcesタブをクリックします + New Datasourceをクリックします Data sourceのタイプは、ローカルディレクトリからのファイル、Web URL、GitHub URL、またはTrueFoundry artifact FQNの指定のいずれかを選択できます。例: Localdirを選択した場合は、マシンからファイルをアップロードしてSubmitをクリックします。 作成されたData sourceのリストはData Sourcesタブで確認できます。 2. Collectionの作成
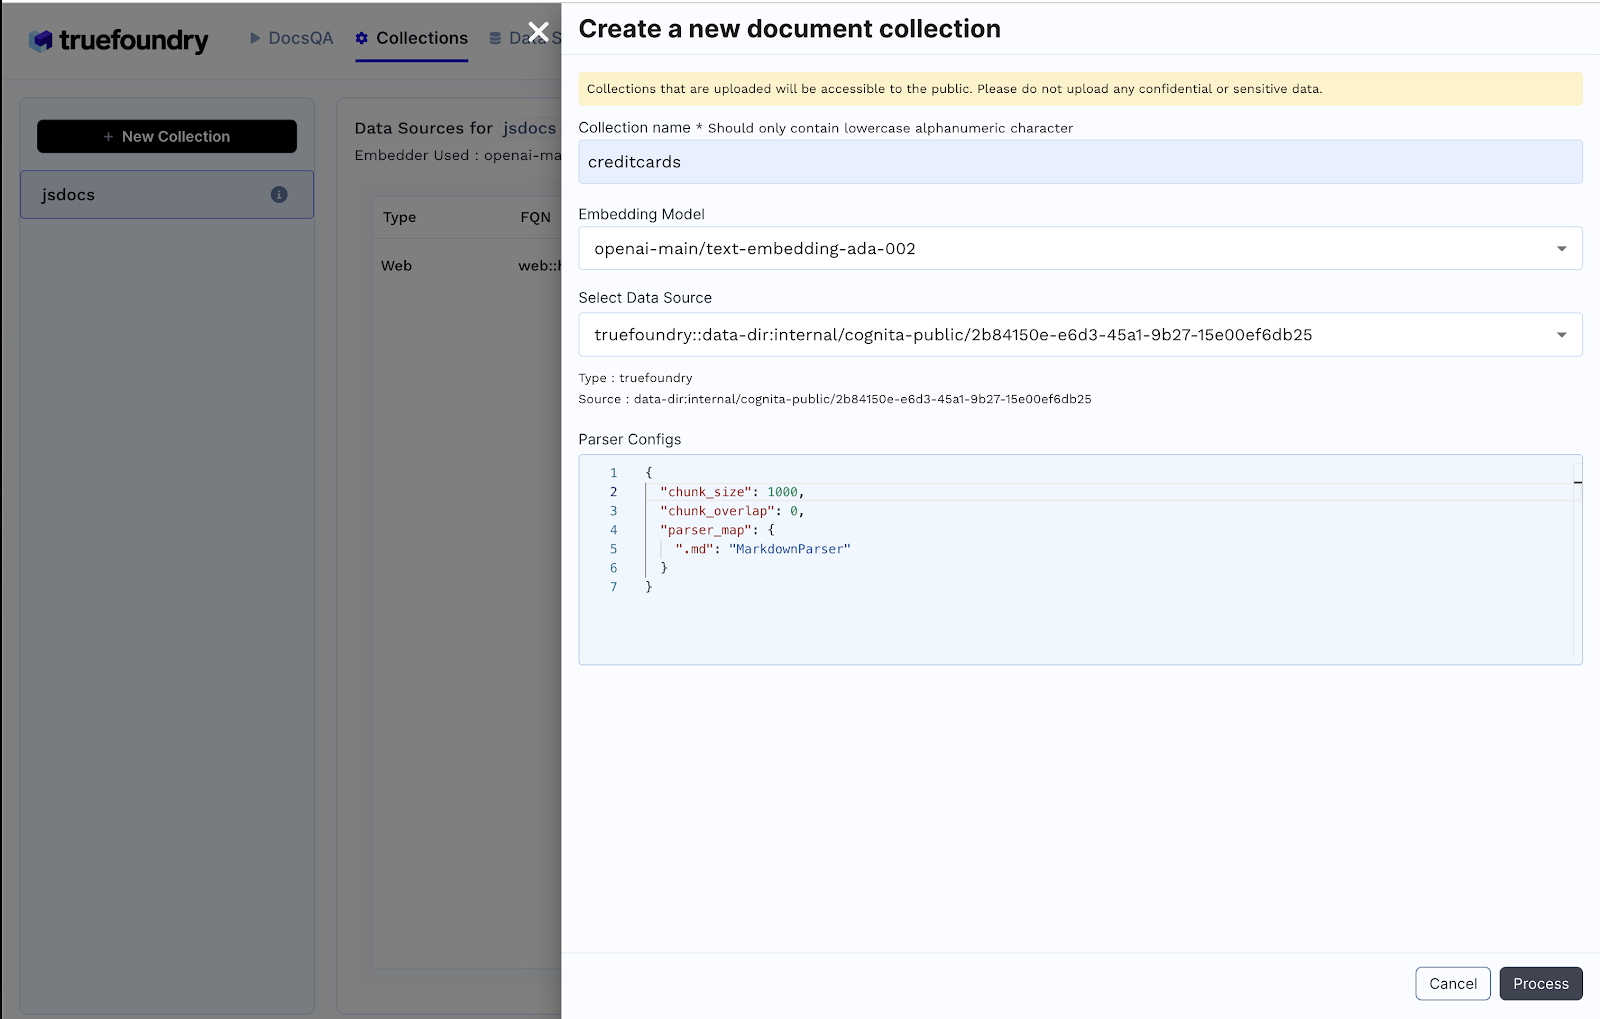
Collection Nameを入力します Embedding Modelを選択します 以前に作成したデータソースと必要な設定を追加します Processをクリックしてコレクションを作成し、データをインデックス化します 3. 新しいコレクションを作成すると、バックグラウンドで以下が発生します
設定されたMongoDBデータベース内に新しいコレクションが作成されます。たとえば、データベースの名前が `cognita` の場合、このステップによってMongoDBのcognitaデータベース内に指定した入力名のコレクションが作成されます。 コレクションの作成時に、以下のコードスニペットを使用してベクトル検索インデックスが作成されます: これにより、新規作成されたコレクションがベクトル検索クエリに対応できるようになります。MongoDBでのインデックス作成には最大1分かかる場合があることに注意してください。
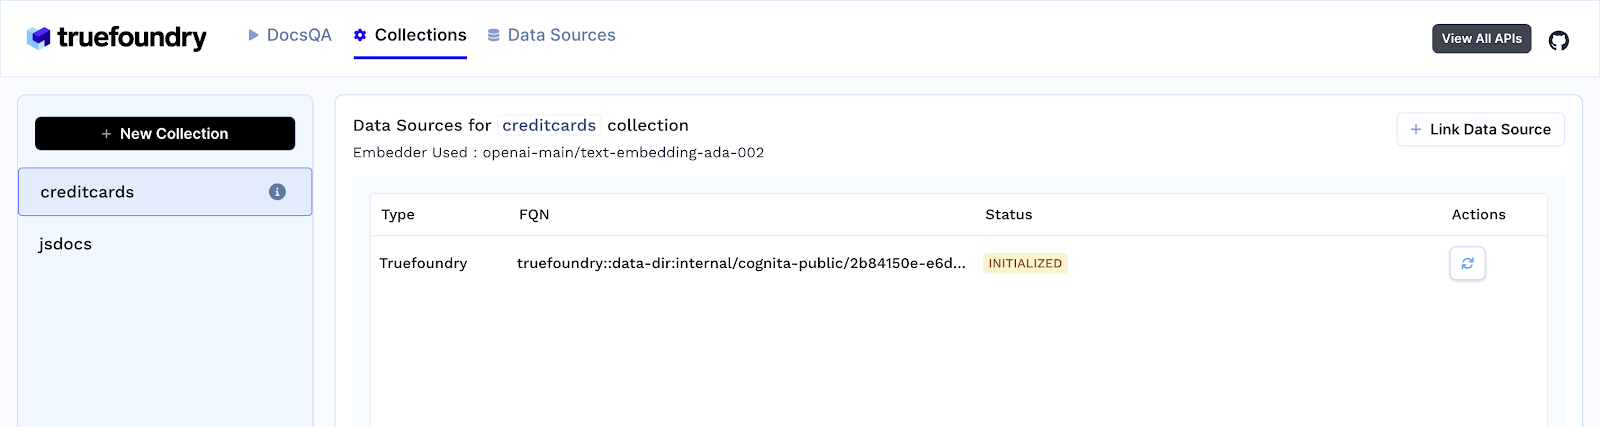
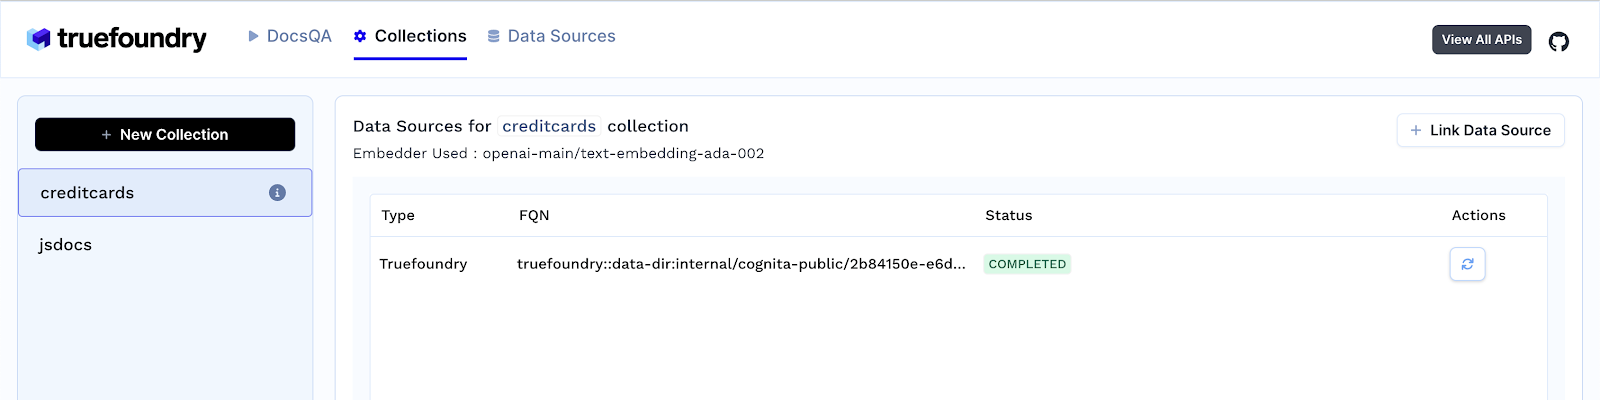
4. コレクションを作成するとすぐにデータの取り込みが始まります。Collectionsタブでコレクションを選択することでそのステータスを確認できます。このステップでは、ファイルのパース、チャンク分割、MongoDBへの追加が行われます。後からデータソースを追加してコレクション内にインデックスを作成することも可能です。Statusが「Completed」になったら次のステップに進みます。
ステップ4: アプリケーションに最適な設定を見つける DocsQAタブで、Cognitaのプレイグラウンドを使用してさまざまな設定を試すことで、アプリケーションに最も適したものを見つけます。以下のようなさまざまな要素を試すことができます:検索手法(Retrieval techniques) LLMモデル、temperatureなど LLMプロンプト 埋め込みモデル(Embedding models) アプリケーションに最も効果的な設定が決まったら、その設定で「Create Application」を押すと、アプリケーション用のAPIエンドポイントがデプロイされます。「Applications」タブに移動して、デプロイされたすべてのアプリケーションを確認できます。 おわりに このチュートリアルでは、CognitaとMongoDBを使用して、本番環境に対応したRAGアプリケーションをわずか10分で構築する方法を実演しました。Cognitaの適応性と使いやすさ、そしてベクトル検索を備えたMongoDBの柔軟なドキュメントモデルのシナジーは、高度なAIアプリケーションを作成するための堅牢な基盤を提供します。
TrueFoundryについて詳しく知る
デモを予約
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.
Built for Speed: ~10ms Latency, Even Under Load