



novembre 20, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Published: novembre 20, 2026

Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Toutes les équipes qui adoptent Model Context Protocol commencent de la même manière. Un développeur ajoute un serveur de système de fichiers et un serveur GitHub à Claude Desktop, modifie un fichier de configuration JSON, y colle un jeton, et cela fonctionne. C’est la bonne façon de démarrer. C’est rapide, cela ne comporte aucune pièce mobile, et cela permet à l’équipe de comprendre ce que fait réellement MCP avant de s’engager dans une infrastructure.
La question n’est pas de savoir s’il faut commencer par là. Il s’agit de savoir quand s’arrêter. Le modèle direct présente une courbe de défaillance invisible à petite échelle et brutale à moyenne échelle. La plupart des équipes atteignent le coude de cette courbe sans s’en rendre compte, généralement au moment où la deuxième équipe souhaite utiliser le même serveur et que personne ne peut dire qui possède les identifiants associés. Cet article traite de l’emplacement de ce point de bascule, de la façon de le voir venir et de ce qui change réellement lorsque vous placez une gateway au milieu. Si vous souhaitez d’abord obtenir la définition de base, ce qu’est une gateway MCP couvre l’aspect global du sujet ; nous nous concentrons ici sur la prise de décision.
Vous dépassez les capacités des connexions MCP directes ? Découvrez ce qu’une seule gateway peut remplacer. Réserver une démo.
Le terme « direct » signifie que chaque client est configuré pour communiquer avec chaque serveur dont il a besoin. Dans Claude Desktop, Cursor, VS Code ou un agent personnalisé, il s’agit d’un fichier de configuration par client répertoriant chaque serveur, son transport et ses identifiants. Le client détient la connexion et le secret. Il n’y a pas de couche partagée. Si dix clients utilisent le même serveur, l’adresse et le jeton de ce serveur résident à dix endroits différents.
Une gateway signifie que chaque client est configuré une seule fois, pour communiquer avec la gateway. La gateway conserve le registre des serveurs existants, termine la connexion à chaque serveur backend et décide par requête si cet appelant peut accéder à cet outil. Les clients ne détiennent jamais d’identifiants backend ; ils s’authentifient auprès de la gateway, et la gateway s’authentifie auprès des serveurs. La topologie passe d’un maillage à une étoile.
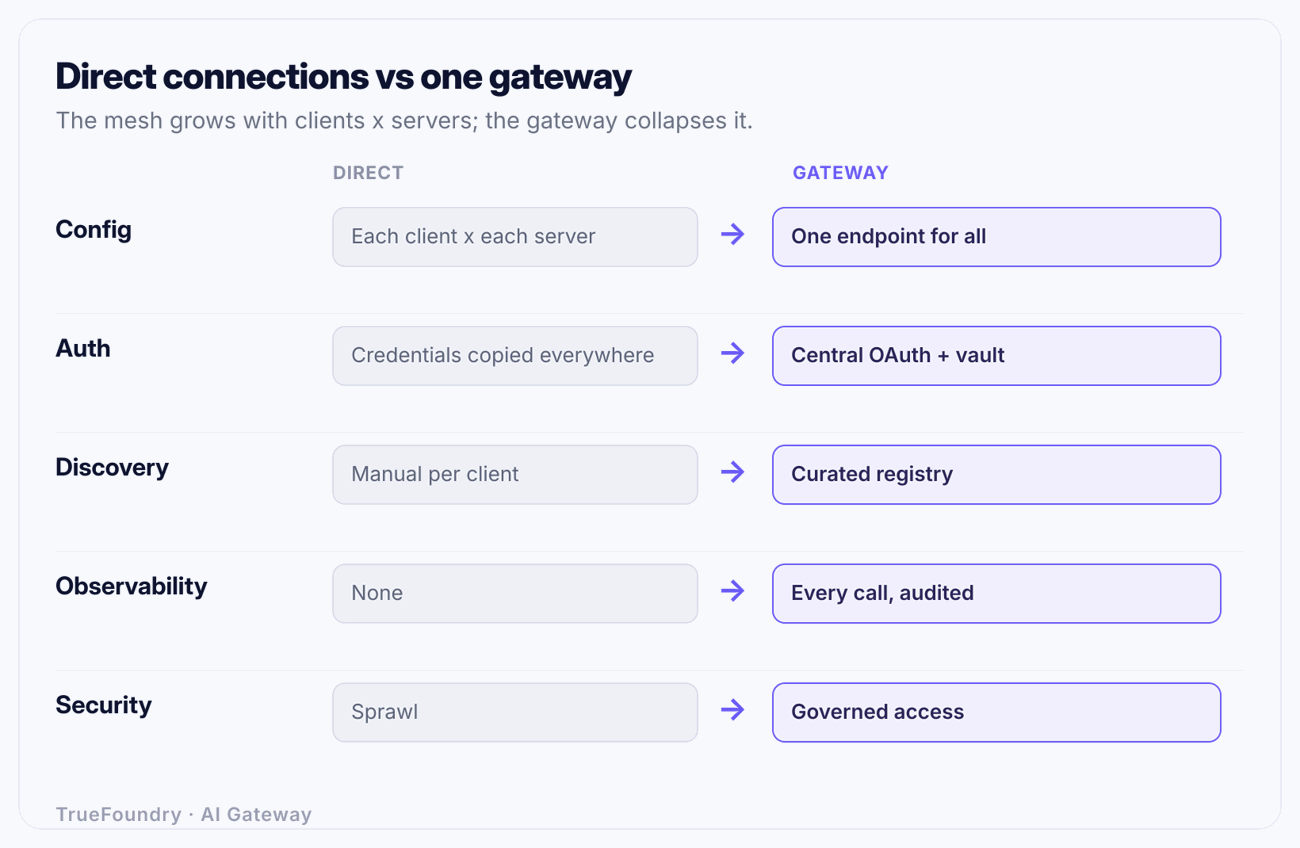
Ce schéma résume l’argumentation complète en une seule image, mais il reste en deçà de la réalité, car les lignes ne sont pas de simples connexions réseau. Chaque ligne du maillage représente également un identifiant à provisionner, une entrée de configuration à maintenir et un parcours dépourvu d’audit. L’étoile ne se contente pas de réduire les lignes ; elle modifie la responsabilité de chaque enjeu.
Les différences ne sont pas réparties de manière égale. Certaines comptent à n’importe quelle échelle ; d’autres ne posent problème qu’au-delà d’un certain seuil. Voici la répartition objective.
En lisant conjointement les lignes « ajout d’un serveur » et « scalabilité », la dynamique devient évidente. Dans le modèle direct, chaque unité de croissance multiplie le travail. Dans le modèle avec gateway, la croissance est additive et le coût par élément reste fixe. C’est la différence entre un modèle scalable et un modèle qui se contente de fonctionner.
Les chiffres rendent cela concret. Prenons une équipe plateforme de taille moyenne : 30 développeurs, chacun utilisant un mélange de clients (certains sur Claude Desktop, d’autres sur Cursor, d’autres sur un agent maison), et 6 serveurs MCP que l’organisation souhaite mettre à disposition de tous. Un serveur GitHub, un serveur Jira, un serveur de documentation interne, un serveur de lecture de base de données, un serveur d’observabilité et un serveur de déploiement.
En direct. Chaque développeur configure chacun des 6 serveurs dans chaque client. En faisant abstraction de la complexité multi-clients et en supposant un seul client par personne : cela représente 30 × 6 = 180 entrées de configuration, réparties sur 30 machines, maintenues manuellement. De plus, les trois serveurs qui nécessitent de vrais identifiants (le serveur de lecture de base de données, le serveur de déploiement et le serveur GitHub) voient désormais leurs jetons copiés sur 30 ordinateurs portables chacun. Cela fait 90 copies d’identifiants actifs pour trois systèmes sensibles, résidant dans des fichiers de configuration en texte clair, sans aucun registre centralisé indiquant quelle copie se trouve où.
Appliquez maintenant les opérations qui surviennent réellement. Le jeton du serveur de base de données est renouvelé : 30 développeurs doivent chacun modifier un fichier, et tant que le dernier ne l’a pas fait, certains rencontrent des erreurs et d’autres utilisent un secret obsolète. Un développeur quitte l’entreprise : quelqu’un doit savoir que son ordinateur contenait des copies de trois jetons sensibles et révoquer chacun d’eux. Or, aucun registre ne l’indique, donc en pratique personne ne le fait, et trois identifiants s'évaporent dans la nature. Un septième serveur est ajouté : 30 modifications de configuration supplémentaires. Une revue de sécurité demande « qui a appelé le serveur de déploiement mardi dernier » : il n’y a aucune réponse, car rien ne l’a enregistré de manière centralisée.
Avec une gateway. Chaque développeur configure un seul endpoint : la gateway. Cela représente 30 entrées de configuration, et elles ne changent presque jamais, car la cible vers laquelle elles pointent ne déplace pas. Les 6 serveurs sont enregistrés une fois, dans le registre de la gateway. Les identifiants sensibles résident dans la gateway, et sur zéro ordinateur portable de développeur. La rotation des jetons consiste en un changement unique à un seul endroit. Le développeur partant est retiré du contrôle d’accès de la gateway, et chaque accès qu’il possédait est fermé en une seule action, avec un enregistrement d’audit de ce à quoi il avait accédé. Le septième serveur représente une entrée de registre unique, et il apparaît dans le catalogue pour toutes les personnes y ayant droit grâce à la découverte dynamique. La question de sécurité devient une simple requête dans le journal d’audit.
Le nombre de configurations passe de 180 à 30, mais cela sous-estime l’impact réel. Le chiffre qui importe réellement est le nombre de copies d’identifiants, qui passe de 90 à 0, ainsi que le nombre d’emplacements où une modification doit être effectuée, qui passe de « chaque ordinateur portable concerné » à « un seul ». Le modèle direct n’a pas échoué parce que 180 est un grand nombre. Il a échoué parce que chaque événement opérationnel (rotation, départ d’un collaborateur, croissance, audit) évolue à l’échelle du maillage.
Voici la partie que la plupart des fournisseurs de gateways omettent. Dans un ensemble large et légitime de situations, vous ne devriez pas utiliser de gateway, et en installer une relèverait de la pure surcharge inutile.
Exécutez les serveurs directement lorsque l’ensemble des conditions suivantes est rempli. Un seul développeur, ou quelques-uns qui ne partagent pas de serveurs. Un ou deux serveurs. Des serveurs locaux, s’exécutant sur la même machine que le client via stdio, et non des serveurs distants accessibles via le réseau. Pas d’identifiants partagés, car chaque personne utilise les meins. Aucune exigence de conformité ou d’audit, car il s’agit d’expérimentation ou d’outillage personnel. C’est le cas classique de l’ordinateur portable, et pour ce cas d’usage, une gateway ajoute un saut réseau, une dépendance et un composant à exploiter, en échange de la résolution de problèmes que vous n’avez pas.
L’indicateur le plus clair réside dans le transport. Un serveur s’exécutant localement via stdio, détenu par la seule personne qui l’utilise, est un processus sur votre machine ; l’envelopper dans une gateway revient à placer un équilibreur de charge devant un script. Dès qu’un serveur devient distant, accessible via Streamable HTTP par plus d’un client, le calcul s’inverse. En effet, il existe désormais un identifiant qui transite, une connexion que plusieurs clients partagent et une question d’autorisation d’accès, ce qui correspond exactement à l’ensemble des problèmes qu’une gateway a pour rôle de résoudre. La discussion sur l’hébergement de serveur MCP approfondit la distinction entre local et distant et explique pourquoi elle constitue la véritable bifurcation architecturale.
Si vous cherchez une procédure simple, la voici. Parcourez les questions dans l’ordre ; arrêtez-vous au premier signal fort.

L’arbre traduit une idée simple : la gateway justifie sa présence dès qu’une préoccupation devient partagée. Partagée entre clients, partagée entre personnes, partagée sur le réseau ou partagée avec un auditeur. Tant que tout reste privé à un seul développeur sur une seule machine, le modèle direct l’emporte. Dès qu’un élément est partagé, l’entité qui gère ce partage, l’authentification, l’accès, la découverte et l’audit doit résider dans un emplacement centralisé, et cet emplacement est la gateway.
Voici la même logique sous forme de liste de contrôle à évaluer. Comptez vos réponses « oui ».
Avec zéro ou un seul « oui », vous vous situez confortablement dans la zone des connexions directes ; profitez de cette simplicité. Avec deux ou trois, vous êtes au coude de la courbe, là où une gateway commence à devenir rentable. Avec quatre ou plus, vous subissez déjà le coût de son absence, à travers la dispersion des identifiants et des questions d’audit sans réponse, que cela apparaisse ou non sur un tableau de bord.

Découvrez comment TrueFoundry regroupe des connexions MCP N-par-M en un seul endpoint gouverné. Réserver une démo.
Il convient d’être précis sur ce qui est déplacé au centre, car le terme « gateway » peut sembler désigner un proxy vague. Quatre éléments concrets changent d’emplacement.
L’identité et l’authentification. La gateway termine le protocole OAuth vers les serveurs backend, en gérant à la fois les flux à deux jambes (service à service) et à trois jambes (pour le compte d’un utilisateur). Ainsi, les clients présentent un seul identifiant à la gateway et ne détiennent jamais de secrets backend. Les mécanismes de ces flux sont détaillés dans l’authentification MCP ; l’élément clé ici est qu’ils s’exécutent une seule fois, au point de passage obligé, au lieu d’être réimplémentés ou copiés-collés par client.
Le registre. Au lieu que chaque client inscrive en dur une liste de serveurs, la gateway héberge un registre structuré des serveurs existants, et les clients y découvrent les outils de manière dynamique. L’ajout ou la déprécation d’un serveur est une opération au niveau du registre, et non une modification sur l’ensemble du parc. Si le concept de registre est nouveau pour vous, l’article ce qu’est un registre MCP en explique le modèle.
Le contrôle d’accès et les garde-fous. Le contrôle d'accès basé sur les rôles (RBAC) détermine quels utilisateurs ou équipes peuvent accéder à quels serveurs et outils. De plus, les garde-fous pour des éléments comme les PII et l’injection de prompt s’appliquent de manière uniforme, car chaque requête passe par un endroit unique. Dans le modèle direct, chaque serveur applique ce qu’il peut, de manière incohérente ; dans le modèle avec gateway, la politique est écrite une fois. Le modèle de contrôle global est présenté dans la gouvernance MCP en entreprise.
L’observabilité et l’audit. Chaque appel génère un enregistrement : l’auteur, le serveur concerné, l’outil utilisé, l’horodatage, la latence et le résultat. C’est l’élément le plus fréquemment manquant que les équipes découvrent dans le modèle direct, et le plus difficile à ajouter a posteriori, car il est impossible d’enregistrer des appels qui ne sont jamais passés par un point commun.
Installer une gateway pour une configuration à un seul développeur et un seul serveur. Cela génère de la surcharge sans aucun bénéfice. Si vous vous situez sous le premier seuil, une gateway ne résout rien et ajoute une dépendance. Commencez en direct, et migrez lorsqu’un signal se déclenche.
Rester en direct jusqu’à ce qu’un identifiant fuite. C’est l’erreur la plus courante et la plus coûteuse. Le modèle direct ne propose aucune procédure de départ des collaborateurs. Ainsi, lorsque quelqu’un quitte l’entreprise avec des jetons sur son ordinateur portable, ou qu’un fichier de configuration est envoyé par erreur sur un dépôt de code, la dispersion des identifiants n’apparaît au grand jour qu’au moment de l’incident. Les 90 copies d’identifiants constituaient un risque permanent ; elles ne sont devenues visibles que lorsque l’une d'elles a été compromise.
Considérer que l’observabilité est assurée sous prétexte que chaque serveur enregistre des journaux. Des journaux isolés par serveur ne permettent pas de répondre aux questions transversales. Déterminer quel utilisateur a sollicité de manière excessive l’outil le plus coûteux sur l’ensemble des serveurs cette semaine est impossible lorsque les journaux résident à six endroits différents, avec six schémas distincts et sans identité partagée. L’observabilité centralisée est fondamentalement différente de six journaux locaux.
Ajouter la gateway tout en laissant un accès direct ouvert. Si les clients peuvent toujours atteindre les serveurs directement, le contrôle d’accès et l’audit de la gateway deviennent indicatifs et non contraignants. Un point de passage obligé ne régit que ce qui est contraint d’y transiter. Fermer l’accès direct est ce qui transforme la gateway d’un simple élément de confort en un véritable outil de contrôle.
Confondre « transport sans état » et « absence d’infrastructure requise ». Le fait que Streamable HTTP soit sans état facilite la montée en charge des serveurs, mais cela ne gère ni les identifiants, ni la découverte, ni l’audit. Ce sont précisément les enjeux pris en charge par la gateway, et ils ne disparaissent pas simplement parce que le protocole s’est simplifié.
Le choix entre une gateway et des connexions directes n’est pas d’ordre idéologique, et ne se résume pas à « les gateways sont destinées aux entreprises, le direct aux projets personnels ». C’est une fonction liée au partage. Tant qu’un serveur reste privé à une seule personne sur une seule machine, la connexion directe constitue la réponse la plus simple et la plus adaptée, et recourir à une gateway est prématuré. Dès qu’un serveur est partagé (entre clients, entre personnes ou sur le réseau), les problématiques créées par ce partage (authentification, accès, découverte et audit) doivent résider dans un emplacement central, et cet emplacement central est la gateway.
Le piège réside dans le fait que le modèle direct n’avertit pas lorsqu’il cesse d’être adapté. Il continue de fonctionner pendant que les copies d’identifiants s’accumulent et que l’écart d’audit se creuse, jusqu’au jour où une rotation interrompt le travail de la moitié de l’équipe ou que quelqu’un parte avec des jetons non suivis. Les quatre questions (plus d’un client, des serveurs partagés, des serveurs distants, des besoins de conformité) permettent d'identifier le point de bascule avant de le subir. Évaluez vos réponses et migrez lorsque les indicateurs le demandent, plutôt qu’après un incident.
Passez de serveurs MCP dispersés à un point de contrôle unique. Réserver une démo.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception





