



novembre 20, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Published: novembre 20, 2026

Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
La plupart des équipes découvrent qu'elles ont besoin d'une plateforme d'évaluation de la même manière : une modification de prompt qui semblait correcte dans un notebook régresse silencieusement en production, un client capture l'écran d'une réponse hallucinée, et personne ne peut dire si la nouvelle version du modèle est réellement meilleure que l'ancienne ou simplement différente. La question « cette application LLM est-elle performante ? » s'avère n'avoir aucune réponse tant que vous n'avez pas construit la structure nécessaire pour la mesurer.
Cette structure est précisément ce que fournissent les plateformes d'évaluation LLM. Mais cette catégorie d'outils est confuse. Certains outils sont axés avant tout sur l'évaluation avec du tracing greffé par-dessus. D'autres sont axés sur l'observabilité avec des évaluations ajoutées ensuite. Certains sont des bibliothèques open-source que vous hébergez ; d'autres sont des SaaS gérés. Et la nouveauté réside dans les agents : évaluer un simple couple prompt-completion est un problème, mais évaluer un agent à dix étapes qui appelle des outils, extrait des documents et boucle en est un bien plus complexe.
Ce guide poursuit trois objectifs. Il définit le cycle de vie de l'évaluation afin que vous sachiez de quelles capacités vous avez réellement besoin. Il passe en revue les principales plateformes (Langfuse, Arize Phoenix, Braintrust, LangSmith, Comet Opik, Maxim, Helicone) avec des précisions sur les points forts et faibles de chacune. Et il explique où se situe une gateway IA, car les traces et les données de coûts qu'elle produit constituent la matière première consommée par la plupart des plateformes d'évaluation.
Vous souhaitez des traces par requête, le suivi des coûts et des guardrails en ligne en plus de vos évaluations ? Réservez une démo.
L'évaluation n'est pas une étape unique que vous exécutez avant le lancement. C'est une boucle comprenant quatre phases, et une plateforme sérieuse les prend toutes en charge.
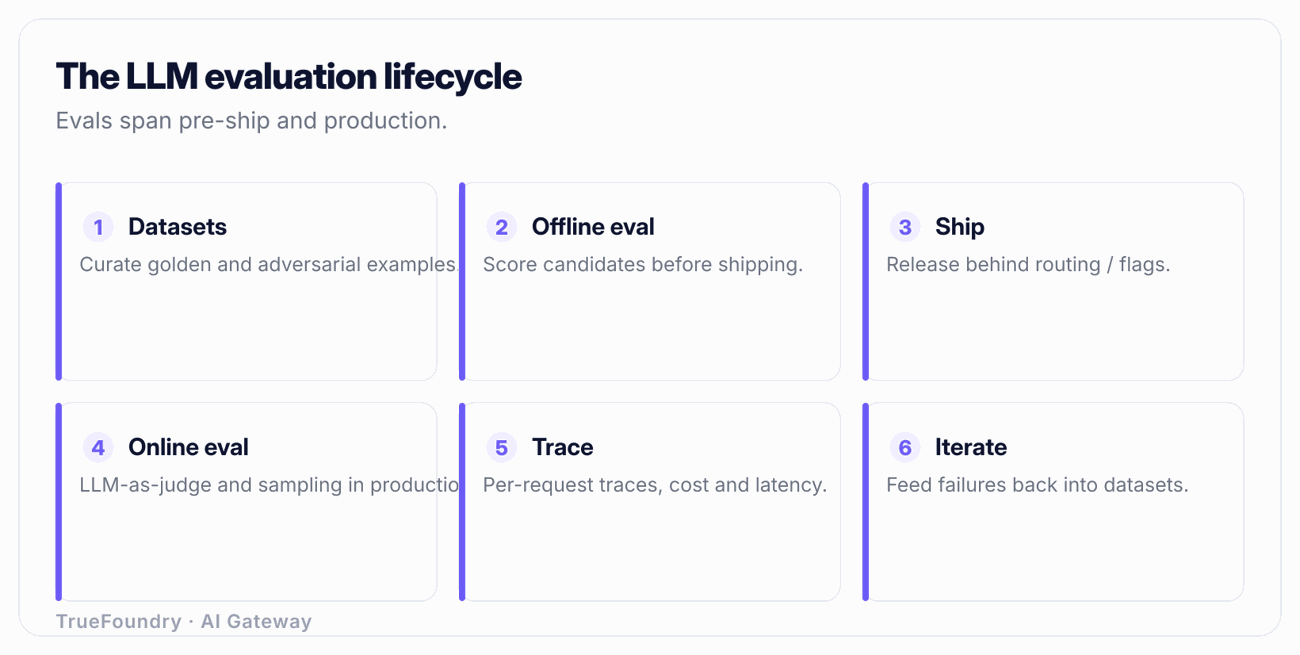
1. Les datasets. Tout commence par des exemples. Un dataset est un ensemble d'entrées, éventuellement accompagnées des sorties attendues ou de réponses de référence, qui représentent le travail effectué par votre application. Les meilleurs datasets ne sont pas synthétiques, ils sont extraits de la production : les vraies questions posées par les utilisateurs, en particulier celles qui ont échoué. Une équipe mature réinjecte continuellement les traces de production défaillantes ou mal notées dans le dataset afin que la suite d'évaluation devienne plus exigeante au fil du temps au lieu de rester figée au niveau de complexité du jour de lancement.
2. L'évaluation hors ligne (offline). Avant de déployer une modification de prompt, de modèle ou de recherche documentaire (retrieval), vous l'exécutez sur le dataset et notez les résultats. Les méthodes de notation vont de déterministes (correspondance exacte, regex, validité du schéma JSON, exécution correcte du SQL) à évaluées par modèle (LLM-as-judge pour l'exactitude, la pertinence, le ton). L'évaluation offline est votre porte de validation pré-fusion (pre-merge gate) : elle répond à la question « cette modification a-t-elle amélioré ou dégradé les choses sur les cas que je connais déjà ? »
3. L'évaluation en ligne (online). Les datasets offline ne couvrent jamais tout ce que la production vous envoie. L'évaluation online exécute des évaluateurs sur le trafic en direct, généralement sur un échantillon, pour détecter les régressions et les nouveaux modes de défaillance que votre dataset a manqués. C'est là que vous mesurez des éléments tels que le taux d'hallucination en production, la pertinence des réponses et les violations de guardrails sur de vraies sessions utilisateur.
4. Tracing et observation. Le tracing constitue le socle des deux phases précédentes : il s'agit de capturer chaque étape d'une exécution sous forme de spans structurés. Pour un chatbot simple, il s'agit de l'entrée du prompt, de la sortie de la completion, ainsi que du nombre de tokens et de la latence. Pour un agent, il s'agit d'un arbre : l'étape de planification, chaque appel d'outil avec ses arguments et son résultat, chaque recherche avec les extraits (chunks) renvoyés, chaque appel de modèle avec son prompt et sa sortie. Sans cet arbre, vous pouvez noter la réponse finale d'un agent, mais vous ne pouvez pas déterminer pourquoi elle était erronée, si la recherche a échoué, si l'outil a renvoyé une erreur ou si le modèle a ignoré un bon contexte.
La boucle se ferme lorsque les résultats des étapes 3 et 4 sont réinjectés dans l'étape 1. Une bonne plateforme permet cela en un clic : repérer une mauvaise trace de production, l'ajouter au dataset, puis exécuter à nouveau l'évaluation offline sur cette trace pour toujours.
L'évaluation des agents ajoute deux difficultés supplémentaires. Tout d'abord, la trajectoire importe, pas seulement la réponse finale. Un agent peut atteindre une réponse correcte en empruntant un chemin défaillant (trois appels d'outils redondants, une recherche ayant renvoyé du contenu inutile que le modèle a ignoré par chance) et cette fragilité finira par vous poser problème plus tard. Vous devez noter les étapes, et pas seulement le résultat. Deuxièmement, le non-déterminisme se cumule. Un agent à dix étapes où chaque étape présente une certaine variance produit des exécutions très différentes à partir d'une même entrée. Vous avez donc besoin de plusieurs exécutions par cas et d'une notation agrégée, plutôt que d'un simple succès ou échec sur un seul passage.
Pour tout ce qui est ouvert (résumés, réponses de chat, champs extraits avec une exactitude approximative), vous ne pouvez pas écrire de regex. L'évaluateur pratique consiste à utiliser un autre LLM invité à noter le résultat : le LLM-as-judge.
Cela fonctionne, mais avec des mises en garde qui séparent les équipes qui font confiance à leurs évaluations de celles qui subissent des désillusions :
Toutes les plateformes ci-dessous proposent le LLM-as-judge. Les différences résident dans la facilité avec laquelle elles permettent l'étalonnage, la définition de grilles d'évaluation et le maintien du versionnage du juge.
Aucun outil unique ne s'impose pour tout le monde. Voici un panorama objectif.
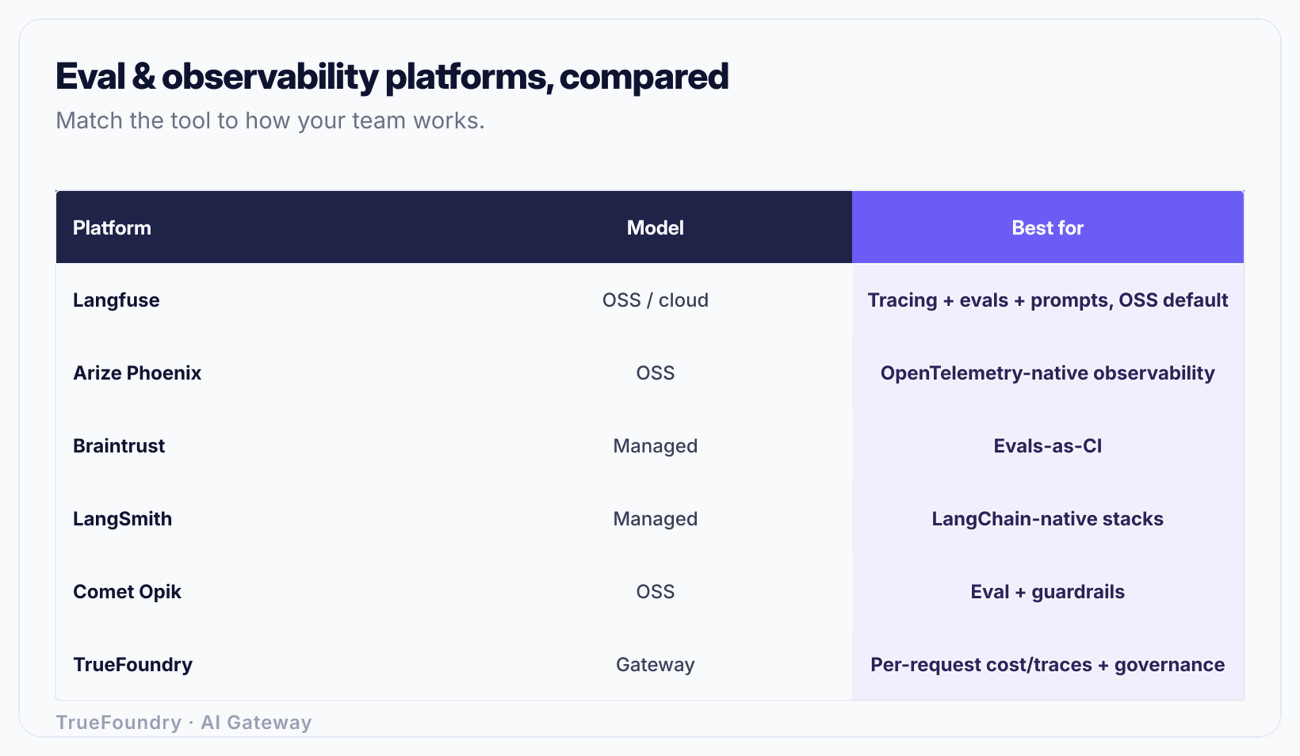
Langfuse. Open source (hébergeable par vos soins ou sur un cloud géré), c'est l'option OSS la plus complète. Elle combine tracing, évaluations, gestion des prompts et datasets au sein d'un seul système. Idéale pour les équipes souhaitant un auto-hébergement pour des raisons de résidence des données et obtenir une observabilité globale couplée à l'évaluation sans devoir assembler trois outils différents. Le modèle de tracing est flexible et indépendant des frameworks (framework-agnostic). Si vous cherchez une plateforme open-source unique couvrant la majeure partie du cycle de vie, c'est généralement la première à essayer. Consultez notre vue d'ensemble des outils d'observabilité LLM pour comprendre son positionnement dans le paysage plus large de l'observabilité.
Arize Phoenix. Open source et natif OpenTelemetry, ce qui constitue sa caractéristique principale. Phoenix prend en charge les conventions sémantiques OTel pour les spans LLM, de sorte que les traces s'intègrent directement dans les infrastructures que vous exploitez peut-être déjà, vous évitant ainsi d'être enfermé dans un format de trace propriétaire. Très performant sur le débogage RAG et la recherche documentaire (inspection des embeddings et des chunks). Si votre organisation s'est standardisée sur OpenTelemetry, Phoenix est le choix le plus naturel. Arize commercialise également un produit enterprise géré au-dessus de son cœur OSS.
Braintrust. Solution gérée, axée en priorité sur l'évaluation. Sa thèse repose sur l'évaluation intégrée à l'intégration continue (evals-as-CI) : vous intégrez l'évaluation dans votre boucle de développement de sorte que chaque modification de prompt ou de code s'exécute automatiquement sur des datasets, avec des comparaisons de scores présentées comme des résultats de tests. Excellente expérience utilisateur pour expérimenter et comparer côte à côte des variantes de prompts et de modèles. Solution idéale pour les équipes dont le problème principal est « nous modifions des prompts en permanence et n'avons pas de garde-fou contre les régressions ». Plus limitée sur l'auto-hébergement et l'observabilité complète que Langfuse.
LangSmith. Solution gérée, développée par l'équipe LangChain et profondément intégrée à LangChain et LangGraph. Si votre stack s'appuie déjà sur LangChain, le tracing s'obtient presque sans effort, l'instrumentation est incluse, et les vues sur la trajectoire des agents sont très complètes. Le compromis réside dans le fait que l'expérience optimale présuppose l'utilisation de l'écosystème LangChain ; en dehors de celui-ci, l'outil reste utilisable mais présente un intérêt moins évident.
Comet Opik. Open source, issu de la lignée Comet (suivi d'expérimentations ML). Il couvre le tracing, les évaluations et intègre notamment des contrôles de type guardrails parallèlement à l'évaluation. Très adapté aux équipes utilisant déjà Comet pour le suivi d'expérimentations ML classiques et souhaitant centraliser leurs travaux LLM au même endroit, ou cherchant un outil d'évaluation OSS doté de contrôles de modération intégrés.
Maxim AI. Une plateforme d'évaluation et d'observabilité qui propose également Bifrost, une gateway IA open-source. La promesse globale est d'« évaluer, observer et router auprès d'un seul fournisseur ». La limite rencontrée par les acheteurs est que les évaluations et la gateway sont concrètement deux produits distincts plutôt qu'un plan de contrôle unique, les tarifs de la gateway ne sont pas publics (accès sur demande), et il s'agit d'un éditeur plus récent dont les benchmarks sont largement auto-déclarés. Si vous évaluez spécifiquement Maxim ou sa gateway Bifrost, analysez séparément la profondeur de l'évaluation et celle de la gateway/gouvernance, car peu d'outils sont les meilleurs de leur catégorie sur ces deux aspects.
Helicone. Open source, orienté observabilité et proxy. Il se positionne comme un proxy léger devant vos appels de modèles et capture les logs, la latence et les coûts avec une intégration minimale (simple modification d'une URL de base). Les évaluations sont présentes mais plus sommaires que celles d'une plateforme d'évaluation dédiée. Idéal lorsque votre priorité est d'obtenir rapidement une observabilité économique avec un faible coût de configuration, en considérant l'évaluation approfondie comme un besoin secondaire.
Voici le tableau comparatif résumé :
Découvrez comment TrueFoundry apporte de l'observabilité et de la gouvernance à votre stack d'évaluation. Réservez une démo.
Faire un choix parmi la liste ci-dessus revient à évaluer quelques axes clés. Évaluez les candidats par rapport à ces critères plutôt qu'en fonction du volume de fonctionnalités vanté par le marketing.
Méthode concrète pour utiliser cette grille : si votre contrainte stricte est « les données clients ne doivent pas quitter notre VPC », vous restreignez immédiatement votre choix aux options OSS auto-hébergeables (Langfuse, Phoenix, Opik) ou à un plan Enterprise avec déploiement intra-VPC, ce qui élimine les outils exclusivement gérés quelle que soit leur expérience utilisateur. Partez de vos exigences non négociables, puis optimisez parmi les choix restants.
Une plateforme d'évaluation a besoin de données à analyser : des traces, des prompts, des completions, des volumes de tokens, des latences et des coûts par appel. D'où viennent ces données ? Pour une application unique, vous instrumentez le code directement. À l'échelle d'une organisation exploitant des dizaines d'applications et d'agents connectés à de multiples fournisseurs de modèles, la source la plus propre est la couche par laquelle passe déjà chaque appel : la gateway IA.
Une gateway comme TrueFoundry se positionne en amont de l'ensemble du trafic de modèles et de fournisseurs derrière une API unifiée compatible OpenAI. Comme chaque requête la traverse, elle émet une observabilité par requête : tokens en entrée et sortie, latence, modèle et fournisseur utilisés, et coût, le tout étiqueté par utilisateur, équipe et application. C'est exactement le flux de données qu'une plateforme d'évaluation cherche à ingérer, et il est obtenu sans instrumentation spécifique par application puisque la gateway le produit de façon centralisée.
La gateway exécute également des guardrails en ligne au moment de l'appel (détection de PII, contrôles d'injection de prompt, analyse de secrets), ce qui répond à un besoin différent de l'évaluation offline. Les guardrails bloquent ou signalent une requête ou une réponse défaillante en temps réel ; les évaluations notent la qualité a posteriori sur des datasets et des échantillons de production. Les deux sont nécessaires. Le guardrail stoppe le risque immédiat sur le parcours de la requête ; la plateforme d'évaluation vous indique si la qualité des réponses s'améliore ou se détériore sur plusieurs semaines.
La répartition des rôles est claire : la gateway gère le parcours de la requête (routage, fallback, mise en cache, budgets, guardrails en ligne et émission des traces) ; la plateforme d’évaluation gère la boucle de mesure (datasets, notation offline et online, LLM-as-judge, comparaison d'expérimentations). TrueFoundry fournit la partie gateway et le flux d'observabilité ; une plateforme d'évaluation dédiée choisie dans la liste ci-dessus consomme ces données. Pour les équipes souhaitant standardiser les coûts et la gouvernance sur de nombreux modèles, associer ces deux éléments est plus efficace que d'essayer de forcer un outil à remplir le rôle de l'autre. Notre guide sur les meilleures plateformes d'observabilité IA pour les LLM en 2026 approfondit spécifiquement la partie observabilité.
Considérer le LLM-as-judge comme une vérité absolue. Le juge reste un modèle sujet à ses propres biais et modes de défaillance. Les équipes qui déploient un juge sans l'étalonner par rapport à des annotations humaines finissent par optimiser leur application pour satisfaire un évaluateur mal étalonné, ce qui est pire que l'absence d'évaluation car cela donne une impression de rigueur tout en étant erroné. Mesurez toujours la concordance entre le juge et l'humain au préalable.
Évaluer uniquement la réponse finale d'un agent. Une réponse correcte issue d'une trajectoire défaillante constitue un bug latent. Si vous ne notez jamais les étapes intermédiaires, vous ne remarquerez pas que votre agent parvient à la bonne réponse au prix de trois appels d'outils superflus et d'une recherche documentaire qu'il a ignorée, jusqu me ce qu'un léger changement le fasse échouer sans que vous ne puissiez en comprendre la raison.
Figer le dataset au moment du lancement. Un jeu d'évaluation statique mesure indéfiniment le niveau de difficulté du jour du lancement, tandis que la production évolue. Sans une boucle qui réinjecte continuellement les traces de production défaillantes dans le dataset, votre tableau de bord d'évaluation affichant des indicateurs verts finit par ne plus rien signifier.
Acheter un outil d'évaluation pour résoudre un problème qu'un guardrail devrait traiter. Si votre besoin réel est de « bloquer les PII et les injections de prompts dans le parcours de la requête », il s'agit d'une fonctionnalité de guardrails en ligne au niveau de la gateway, et non d'une suite d'évaluation offline. Inversement, exécuter des datasets offline pour détecter des attaques en temps réel est trop lent. Adaptez l'outil selon que le contrôle s'effectue dans le flux ou a posteriori.
Ignorer la résidence des données jusqu'à la phase d'achats (procurement). Des équipes sélectionnent un outil d'évaluation géré en se basant sur son expérience utilisateur, puis découvrent lors de la revue de sécurité que les prompts de production contenant des données clients ne peuvent pas quitter le VPC. Tranchez la question entre OSS et solution gérée ainsi que le mode de déploiement dès le départ ; cela élimine des options plus rapidement que n'importe quelle fonctionnalité.
L'évaluation est la discipline qui transforme le ressenti « l'IA semble meilleure maintenant » en un chiffre vérifiable. Les plateformes se différencient moins sur leur capacité à effectuer des évaluations (elles le font toutes) que sur leur façon de gérer l'ensemble du cycle de vie : curation de datasets, validation offline, surveillance online, tracing de la trajectoire des agents et LLM-as-judge étalonné. Partez de vos contraintes strictes (résidence des données, frameworks existants, OSS vs géré), évaluez la sélection par rapport à la grille de critères, et exigez une boucle complète plutôt qu'un banc d'essai ponctuel.
Rappelez-vous également que l'évaluation ne fonctionne pas de manière isolée. La gateway placée devant vos modèles produit déjà les traces et les données de coûts dont votre plateforme d'évaluation a besoin, et elle applique dans le flux des requêtes des guardrails que les évaluations offline ne peuvent pas assurer. En associant une plateforme d'évaluation performante à une gateway offrant une observabilité claire par requête et des contrôles en ligne, vous obtenez à la fois le filet de sécurité en temps réel et l'indicateur de qualité à long terme nécessaires au maintien de la fiabilité d'un produit LLM.
Associez vos évaluations à une gateway gouvernée. Réservez une démo.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception





