



novembre 20, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Published: novembre 20, 2026

Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
La plupart des équipes qui évaluent une gateway IA partent de la même crainte : « Si je place un proxy devant chaque appel de modèle, j'ajoute un saut (hop), et ce saut coûte de la latence. » C'est un réflexe compréhensible, mais une mauvaise raison pour se passer d'une gateway. Ce réflexe se trompe sur l'ordre de grandeur. Un appel de modèle vers un LLM de pointe prend de 300 millisecondes pour une complétion courte jusqu'à 20 secondes ou plus pour une réponse de raisonnement longue. Une gateway correctement conçue ajoute seulement entre quelques millisecondes et une faible dizaine de millisecondes de traitement propre. La question n'est jamais « est-ce que la gateway ajoute de la latence » (elle en ajoute, de façon négligeable), mais « puis-je mesurer ce surcoût avec précision, et reste-t-il faible sur les valeurs extrêmes et sous la charge ? »
Le problème est que presque personne n'évalue cela correctement. Les équipes exécutent une boucle de 100 requêtes à travers la gateway, regardent le temps moyen écoulé, le comparent à 100 appels directs, et en concluent quelque chose sur les « performances » qui est en réalité dominé par la variance du fournisseur et le gigotement (jitter) réseau. Le signal qui les intéresse — la contribution propre de la gateway — se retrouve enfoui sous des secondes de temps modèle et n'est jamais isolé.
Cet article présente une méthode neutre vis-à-vis des fournisseurs pour évaluer correctement une gateway IA : quelles métriques comptent, comment isoler le surcoût de la gateway de la latence du fournisseur, comment tester les valeurs extrêmes et la charge, comment gérer le streaming et le cachage, et à quoi ressemble un « bon » résultat. Chaque exemple numérique présent ici est un modèle illustratif, pas un résultat mesuré. Vous devez remplir les tableaux avec les chiffres issus de vos propres exécutions.
Vous souhaitez mesurer le surcoût réel de la gateway sur votre propre trafic ? Réservez une démo.
Une gateway IA se situe sur le chemin de la requête, entre votre application et un ou plusieurs fournisseurs de modèles. Dans le cas de TrueFoundry, il s'agit d'une API unifiée et compatible OpenAI qui gère le routage, le basculement (fallback) et les reessais, le cachage exact et sémantique, les budgets et les limites de débit (rate limits), les garde-fous (guardrails) et l'observabilité par requête. Chacune de ces fonctionnalités effectue un travail, et ce travail prend du temps. Évaluer les performances consiste à attribuer correctement ce temps au bon endroit.
Une requête unique sans streaming dispose d'un budget de latence qui se décompose comme suit :
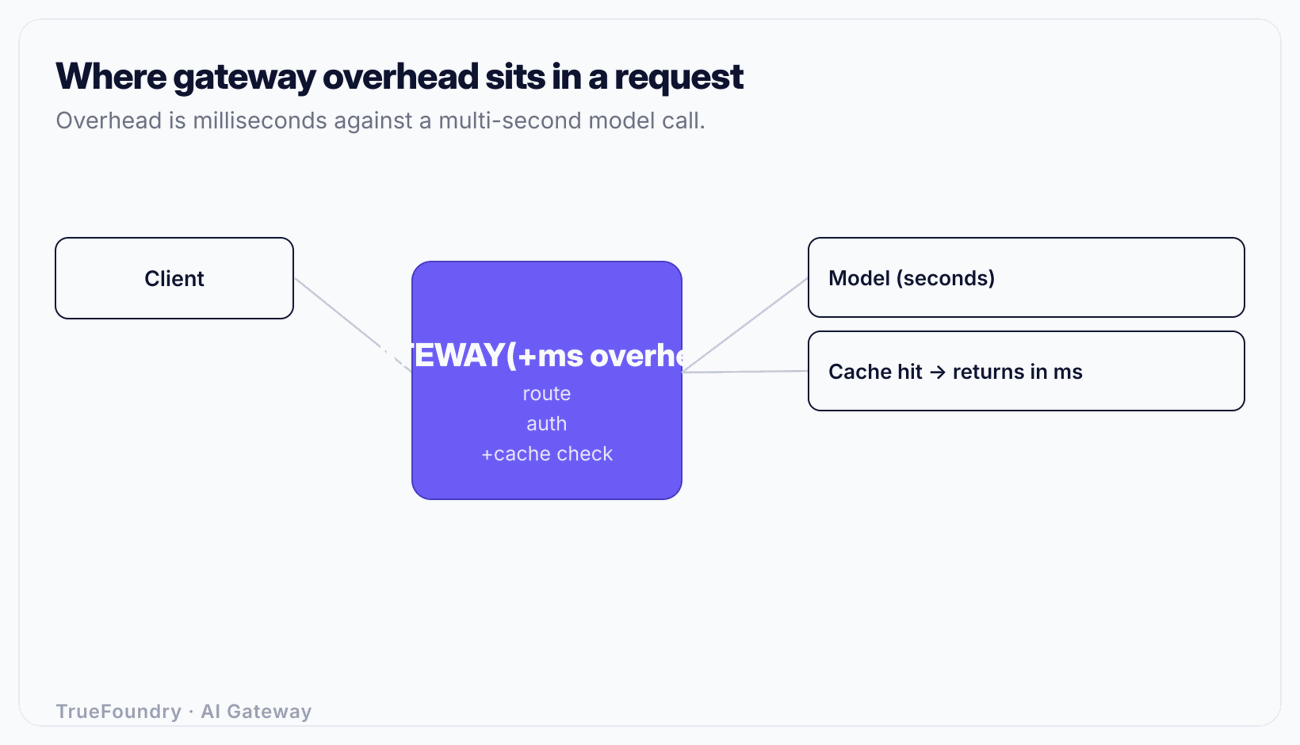
Décomposez le temps total d'une requête en quatre parties :
La métrique clé de benchmark est la latence ajoutée : (2) plus (4), isolée de (1) et (3). Si votre outil de mesure n'indique que le temps de bout en bout, vous mesurez le fournisseur, pas la gateway.
Six chiffres décrivent les performances d'une gateway. Enregistrez les six ; une simple moyenne ne constitue pas un benchmark.
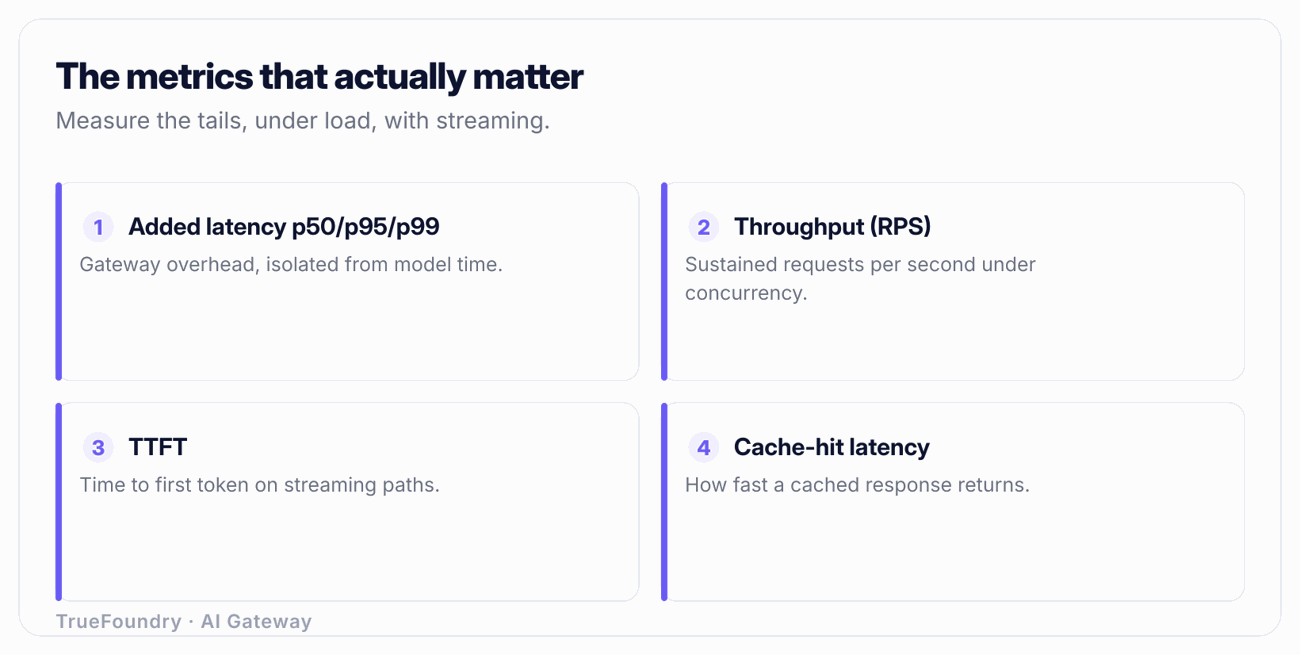
Les deux métriques de valeurs extrêmes méritent une attention particulière. Dans une charge de travail orientée agents, une seule action utilisateur peut se ramifier en 10 à 50 appels de modèle au cours d'une boucle de raisonnement. Si chaque appel a 1 chance sur 100 d'emprunter un chemin p99 lent, une boucle de 30 appels rencontrera ce chemin environ une fois toutes les trois ou quatre actions utilisateur. À l'échelle des agents, les valeurs extrêmes ne sont pas un cas particulier : elles représentent le cas général.
La démarche méthodologique fondamentale repose sur la soustraction. Le piège réside dans le fait que la latence du fournisseur est bruyante, ce qui rend une soustraction naïve tout aussi bruyante.
Option A : requêtes appariées. Pour chaque itération de test, envoyez la même requête directement au fournisseur et via la gateway, dans un intervalle de temps aussi réduit que possible, idéalement de manière entrelacée. Soustrayez le temps direct du temps gateway pour chaque paire. L'appariement permet de compenser les variations de charge du fournisseur pendant le test, car les deux moitiés d'une paire subissent approximativement les mêmes conditions chez le fournisseur. Accumulez des milliers de paires, puis calculez les centiles de la différence. Cela mesure la latence ajoutée réelle, y compris l'appel en amont de la gateway, mais reste sensible aux variations (jitter) du fournisseur entre les deux moitiés de la paire.
Option B : chronométrage interne à la gateway. Une bonne gateway enregistre son propre temps de traitement par requête : l'intervalle entre l'acceptation de la requête et l'envoi de l'appel en amont, plus le travail côté réponse. L'observabilité par requête de TrueFoundry expose la latence décomposée de cette façon, étiquetée par utilisateur, équipe et modèle. Cela vous fournit directement le surcoût, sans soustraction ni bruit du fournisseur, et c'est le chiffre auquel vous devez vous fier lorsque vous le possédez. Validez-le une fois par rapport à des mesures de requêtes appariées, puis appuyez-vous sur la métrique interne pour le suivi continu.
Option C : simuler (mocker) le fournisseur. Pointez la gateway vers un stub local qui renvoie une réponse préenregistrée avec un délai fixe et connu (par exemple 200 ms). Le temps fournisseur devient alors une constante que vous avez choisie, et tout ce qui dépasse cette valeur représente le surcoût de la gateway plus le réseau. C'est la méthode la plus propre pour solliciter les chemins de code propres à la gateway à un RPS élevé sans payer ni subir de limites de débit de la part d'un vrai fournisseur, et c'est l'outil adapté pour identifier le point d'inflexion du débit. Cela ne reflète pas le comportement d'un vrai fournisseur, utilisez-le donc pour le surcoût et le débit, pas pour le réalisme de bout en bout.
Utilisez les trois options. L'Option C permet de trouver le plafond de débit, l'Option A valide la latence ajoutée en conditions réelles, et l'Option B vous donne le chiffre que vous suivrez en production. Pour en savoir plus sur le positionnement de la gateway par rapport à votre application et sur la manière dont cet emplacement régit la latence, consultez control plane vs data plane ainsi que le cadre plus large dans comment choisir une gateway IA.
Un benchmark exécuté avec une concurrence de 1 vous indique le niveau plancher, mais ne vous apprend rien sur la production. Les gateways réelles traitent des centaines ou des milliers de requêtes simultanées en cours d'exécution, et le comportement intéressant réside dans la manière dont le surcoût se dégrade à mesure que la concurrence augmente.
Concevez le test de charge sous forme de rampe. Commencez à faible concurrence, maintenez le palier, augmentez, maintenez, et poursuivez les paliers jusqu'à ce que la latence ajoutée p95 dépasse votre seuil. À chaque palier, enregistrez la latence ajoutée p50, p95, p99 et le RPS atteint. Le résultat est une courbe, pas un point fixe. Trois profils sont fréquents :
Deux détails de génération de charge modifient les chiffres plus que ce à quoi les gens s'attendent. Premièrement, utilisez un modèle de charge en boucle ouverte où les requêtes arrivent selon un calendrier défini, indépendamment du fait que les précédentes soient terminées ou non, et non un modèle en boucle fermée où un pool fixe de workers attend chaque réponse. Le test en boucle fermée masque l'accumulation de file d'attente car les réponses lentes régulent la charge offerte, ce qui flatte vos chiffres de tail latency. Deuxièmement, générez la charge à partir d'un nombre suffisant de connexions clients pour que le client ne soit pas lui-même le goulot d'étranglement ; un seul processus client avec un petit pool de connexions signalera une latence de « gateway » qui est en réalité une mise en file d'attente côté client.
Pour les charges de travail de chat et d'agents, la plupart des réponses sont envoyées en streaming. Le streaming inverse la métrique qui compte : l'utilisateur perçoit le time to first token, et le temps total n'a presque aucun impact sur la vitesse perçue.
Une gateway correctement conçue transfère les chunks transmis en streaming au fur et à mesure qu'ils arrivent, en n'ajoutant qu'un faible overhead constant par chunk. Une gateway mal conçue met en mémoire tampon l'intégralité de la réponse en amont, applique le traitement de la réponse, et commence seulement ensuite le streaming vers le client, ce qui transforme une réponse en streaming de 3 secondes en une attente de 3 secondes suivie d'un transfert instantané. Le benchmark de TTFT détecte cela immédiatement : mesurez l'intervalle entre l'envoi de la requête et la réception du premier octet du premier chunk de contenu, à la fois via la gateway et en accès direct. L'overhead de TTFT de la gateway doit être proche de son overhead en mode non-streaming, c'est-à-dire quelques millisecondes, et non des centaines.
Les guardrails de réponse compliquent cela en toute honnêteté. Si vous exécutez un guardrail de sortie qui doit inspecter la réponse complète (certains contrôles de PII ou de politiques), vous ne pouvez pas effectuer de streaming et analyser le texte complet en même temps sans faire un choix d'architecture : streamer de manière optimiste et rétracter, ou mettre en mémoire tampon et retarder. Évaluez les deux modes si vous utilisez des guardrails de sortie, et indiquez le coût en TTFT de chacun. Ne laissez pas un fournisseur vous citer un TTFT de streaming mesuré avec les guardrails désactivés pour ensuite les activer en production.
Découvrez comment TrueFoundry maintient la latence ajoutée à quelques millisecondes seulement. Réservez une démo.
Vous n'avez pas besoin de choisir une gateway en fonction de son langage d'implémentation, mais vous devez comprendre comment le langage et l'architecture façonnent la courbe de débit, car cela vous indique sur quoi insister lors des tests de charge.
Une gateway conçue sur une boucle d'événements mono-thread gère une concurrence énorme pour les tâches liées aux E/S (attente du fournisseur), mais sérialise toute tâche liée au CPU sur le hot path. Si le parsing de requête, le comptage de tokens ou l'expression régulière de guardrail s'exécutent en ligne, ces étapes entrent en compétition pour l'unique thread et se traduisent par une hausse du p99 sous charge. Un runtime doté d'un global interpreter lock a une contrainte similaire : même avec un pool de threads, les sections liées au CPU ne s'exécutent pas réellement en parallèle au sein d'un même processus, vous devez donc effectuer une mise à l'échelle en exécutant plus de processus, et votre benchmark doit tenir compte de la duplication de la mémoire par processus et du pool de connexions. Les runtimes compilés et multithreadés (Go, Rust) parallélisent le travail CPU sur plusieurs cœurs au sein d'un seul processus, ce qui repousse généralement le point d'inflexion du débit plus haut par instance, au prix d'un profil opérationnel différent.
À retenir en pratique : il ne s'agit pas de dire « Go est meilleur que Python ». Il s'agit de : identifier ce qui s'exécute sur le hot path et l'évaluer sous concurrence. Le comptage de tokens sur un contexte de 100 000 tokens, l'exécution d'un classifieur d'injection de prompt ou le calcul d'un embedding pour le cache sémantique sont tous des travaux CPU. S'ils s'exécutent en ligne, ils feront fléchir votre courbe de tail latency. S'ils s'exécutent en dehors du hot path ou derrière un fast path, ce ne sera pas le cas. Testez avec des tailles de prompt représentatives, et non avec des exemples légers de 10 tokens, car la longueur du contexte détermine le coût CPU de ces étapes précises. Le rôle de la gateway en tant qu'LLM proxy est de maintenir ce travail par requête à un niveau faible et prévisible.
Le seul scénario qui renverse complètement l'idée selon laquelle « les gateways ajoutent de la latence » est le caching, et c'est le scénario que les équipes oublient d'évaluer.
TrueFoundry prend en charge à la fois le caching exact (une requête identique renvoie la réponse stockée) et le semantic caching (une requête dont l'embedding respecte un seuil de similitude cosinus par rapport à une requête antérieure renvoie cette réponse). En cas de hit, l'appel au modèle n'a jamais lieu. La latence de la requête passe de plusieurs centaines de millisecondes ou secondes pour le modèle au temps de recherche propre à la gateway : le calcul de l'embedding (pour le cache sémantique) plus une recherche vectorielle ou de clé, généralement de l'ordre de quelques millisecondes à quelques dizaines de millisecondes tout au plus.
Évaluez cela comme un scénario à part entière :
Un exemple concret, à titre d'illustration uniquement : supposez qu'un appel direct au modèle pour votre charge de travail s'exécute en 1 200 ms au p50. Un exact cache hit peut répondre en 6 ms, et un hit sémantique en 22 ms (dominé par l'étape d'embedding). Avec un taux de hit de 40 %, le p50 combiné est d'environ 0,6 × 1 200 + 0,4 × 15 ≈ 726 ms, soit une réduction de 40 % de la latence typique et une réduction de 40 % des dépenses en tokens, toutes deux produites par la gateway. Rapportée en moyenne de bout en bout, la gateway semble considérablement plus rapide que les appels directs. C'est pourquoi « la gateway ajoute de la latence » n'est pas le bon constat : sur le trafic en cache, elle réduit la latence. Complétez avec vos propres chiffres ; la structure reste valable quelles que soient les spécificités.
Exécutez cette liste avant de faire confiance à toute affirmation sur la latence d'une gateway, y compris les vôtres.
Le tableau ci-dessous est un modèle à remplir avec vos propres exécutions. Les chiffres sont des espaces réservés qui montrent la forme et l'ordre de grandeur attendus, et non des résultats mesurés sur un produit spécifique. Remplacez chaque cellule par des valeurs mesurées sur vos modèles, vos régions et votre trafic.
Considérer une ligne seule de manière isolée n'a aucun sens. La valeur réside dans la comparaison : cache-hit par rapport au miss, streaming par rapport au non-streaming, faible charge par rapport au point d'inflexion.
Elles rapportent la latence de bout en bout et l'appellent performance de la gateway. Le modèle domine le temps total réel, donc le « benchmark » mesure principalement le fournisseur et le réseau. Isolez l'overhead, sinon vous n'aurez rien mesuré sur la gateway.
Elles évaluent la moyenne et déploient sur cette base. Le p50 semble excellent et le p99 provoque des timeouts sur leurs boucles d'agents en production. Lors d'un fan-out d'agents, la tail latency constitue l'expérience utilisateur. Rapportez toujours le p95 et le p99.
Elles testent avec une concurrence de 1. L'overhead sur une seule requête en cours n'indique rien sur le comportement à 500. La courbe de dégradation, et son point d'inflexion, est tout l'intérêt de la démarche. Augmentez la charge.
Elles oublient d'évaluer le cache. Le caching est la seule fonctionnalité qui rend la gateway plus rapide que les appels directs, et c'est le scénario le plus souvent ignoré. Mesurez la latence des hits et la latence combinée à votre taux de hit réel, sinon vous sous-estimerez la valeur de la gateway de l'ensemble du bénéfice du caching.
Elles font confiance au chiffre d'un fournisseur sans le reproduire. Une valeur de latence sur une présentation a été mesurée sur le modèle, la région, la taille de prompt et la configuration de guardrails de quelqu'un d'autre. Tant que vous ne la reproduisez pas sur votre trafic, cela reste du marketing. Exécutez la checklist vous-même.
La crainte qu'une gateway IA n'ajoute une latence inacceptable persiste parce que les équipes ne mesurent pas la bonne chose. Le temps total réel de bout en bout est dominé par le modèle, ce qui ne vous apprend presque rien sur la gateway. Isolez l'overhead, rapportez-le sur la tail latency, et la situation s'inverse : une gateway performante ajoute quelques millisecondes à une requête qui prend déjà plusieurs secondes, et sur le trafic en cache, elle rend la requête nettement plus rapide tout en réduisant la consommation de tokens.
Évaluez-la vous-même. Utilisez la checklist, remplissez le modèle avec vos propres exécutions, augmentez la concurrence pour trouver le point d'inflexion, et mesurez la latence du p99 et des cache-hits comme des métriques de premier ordre plutôt que comme des réflexions après coup. Une gateway qui passe ce test vous apporte le routage, le fallback, le caching, les budgets, les guardrails et l'observabilité par requête pour un coût de latence négligeable par rapport au modèle, et la seule façon de le prouver est de le mesurer sur votre propre trafic.
Évaluez les performances d'une gateway qui devient plus rapide lorsque le caching est activé. Réservez une démo.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception





