Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.
Los volúmenes proporcionan almacenamiento persistente a los contenedores dentro de los pods para que puedan leer y escribir datos en un disco central a través de múltiples pods. Son especialmente útiles en machine learning cuando se necesita almacenar y acceder a datos, modelos y otros artefactos requeridos para tareas de entrenamiento, servido e inferencia.
En este blog, analizaremos cómo utilizar los volúmenes y las opciones disponibles en cada nube.
¿Cuándo utilizar volúmenes de Kubernetes?
Algunos casos de uso en los que los volúmenes resultan ser muy útiles:
Compartir datos de entrenamiento: Es posible que varios científicos de datos estén entrenando con los mismos datos, o que se estén ejecutando múltiples experimentos en paralelo sobre el mismo conjunto de datos. La forma ingenua sería duplicar los datos para cada científico de datos; sin embargo, esto terminará costando mucho más. Una forma más eficiente es almacenar los datos de entrenamiento en un volumen y montarlo en los notebooks de los diferentes científicos de datos.
Almacenamiento de modelos: Si alojamos modelos como API en tiempo real, habrá múltiples réplicas del servidor de API para gestionar el tráfico. En este caso, cada réplica debe descargar el modelo desde el registro de modelos (por ejemplo, S3) al disco local. Si cada réplica hace esto repetidamente, tardará más tiempo en iniciarse y también incurrirá en más costes de acceso a S3. Utilizando volúmenes, puede almacenar sus modelos entrenados externamente y montarlos en el servidor de inferencia. No es necesario descargar el modelo; el servidor de API puede encontrar el modelo en el disco en la ruta montada.
Intercambio de artefactos: Podemos tener un caso de uso en el que la salida de una etapa del pipeline necesite ser consumida por la siguiente etapa. Por ejemplo, después de ajustar un modelo (fine-tuning), es posible que necesitemos alojarlo como una API solo para experimentación. Aunque podemos escribir el modelo en S3 y luego volver a descargarlo desde S3, el proceso de carga/descarga del modelo llevará mucho tiempo. En su lugar, para una experimentación más rápida, el trabajo de ajuste fino simplemente puede escribir el modelo en un volumen y el servicio de inferencia puede montar el volumen con el modelo.
Puntos de control (Checkpointing): Durante el entrenamiento de modelos de machine learning, es común guardar puntos de control periódicamente para reanudar el entrenamiento en caso de fallo o para realizar un ajuste fino. Los volúmenes se pueden utilizar para almacenar estos archivos de puntos de control, garantizando que el progreso del entrenamiento no se pierda cuando un trabajo se reinicia tras un fallo. Esto también le permite ejecutar el entrenamiento en instancias spot, ahorrando muchos costes.
Ahora, hablando de casos de uso de ML: en la mayoría de las situaciones, los ingenieros de ML reciben los datos en buckets de S3, buckets de GCS o Azure Blob Storage. Si desean entrenar modelos con estos datos, necesitan descargarlos en su carga de trabajo de entrenamiento (trabajo desplegado o notebook) o montar el contenido de su bucket directamente en la carga de trabajo.
¿Cuándo usar un volumen frente a almacenamiento de blobs como S3 / GCS / Azure Container?
Elegir cuándo optar por almacenamiento de blobs como S3 en comparación con un volumen es importante desde la perspectiva del rendimiento, la fiabilidad y el coste.
Rendimiento
En la mayoría de los casos, leer datos desde S3 será más lento que leerlos directamente desde un volumen. Por lo tanto, si la velocidad de carga es crucial, un volumen es la opción correcta. Un excelente ejemplo de esto es la descarga y carga del modelo en tiempo de inferencia en múltiples réplicas del servicio. Un volumen es una mejor opción, ya que no incurre en el tiempo de descargar el modelo repetidamente y puede cargar el modelo en memoria desde el volumen mucho más rápido.
Fiabilidad
Los almacenamientos de blobs como S3/GCS/ACS generalmente serán más fiables que los volúmenes. Por lo tanto, lo ideal es respaldar siempre los datos sin procesar en uno de los almacenamientos de blobs y usar volúmenes solo para datos intermedios. También se debe guardar permanentemente una copia de los modelos en S3.
Coste
El acceso a volúmenes como EFS es un poco más barato que usar S3; por lo tanto, si lee los mismos datos con bastante frecuencia, puede ser útil almacenarlos en un volumen. Si lee o escribe de forma muy infrecuente, S3 debería ser suficiente.
Restricciones de acceso
Idealmente, solo las cargas de trabajo dentro de la misma región y clúster deberían acceder a los datos de los volúmenes. S3 está diseñado para ser accedido globalmente y a través de entornos cloud, por lo que los volúmenes no son una gran opción si desea acceder a los datos en una región o proveedor de nube diferente.
Modos de aprovisionamiento de volúmenes
Para admitir todos los tipos de volúmenes, TrueFoundry ofrece dos modos de aprovisionamiento de volúmenes orientados a diferentes casos de uso:
Dinámico
Son volúmenes que se crean dinámicamente y se aprovisionan a medida que despliega un volumen en TrueFoundry. Por ejemplo, EBS, EFS en AWS y AzureFiles en Azure se pueden aprovisionar dinámicamente en TrueFoundry.
Estático
Son volúmenes para los cuales ya existe un volumen de almacenamiento y queremos montar los datos de ese volumen de almacenamiento en nuestro servicio/trabajo. Los ejemplos incluyen el montaje de buckets de S3 y buckets de GCS en las cargas de trabajo desplegadas en la plataforma.
A continuación, comprendamos cómo funcionan estos dos modos y qué opciones están disponibles en cada nube:
Volúmenes aprovisionados dinámicamente
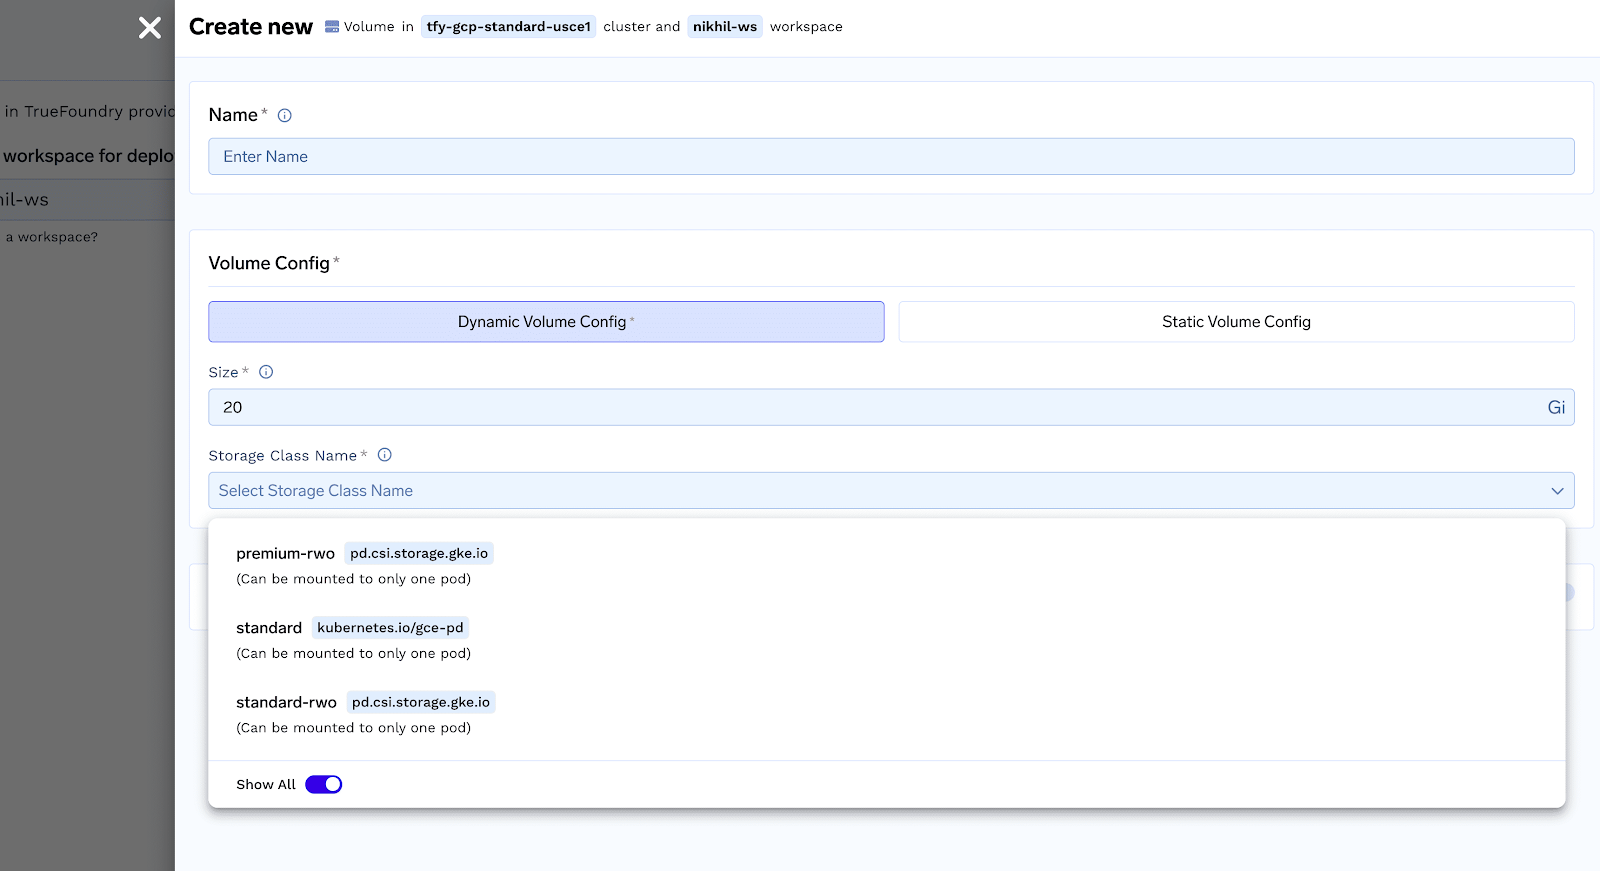
Los volúmenes aprovisionados dinámicamente requieren que especifique una clase de almacenamiento (storage class). Un volumen se aprovisiona dinámicamente según la clase de almacenamiento y el tamaño proporcionados por el usuario.
Comprendamos qué es una clase de almacenamiento y las diferentes clases de almacenamiento disponibles en cada nube:
Clases de almacenamiento (Storage Classes)
Las clases de almacenamiento proporcionan una forma de especificar el tipo de almacenamiento que se debe aprovisionar para un volumen. Estas clases de almacenamiento difieren en sus características, como el rendimiento, la durabilidad y el coste. Puede seleccionar la clase de almacenamiento adecuada para su volumen desde el menú desplegable Storage Class mientras lo crea.
Las clases de almacenamiento específicas disponibles dependerán del proveedor de nube que esté utilizando y de lo que haya preconfigurado el equipo de infraestructura. Normalmente verá las siguientes opciones en las clases de almacenamiento según el proveedor de nube:
Clases de almacenamiento en AWS
Nombre de almacenamiento en TrueFoundry
Nombre de almacenamiento del proveedor cloud
Storage Class
Descripción
efs-sc
Elastic File System (EFS)
efs.csi.aws.com
Un sistema de archivos elástico totalmente gestionado, escalable y altamente durable que ofrece alta disponibilidad, escalado automático y uso compartido de archivos general rentable. Es adecuado para cargas de trabajo con necesidades de capacidad variables.
Clases de almacenamiento en GCP
Nombre de almacenamiento en TrueFoundry
Nombre de almacenamiento del proveedor cloud
Storage Class
Descripción
standard-rwx
Google Basic HDD Filestore
filestore.csi.storage.gke.io
Una solución de almacenamiento de archivos escalable y rentable, ideal para almacenamiento de archivos de uso general y cargas de trabajo sensibles al coste. Ofrece un menor coste, pero también un menor rendimiento debido a su naturaleza basada en HDD.
premium-rwx
Google Premium Filestore
filestore.csi.storage.gke.io
Proporciona un mayor rendimiento y rendimiento de procesamiento (throughput) en comparación con Basic HDD, lo que lo hace adecuado para operaciones de archivo intensivas en I/O y cargas de trabajo exigentes. Está basado en SSD, ofreciendo un mayor rendimiento a un coste más alto.
enterprise-rwx
Google Enterprise Filestore
filestore.csi.storage.gke.io
Ofrece el máximo rendimiento, capacidad de procesamiento, funciones avanzadas, soporte multizona y alta disponibilidad, lo que lo hace ideal para cargas de trabajo de misión crítica y aplicaciones con estrictos requisitos de disponibilidad. Tiene el coste más elevado.
Clases de almacenamiento en Azure
Nombre de almacenamiento en TrueFoundry
Nombre de almacenamiento del proveedor cloud
Storage Class
Descripción
azurefile
Azure File Storage (Standard)
file.csi.azure.com
Utiliza almacenamiento Azure Standard para crear recursos compartidos de archivos para el uso compartido general a través de VM o contenedores, incluidas aplicaciones de Windows. Ofrece un rendimiento rentable.
azurefile-premium
Azure File Storage (Premium)
file.csi.azure.com
Utiliza almacenamiento Azure Premium para un mayor rendimiento, lo que lo hace adecuado para operaciones de archivo intensivas en I/O.
azurefile-csi
Azure File Storage (StandardCSI)
file.csi.azure.com
Aprovecha el almacenamiento Azure Standard con CSI para aprovisionamiento dinámico, ofreciendo potencialmente un mejor rendimiento y características de CSI.
azurefile-csi-premium
Azure File Storage (PremiumCSI)
file.csi.azure.com
Combina almacenamiento Azure Premium con CSI para aprovisionamiento dinámico y operaciones de archivo de alto rendimiento.
azureblob-nfs-premium
Azure Blob Storage (NFS Premium)
blob.csi.azure.com
Utiliza almacenamiento Azure Premium con el protocolo NFS v3 para acceder a grandes cantidades de datos no estructurados y almacenamiento de objetos, atendiendo a cargas de trabajo exigentes con acceso NFS.
azureblob-fuse-premium
Azure Blob Storage (Fuse Premium)
blob.csi.azure.com
Utiliza almacenamiento Azure Premium con BlobFuse para acceder a grandes cantidades de datos no estructurados y almacenamiento de objetos, adecuado para cargas de trabajo que requieren acceso a través de BlobFuse.
Volúmenes aprovisionados estáticamente
Los volúmenes aprovisionados estáticamente le permiten montar lo siguiente como volumen:
Bucket de GCS
Bucket de S3
EFS existente
Cualquier volumen general en Kubernetes
Para utilizar volúmenes aprovisionados estáticamente, debe crear un “PersistentVolume” que haga referencia a su almacenamiento (S3/GCS, etc.). Esto requerirá instalar los controladores CSI necesarios en el clúster y/o configurar las serviceaccounts pertinentes para los permisos. En la siguiente sección explicaremos cómo crear volúmenes aprovisionados estáticamente.
Montar un bucket de GCS como volumen
Para montar un bucket de GCS como volumen en TrueFoundry, debe seguir estos pasos. Puede consultar este documento para obtener más detalles:
Crear un bucket de GCS
Cree un bucket de GCS y asegúrese de lo siguiente:
Debe ser de región única (multirregión funcionará, pero la velocidad será menor y los costes mayores)
La región debe ser la misma que la de su clúster de Kubernetes
Crear una cuenta de servicio (Service Account) y otorgar los permisos correspondientes
Debe ejecutar el siguiente script. Este realiza lo siguiente:
Habilita el controlador GCS Fuse Driver en el clúster
Crea la política IAM para acceder a su bucket
Crea la service-account de K8s y le añade la política
Habilita la vinculación de roles (role-binding) de la cuenta de servicio al namespace deseado de K8s.
Crear la Service-Account en el Workspace desde la interfaz de usuario de TrueFoundry
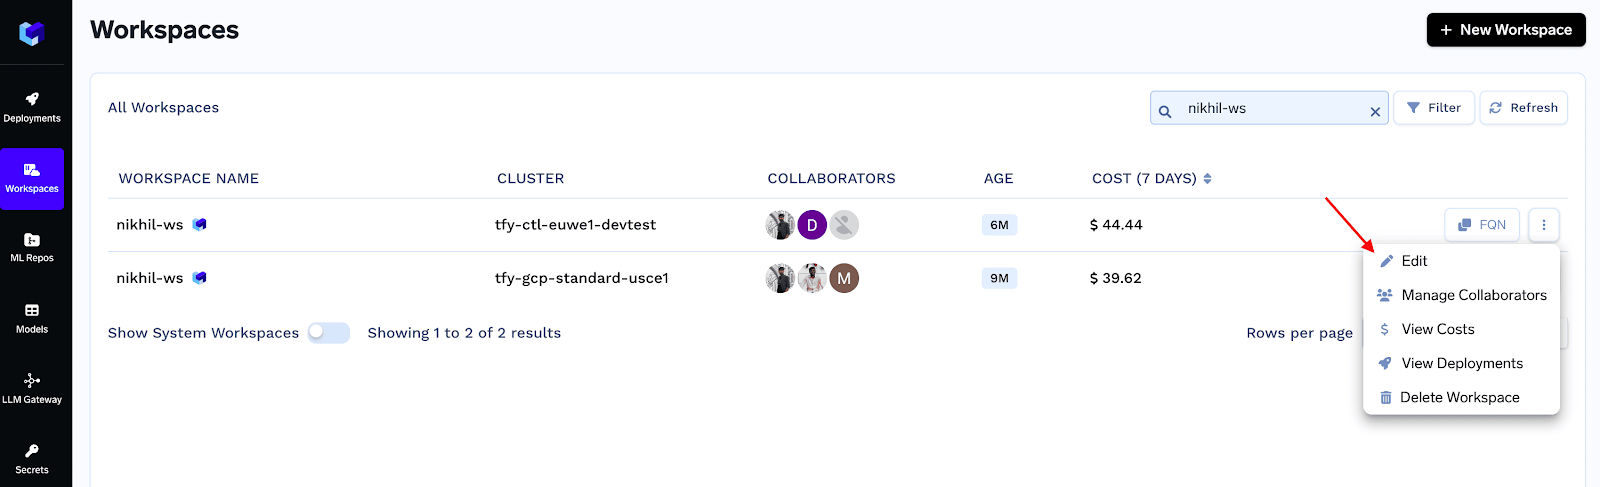
Ahora necesitamos crear una cuenta de servicio en TrueFoundry en el mismo workspace con el nombre TARGET_NAMESPACE, y la cuenta de servicio debe tener el nombre GCP_SA_NAME.
Vaya a Workspaces -> Elija su Workspace y haga clic en los tres puntos de la derecha y seleccione Edit:
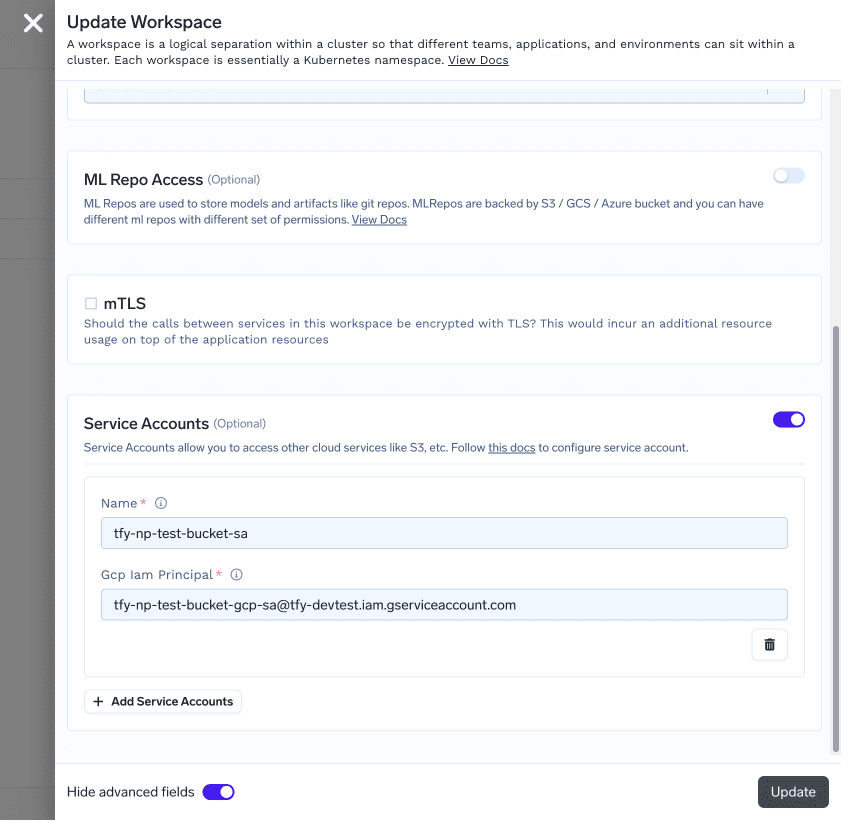
Abra Advanced Options desde la parte inferior izquierda del formulario y complete la sección Serviceaccount :
Nota
El nombre de la cuenta de servicio y el workspace deben ser exactamente los mismos que en el paso anterior.
Crear un objeto PersistentVolume
Cree un objeto de volumen persistente con el siguiente paso (ejecutando un kubectl apply).
Para montar un bucket de S3 como volumen en TrueFoundry, debe seguir estos pasos:
Configurar políticas IAM y roles correspondientes
Siga este documento de AWS para configurar el punto de montaje de S3 en un clúster de EKS.
Esto le guiará para hacer lo siguiente:
Crear una política IAM para otorgar permisos al punto de montaje para acceder al bucket de S3
Crear un rol IAM.
Instalar el controlador CSI de mountpoint para Amazon S3 y adjuntar el rol creado anteriormente.
Crear un PersistentVolume en el clúster de Kubernetes
Cree un PV con la siguiente especificación (ejecutando un kubectl apply):
YAML
apiVersion: v1
kind: PersistentVolume
metadata:
  name:
spec:
  capacity:
    storage: 100Gi
  csi:
    driver: s3.csi.aws.com
    volumeHandle: s3-csi-driver-volume # must be unique
    volumeAttributes:
      bucketName:
  accessModes:
    - ReadWriteMany
  persistentVolumeReclaimPolicy: Retain
  storageClassName: s3-test # put any value here
  mountOptions:
    - allow-delete
    - region
    - allow-other
    - uid=1000
  volumeMode: Filesystem
Montar un EFS existente como volumen
Para montar un EFS existente como volumen en TrueFoundry, debe seguir estos pasos:
Instalar el controlador EFS CSI en su clúster
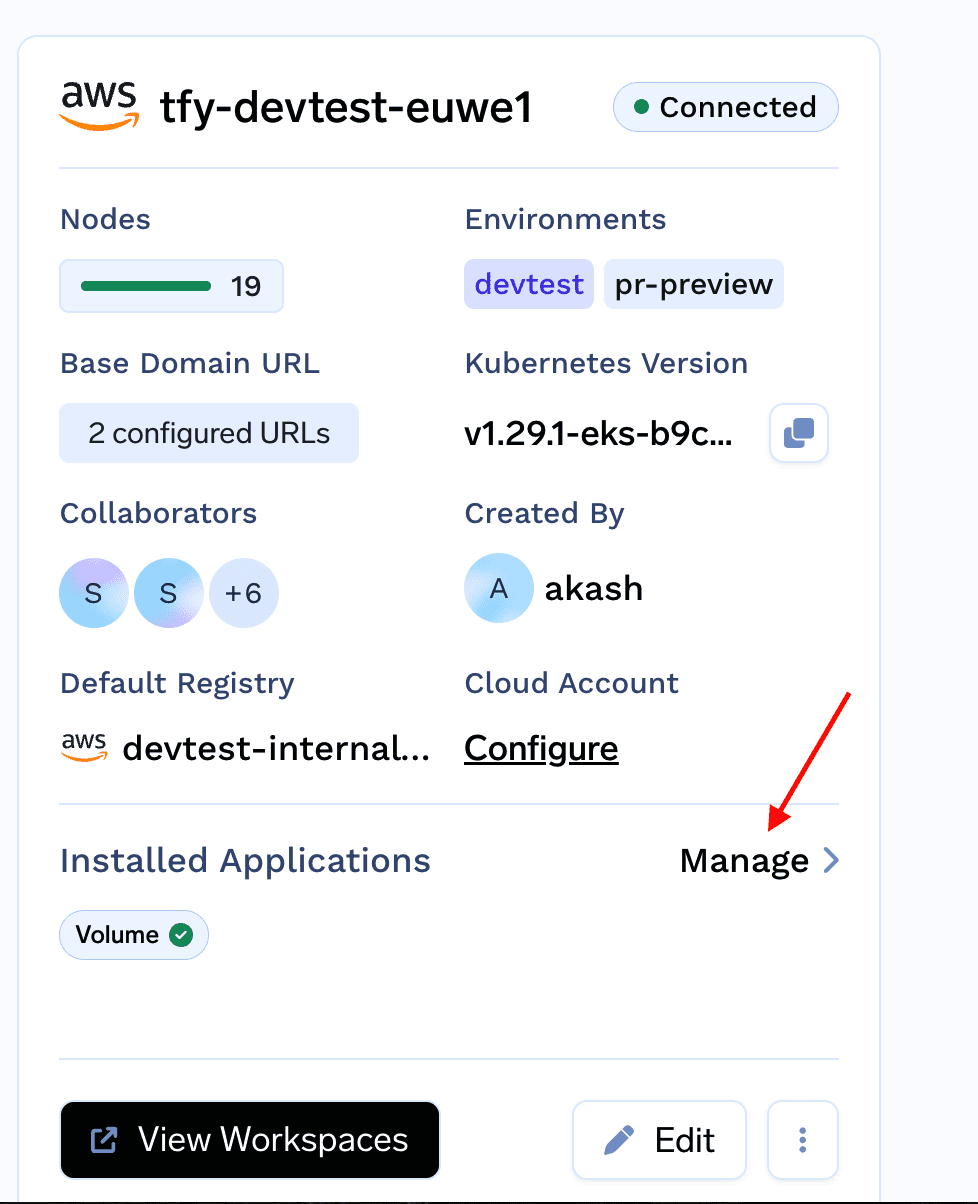
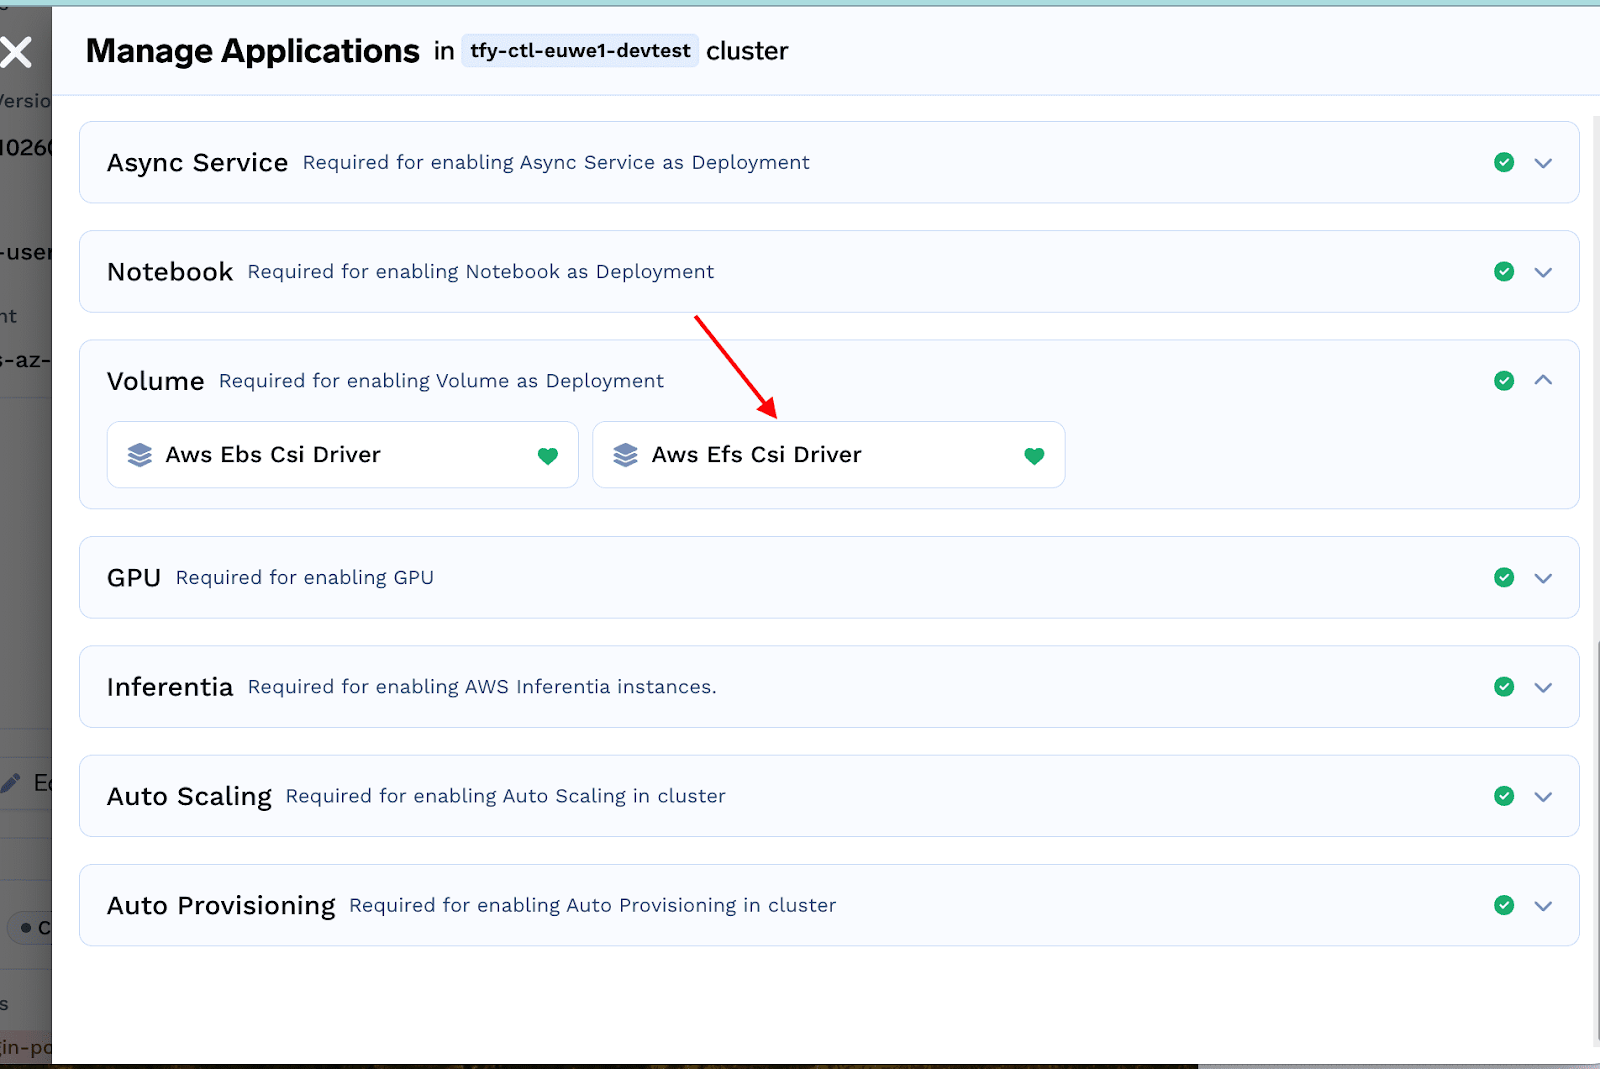
Para instalar el controlador EFS CSI en su clúster, vaya a la interfaz de TrueFoundry -> Clusters-> Installed Applications-> Manage
En la sección Volumes, haga clic en install AWS EFS CSI driver y luego en Install.
Crear un punto de acceso (Access Point) para su EFS
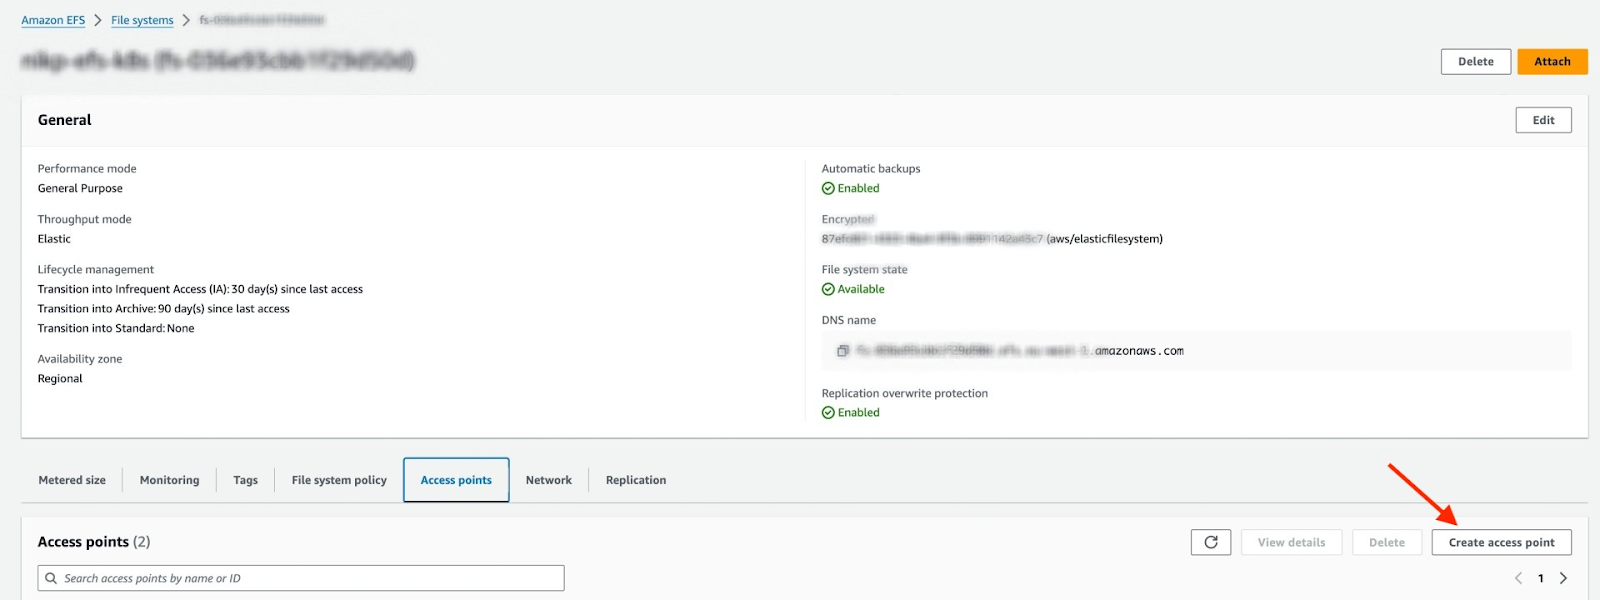
Localice su EFS en la consola de AWS y ábralo. Asegúrese de que el EFS y el clúster de K8S estén en la misma VPC. Haga clic en "Create access point"
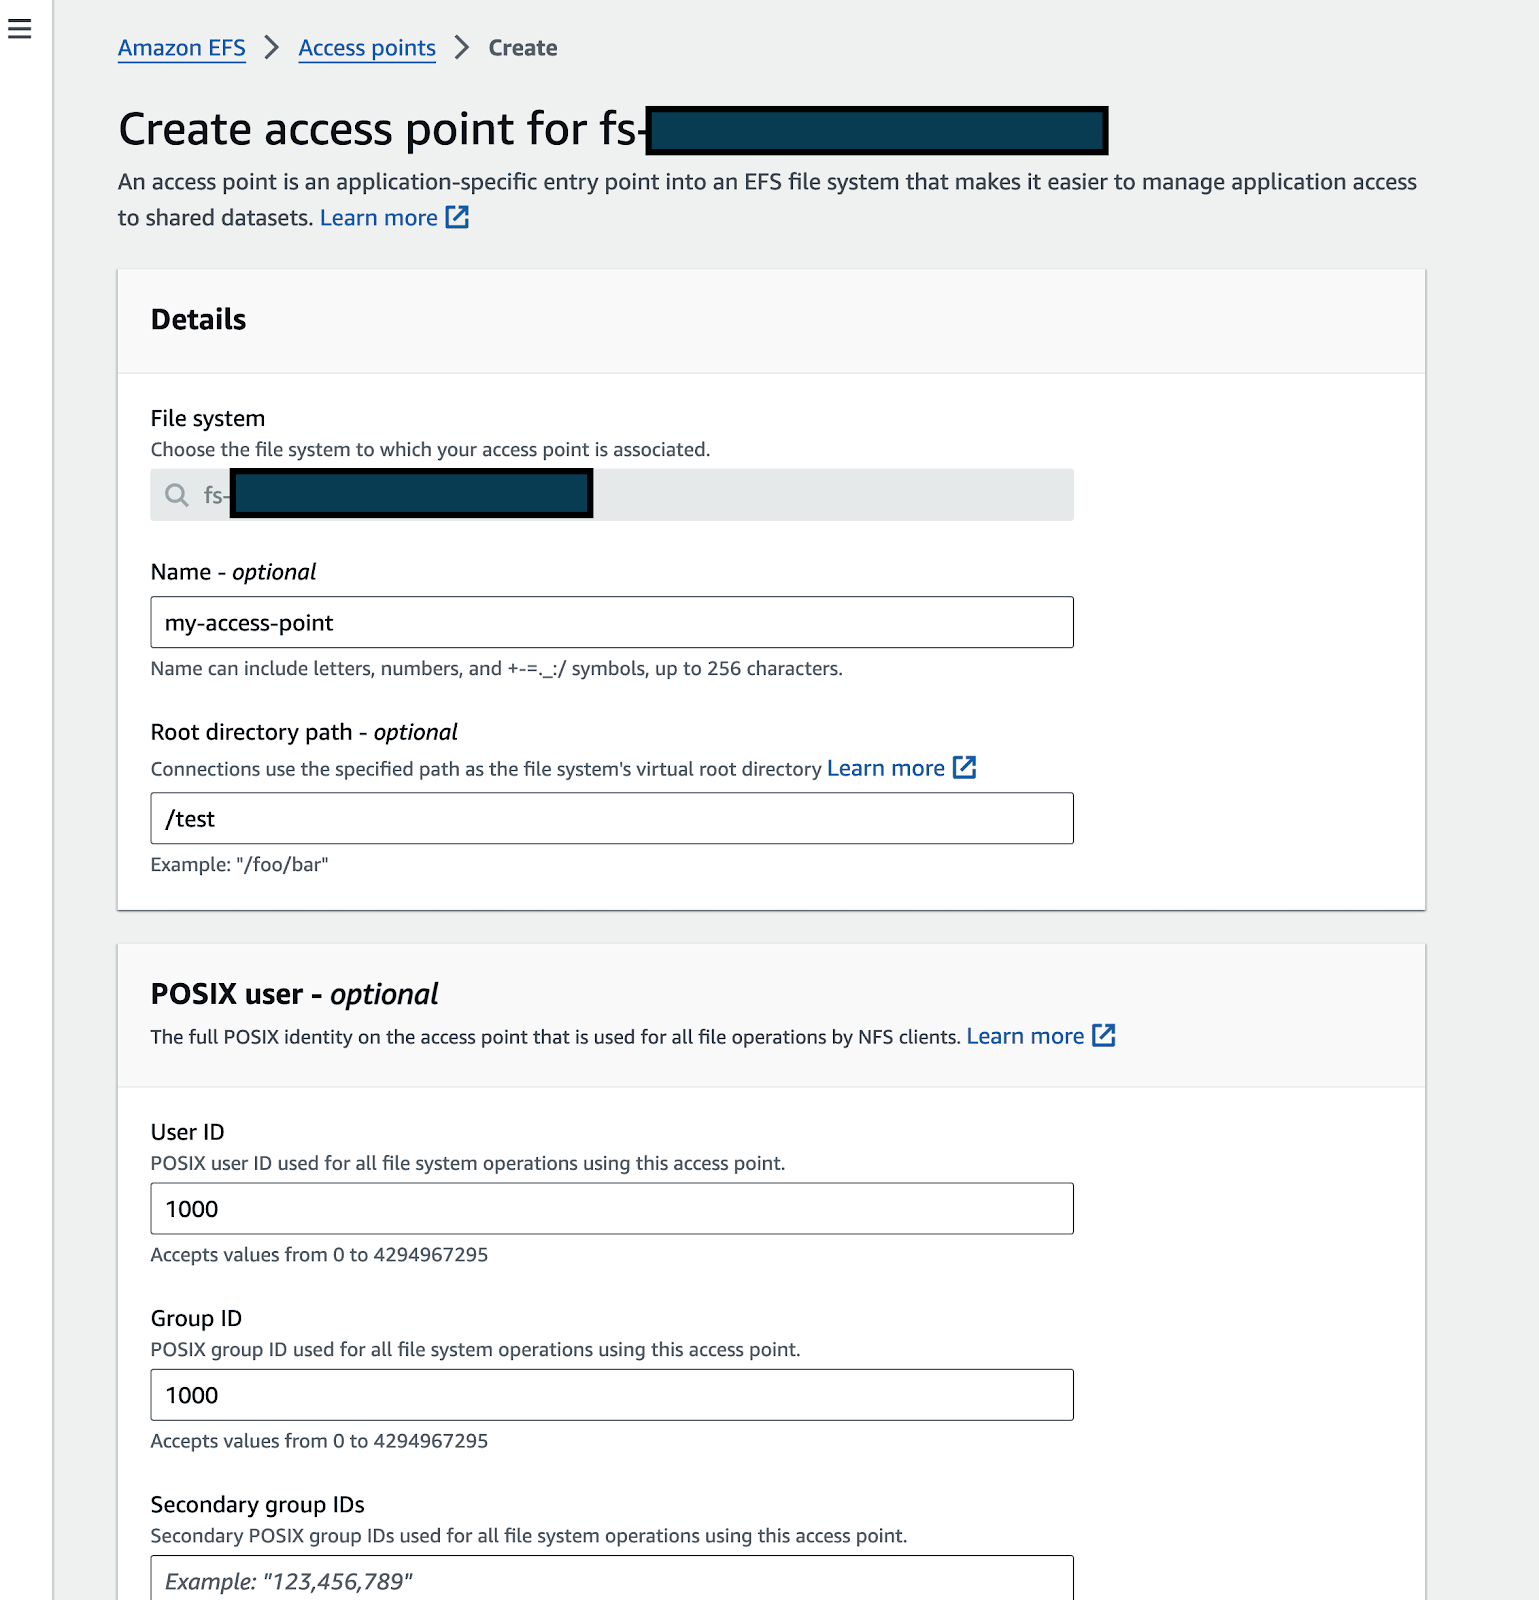
Introduzca los detalles como el nombre y la ruta del directorio raíz (Root directory path) (asegúrese de completar la sección de permisos de creación del directorio raíz; puede poner UID:1000 GID:1000 si desea adjuntarlo al notebook)
Haga clic en crear.
Crear un PersistentVolume en el clúster
Cree un PV con la siguiente especificación (ejecutando un kubectl apply):
YAML
apiVersion: v1
kind: PersistentVolume
metadata:
  name:
spec:
  capacity:
    storage: 5Gi # this number doesn't matter for EFS, any number will work
  csi:
    driver: efs.csi.aws.com
    volumeHandle: :: # e.g. fs-036e93cbb1fabcdef::fsap-0923ac354cqwerty
  accessModes:
    - ReadWriteMany
  persistentVolumeReclaimPolicy: Retain
  storageClassName: efs-sc
  volumeMode: Filesystem
Crear un volumen en TrueFoundry
Siga esta sección para crear un volumen en TrueFoundry
Uso de volúmenes en TrueFoundry
Con las guías anteriores, puede aprovisionar fácilmente volúmenes o utilizar contenedores de almacenamiento existentes como volúmenes. Ahora estos volúmenes se pueden montar en cualquier carga de trabajo en Kubernetes. Si está utilizando esto, puede montar fácilmente su volumen en cualquier carga de trabajo en TrueFoundry. Puede montarlo fácilmente en un servicio o de forma similar en cualquier carga de trabajo desplegada en TrueFoundry. También puede habilitar un explorador de archivos para navegar por los contenidos del volumen en solo unos pocos clics utilizando nuestro explorador de volúmenes.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.
Diseñado para la velocidad: ~ 10 ms de latencia, incluso bajo carga