



October 14, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.


Published: October 7, 2026
¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
Todos los equipos que implementan IA actualmente viven la misma contradicción. Los desarrolladores quieren integrar nuevos modelos tan pronto como aparecen. Los equipos de seguridad necesitan que cada prompt y cada respuesta sean seguros, cumplan con las normativas y no filtren datos. Ambos tienen razón y ninguno puede esperar al otro. Por lo tanto, la verdadera pregunta no es qué modelo asegurar, sino cómo aplicar una política de seguridad única y coherente en las decenas o cientos de modelos que sus equipos ya están utilizando, sin tener que reconstruir la integración cada vez.
Esa brecha, entre el acceso a los modelos y la gobernanza real de lo que fluye a través de ellos, es donde la mayoría de los esfuerzos de seguridad de IA fracasan silenciosamente. Hoy, estamos cerrando esa brecha. Anunciamos la integración de HiddenLayer Runtime Security con la TrueFoundry AI Gateway, para que pueda aplicar seguridad de IA en tiempo de ejecución a cualquier modelo detrás de la puerta de enlace desde un solo lugar, sin necesidad de ingeniería por modelo.
La TrueFoundry AI Gateway es el punto de control para la IA empresarial. Ofrece a los desarrolladores un acceso unificado a cientos de LLM a través de una única API, con enrutamiento inteligente, observabilidad y controles de costos integrados. A medida que la adopción aumenta, lo difícil ya no es acceder a un modelo, sino gestionar todo lo que viene después: múltiples proveedores, APIs cambiantes y requisitos de cumplimiento que se aplican a cada llamada.
La puerta de enlace convierte esa dispersión en una superficie coherente. Cada solicitud y cada respuesta pasan por el mismo camino, lo que significa que la seguridad ya no tiene que añadirse a cada aplicación por separado. Puede aplicarse una vez, de forma centralizada, para todos.
HiddenLayer Runtime Security es una plataforma de seguridad en tiempo de ejecución creada específicamente para aplicaciones de LLM. En lugar de confiar en que un prompt o una respuesta son seguros, inspecciona cada interacción a medida que ocurre y toma una decisión clara.
Detecta intentos de inyección de prompts y jailbreak antes de que lleguen al modelo, evitando que un atacante engañe al sistema para revelar sus instrucciones o eludir sus salvaguardas. Identifica y redacta datos confidenciales, como direcciones de correo electrónico y números de teléfono, para que la información sensible nunca se filtre accidentalmente en un prompt o en una respuesta. Y como las políticas residen en la consola de la plataforma AISec en lugar de en su código, su equipo de seguridad puede ajustar qué se bloquea, qué se redacta y qué se marca, sin necesidad de realizar un nuevo lanzamiento.
Por sí sola, cada herramienta es potente. Juntas, eliminan el trabajo que suele hacer que la seguridad de la IA sea tediosa. En lugar de integrar un SDK en cada aplicación o mantener código de seguridad separado para cada proveedor, conecta HiddenLayer a la puerta de enlace una sola vez. A partir de ese momento, cualquier modelo enrutado a través de TrueFoundry hereda automáticamente la misma protección.
La puerta de enlace escucha el veredicto de HiddenLayer en cada llamada y lo aplica al instante. Un prompt malicioso es bloqueado. El contenido sensible se redacta en el momento y el texto limpio continúa su curso. Una solicitud segura pasa directamente. Sus desarrolladores siguen trabajando a toda velocidad y apenas notan que la capa está ahí, mientras que su equipo de seguridad obtiene un control de políticas centralizado y una pista de auditoría completa que abarca todos los modelos y entornos.
HiddenLayer funciona como un envoltorio ligero que la puerta de enlace consulta tanto en la entrada como en la salida. Cada solicitud realiza un viaje de ida y vuelta rápido y predecible antes de llegar al modelo.
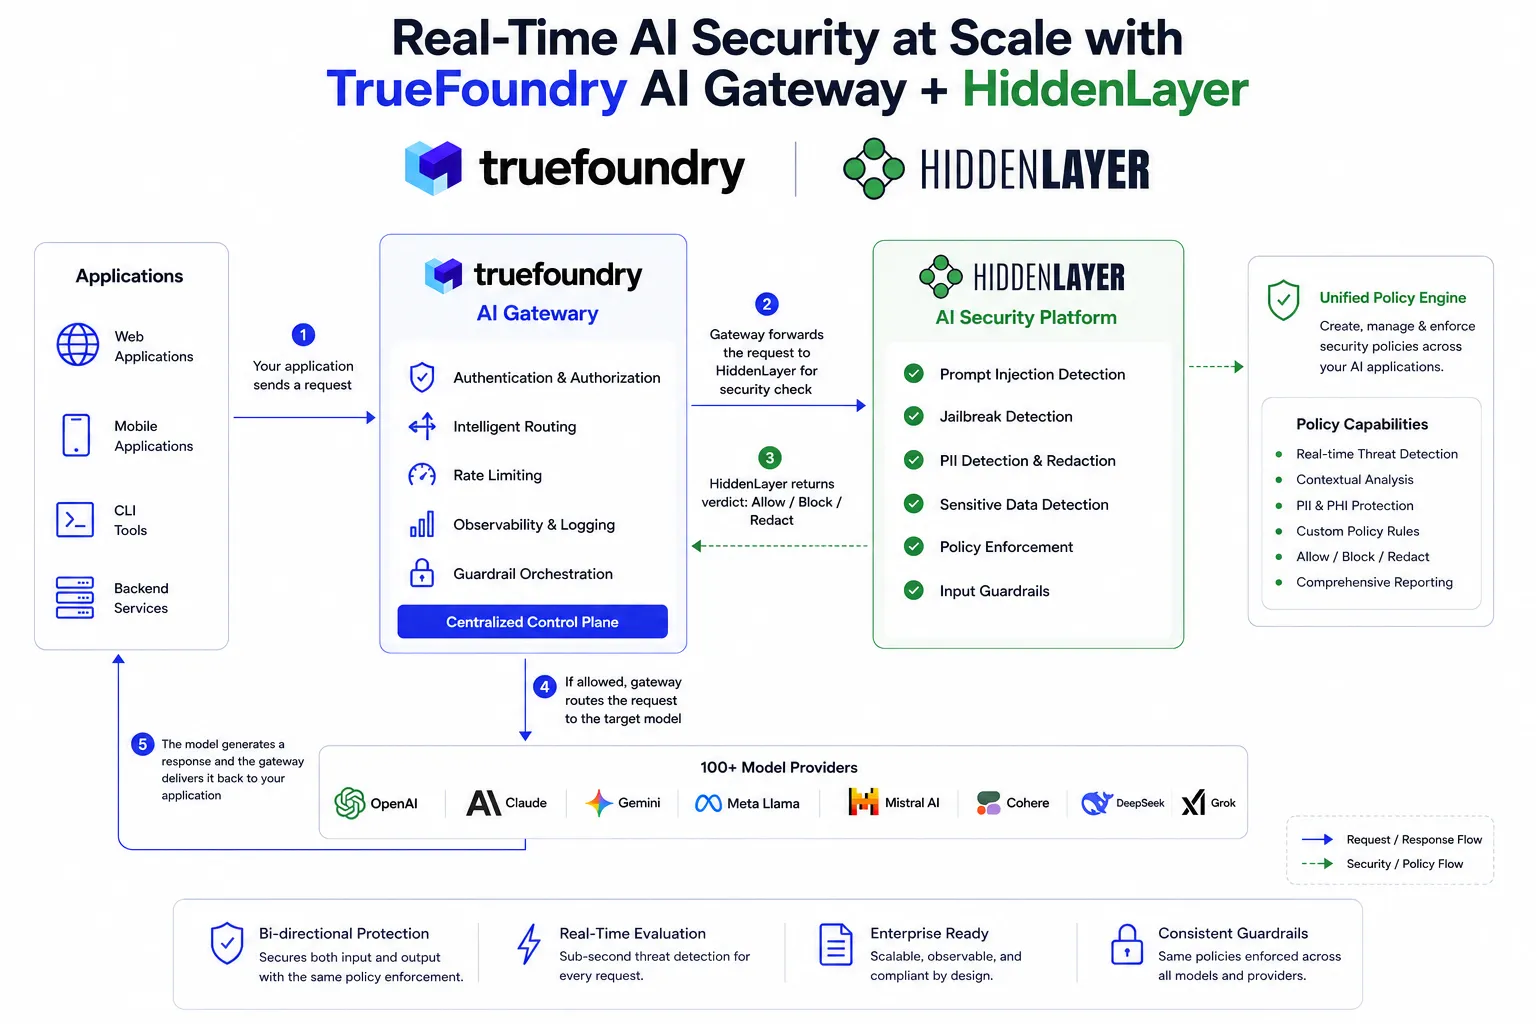
Esta arquitectura permite a las organizaciones aplicar políticas de seguridad de IA coherentes antes de la ejecución del modelo, lo que ayuda a prevenir ataques de inyección de prompts, intentos de jailbreak y la exposición de datos confidenciales, manteniendo al mismo tiempo una capa de acceso unificada para todos los modelos de IA.
La seguridad de la IA no debería frenarle. Con HiddenLayer Runtime Security en TrueFoundry AI Gateway, obtiene una protección en tiempo ejecución que es más parecida a pulsar un interruptor que a gestionar un proyecto de ingeniería. Defina su política una vez, conecte la pasarela a HiddenLayer y todos los modelos que se encuentren detrás estarán protegidos.
Para ver cómo funciona de principio a fin, lea la guía de integración de HiddenLayer en la documentación de TrueFoundry, o contacte con nuestro equipo para una demostración guiada.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada


















