


noviembre 20, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.




¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
50 preguntas que debe hacer a cualquier proveedor en 2026
Las evaluaciones de plataformas de IA para empresas suelen fallar por motivos muy predecibles. La demostración del proveedor se ejecuta con un prompt de prueba cuidadosamente seleccionado. Su diapositiva de precios asume un consumo de 5000 tokens por llamada que no coincide con su carga de trabajo real. El diagrama de arquitectura de seguridad que muestran corresponde a un modo de despliegue por el que ni siquiera ha preguntado. La funcionalidad de MCP que afirman tener estará disponible «en nuestra próxima versión». Seis semanas después, termina firmando un contrato para un producto que solo encaja en un 70 %, y su equipo de plataforma pasa el resto del contrato cubriendo el 30 % restante con desarrollos a medida.
Una RFP puntuada cambia por completo esta dinámica. Todos los proveedores responden a las mismas preguntas, por escrito, antes de realizar cualquier demostración. Sus evasivas (una pregunta esquivada, una funcionalidad que «requiere de nuestro socio de integración» o una afirmación de cumplimiento normativo que no resiste un análisis de alcance) quedan registradas por escrito, donde no pueden volver a justificarse en una llamada posterior. Ese mismo documento permite exigir responsabilidades al proveedor cuando la realidad tras la firma empieza a diferir de la propuesta comercial previa, la queja de compras más habitual en el momento de la renovación del primer año.
Hay tres factores clave que hacen que esta plantilla vaya más allá de lo que cubren los marcos genéricos de contratación empresarial. Gobernanza de MCP, la pila de protocolos que utilizarán sus agentes de IA para comunicarse con las herramientas, donde la mayoría de las pasarelas de IA siguen añadiendo controles de acceso como un parche sobre un diseño inicial que no los contemplaba. Controles de IA agéntica, la correlación de trazas, la atribución de costes y los límites de aislamiento que convierten la tarea de un agente de múltiples pasos en una unidad depurable, facturable y gobernable, en lugar de una maraña desconectada de llamadas a LLM. Cumplimiento normativo específico para IA, que incluye la paridad de campos en los registros de auditoría entre llamadas a LLM e invocaciones a herramientas, respuestas estructuradas sobre la residencia de datos teniendo en cuenta el enrutamiento entre regiones de los proveedores de modelos, y los controles arquitectónicos de BAA que garantizan el cumplimiento real de HIPAA más allá del mero papeleo.
Utilice este documento como punto de partida. Adapte las ponderaciones a su entorno. Envíe este mismo documento a todos los proveedores de su lista corta. El equipo de soluciones de TrueFoundry está preparado para responder a las 50 preguntas por escrito y con evidencias como parte de su proceso formal de evaluación empresarial.
Pasemos a las preguntas.

Figura 1. Arquitectura de referencia con plano dividido: plano de control y plano de computación separados por un límite de solo metadatos, con un único IdP que proporciona la identidad a ambos.
El orden de las operaciones es más importante que las propias preguntas. La mayoría de las evaluaciones fallidas se saltan el primer paso: obtener respuestas por escrito a toda la plantilla antes de permitir que cualquier proveedor haga una demostración. Las demostraciones sirven para verificar lo prometido por escrito, no para descubrir funcionalidades. Si la primera noticia que tiene de una característica proviene de una diapositiva durante una presentación, les ha cedido el control de la narrativa de la evaluación.
Envíe la plantilla a todos los proveedores de su lista corta simultáneamente, fijando un plazo de respuesta por escrito de dos semanas. Utilice las respuestas para puntuar según una rúbrica ponderada. Solo después de haber puntuado debe programar las demostraciones. En ellas, el trabajo de su equipo de plataforma consistirá en verificar que lo que está escrito coincide con lo que está en ejecución. Trate cualquier afirmación que aparezca en la demostración pero que no estuviera en la respuesta escrita como un punto a investigar, no como una característica a evaluar positivamente.
Algunos detalles clave para ejecutar esto correctamente:
Si alguna vez ha estado en una revisión de seguridad donde el alcance de cumplimiento del proveedor solo cubría la opción SaaS que no planeaba usar, sabrá lo caro que sale saltarse el paso de la rúbrica. Una RFP puntuada saca a la luz esos detalles antes de firmar el contrato.
La seguridad y el cumplimiento normativo es donde la mayoría de las evaluaciones de plataformas de IA se desmoronan en la segunda reunión. No porque los proveedores carezcan de certificaciones. La mayoría tiene un SOC 2 Type II en algún sitio. El problema suele ser de alineación: el alcance de la certificación, los controles arquitectónicos que la implementan y el modo de despliegue que realmente está comprando no coinciden. Un SOC 2 que cubre el portal de marketing del proveedor no sirve de nada para una pasarela de IA que procesa PHI on-premise. Un BAA que existe como plantilla pero no describe cómo se aísla la PHI en el plano de datos es mero papel mojado, no un control. Las siguientes preguntas fuerzan la alineación entre el alcance de la certificación y la realidad arquitectónica, evitando que las respuestas del tipo «estamos certificados» tengan un peso que no les corresponde.
El otro fallo habitual que conviene mencionar desde el principio: proveedores que responden a preguntas de seguridad de forma abstracta porque su arquitectura real se divide entre dos productos con posturas de control distintas. Su versión on-premise ofrece pocas funcionalidades y no está certificada de forma independiente. Su versión SaaS tiene las certificaciones, pero no se adapta a su entorno. Detecte esto haciendo la misma pregunta dos veces, especificando cada vez el modo de despliegue. Si las respuestas difieren, se encuentra ante dos productos comercializados como si fueran uno solo.
Puntúe esta sección de forma rigurosa.
Un despliegue con plano dividido donde el plano de datos (el proxy que gestiona prompts, respuestas del modelo, embeddings e invocaciones a herramientas de MCP) se ejecuta íntegramente en la VPC del cliente y nunca abre una conexión saliente hacia la infraestructura del proveedor para transferir la carga útil de las peticiones. El plano de control (configuración, ajustes de RBAC, cuadros de mando) puede ejecutarse en la infraestructura del proveedor o en la del cliente según el modo de despliegue, pero solo intercambia metadatos. Los registros de auditoría, los datos de prompts y respuestas, y los embeddings se almacenan en el almacenamiento de blobs controlado por el cliente (S3, GCS, Azure Blob), no en bases de datos gestionadas por el proveedor. Si el «despliegue en VPC» del proveedor sigue enviando prompts a un agregador de registros gestionado por él, se trata de un despliegue SaaS con otro envoltorio.
Revise la sección Descripción del sistema para comprobar que se nombran de forma explícita los modos de despliegue cubiertos. Busque frases como «el entorno SaaS multitenant alojado en [cloud]» frente a «los componentes de la pasarela y del plano de control desplegados por el cliente». Si la descripción solo menciona uno, la certificación solo cubre ese. Compruebe los Criterios de servicios de confianza cubiertos. La seguridad es la base, pero la disponibilidad, la confidencialidad y la integridad del procesamiento son fundamentales para las cargas de trabajo de IA que gestionan datos regulados. Un SOC 2 que solo cubre la seguridad está incompleto.
La plataforma obtiene las claves del proveedor de modelos desde el Vault o Secrets Manager del cliente al iniciar la pasarela o bajo demanda mediante un rol IAM gestionado por el cliente, almacenando en la configuración de la plataforma solo referencias a las claves (no sus valores). La rotación es una operación en Vault: al actualizar la clave en Vault, la pasarela obtiene el nuevo valor en la siguiente lectura o en un intervalo de refresco configurable. La plataforma nunca almacena claves de proveedores en reposo. Si la respuesta del proveedor es «usted carga las claves en nuestra UI de administración y las guardamos cifradas», se trata de un modelo de seguridad diferente (y más débil). Las claves pasan a estar en la infraestructura del proveedor, incluso en un despliegue «en VPC».
El registro de invocación a la herramienta de MCP debe mantener la paridad de campos para las dimensiones compartidas (timestamp, request_id, trace_id, user, application, latency_ms, status, policy decision) además de los campos específicos de la herramienta:
Observe que ambos incluyen el mismo trace_id: la llamada al LLM y la invocación al MCP se correlacionan con una única petición de usuario, lo que concreta la respuesta a la pregunta 8 de la Sección 4. Se deben aplicar funciones hash a los parámetros en lugar de registrarlos en bruto. El registro completo de parámetros supone un riesgo de fuga de datos en entornos regulados. Si el ejemplo de registro de MCP del proveedor no incluye policy.decision, trace_id o la atribución del usuario, la gobernanza de MCP no es una aplicación de políticas en tiempo real, sino un informe a posteriori.

Figura 2. Flujo de datos de registros de auditoría: paridad de campos entre eventos de inferencia de LLM y eventos de invocación a herramientas de MCP, ambos correlacionados mediante un único trace_id.
El «cifrado en reposo» es algo generalizado. El control real reside en saber de quién es la clave que realiza el cifrado. En un despliegue autoalojado, es posible utilizar claves controladas por el cliente porque los almacenes de datos están en su propia cuenta; en un despliegue SaaS, las claves controladas por el cliente son una funcionalidad que el proveedor debe haber diseñado desde el principio. Formule la pregunta especificando el modo de despliegue.
Para despliegues autoalojados, «disponibilidad del parche» significa una versión etiquetada que el equipo de plataforma del cliente pueda desplegar. El «plazo de aplicación del cliente» es el SLA al que el cliente se compromete internamente. Si el proveedor propone un plazo de 30 días para vulnerabilidades CVE críticas, es un periodo de exposición demasiado elevado; exija plazos más cortos.
La mayoría de los procesos de contratación empresarial fallan en la fase de despliegue. La plataforma parece idónea en la demostración del entorno SaaS, pero la revisión de seguridad revela tres bloqueos: conectividad saliente hacia la infraestructura del proveedor para telemetría, una base de datos de configuración alojada en la nube del proveedor y un plano de control acoplado a una región de cloud específica. Cuando estos condicionantes salen a la luz, ya se ha negociado el precio de un producto inadecuado, teniendo que renegociar desde una posición desfavorable o aceptar un despliegue que genera deuda técnica en cumplimiento normativo.
Esta sección expone los condicionantes del despliegue desde el principio. Los proveedores capaces de responder con claridad son aquellos que ya han realizado despliegues en entornos similares al suyo. Los proveedores que necesitan una llamada de descubrimiento para responder a la Sección 2 no lo han hecho, y terminará pagando para realizar esa ingeniería de integración durante dicha llamada.
Analice las respuestas con atención.
Estimación de dimensionamiento para un tráfico constante de ~500 RPS: de 3 a 4 réplicas de pasarela con 2 vCPU / 4 GB de RAM cada una, Postgres con 4 vCPU / 16 GB de RAM y 100 GB SSD, y almacenamiento de blobs dimensionado según la retención (una retención de 90 días a 10 KB/registro y 500 RPS equivale a unos 1,2 TB). El proveedor debe aportar cifras concretas como estas por escrito antes de firmar, evitando respuestas ambiguas como «depende de la carga de trabajo».

Figura 3. Un único plano de control gestionando planos de computación en AWS, Azure, GCP y Kubernetes on-premise simultáneamente, cada uno con su propio límite de residencia de datos.
Cualquier resultado inferior a estos para un entorno de producción multirregión debería incluir una explicación por escrito. Que un proveedor pequeño indique «no admitimos multirregión» es comprensible; que afirme «lo admitimos pero no nos comprometemos a un RTO», no.
Las páginas de producto de los AI gateways suelen ser muy parecidas: API unificada, enrutamiento inteligente, control de costes y observabilidad. Los detalles concretos detrás de esas palabras son los que diferencian una pasarela lista para producción de un proxy básico con una web de marketing. «Enrutamiento inteligente» puede referirse tanto a un round-robin estático entre dos modelos como a una política en cascada con límites de costes, selección por capacidades y cadenas de alternativa (fallback). «Control de costes» puede significar un panel que muestra la factura de ayer o presupuestos estrictos de tokens que devuelven un error 429 a la aplicación cuando un equipo alcanza su límite.
Las preguntas de esta sección exigen detalles concretos. Rechace las respuestas que se limiten a repetir el texto comercial. El proveedor que afirme «admitimos enrutamiento inteligente» sin detallar el lenguaje de reglas, el comportamiento en cascada, la gestión de fallos y la integración con los presupuestos no dispone de enrutamiento real: solo tiene una opción de configuración.
Exija pruebas de la arquitectura propuesta.
La aplicación envía una solicitud estándar compatible con OpenAI. El gateway selecciona el proveedor en función de la regla, cae en la cascada en caso de fallo, adjunta la referencia de presupuesto para la atribución de costes y aplica guardrails inline. No cambia el código de la aplicación cuando se reconfigura la ruta. Si el "enrutamiento inteligente" del proveedor requiere cambios a nivel de aplicación para cada variante, no es un enrutamiento a nivel de gateway. Es un wrapper.
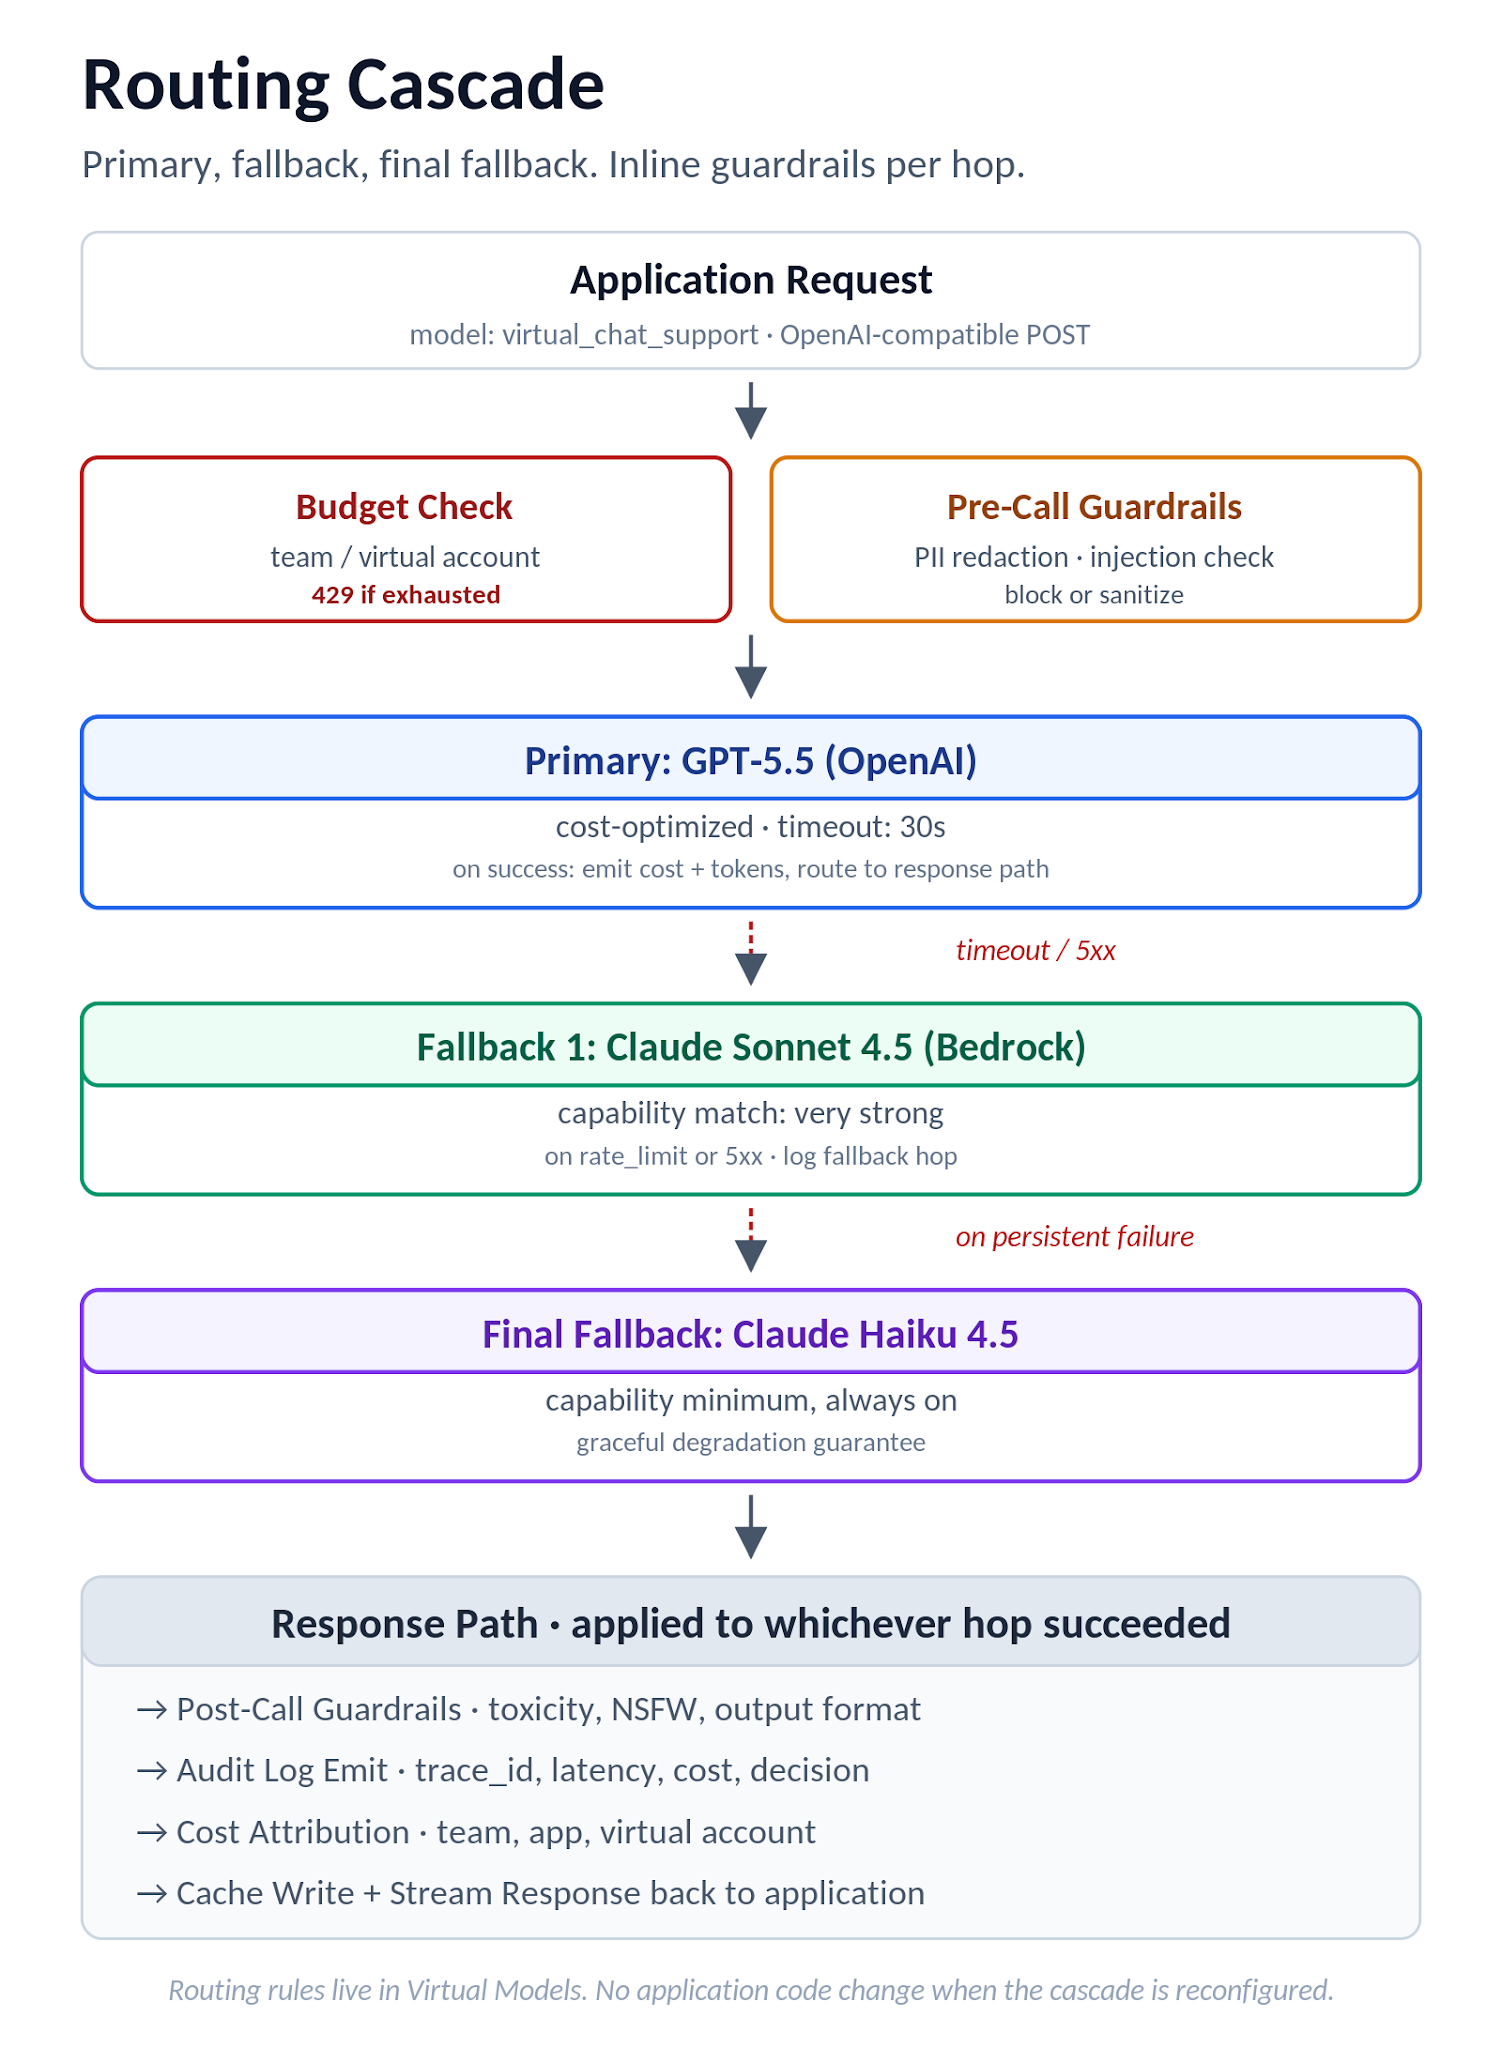
Figura 4. Flujo de la cascada de enrutamiento: comprobación de presupuesto, guardrails pre-call, intento con el modelo primario, cadena de fallback y una ruta de respuesta unificada con auditoría, coste y caché.
Esta sección es donde la mayoría de los productos de AI gateway tendrán dificultades, porque la mayoría se diseñaron para la era de las llamadas a LLM y son anteriores al momento en que MCP comenzó a aparecer en entornos empresariales reales. MCP no es "más observabilidad para llamadas a herramientas". Es un plano de gobernanza independiente: un registro de servidores aprobados, un punto de aplicación para qué herramientas puede invocar cada rol, registros de auditoría que coinciden con los registros de llamadas a LLM en cobertura de campos y un motor de políticas que se ejecuta en el momento de la invocación en lugar de como un informe a posteriori. Los proveedores que no dispongan de este plano intentarán responder a las preguntas de la Sección 4 con descripciones de observabilidad de LLM. Esté atento a la sustitución. Cuanto más directa sea la respuesta, más real será la capacidad.
El patrón a esperar: un proveedor sólido de AI gateway describirá el MCP gateway como una superficie de producto independiente con su propio registro, su propio mapeo RBAC, su propio esquema de registro de auditoría y su propio lenguaje de políticas. Un proveedor más débil lo describirá como "observabilidad extendida" sobre su stack existente de observabilidad de LLM, lo que delata que la gobernanza es escasa. Puntúe la Sección 4 específicamente; no la incluya en la Sección 3.
Lea cada respuesta buscando un lenguaje de aplicación directa.
Las actualizaciones de esta regla deberían propagarse al gateway en segundos (push de configuración, no rediseño ni nuevo despliegue). Si la respuesta del proveedor es "las políticas son evaluadas por el propio servidor MCP", no es una política aplicada por el gateway. Es una política aplicada por el servidor, y necesitará mantener la paridad de políticas en cada servidor MCP del catálogo. Es un problema diferente.
El gateway conserva el trace-id en cada llamada descendente (proveedor de LLM, servidor MCP, salto secundario del gateway) inyectándolo en los encabezados salientes, y emite cada llamada como un span bajo el mismo trace-id. En Datadog, Grafana Tempo o Jaeger, el resultado es una única cascada que muestra: solicitud del usuario → llamada al LLM (claude-sonnet-4-6, 2.1s) → llamada a la herramienta (github.create_issue, 528ms) → llamada al LLM (formateador de salida, 380ms) → respuesta. Sin esto, el mismo flujo aparece como cuatro entradas no relacionadas y el análisis de causa raíz se convierte en un juego de adivinanzas.

Figura 5. Arquitectura del MCP Gateway: un único endpoint para herramientas de desarrollador y agentes, con capas de autenticación, registro, políticas y registro de auditoría entre los clientes y los servidores MCP.
La diferencia entre una plataforma de IA que monitoriza bien y una que observa bien se refleja en las preguntas que se hace su equipo financiero a fin de mes. La monitorización le dice que la factura ha subido un 40 por ciento. La observabilidad le dice que el chatbot del equipo de marketing comenzó a entrar en un bucle en un caso límite de la ventana de contexto hace tres semanas, que el 70 por ciento del aumento proviene de una sola aplicación y que las solicitudes desbordadas tienen una firma específica que se puede enrutar a un modelo más barato. La primera respuesta enfada a finanzas. La segunda respuesta convierte a finanzas en un aliado.
La misma distinción aparece en la depuración de agentes. La monitorización le dice que una tarea del agente ha fallado. La observabilidad le dice qué llamada al LLM devolvió una respuesta mal formada, qué invocación de herramienta descendente caducó como resultado y a qué solicitud de usuario se atribuyó el fallo. Sin un rastreo correlacionado a través de los planos de LLM y MCP (Sección 4, pregunta 8), cada fallo de un agente es un ejercicio forense. Las siguientes preguntas obligan al proveedor a describir qué se captura realmente por llamada, cómo se puede consultar y cómo salen los datos de la plataforma cuando su sistema financiero los necesita.
Los detalles importan aquí.
Esto es lo que hace que la "atribución de costes del agente" sea una señal de grado financiero en lugar de una curiosidad técnica.
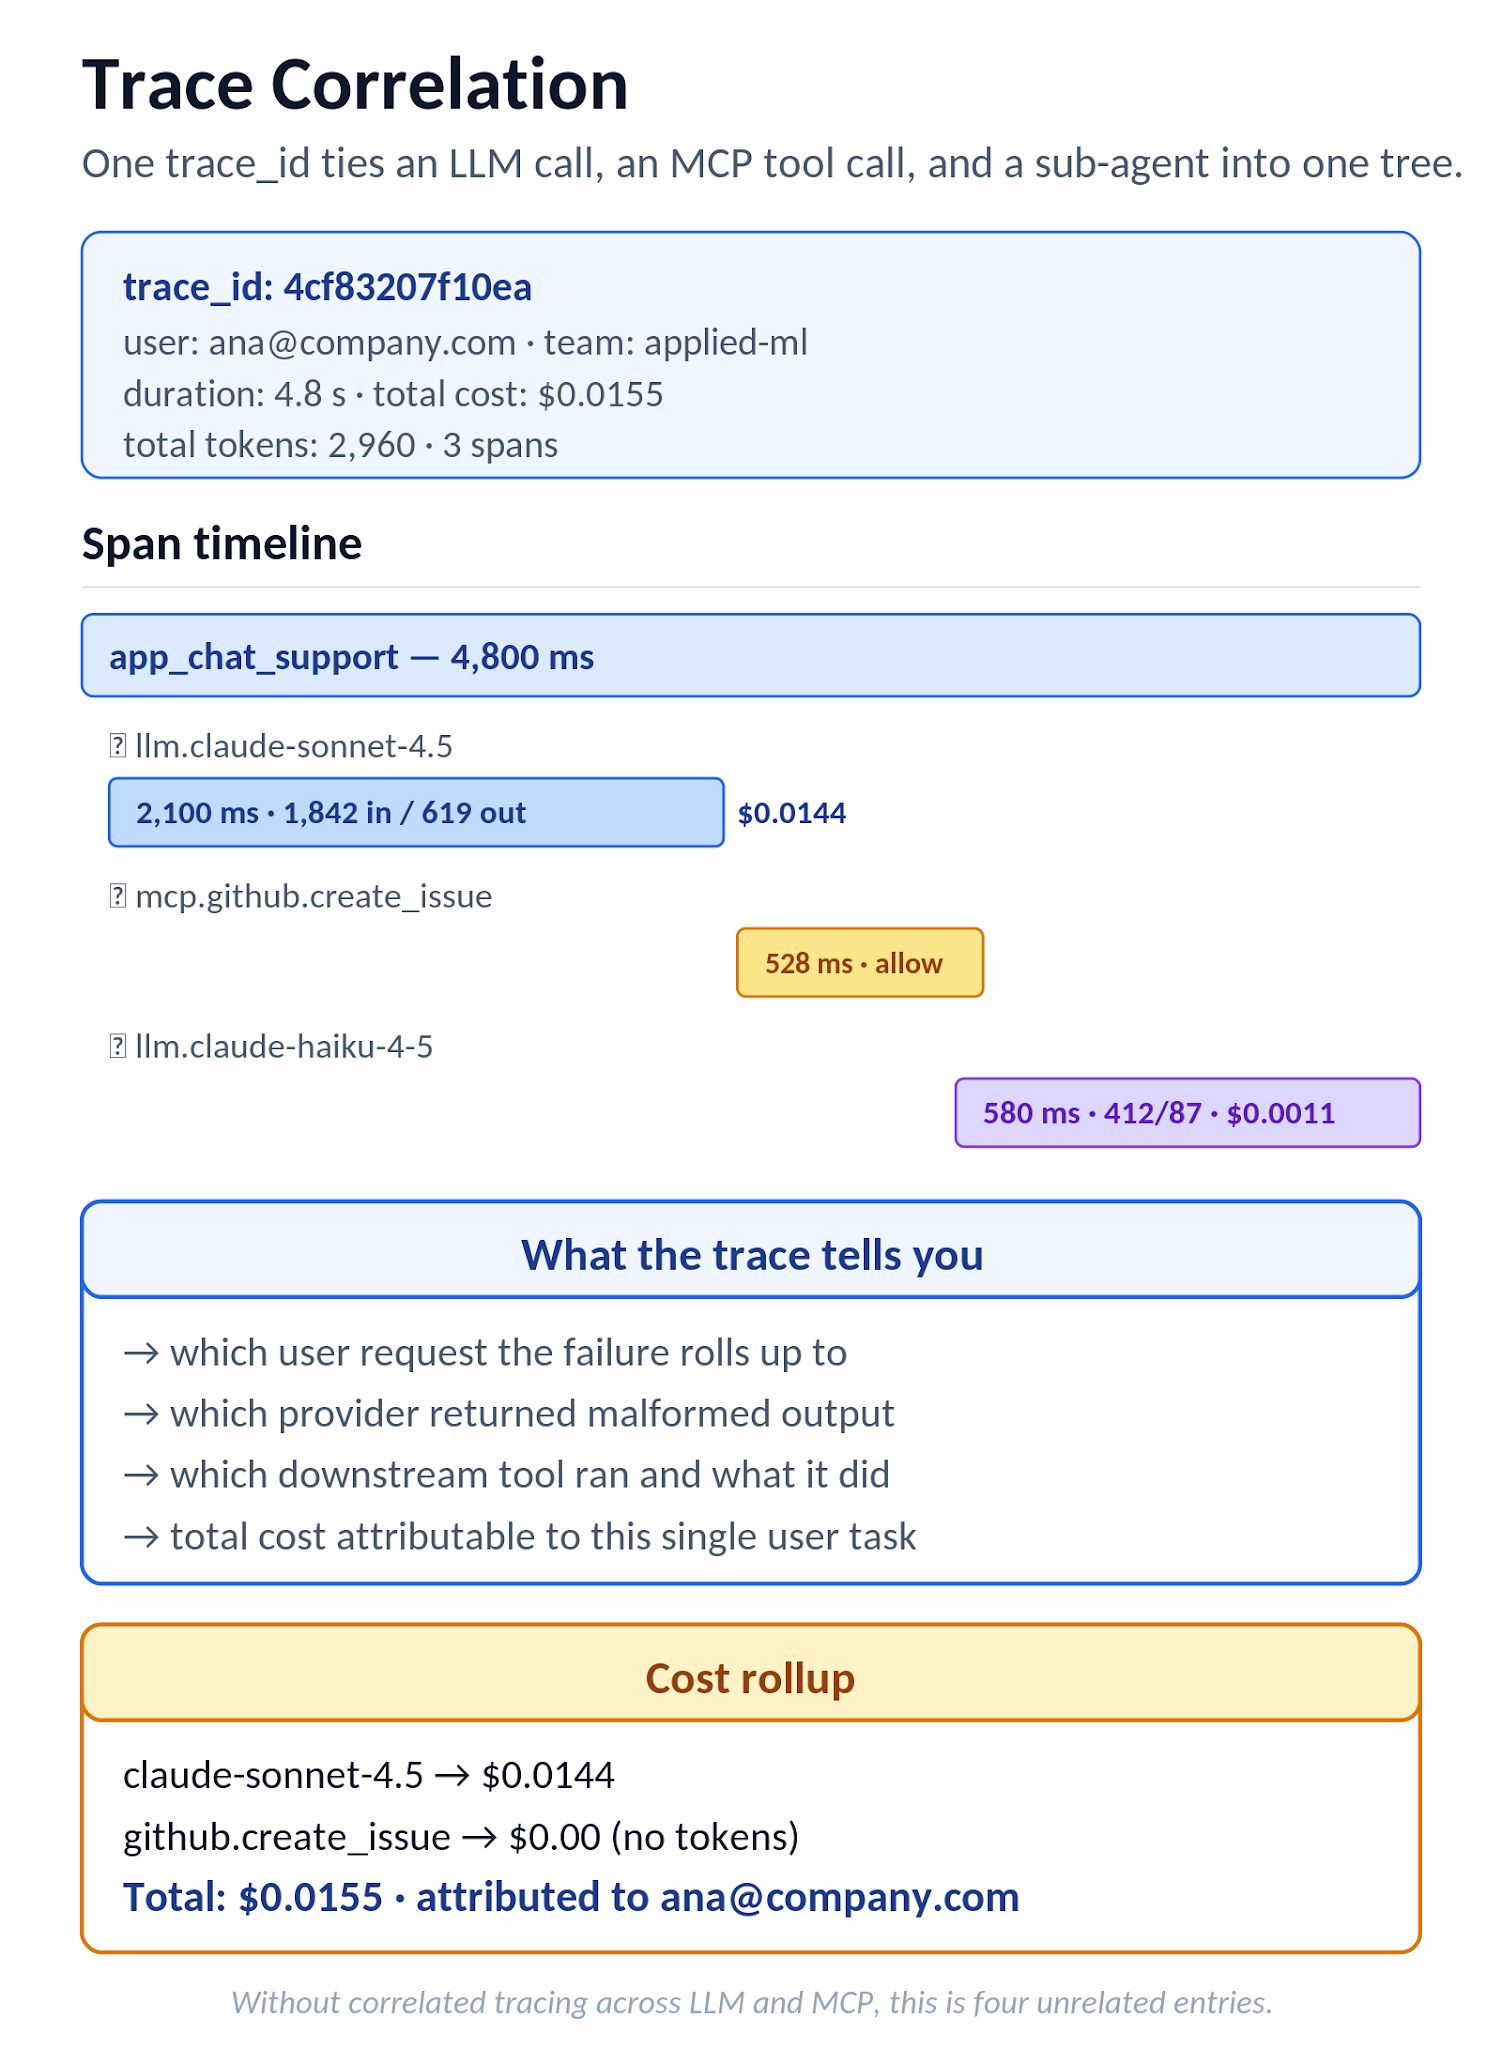
Figura 6. Vista en cascada de traza de una sola tarea de agente: llamada al LLM, llamada a la herramienta MCP y segunda llamada al LLM, todo bajo un mismo trace_id con el coste acumulado a lo largo de los spans.
El coste de una falta de integración rara vez es visible durante la adquisición. Aparece a los seis meses, cuando revocar el acceso de un empleado despedido tarda 48 horas porque SCIM no es real, cuando una interrupción P1 a las 2 a. m. recibe una respuesta automática de "responderemos durante el horario laboral" porque el SLA es aspiracional, cuando el cambio de nombre de un grupo de Okta rompe las asignaciones de roles porque la integración SSO de la plataforma nunca se probó con eventos del ciclo de vida de grupos. Cada uno de esos casos es un coste de ingeniería finito, pero se acumulan en el impuesto operativo que hace que los equipos de plataforma migren silenciosamente de productos por lo demás capaces al renovar al tercer año.
La Sección 6 saca a la luz las realidades operativas. Dos patrones de diagnóstico: cualquier respuesta afirmativa a una pregunta sobre soporte de protocolos merece un seguimiento sobre qué clientes ejecutan ese protocolo en producción hoy en día frente a qué clientes serán los primeros en probarlo. Y cualquier compromiso de SLA sin créditos explícitos asociados debe tratarse como un objetivo de marketing. Los SLA contractuales incluyen créditos porque los proveedores fijan el precio del riesgo de no cumplirlos; los SLA aspiracionales son redactados por marketing y no los incluyen.
Consiga los créditos por escrito.
Si la plataforma solo puede consumir un formato de reclamación fijo, la integración con cualquier cosa que no sea Okta/Azure AD se vuelve dolorosa. La flexibilidad anterior es un coste de configuración de una sola vez; sin ella, cada incorporación de un IdP se convierte en un desarrollo a medida.
Cuando el usuario se desaprovisiona en el IdP, el mismo endpoint recibe un PATCH que cambia active a false, y la plataforma debería revocar el acceso del usuario de inmediato en lugar de en el próximo intento de inicio de sesión. Pruebe esto en la prueba de concepto: desaprovisione a un usuario de prueba en el IdP, luego intente usar un token de plataforma aún válido y confirme que el ciclo de vida de desaprovisionamiento funciona de extremo a extremo. Si la plataforma solo respeta el desaprovisionamiento en el próximo inicio de sesión del usuario, ese es un vacío de cumplimiento que vale la pena reflejar por escrito.
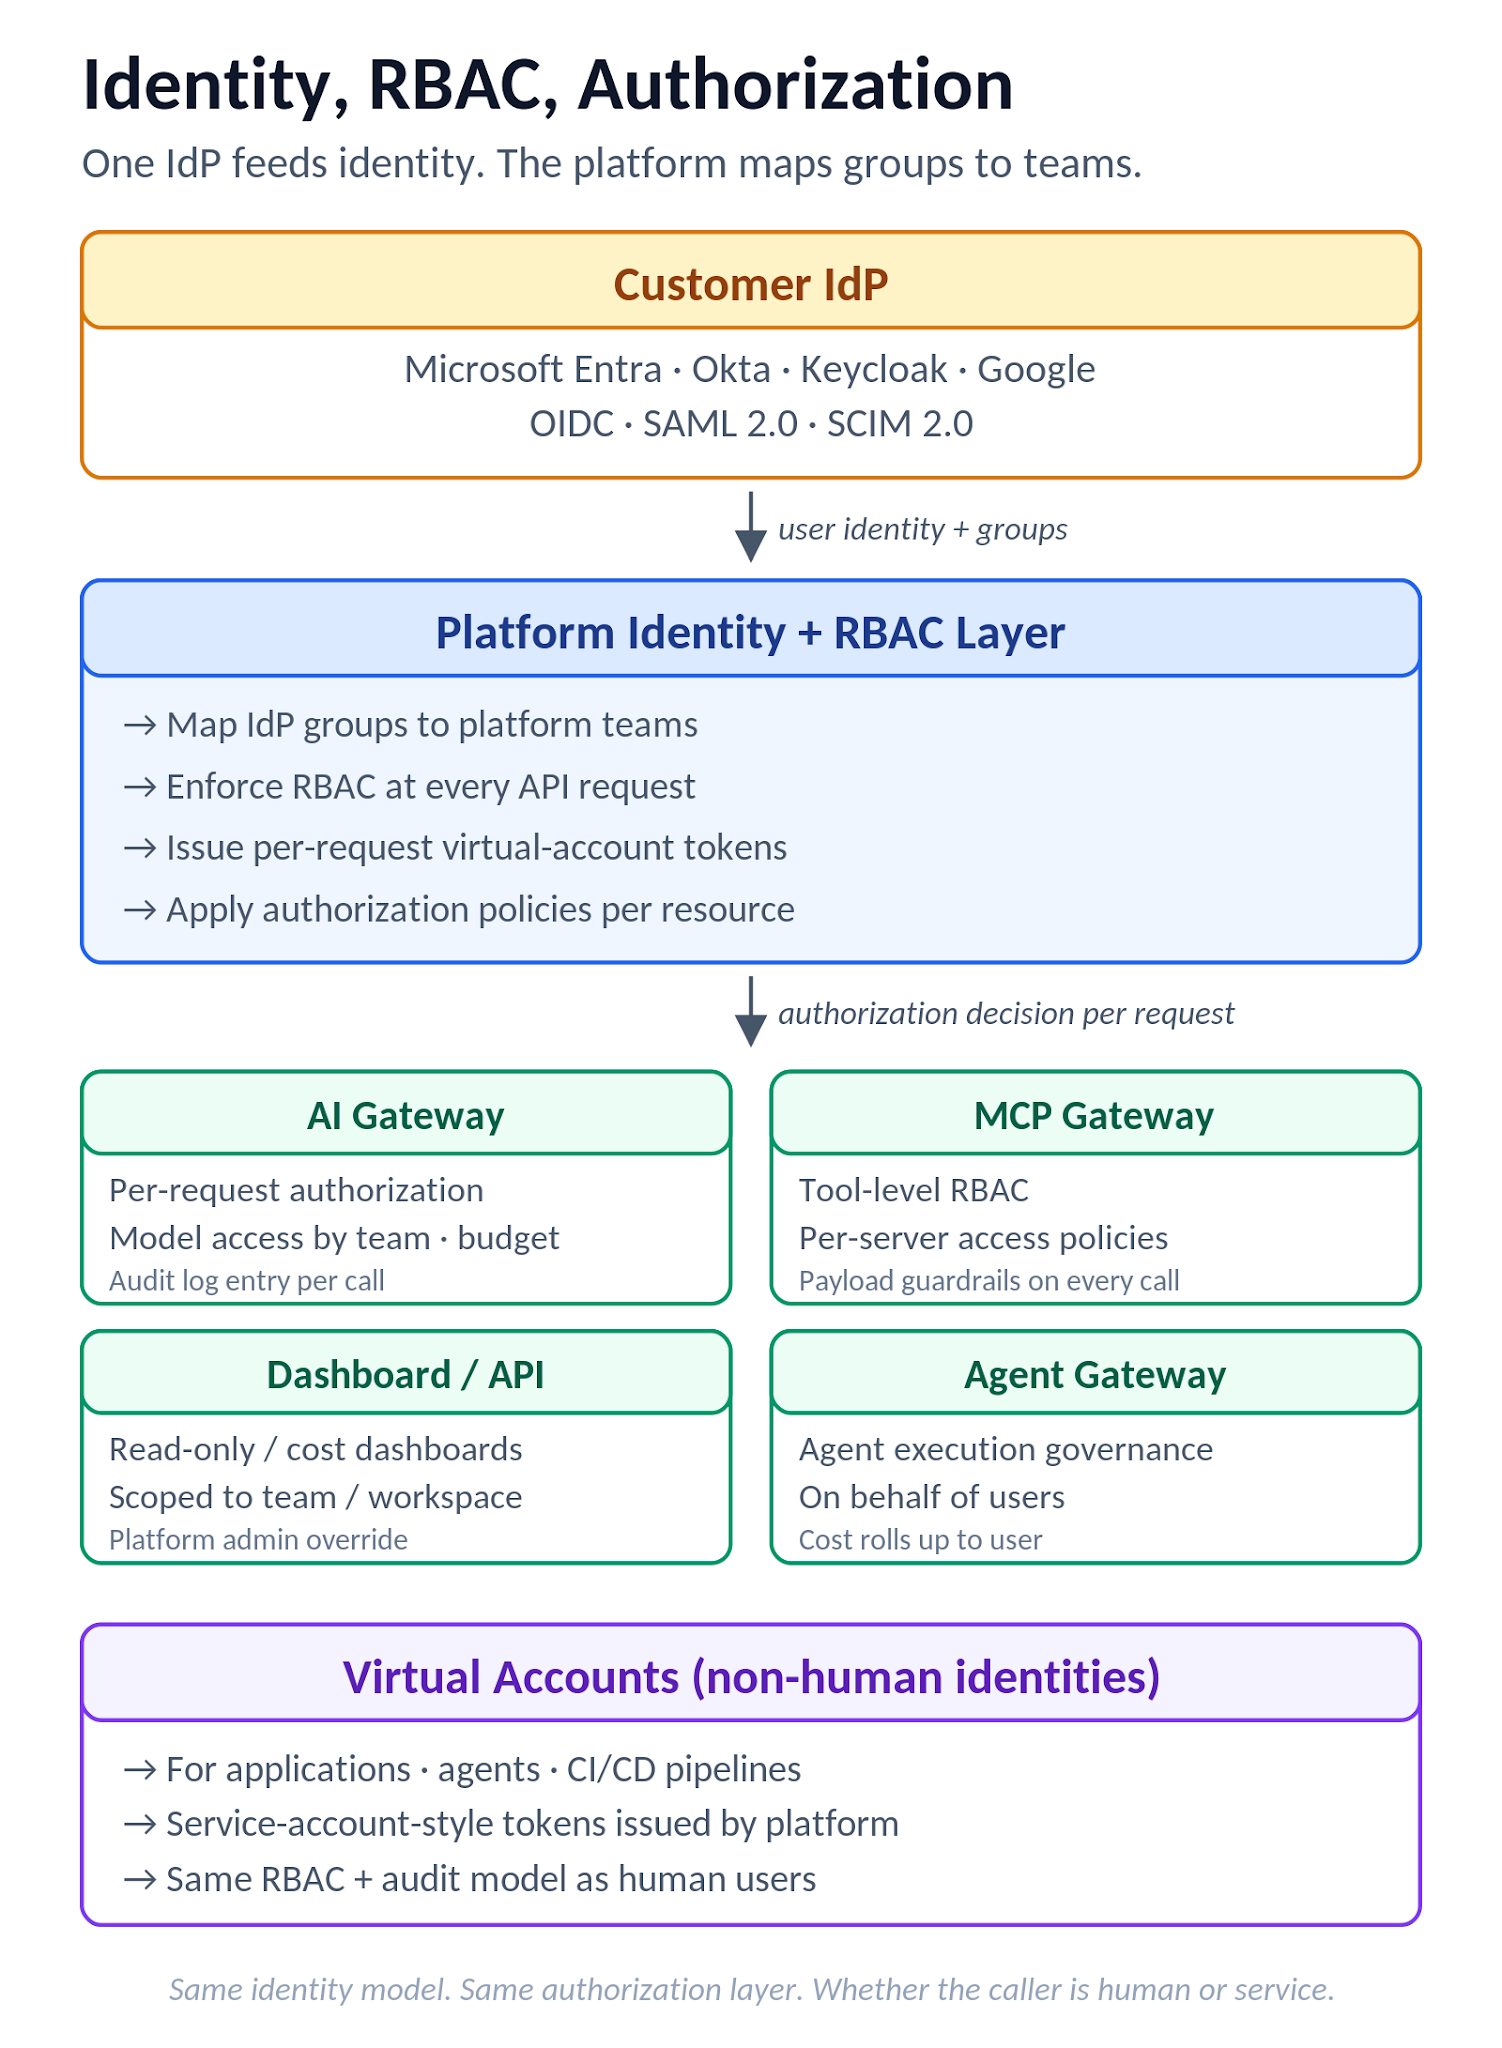
Figura 7. Flujo de identidad y RBAC: el IdP alimenta la identidad, la plataforma mapea grupos a equipos y cuentas virtuales (Virtual Accounts), con aplicación de políticas en AI Gateway, MCP Gateway, panel de control y Agent Gateway.
Tenga cuidado con el "tiempo de respuesta" definido como "un correo electrónico automatizado que dice que recibimos su ticket". Eso no es una respuesta. Una respuesta real es un ingeniero trabajando en el problema. Y la cláusula de crédito es la prueba de fuego: los SLA contractuales vienen con créditos, los SLA de marketing no.
El equipo de soluciones de TrueFoundry trata este RFP como la evaluación formal, no como un recurso comercial. Cada pregunta recibe una respuesta por escrito con evidencias: informes SOC 2 Tipo II, documentación BAA para despliegues en el sector salud, resúmenes de pruebas de penetración, arquitecturas de referencia, registros de auditoría de muestra y referencias de clientes. El resultado es un documento que sus equipos de seguridad, compras y plataforma pueden utilizar para tomar una decisión sin necesidad de una llamada de toma de requisitos para rellenar los huecos.
La arquitectura tras las respuestas se corresponde directamente con la estructura de secciones de esta plantilla, razón por la cual la mayoría de las preguntas se resuelven con claridad. Analizándola detalladamente:
El modelo de despliegue es de plano dividido (split-plane). El plano de control es el cerebro de orquestación, que aloja la configuración, RBAC y los paneles de control. Los planos de cómputo se conectan a través de un agente y alojan las cargas de trabajo reales, incluidos el AI Gateway, el MCP Gateway y cualquier aplicación desplegada o modelos autoalojados. Los planos de cómputo se pueden ejecutar en cuentas en la nube del cliente (AWS, GCP, Azure) o en Kubernetes on-prem, y se pueden conectar múltiples planos de cómputo a un solo plano de control para permitir operaciones multi-entorno bajo una única superficie de control. El AI Gateway se puede autoalojar dentro de la infraestructura del cliente (las opciones de despliegue se documentan por separado) para ofrecer controles de soberanía y residencia de datos. Los registros de auditoría y los datos de rastreo se almacenan mediante proyectos de rastreo y registro de solicitudes del Gateway, con RBAC gobernando el acceso a trazas y registros. La arquitectura de plano dividido es lo que permite que la misma postura de residencia de datos esté disponible en despliegues SaaS, single-cloud, multi-cloud y autoalojados, en lugar de tratar a cada uno como un producto independiente con posturas de control separadas.
La soberanía de datos es la arquitectura, no una frase de marketing.
La autenticación utiliza SSO empresarial sobre OIDC o SAML 2.0 con validación opcional de tokens del IdP directamente en el AI Gateway para el control de acceso a la API. Se admiten los IdP más habituales (Microsoft Entra ID, Okta, Keycloak, Google), mapeando las de declaraciones de identidad y pertenencias a grupos desde el IdP hacia los equipos de TrueFoundry para aplicar RBAC a escala. El aprovisionamiento SCIM es compatible con todas las configuraciones de SSO —tanto OIDC como SAML—, de modo que la revocación en el IdP se propaga de inmediato sin esperar al próximo inicio de sesión del usuario. RBAC opera a nivel de Tenant (roles Admin/Member) además de roles personalizados con permisos delimitados entre usuarios, equipos, clusters, workspaces, despliegues, cuentas de proveedores del AI Gateway, servidores MCP y proyectos de trazado. Las identidades no humanas (aplicaciones, agentes) obtienen Virtual Accounts con tokens de estilo cuenta de servicio, y la autorización por solicitud en los límites del AI Gateway (modelos, agentes, servidores y herramientas MCP) admite patrones de mínimo privilegio. Las claves de proveedores se integran con almacenes de secretos gestionados por el cliente; la autenticación del gateway se superpone al IdP en lugar de reemplazarlo, manteniendo la aplicación de MFA y acceso condicional bajo el control del IdP del cliente.
El AI gateway enruta entre más de 1.000 LLMs a través de un único endpoint compatible con OpenAI: OpenAI, Anthropic (directo y mediante AWS Bedrock), Azure OpenAI, GCP Vertex AI, Groq, Mistral y modelos alojados en infraestructura propia servidos mediante vLLM, TGI o Triton. El enrutamiento se configura a través de Virtual Models, que exponen una sola interfaz de modelo y realizan balanceo de carga o failover entre múltiples proveedores y modelos subyacentes. TrueFailover añade una capa de enrutamiento con detección de caídas y degradaciones, integrando resiliencia multirregión y multinube. Los límites estrictos de tokens y solicitudes por usuario, equipo o Virtual Account devuelven un rechazo estructurado cuando un equipo alcanza su presupuesto, en lugar de una alerta secundaria mientras la solicitud se sigue procesando. La alternativa ante fallos del proveedor es automática y la penalización de latencia se registra como una métrica independiente en la llamada en lugar de quedar oculta en la latencia total. El almacenamiento en caché semántico utiliza embeddings y similitud del coseno con umbral y TTL configurables; la documentación destaca mejoras de latencia de hasta ~20x para consultas repetidas o similares. Las guardrails se basan en reglas (orientadas por modelo, usuario o metadatos); cada una puede Validate (bloquear) o Mutate (reescribir/ofuscar), y se admite Bring-Your-Own Guardrail mediante un servidor de guardrail personalizado usando una plantilla de FastAPI.
Aquí, el enrutamiento es el producto, no un parámetro de configuración.
El ecosistema de agentes y MCP marca la diferencia. TrueFoundry ejecuta de forma nativa un MCP Gateway y un MCP Registry que registran, descubren y conectan de forma centralizada y segura servidores y herramientas MCP mediante controles de acceso gobernados y flujos de autenticación empresarial. Admite transportes MCP modernos, incluido HTTP con streaming para conexiones proxy, y la capa de protocolo utiliza mensajería estándar JSON-RPC según la especificación MCP. La autenticación es multicapa: autenticación en el gateway, control de acceso a servidores MCP y autenticación por servidor o herramienta (incluidos patrones basados en OAuth documentados para servidores MCP empresariales). La configuración centralizada permite que las herramientas de desarrollo se comuniquen con un único endpoint de gateway en lugar de que cada desarrollador configure sus propias conexiones MCP, que es precisamente el patrón de shadow-tooling que el registro busca evitar. Agent Hub proporciona catalogación y orquestación organizacional para agentes complejos y preexistentes, mientras que Agent Gateway ofrece la capa de gobernanza empresarial (acceso seguro a herramientas, observabilidad, control de costes) para ejecutar dichos agentes en producción. La misma identidad que gobierna el acceso a los LLMs gobierna el acceso a las herramientas, por lo que la autorización para ambos reside en una única configuración de IdP. Además, el mismo contexto de traza que vincula las tareas compuestas de un agente LLM vincula las invocaciones MCP asociadas, haciendo que el desglose de costes por tarea y la depuración de extremo a extremo sean prácticos y no meramente teóricos.
La observabilidad utiliza el registro de solicitudes del Gateway mediante trazas. El recuento de tokens, costes, latencia (TTFT y total), decisiones de guardrails, resoluciones de políticas y la atribución por equipo y aplicación se registran en cada llamada, se almacenan como trazas y son accesibles a través de proyectos de trazado con su propio RBAC. La exportación de telemetría sigue estándares abiertos: exportación de datos en OpenTelemetry junto con la exportación de registros y trazas a sistemas externos como Grafana, Datadog y Prometheus, permitiendo integrar la plataforma con sus herramientas de observabilidad existentes sin necesidad de aprender una solución propietaria. Los cuadros de mando de costes funcionan en tiempo real y se pueden compartir con los responsables de equipo mediante roles RBAC de solo lectura. Este mismo almacenamiento de registros y trazas genera el conjunto de datos auditable sobre intentos de prompt injection, activaciones de políticas y patrones de abuso que los clientes pueden analizar para perfeccionar sus guardrails con el tiempo.
Su infraestructura de observabilidad actual sigue siendo su infraestructura de observabilidad.
El rendimiento comprobado que respalda todo esto: 10.000 millones de solicitudes al mes procesadas entre toda la base de clientes, más de 1.000 clusters de Kubernetes gestionados por la plataforma, una latencia adicional en el gateway inferior a 10 ms p95 (TTFT) y más de 350 RPS sostenidos en un solo vCPU. Entre los clientes con despliegues en producción se encuentran Resmed, Siemens Healthineers, Automation Anywhere, Zscaler y Nvidia. La ronda Series A fue liderada por Intel Capital en febrero de 2025, alcanzando una financiación total de aproximadamente 21 millones de dólares con la participación de Peak XV Partners (Surge), Eniac Ventures y Jump Capital.
Escala de producción, no escala de piloto.
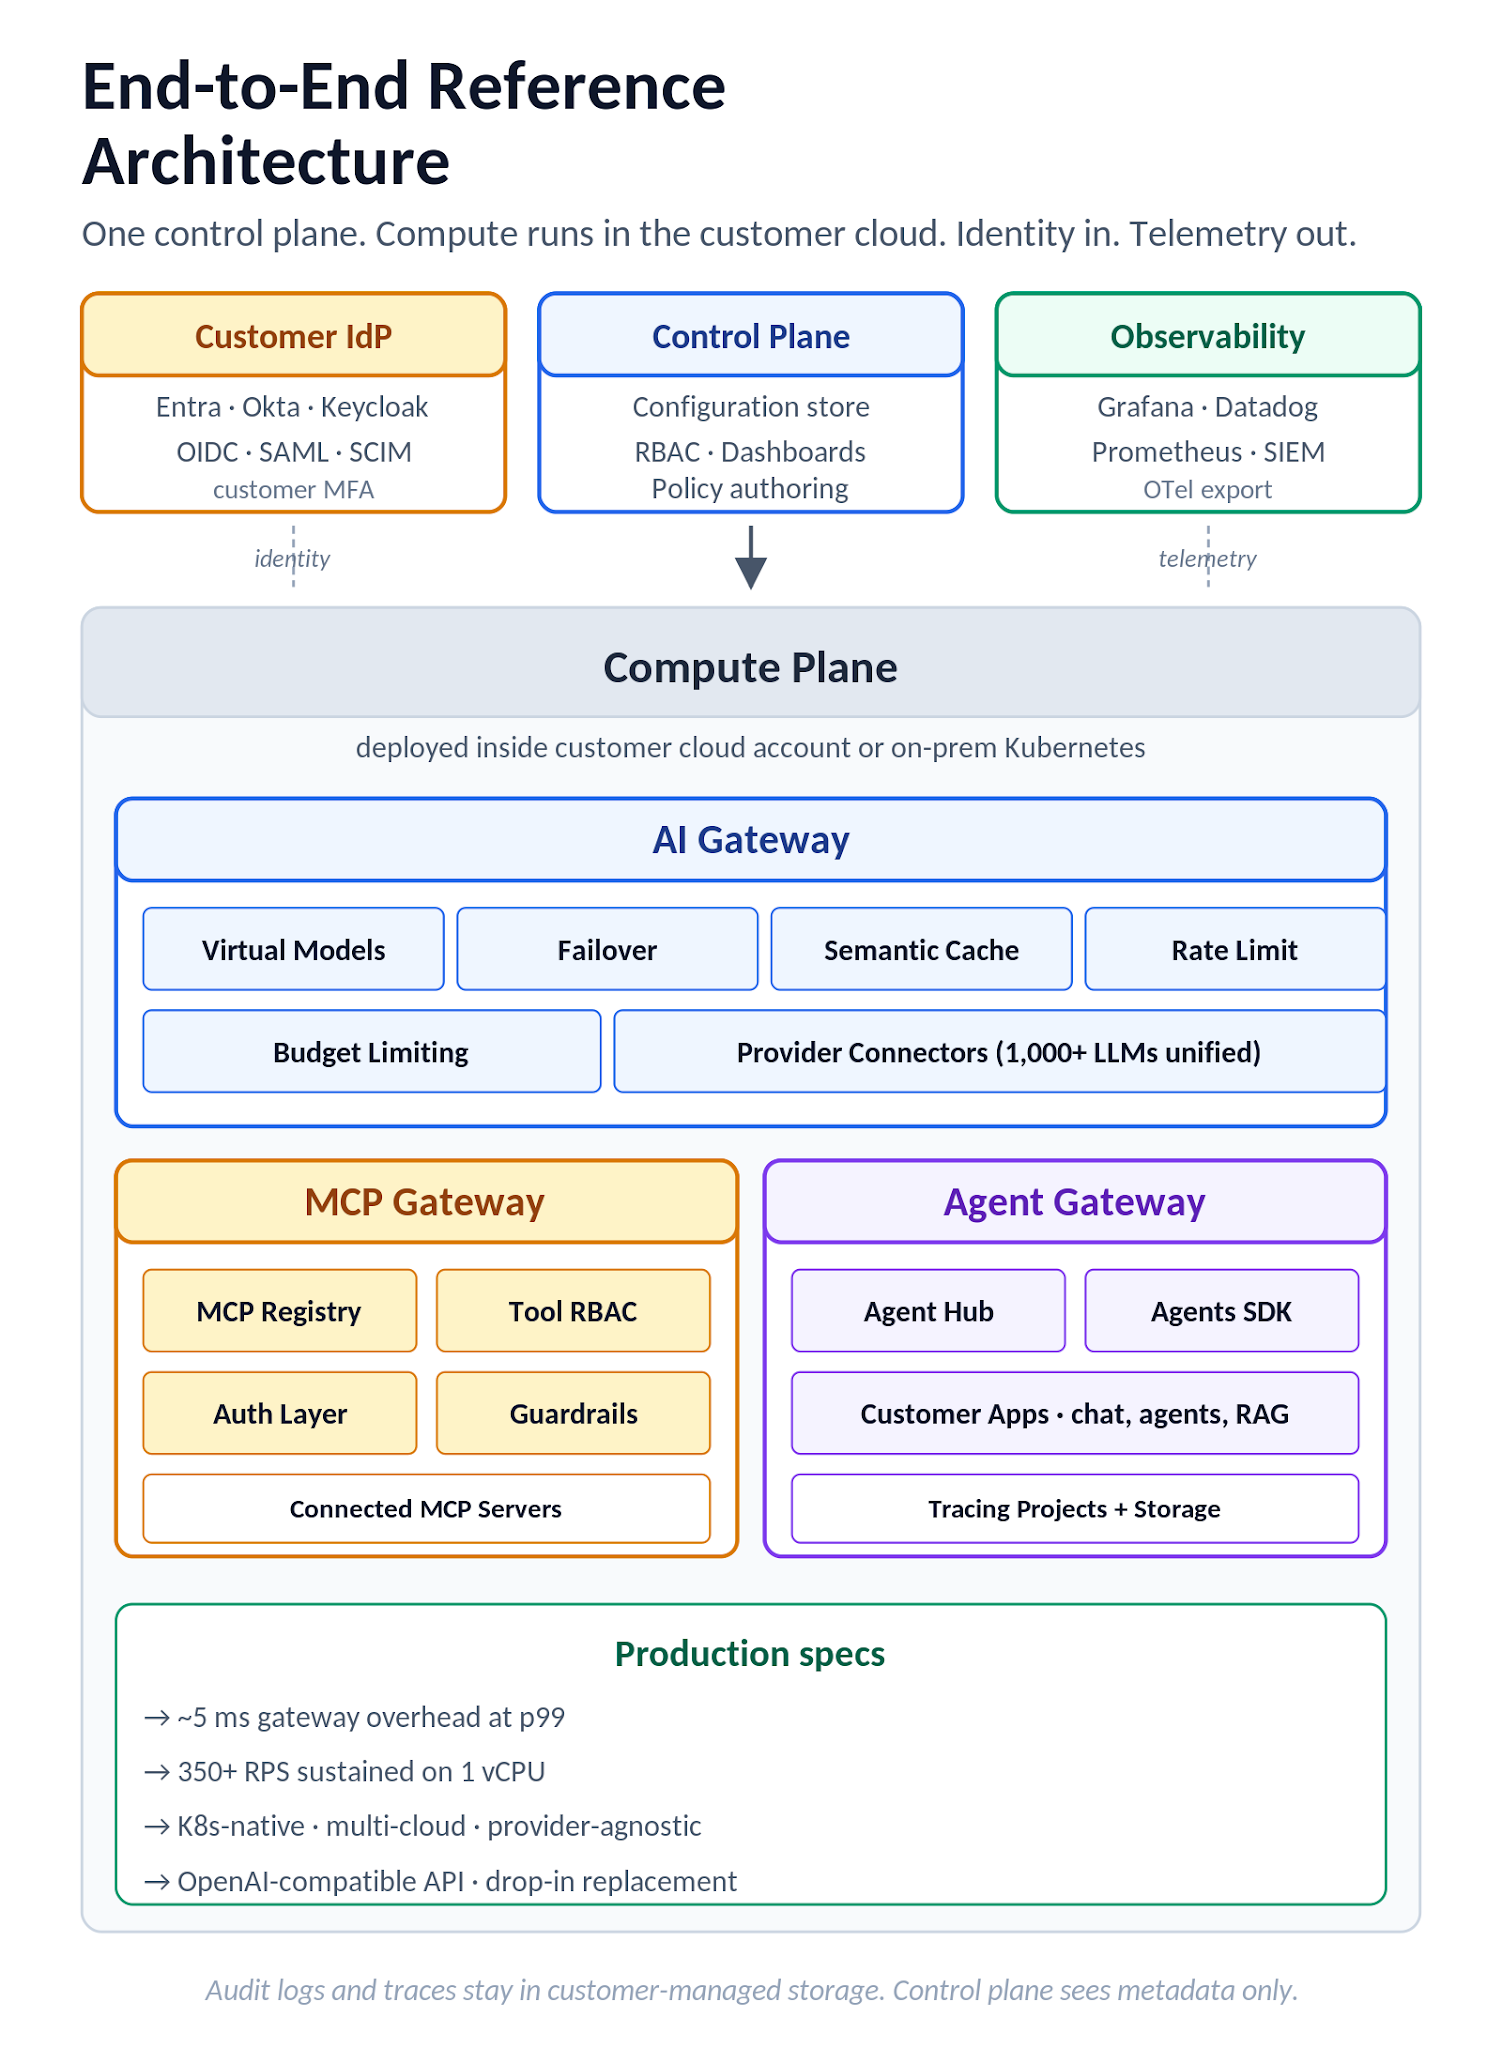
Figura 8. Arquitectura de referencia de extremo a extremo de TrueFoundry: plano de control, plano de cómputo (con AI Gateway, MCP Gateway, Agent Gateway y Customer Apps), IdP del cliente y destinos de observabilidad.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada





