Blank white background with no objects or features visible.

Hallo EMEA! TrueFoundry baut seine Präsenz in Europa, dem Nahen Osten und Afrika weiter aus. Mehr erfahren. →

LLM Cost Tracking Solution für Enterprise Observability, Governance & Optimierung

von Deepti Shukla

Aktualisiert: November 3, 2026

Published: April 20, 2026

 LLM Cost Tracking Solution For Enterprise Observability, Governance & Optimization

Warum jedes Unternehmen eine robuste LLM Cost Tracking Solution benötigt

Da Unternehmen generative AI und Large Language Models (LLMs) in die Produktion bringen, wird das Kostenmanagement missionskritisch. Die tokenbasierte Preisgestaltung, die bei LLM-Anbietern üblich ist, bringt eine einzigartige Komplexität mit sich:

  • Mehrere LLMs mit unterschiedlichen Preisen—OpenAI, Claude, Mistral und self-hosted Modelle haben alle unterschiedliche Kosten pro Token.
  • Variable Nutzung nach Workflow, Benutzer oder Team—Jedes Produktfeature oder jede Benutzersitzung kann Token mit sehr unterschiedlichen Raten verbrauchen.
  • Gestaffelter Kontext und dynamische Pipelines—Funktionen wie Retrieval Augmented Generation (RAG), Toolchains und Agenten führen zu unvorhersehbarem Token-Wachstum.

Ohne eine dedizierte LLM Cost Tracking Solution fehlt den Teams die Transparenz, bis die Kosten unerwartet in die Höhe schnellen. Dies gefährdet Budgets und behindert Skalierungsbemühungen.

Hier erfahren Sie, wie Sie End-to-End-Tracking, Governance und Optimierung angehen—zusammen mit direkten, natürlichen Links zur TrueFoundry-Dokumentation für jedes Kernelement.

1. Einheitliche Observability

Der Aufbau eines robusten Cost Trackings beginnt mit der Erfassung umfassender, strukturierter Daten für jede LLM-Anfrage. Über das TrueFoundry AI Gateway können Sie den gesamten Inferenz-Traffic leiten, egal ob zu einem API-Modell (wie OpenAI, Claude oder Mistral) oder zu einem von Ihnen betriebenen self-hosted Modell. Dieses Gateway dient als Ihre zentrale Steuerungsebene ("Single Pane of Glass") für Observability und Kostenzuweisung.

Bei jeder Anfrage sollten Sie:

  • Metadaten wie Benutzer, Team, Umgebung und Feature für eine präzise Kostenzuweisung taggen (How to add metadata tags).
  • Token-Anzahlen, Anfragelatenz und das verwendete Modell erfassen und analysieren—dies bildet die Grundlage für Echtzeit-Chargeback, Showback und Ausgabenmanagement (Analytics and monitoring).
  • OpenTelemetry integrieren, um diese Metriken in Ihren bestehenden Observability-Stack einzubinden und LLM-Ausgaben mit dem allgemeinen Systemverhalten zu korrelieren.
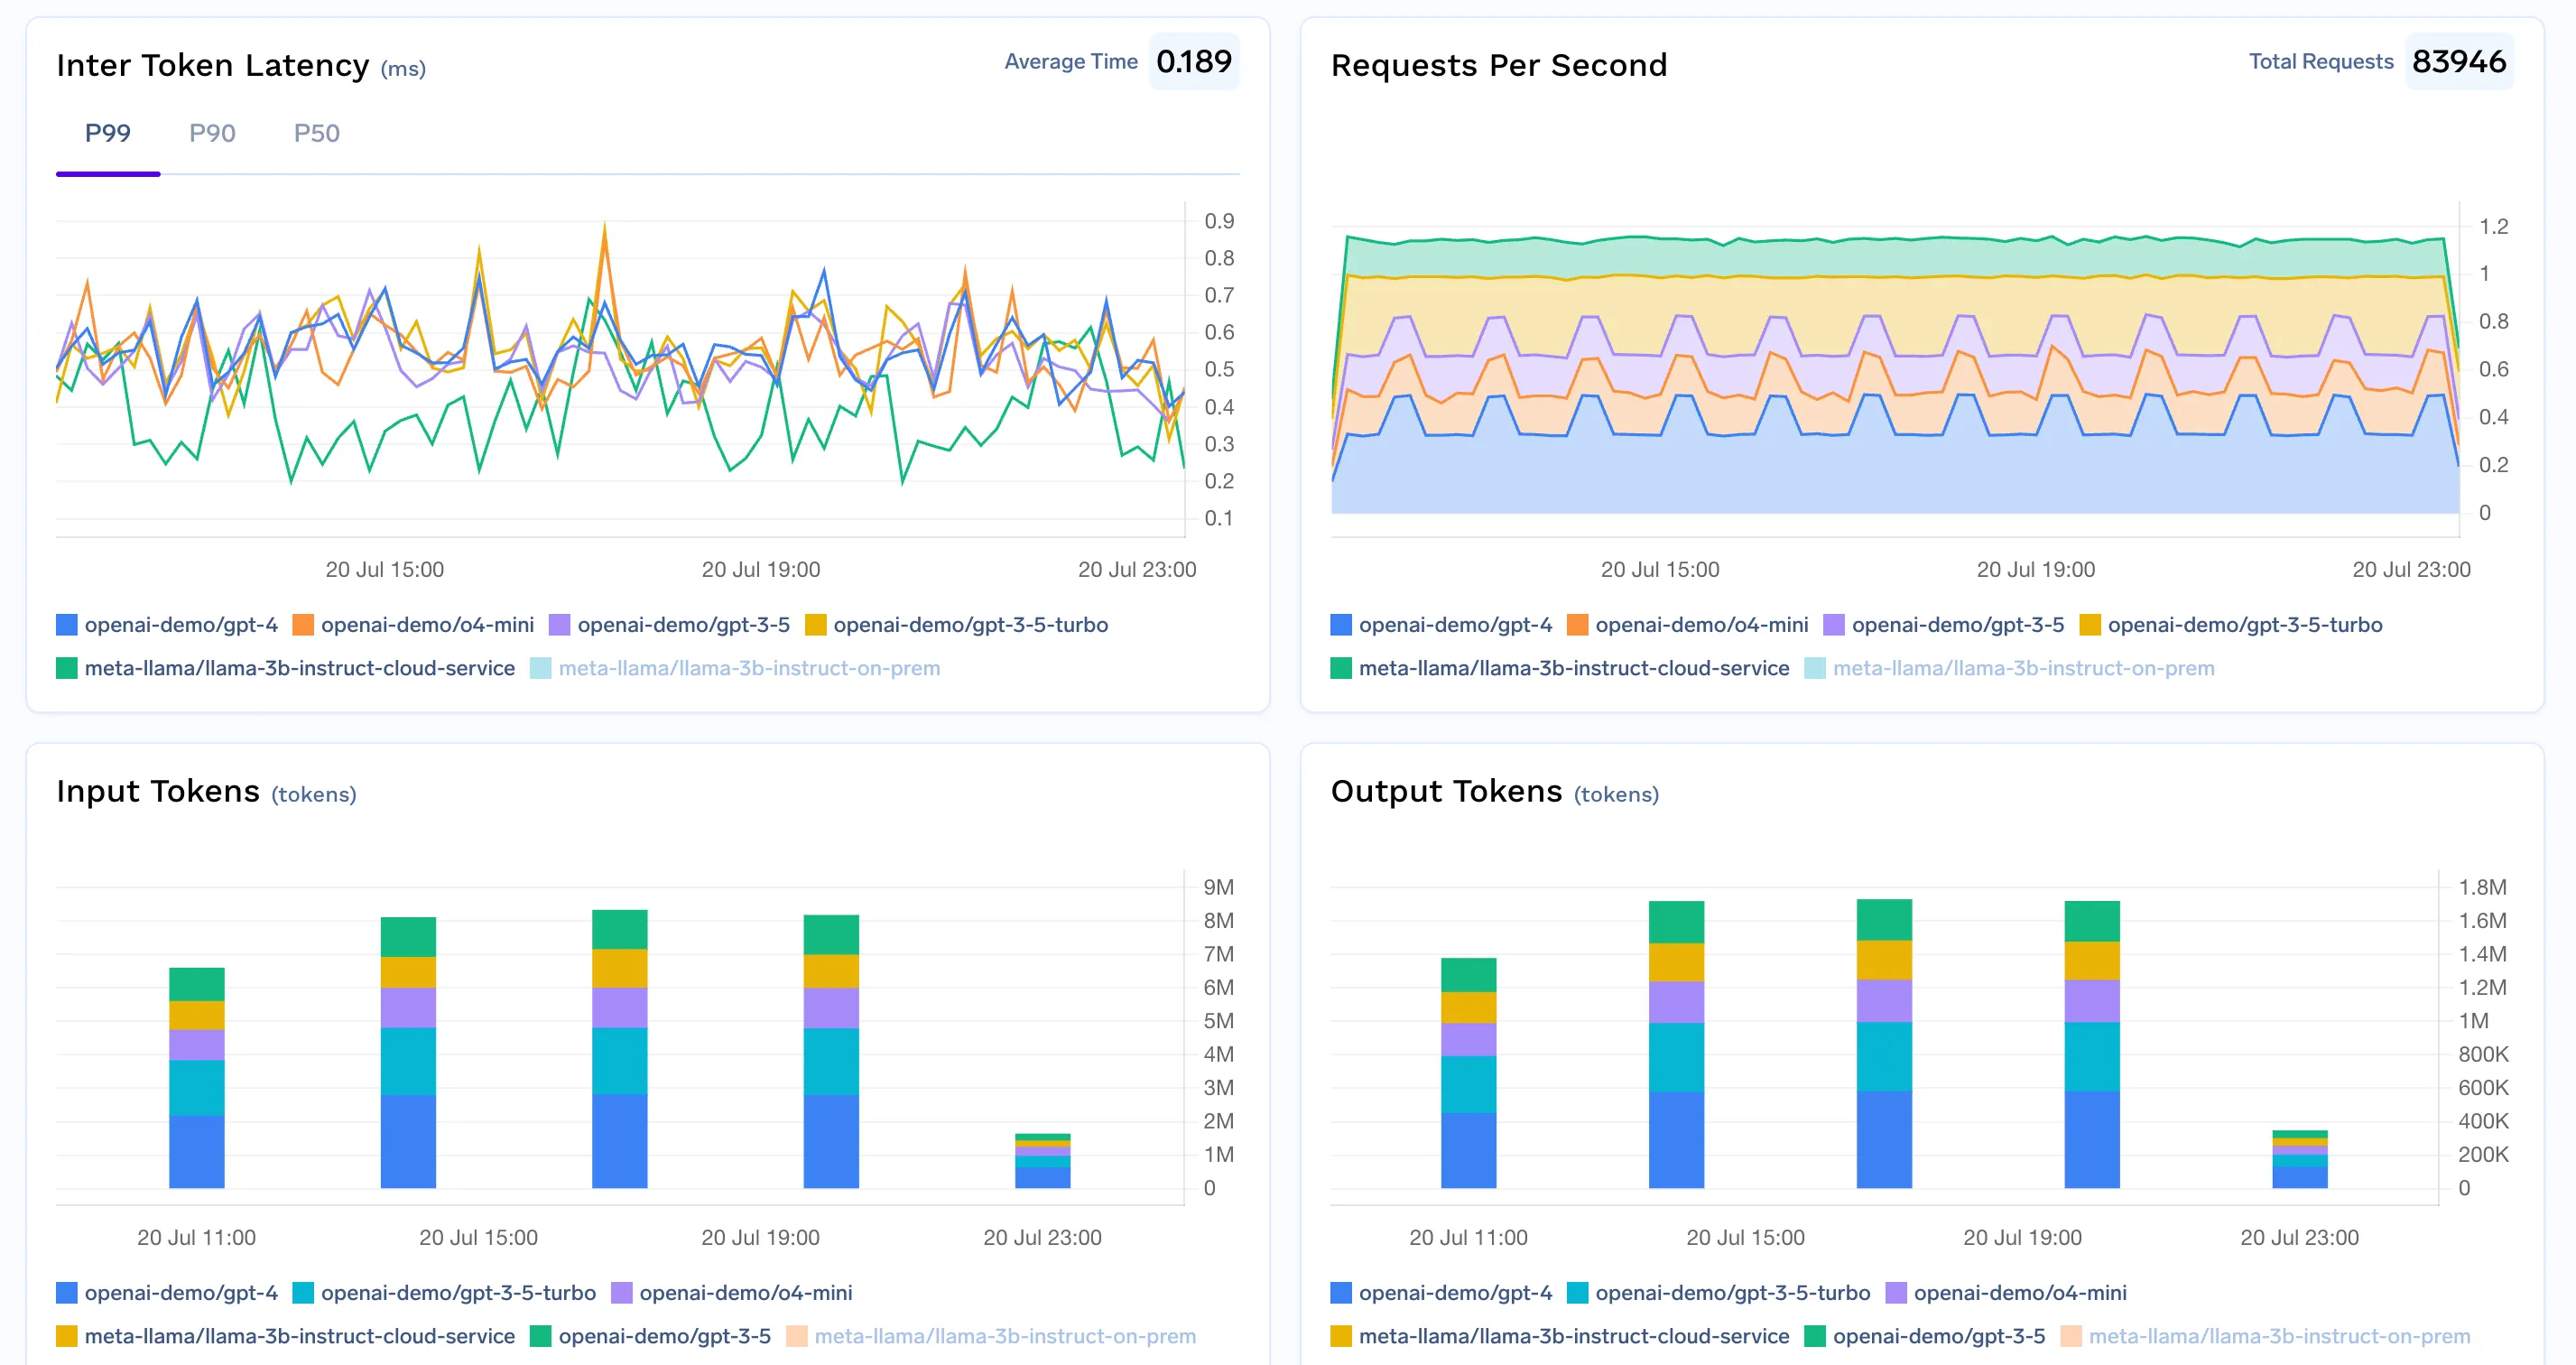
Truefoundry’s LLM cost tracking dashboard showing granular usage metrics, token spend, and model-level insights

2.  Governance

Eine umfassende LLM Cost Tracking Solution muss es Ihnen ermöglichen, Grenzen durchzusetzen, bevor Budgets überschritten werden.

  • Rate Limits: Richten Sie tägliche/monatliche Quoten nach Benutzer, Team, Umgebung, Modell oder sogar benutzerdefinierten Metadaten ein (Rate Limiting Guide). Dies hilft, unkontrollierte Workloads zu verhindern, die Ausgaben in die Höhe treiben.
  • Budgetdeckel & automatisierte Durchsetzung: Konfigurieren Sie Regeln, sodass bei Überschreitung des Budgets durch ein Team oder Feature Anfragen automatisch blockiert oder Manager benachrichtigt werden (Budget Enforcement).
  • Zugriffskontrolle: Beschränken Sie kostenintensive oder experimentelle Modelle auf die Teams und Workflows, die sie wirklich benötigen (Access policies).
  • Guardrails: Blockieren Sie unsichere oder kosteneffiziente Prompts und verhindern Sie unbeabsichtigtes Prompt-Wachstum (Guardrails Overview).

Zusammen verwandeln diese Governance-Funktionen das Logging in eine aktive, durchsetzbare LLM Cost Tracking Solution, die Überschreitungen von Grund auf verhindert—nicht erst durch rückwirkende Berichte.

3. Kontinuierliche Optimierung: Machen Sie Ihre LLM Cost Tracking Solution dynamisch

Nach Observability und Governance ist die Optimierung der fortlaufende Prozess zur Reduzierung von Ausgaben, ohne Leistung oder Qualität zu beeinträchtigen.

  • Load Balancing und Smart Routing: Nutzen Sie das Load Balancing von TrueFoundry, um Anfragen an das kosteneffizienteste Modell zu senden. Zum Beispiel können einfache Abfragen an Mistral oder ein feingetuntes kleines Modell gesendet werden, während komplexe Anfragen an GPT-4 geroutet werden.‍
  • Semantisches Caching: Diese Technik speichert und wiederverwendet LLM-Ergebnisse basierend auf der semantischen Ähnlichkeit von Abfragen. Sie ist jedoch nicht weit verbreitet, da sie aufgrund subtiler Unterschiede im Prompt-Kontext zu erhöhter Unsicherheit oder Variabilität in den Modellantworten führen kann.‍
  • Caching und Batching: Nutzen Sie die Batch Prediction API, um wiederholte Abfragen zu minimieren und ähnliche Anfragen zu aggregieren, was die Token-Kosten drastisch senkt.‍
  • Prompt Engineering und strukturierte Ausgaben: Verwenden Sie die Structured Schema Tooling, um ausführliche/unvorhersehbare LLM-Ausgaben zu begrenzen und Kosten zu stabilisieren.‍
  • Modell-Fine-Tuning: Für wiederkehrende, domänenspezifische Workflows nutzen Sie TrueFoundry's Fine-Tuning Workflows, um Prompts zu verkürzen und Anfragen für Ihren Geschäftskontext zu komprimieren.‍
  • Self-Hosting: Wenn sich Workflows stabilisieren und das Volumen wächst, kann die Ausführung von Open-Source-LLMs (wie Mistral oder Llama) über Self-Hosted Deployment die API-Raten pro Token drastisch unterbieten—und das alles unter Verwendung derselben Observability- und Policy-Tools.

4. Wichtige Metriken: Was Sie in Ihrer LLM Cost Tracking Solution nachverfolgen sollten

Eine erfolgreiche Kostenoptimierung basiert auf einer aufmerksamen Messung. Die folgenden Metriken sind in Ihrem gesamten Stack von zentraler Bedeutung:

  • Token pro Anfrage: Normalisiert und vergleicht Nutzungsmuster.
  • Kosten pro Benutzer/Team/Feature: Ermöglicht Showback- und Chargeback-Berichte für interne Rechenschaftspflicht.
  • Cache Hit Ratio: Zeigt auf, wie viel Ausgaben durch intelligentes Caching eingespart werden.
  • An Anfragen geroutet, die an teure Modelle gingen: Hilft Ihnen, nicht-essentiellen Traffic auf günstigere Optionen zu verlagern.
  • Kostenspitzen/Anomalien: Ermöglicht das Erkennen von Regressionen, Fehlkonfigurationen oder möglichem Missbrauch.
    Alle diese Daten können automatisch mit TrueFoundry Analytics erfasst und visualisiert werden.

5. Wann Sie LLMs im Rahmen Ihrer LLM Cost Tracking Solution selbst hosten sollten

  • Wenn Ihr Unternehmen über eine vorhersehbare, hochvolumige LLM-Nutzung verfügt, können die Einsparungen durch selbst gehostete Open-Source-Modelle erheblich sein.
  • Das Multi-Cloud LLM Gateway und die Self-Hosted Deployment Guides von TrueFoundry stellen sicher, dass Monitoring-, Governance- und Routing-Logik für externe APIs und Ihre internen Cluster identisch funktionieren.
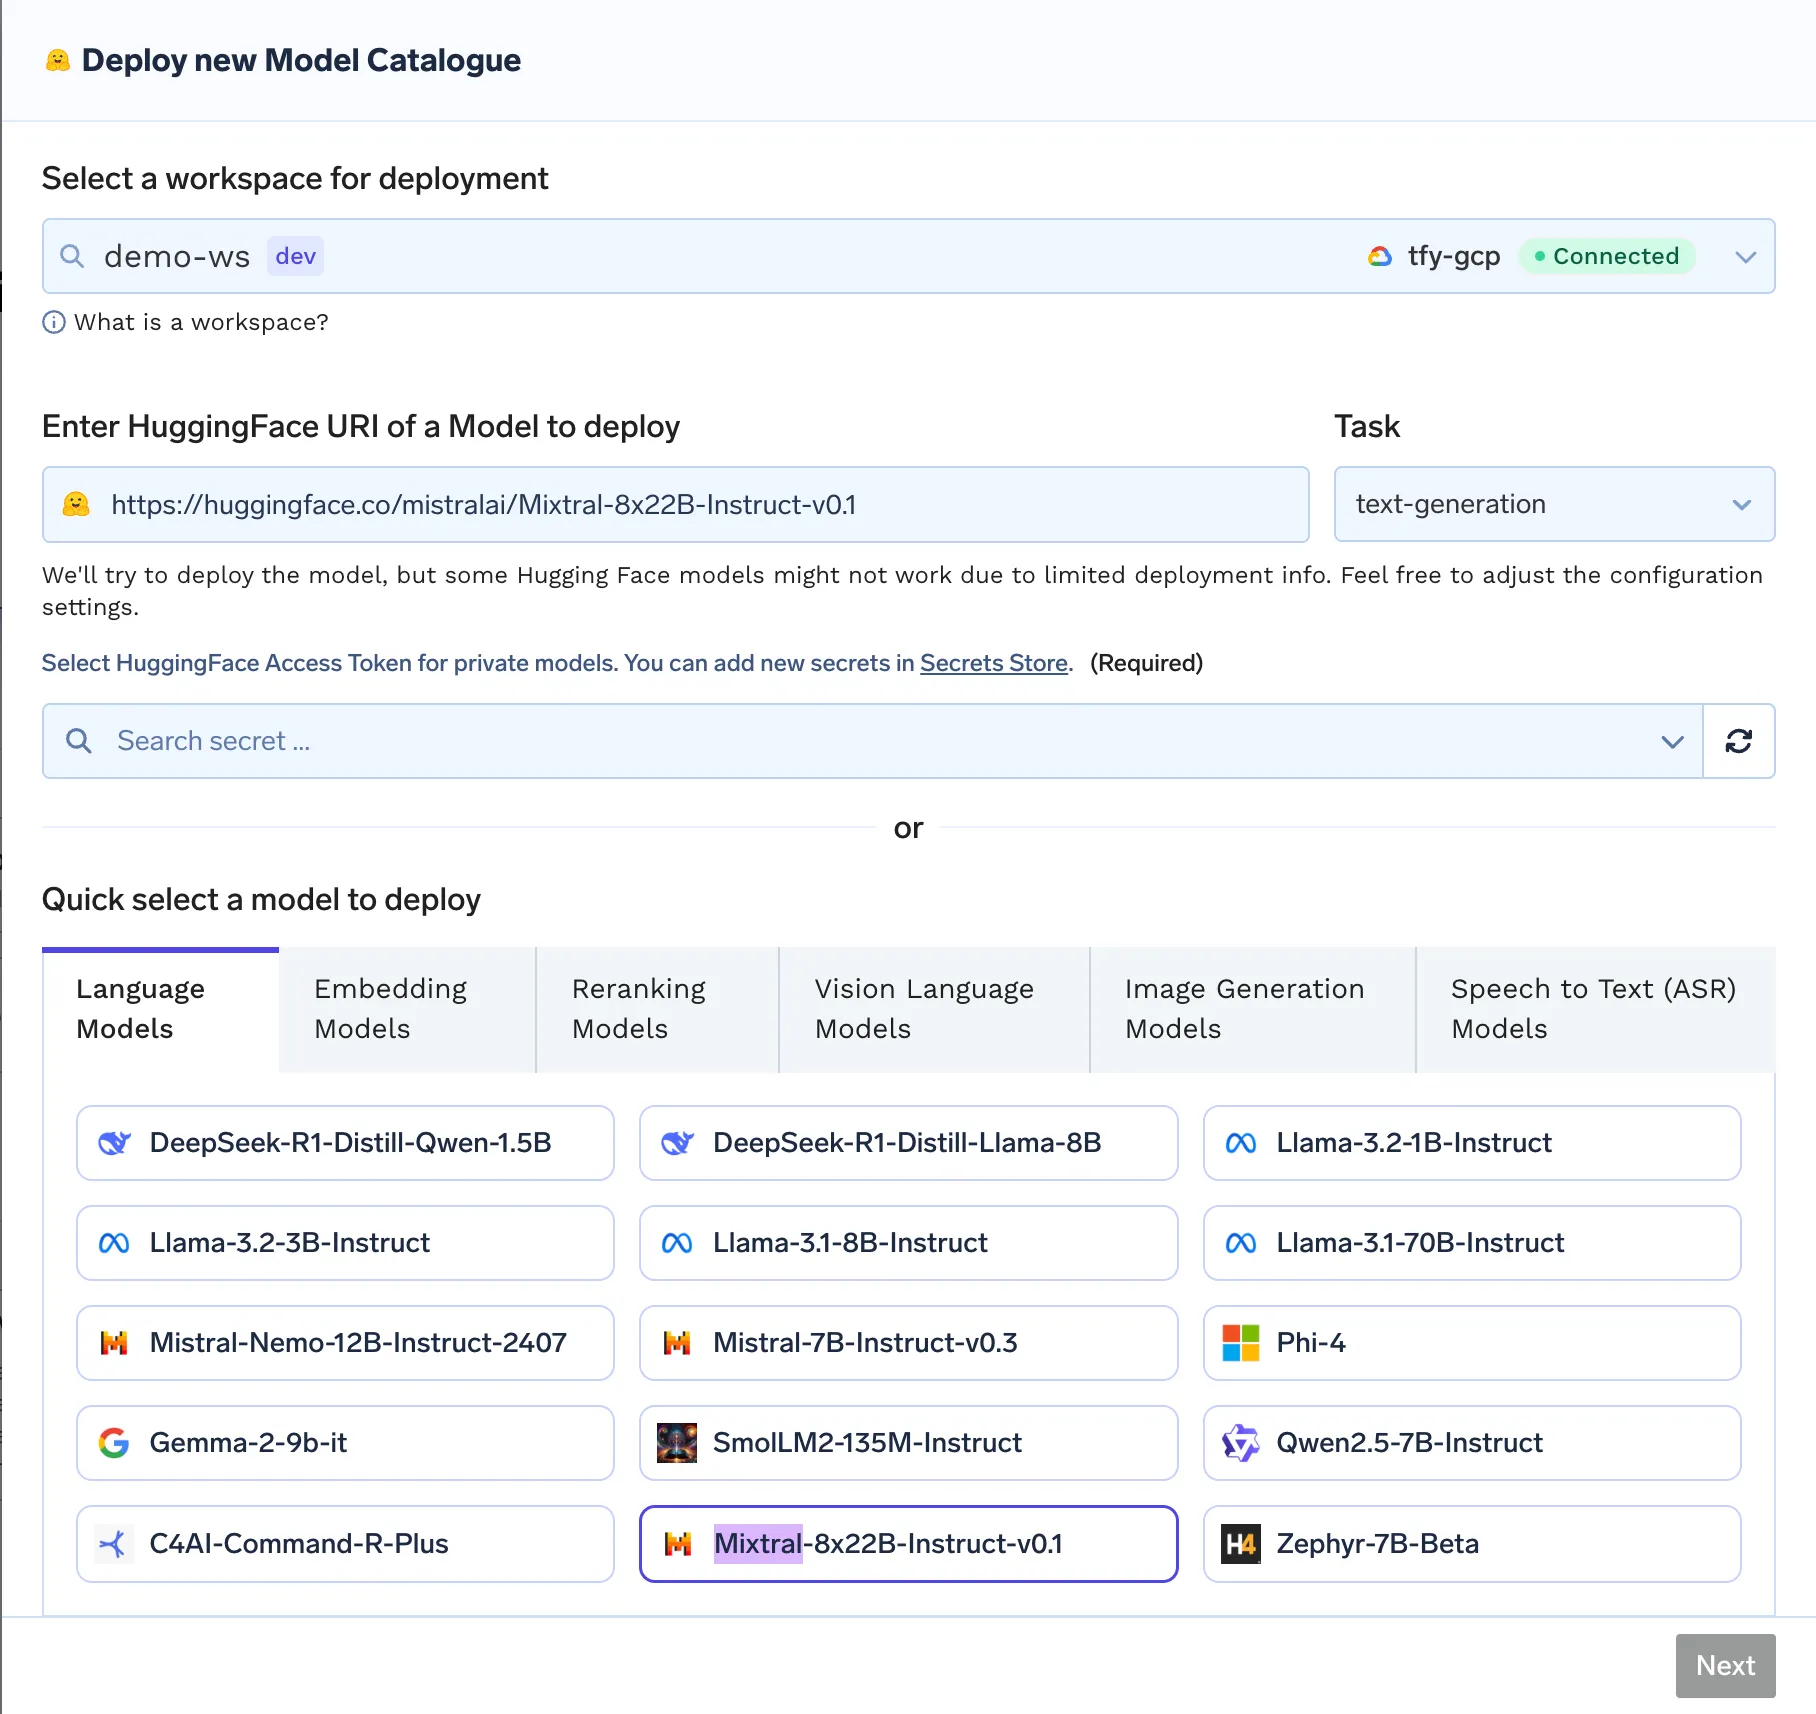
Truefoundry’s LLM model deployment dashboard for self-hosted models with governance and cost tracking

6. Best Practices für LLM Cost Tracking Solutions

  • Zentralisieren Sie den gesamten Inferenz-Traffic über ein Gateway mit aktivierter Observability.
  • Automatisieren Sie Tagging und Budget-Alerts für eine detaillierte Kostenaufschlüsselung nach Feature, Team oder Workflow.
  • Überprüfen und passen Sie Rate Limits und Zugriffsrichtlinien regelmäßig an, wenn sich Ihr Modell-, Team- und Feature-Mix weiterentwickelt.
  • Überwachen und beheben Sie Sicherheitsrisiken und unkontrollierten Verbrauch, insbesondere bei self-hosted Modellen oder Modellen mit hohen Berechtigungen.
  • Verwenden Sie Batch Prediction und Prompt-Validierung, um eine effiziente Ressourcennutzung zu gewährleisten und Token-Lecks zu vermeiden.

Fazit

Eine moderne LLM Cost Tracking Solution ist mehr als nur eine nachträgliche Berichterstattung—sie ist eine strategische Control Plane für jede Phase des AI-Deployments, von der täglichen Governance bis zur fortlaufenden Optimierung. Durch die Nutzung der umfassenden Funktionen von TrueFoundry's AI Gateway erhalten Teams granulare Transparenz, proaktive Ausgabenkontrollen und kostenbewusstes Routing für jedes verwendete LLM, egal ob über API oder self-hosted Cluster.

Für einen schrittweisen technischen Einblick siehe:

Häufig gestellte Fragen (FAQs)

Was ist eine LLM Cost Tracking Solution?

Eine LLM Cost Tracking Solution ist eine strategische Control Plane zur Überwachung, Verwaltung und Optimierung der spezifischen Ausgaben im Zusammenhang mit dem Betrieb von Large Language Models. Im Gegensatz zu traditioneller Cloud-Infrastruktur verfolgt sie gezielt tokenbasierte Preise, variable Inferenzlasten und rechenintensive Ressourcen. Diese Plattformen bieten Echtzeit-Transparenz über die Ausgaben bei mehreren Anbietern, Modellen und Teams.

Warum ist das Tracking von LLM-Nutzungskosten wichtig?

Das Tracking von LLM-Nutzungskosten ist entscheidend, da die Ausgaben für die AI-Infrastruktur aufgrund verbrauchsbasierter Token-Preise exponentiell und unbemerkt steigen können. Ohne granulare Überwachung drohen Unternehmen massive Budgetüberschreitungen, unvorhersehbare monatliche Abrechnungen und fehlende finanzielle Rechenschaftspflicht. Effektives Tracking sichert nachhaltiges Wachstum, indem jeder ausgegebene Dollar direkt mit messbarem Geschäftswert und ROI verknüpft wird.

Welche LLM Cost Tracking Tools sollten in Betracht gezogen werden?

Es gibt mehrere spezialisierte Tools und Plattformen, die derzeit führend bei der Verwaltung und Nachverfolgung von LLM-Kosten sind. TrueFoundry bietet ein einheitliches AI Gateway für Ausgabenmanagement und Governance über mehrere Modelle hinweg. Andere prominente Lösungen sind LiteLLM, das einen leichtgewichtigen Proxy für Echtzeit-Ausgabentransparenz bietet, und Portkey, das sich auf eine detaillierte Kostenzuweisung für generative AI-Anwendungen konzentriert.

Bieten LLMOps-Plattformen ein integriertes Cost Tracking?

Ja, die meisten fortgeschrittenen LLMOps-Plattformen integrieren nativ eine LLM Cost Tracking Solution, um den gesamten Modelllebenszyklus zu verwalten. Plattformen wie TrueFoundry und Weights & Biases erfassen detaillierte Telemetriedaten über Produktionsumgebungen hinweg und zeigen Token-Kosten zusammen mit Leistungsmetriken an. Diese native Integration ermöglicht es Entwicklern, sowohl die Genauigkeit als auch die finanzielle Effizienz innerhalb eines einzigen, einheitlichen Workflows zu optimieren.

Wie benachrichtigt mich eine LLM Cost Tracking Solution, wenn die LLM-Ausgaben einen Schwellenwert überschreiten?

LLM Cost Tracking Solutions nutzen Echtzeit-Monitoring, um automatisierte Benachrichtigungen per E-Mail, Slack oder Webhooks auszulösen, sobald die Nutzung festgelegte Prozentsätze eines Budgets erreicht. Diese Systeme können mit automatisierten Durchsetzungsregeln konfiguriert werden, die den Traffic drosseln oder Anfragen blockieren, sobald eine Obergrenze erreicht ist. Diese proaktive Alarmierung verhindert unkontrollierte Workloads und stellt sicher, dass finanzielle Leitplanken bestehen bleiben.

Was macht TrueFoundry zu einer idealen LLM Cost Tracking Solution?

TrueFoundry ist eine ideale LLM Cost Tracking Solution, da es Echtzeit-Kostenzuweisung mit tiefem, metadatengesteuertem Kontext kombiniert. Es ermöglicht Unternehmen, benutzerdefinierte Preise pro Modell zu definieren und granulare Budget-Schwellenwerte für bestimmte Teams, Projekte oder Umgebungen festzulegen. Das AI Gateway optimiert die Ausgaben weiter durch Smart Routing, semantisches Caching und automatische Modell-Fallbacks und stellt so eine hohe Leistung zum niedrigstmöglichen Preis sicher.

Try now.

One gateway for all your models, MCP servers, and agents. No credit card needed.

Melde dich an
Inhaltsverzeichniss

Steuern, implementieren und verfolgen Sie KI in Ihrer eigenen Infrastruktur

Buchen Sie eine 30-minütige Fahrt mit unserem KI-Experte

Eine Demo buchen

Der schnellste Weg, deine KI zu entwickeln, zu steuern und zu skalieren

Demo buchen
Summarize with
ChatGPT logo by OpenAI
Perplexity AI logo
Blurry red snowflake on white background, symmetrical frosty design with soft edges and abstract shape.

Entdecke mehr

October 5, 2023
|
Lesedauer: 5 Minuten

<Webinar>GenAi Showcase for Companies

Best Fine Tuning Tools for Model Training
May 3, 2024
|
Lesedauer: 5 Minuten

Die 6 besten Fine-Tuning-Tools für das Modelltraining im Jahr 2026

May 25, 2023
|
Lesedauer: 5 Minuten

Open-Source-LLMs: Nutzen oder untergehen

August 27, 2025
|
Lesedauer: 5 Minuten

Kartierung des On-Prem-AI-Marktes: Von Chips bis zu Control Planes

November 14, 2026
|
Lesedauer: 5 Minuten

Claude Managed Agents vs LangChain Deep Agents: Which Agent Harness Should You Choose?

Keine Artikel gefunden.
November 13, 2026
|
Lesedauer: 5 Minuten

Claude Managed Agents vs TrueForge: Which Agent Harness Should Enterprise Teams Run in 2026

Keine Artikel gefunden.
 What is an LLM Gateway
November 13, 2026
|
Lesedauer: 5 Minuten

Was ist ein LLM Gateway? Ein kompletter Leitfaden

Technik und Produkt
November 13, 2026
|
Lesedauer: 5 Minuten

Helm Charts auf ArtifactHub über Hosting auf GitHub Pages

Technik und Produkt
Keine Artikel gefunden.

Aktuelle Blogs

Black left pointing arrow symbol on white background, directional indicator.
Machen Sie eine kurze Produkttour
Produkttour starten
Produkttour