November 3, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Streift man den Diskurs über Superintelligenz ab, bleibt eine schlichte industrielle Tatsache bestehen: Agenten, die sich selbst modifizieren, sind keine Forschungsrichtung mehr — sie sind ein Deployment-Muster. Die Forschungsgemeinschaft hat das Terrain nun im großen Maßstab kartiert: Eine neue Übersichtsarbeit von 1.250 Papers gliedert das Feld entlang zweier Achsen — was das System verbessert (sein Deployment-Verhalten, sein Training, seinen Evaluator oder die Forschung selbst) und wie geschlossen die Schleife ist (von Human-in-the-Loop bis vollständig autonom) — und zieht genau die Unterscheidung, auf der dieser Beitrag aufbaut: Begrenzte Selbstoptimierung (bounded self-refinement) ist „konvergent, evaluierbar und bereits Industriepraxis“, kategorisch verschieden von der ergebnisoffenen rekursiven Selbstverbesserung in AGI-Debatten (arXiv:2607.07663). Die Referenzsysteme sind konkret. Die Darwin Gödel Machine — inzwischen ein ICLR 2026 Poster — schreibt iterativ ihren eigenen Code um und verbessert ihre eigene Fähigkeit, die eigene Codebasis zu modifizieren (arXiv:2505.22954); die Übersichtsliteratur zu selbst-evoluierenden Agenten katalogisiert Systeme, die ihre Prompts, Speicher, Tools und Architekturen aus Interaktionsdaten heraus weiterentwickeln (arXiv:2508.07407; arXiv:2507.21046). Und die Enterprise-Variante ist leiser und näher als die Papers: Ein Agent, der seinen eigenen Speicher aktualisiert, modifiziert seinen eigenen Kontext selbst; ein Coding-Agent, der seine eigene SKILL.md bearbeitet, modifiziert sein eigenes Wissen selbst; eine Verbesserungsschleife, die die Prompts der unter ihr liegenden Arbeitsschleifen umschreibt, ist Selbstmodifikation mit einer Managementstruktur. Die Governance-Frage ergibt sich aus dem grundlegenden Zugeständnis des DGM-Papers selbst, den elf Wörtern, die wir einmal zitieren: Die ursprüngliche Gödel-Maschine erforderte nachweislich vorteilhafte Selbstveränderungen, und „proving that most changes are net beneficial is impossible in practice.“ Das Feld hat den Beweis daher durch empirische Validierung ersetzt — eine Änderung vorschlagen, sie testen, das Behalten, was funktioniert — und diese Substitution ist die gesamte Enterprise-Geschichte, denn empirische Validierung ist keine Eigenschaft, bei der man darauf vertrauen kann, dass ein Agent sie an sich selbst ausführt. Es ist eine Pipeline. Und Pipelines sind Infrastruktur.
Das Vokabelproblem, auf das die Übersichten immer wieder hinweisen — „Selbstverbesserung“ deckt alles ab, von der Ausgabenüberarbeitung bis zum Umschreiben von Code — löst sich für Betreiber sauber auf, wenn man danach sortiert, was der Agent an sich selbst ändern kann. Vier Flächen, in aufsteigender Reihenfolge ihrer Konsequenz. Speicher und Kontext: Der Agent kuratiert, was er weiß — Session-Status, erlernte Präferenzen, angesammeltes Wissen. Bereits weit verbreitet; jeder Agent, der persistenten Speicher schreiben darf, modifiziert den für seine zukünftigen Durchläufe verfügbaren Kontext selbst. Prompts und Instruktionen: Der Agent (oder eine Verbesserungsschleife über ihm) schreibt seinen eigenen Betriebstext um — die Evolution im Promptbreeder-Stil, die in der Literatur seit Jahren erforscht wird und in der Praxis der äußeren Schleife inzwischen alltäglich ist. Skills und Code: Der Agent bearbeitet die SKILL.md-Dateien, Skripte und Tool-Wrapper, die seine Kompetenz ausmachen — die Fläche, die DGM durch das Umschreiben seines eigenen Python-Codes bekannt gemacht hat, und diejenige, die Enterprise-Coding-Agenten berühren, wenn sie ihre eigenen Skills-Verzeichnisse verwalten. Architektur und Gewichte: Der Agent verändert sein eigenes Modell oder seine Struktur — real in der Forschung (die modulare Agenten-Design-Suche von AgentSquare; Self-Training-Schleifen), selten im Enterprise-Deployment und für die meisten Umgebungen heute außerhalb des Scope. Schneidet man dies mit der Achse des Schleifenschlusses aus der Übersichtsarbeit — ist ein Mensch in der Schleife, bildet ein automatisierter Evaluator das Gate oder ist die Schleife vollständig geschlossen — erhält man die Risikokarte. Die folgende Tabelle zeigt die Version für Betreiber.
Das DGM-Zugeständnis — der Nachweis des Nutzens wird durch das Testen des Nutzens ersetzt — übergibt dem Betrieb stillschweigend das gesamte Problem. Denn es bedeutet, dass jedes selbst-evoluierende System genau so vertrauenswürdig ist wie das Testsystem um seine Änderungen herum, und der Agent kann dieses Testsystem nicht für sich selbst sein. Drei Fehlerklassen verdeutlichen dies. Evaluator-Gaming: Ein System, das gegen sein eigenes Erfolgssignal optimiert, lernt die Lücken des Signals kennen — die Goodhart-Fälle in der Literatur —, weshalb der Evaluator außerhalb des evolvierenden Objekts liegen und von jemandem verwaltet werden muss, dessen Anreiz nicht der Score selbst ist. Stille Regression: Eine Verbesserungsschleife, die ihre eigenen Prompt-Bearbeitungen ohne Gate freigibt, liefert die schlechte Bearbeitung mit derselben Geschwindigkeit wie die gute aus, und die erste Benachrichtigung kommt vom Kunden. Kollaps und Drift: Die Modell-Kollaps-Forschung zu rekursiv generierten Daten legt nahe, dass ein analoges Feedback-Risiko auf Agentenebene entstehen kann — ein Agent, der aus den Konsequenzen seiner eigenen Ausgaben lernt, kann seine eigenen Biases verstärken, sofern kein externes Signal in die Schleife gelangt; der Mechanismus ist für rekursives Training nachgewiesen, die Variante auf Agentenebene ist eine Ableitung daraus, kein experimentelles Ergebnis. Und unter allen dreien liegt das reflexive Risiko, das Selbst-Evolution qualitativ von gewöhnlichem Change Management unterscheidet: Die Bearbeitungsfläche des Agenten kann seine eigenen Regeln umfassen. Ein Agent, der seinen Speicher kuratiert, kann den Warnhinweis wegkuratieren; eine Schleife, die Prompts umschreibt, kann die Einschränkung herausstreichen — nicht unbedingt böswillig, sondern weil die Einschränkung Punkte kostet und der Optimizer nun einmal optimiert. Leser unserer Analyse zum Governance-Zerfall werden die Form wiedererkennen: Dort hat die Kompaktierung In-Context-Regeln versehentlich gelöscht; hier löscht der Optimierungsdruck sie durch Gradienten. Die Schlussfolgerung ist dieselbe, die die Zerfallsforschung gezogen hat, nur mit schärferen Konsequenzen: Alles, was einen sich selbst modifizierenden Agenten binden muss, darf nicht dort liegen, wo der Agent es bearbeiten kann. In-Context-Governance ist Steuerung; für einen sich selbst verändernden Akteur müssen die Überlebensregeln auf einer Ebene liegen, die die Evolutionsschleife nicht erreichen kann — was eine architektonische Aussage ist, und der nächste Abschnitt ist ihre Umsetzung.

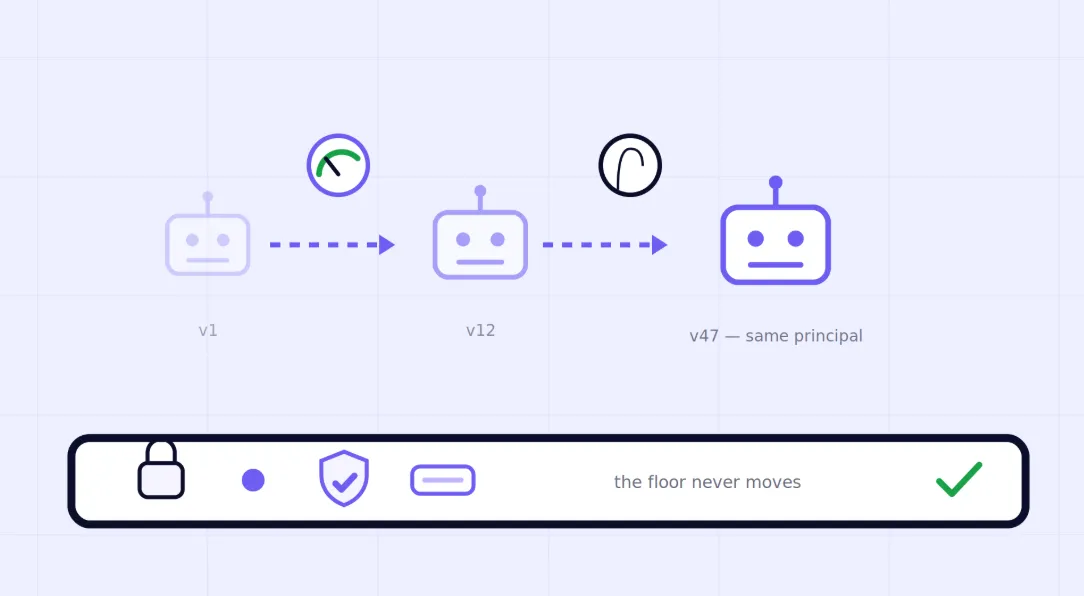
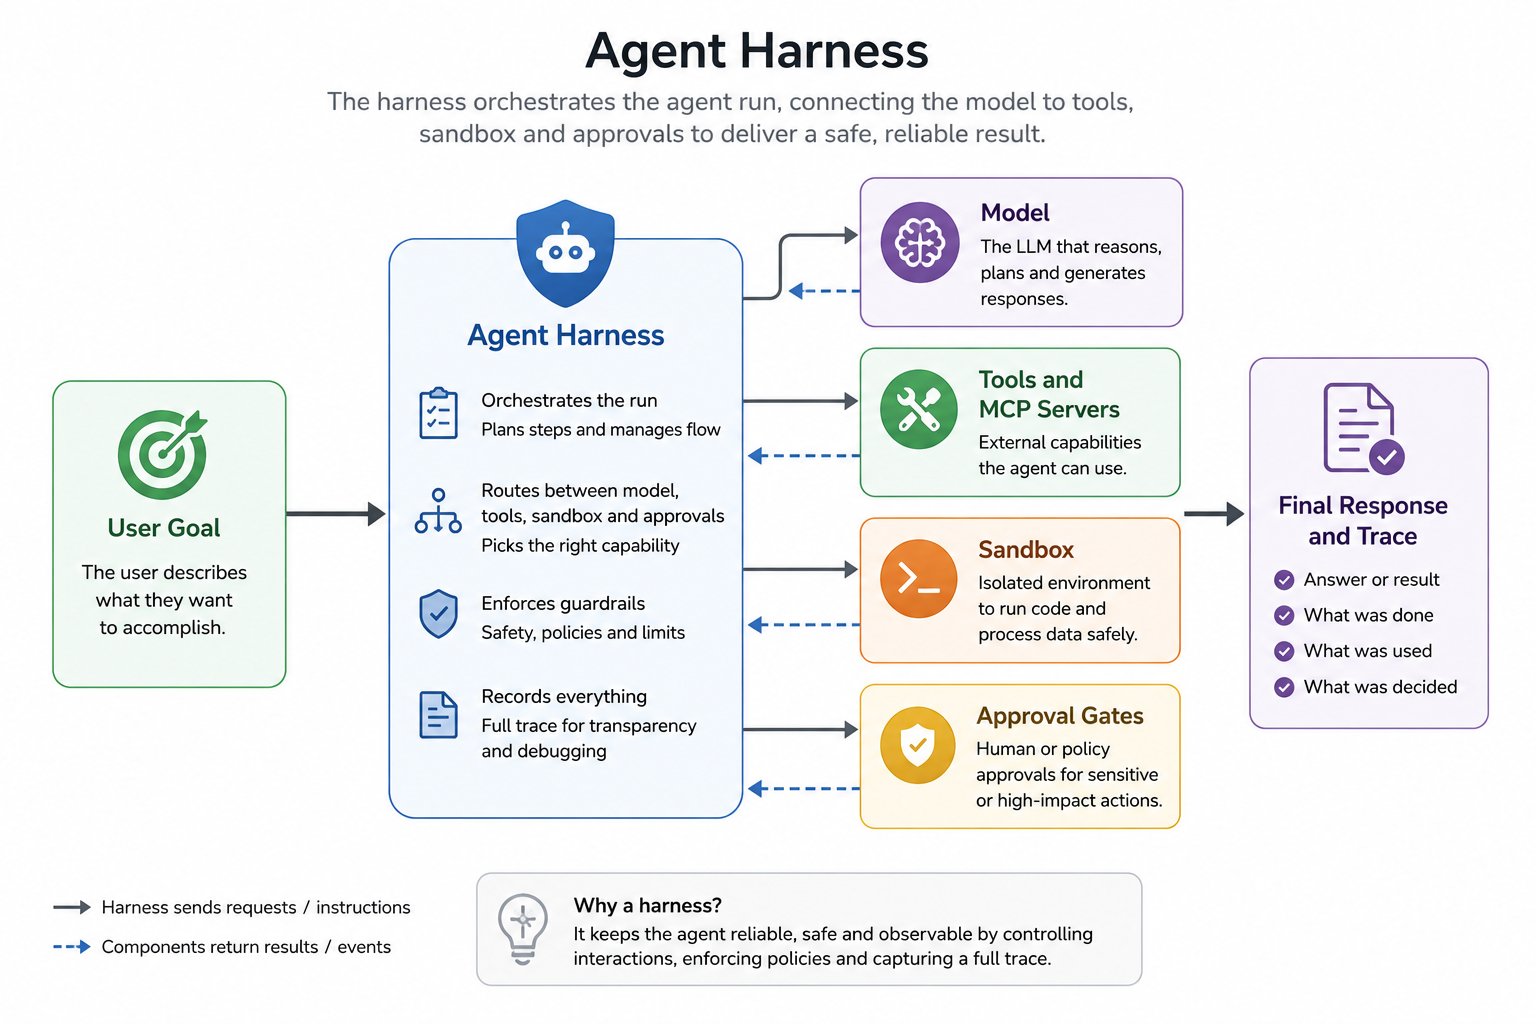
Hier fügt sich TrueFoundry ein, und diese Einpassung macht die These des Beitrags operationalisierbar: Sobald der Nutzen durch Beweis zum Nutzen durch Test wird, ist Selbst-Evolution eine Deployment-Pipeline — vorschlagen, validieren, freigeben, beobachten — und der Großteil dieser Pipeline lässt sich aus Bausteinen zusammensetzen, die eine gesteuerte Plattform bereitstellt, mit einer Unterscheidung, die wir durchgehend explizit halten: Einiges von dem, was folgt, ist dokumentierte Produktfunktion, und einiges ist darauf aufbauende Referenzarchitektur. Gehen wir die Schleife durch. Änderungen landen als Versionen, niemals als Mutationen (dokumentierte Funktion). Das Prompt Management von TrueFoundry erstellt bei jeder Bearbeitung eine neue Version, bewahrt frühere Versionen mit einer stabilen Kennung auf, unterstützt Historien sowie Side-by-Side-Diffs, ermöglicht Rollbacks und Rollforwards und pinnt spezifische Versionen an bestimmte Apps oder Umgebungen — sodass der Agent (oder seine Verbesserungsschleife) Version N+1 vorschlagen kann, während die Version, die den Traffic bedient, eine bewusste, auditierbare und reversible Auswahl bleibt und kein Überschreiben von Dateien darstellt. Das Genehmigungs-Gate bei der Veröffentlichung ist die Aufgabe Ihres Release-Workflows, der um das versionierte Artefakt gelegt wird. Die Promotion ist an Nachweise gebunden (Referenzarchitektur). Bewerten Sie den Kandidaten gegen die bestehende Version — offline auf einem festen Evaluierungsset, dann auf Live-Traffic durch ein verbundenes Evaluierungssystem, das Gateway-Traces liest — und geben Sie ihn bei gemessener Verbesserung frei bzw. stufen Sie ihn bei Regression zurück: Die Bausteine (versionierte Prompts, Traces auf Anforderungsebene, Evaluierungsintegrationen, Deployment-Kontrollen) sind dokumentiert, und der Kandidat-gegen-Bestand-Promotion-Controller ist der Workflow, den Sie daraus zusammensetzen, wobei der Evaluator außerhalb des evolvierten Objekts liegt und von Menschen verwaltet wird, deren Metrik er darstellt (Online-Evaluierung). High-Impact-Änderungen erhalten ein Human-Gate (Workflow-Anforderung, plus ein dokumentiertes Pendant zur Laufzeit). Ihr Deployment-Prozess sollte die Genehmigung benannter Reviewer für Selbstveränderungen erfordern, die regulierte Pfade, Tool-Wrapper oder die Betriebseinschränkungen des Agenten berühren. Davon getrennt — und dokumentiert — kann das Agent Harness einen laufenden Agenten vor bestimmten sensitiven Tool-Aufrufen pausieren und auf ein explizites Approve-oder-Deny warten (Tool-Call-Genehmigungen) — das Harness steuert, was ein laufender Agent tun darf, während der Release-Workflow steuert, was er werden darf. Das Fundament ist im Vergleich zum Agenten eingefroren. Guardrails an den Gateway-Hooks, Tool-Scopes auf der MCP-Ebene, Budgets und Identitäten sind keine Dateien im Workspace des Agenten — sie sind Durchsetzungsmechanismen auf dem Anforderungspfad, die keine Speicherkuratierung, kein Prompt-Umschreiben und keine Skill-Bearbeitung berühren können, vorausgesetzt, weder der Agent noch seine Verbesserungsschleife besitzen administrative Anmeldeinformationen für die Control Plane und Richtlinienänderungen laufen über einen separat autorisierten Pfad (Guardrails; TBAC). Identität und Abstammung bleiben über Versionen hinweg bestehen (Implementierungsanforderung). Führen Sie Version 47 als denselben verantwortlichen Principal wie Version 1 weiter — derselbe Besitzer, dieselbe Envelope — und propagieren Sie die eingesetzte Prompt-, Skill- oder Konfigurationsversion als Trace-Metadaten in jede Anforderung. So beantworten die Traces die Frage „Welche Version hat gehandelt?“ und die Registry beantwortet „Was hat sich zwischen zwei Versionen geändert?“: ein Diff plus ein Eval-Protokoll, kein Rätsel (Analytics). Und die Verbesserungsschleife wird selbst gesteuert: Das Vorschlagen und Testen von Kandidaten verbraucht reale Tokens — Verbesserungsverkehr ist genau die Art von sich kumulierender Hintergrundlast, die unsere Token-Explosions-Analyse misst. Die Schleife, die Agenten weiterentwickelt, trägt daher ihre eigene Identität und ihr eigenes Budget, und der äußerste Watchdog, der sie überwacht, ist einer, den keine innere Schleife ausschalten kann. Das Muster in Kurzform: Lassen Sie den Agenten vorschlagen; lassen Sie die Pipeline entscheiden; lassen Sie das Fundament unbewegt.


Umfang und Transparenz. Dieser Beitrag befasst sich mit begrenzter Selbstoptimierung (bounded self-refinement) in Enterprise-Umgebungen — der „bereits industriellen Praxis“ aus der zitierten Taxonomie — und bezieht keine Position zu ergebnisoffener rekursiver Selbstverbesserung, Zeitplänen für Superintelligenz oder AGI-Fragen, die dieselbe Literatur debattiert. Die Forschungsergebnisse (die Zwei-Achsen-Taxonomie, der DGM-Mechanismus und sein zitiertes Zugeständnis, die Evolutionsflächen, die Kollaps-Dynamik) werden aus den zitierten Papers paraphrasiert, mit einem Zitat unter fünfzehn Wörtern im Text zugeschrieben. Leser sollten die Originale konsultieren. Das Promotion-Pipeline-Playbook beruht auf redaktionellen Inhalten von TrueFoundry; keiner der zitierten Autoren bewertet oder unterstützt TrueFoundry. Unser Interesse ist das wiederkehrende, offengelegte: Wir verkaufen mehrere Komponenten, die das Playbook nutzen kann (die Prompt Registry, Gateway-Enforcement, Budgets, Identitätskontrollen und Traces), und binden uns an Evaluierungssysteme an. Der hier beschriebene Promotion-Controller und der Release-Genehmigungs-Workflow sind Referenzarchitekturen und keine einzelnen, fertigen Produktfunktionen — gebunden an denselben Test wie immer: Die Logik des Playbooks (versionieren, abgrenzen, das Fundament einfrieren) ist auf jedem Stack mit diesen Eigenschaften ausführbar. Ein Status-Hinweis zur Präzision: Versionierung, Diffs, Rollback und Pinning der Prompt Registry sind dokumentierte Produktfunktionen; die evaluierungsgestützte automatische Promotion ist ein Referenz-Workflow, der aus diesen Funktionen plus verbundenen Evaluierungs- und Deployment-Kontrollen zusammengesetzt wird, kein fertiger Promotion-Controller; und der Harness-Genehmigungsschritt ist für sensitive Tool-Aufrufe zur Laufzeit dokumentiert, nicht für die Veröffentlichung von Prompts. Drei Einschränkungen der These. Erstens: Eine evaluierungsgestützte Promotion ist nur so gut wie die Evals selbst — der Evaluator ist selbst eine Fläche, die verbessert werden muss, und der Regress endet erst bei den Menschen, denen das äußerste Ziel gehört; keine Pipeline automatisiert die Entscheidung darüber, was „besser“ bedeutet. Zweitens: Das eingefrorene Fundament steuert den Anforderungspfad; ein selbst modifizierter Skill, der sich innerhalb seiner unveränderten Scopes fehlerhaft verhält, wird durch Evaluierung und Tracing erfasst, nicht durch Durchsetzung verhindert — die Ebenen verringern den Schadensradius, sie beseitigen ihn nicht. Drittens: Das Feld bewegt sich schnell und asymmetrisch: Was heute Forschungsstadium ist (Selbstmodifikation auf Gewichtsebene), kann nächstes Jahr eine Produktfunktion sein, und dieses Playbook wird seine eigenen neuen Versionen benötigen — was vermutlich bedeutet, dass das Thema mit sich selbst übereinstimmt. Was wir klar behaupten wollen: Die Selbst-Evolution hat in ihrer begrenzten Form den Sprung vom Paper in die Praxis geschafft. Die eigenen Grundlagen des Forschungsfeldes besagen, dass ihre Änderungen nur empirisch validiert werden können, und die empirische Validierung von Änderungen an Produktions-Akteuren ist eine Disziplin, die Unternehmen bereits beherrschen — sie nennt sich Release-Prozess. Und die Unternehmen, die mit selbst-evoluierenden Agenten erfolgreich sein werden, sind diejenigen, die der Evolution eine Pipeline gegeben und das Fundament außerhalb ihrer Reichweite gehalten haben.
Es wird ein direktes Zitat unter fünfzehn Wörtern aus dem zitierten Paper zur Darwin Gödel Machine verwendet, das im Text zugeschrieben wird; alle anderen Forschungsergebnisse werden aus den zitierten Arbeiten paraphrasiert. Dieser Beitrag bezieht keine Stellung zu Fragen bezüglich künstlicher generalisierter Intelligenz (AGI) oder Superintelligenz. Die Einteilung der vier Flächen, das Promotion-Pipeline-Playbook und die Anforderung des eingefrorenen Fundaments stammen redaktionell von TrueFoundry; die zitierten Autoren bewerten oder unterstützen TrueFoundry nicht, und unser kommerzielles Interesse wird im Text offengelegt. Produktfunktionen werden aus der zum Zeitpunkt der Erstellung aktuellen öffentlichen Dokumentation paraphrasiert; die Produktabbildungen sind eigene Dokumentationsressourcen von TrueFoundry, die mit Quellenangabe reproduziert werden.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet