November 6, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Tokenmaxxing weicht der Kostendisziplin. Ende Juni berichtete CNBC , dass die größten Unternehmenskunden der führenden KI-Labore von einem Wettlauf beim Token-Verbrauch zu strengeren Budgets und Forderungen nach messbaren Erträgen übergehen. Gil Luria von D.A. Davidson merkte an, dass einige Unternehmen beginnen könnten, ausufernde Token-Ausgaben direkt zu begrenzen. Uber hat ein monatliches Limit von 1.500 US-Dollar pro Mitarbeiter pro agentischem Coding-Tooleingeführt, das über ein internes Dashboard nachverfolgbar ist und bei Genehmigung überschritten werden kann (Bloomberg). Microsoft hat Berichten zufolge einige interne KI-Kontingente gekürzt und betont eine kostenbewusste Nutzung. Amazon hat Mitarbeiter angehalten, KI für echte Probleme einzusetzen statt für eine ständig wachsende Liste von Anwendungsfällen, und Berichte deuten auf strengere Token-Budgets bei Meta hin – dies sind Signale für interne Richtlinien, kein Rückzug von der KI-Einführung selbst (Publicis Sapient). Bis zum 10. Juli berichtete Forbes, dass Token-Ausgaben zur entscheidenden Kennzahl geworden seien, und verwies auf Gartners Warnung, dass die Kosten für KI-Programmierung auf dem besten Weg seien, die durchschnittlichen Entwicklergehälter zu übersteigen (Forbes). Die wichtige Frage ist heute nicht mehr, ob Unternehmen sich um Token-Ausgaben sorgen; das tun sie zweifellos. Die Frage ist, was den reinen Verbrauch als steuernde Kennzahl ersetzt. Der Essay von IBM vom 25. Juni – derselbe Beitrag, der für Valuemaxxing plädierte – warnt, dass die Token- Minimierung denselben grundlegenden Fehler wie das Tokenmaxxing begehen kann, indem sie den Verbrauch selbst als zu optimierende Größe betrachtet. In der Formulierung von IBM: "Kosten verschwinden nicht; sie verlagern sich." Die nachhaltige Antwort lautet Wert pro Token: Messen Sie, was die Ausgaben bewirkt haben, und nutzen Sie diese Erkenntnisse für die Steuerung, Budgetierung und Optimierung, ohne dabei weder hohen noch niedrigen Verbrauch mit Erfolg gleichzusetzen.
Stellen Sie das neue Material in einer chronologischen Abfolge zusammen, denn das Tempo ist Teil der Erkenntnis. Mai: Branchenberichte zeigen, dass Microsoft einige interne KI-Nutzungsrechte einschränkt und Amazon seine Mitarbeiter dazu anhält, KI für reale Probleme einzusetzen, statt nur Anwendungsfälle zu sammeln – das sind Signale für eine interne Neuausrichtung, kein Rückzug von der KI-Nutzung, aber die ersten Anzeichen einer Trendwende bei Unternehmen, die Monate zuvor den Verbrauch noch als Selbstzweck betrachteten (Die Zusammenfassung von Publicis Sapient). Ende Juni: Der Bericht von CNBC liefert die strukturelle Einordnung: Die größten Unternehmenskunden der führenden KI-Labore stellen von einem Wettlauf um die höchsten Ausgaben auf Budgetdisziplin und geforderte Renditen um, wobei Analysten bereits explizite Ausgabenobergrenzen erwarten. IBM veröffentlicht den Essay, der diesen Wandel prägte: Token-Verbrauch wird darin als Kostenfaktor und nicht mehr als Wertmaßstab definiert, und der Begriff „Valuemaxxing“ wird als Nachfolger etabliert. Uber, das mahnende Beispiel dieser Ära, führt ein monatliches Limit von 1.500 US-Dollar pro Mitarbeiter für agentische Coding-Tools ein, das über Dashboards nachverfolgbar ist und nur mit Genehmigung überschritten werden kann. Anfang Juli: Tim Keary von Forbes fasst die Folgen zusammen: Token-Ausgaben werden zur neuen Kennzahl auf Vorstandsebene. Gartner prognostiziert, dass die Kosten für KI-gestützte Programmierung bei verbrauchsbasierten Lizenzmodellen bis 2028 die durchschnittlichen Entwicklergehälter übersteigen werden (Gartners Ankündigung vom 24. Juni), wobei die Kombination mehrerer Modelle als Strategie zur Kostensenkung aufkommt und eine neue Fehlerquelle durch komplexe Abrechnungen und Risiken schafft, während der Benchmark-Bericht 2026 von Lucidworks zeigt, dass die Bereitstellungskosten für 58 % der Unternehmen ein Hauptanliegen sind, verglichen mit 3 % im Jahr 2023 (Forbes). Im Laufe des Juli: Der Diskurs unter Anwendern wird konkreter: Routing-Plattformen kristallisieren sich als taktische Lösung heraus. Marktanalysen beschreiben die dynamische Zuweisung zwischen Spitzenmodellen und günstigeren Alternativen als neuen Standard und weisen auf das zugrunde liegende Paradoxon hin: Während die Preise pro Token sinken, treiben agentische Workflows den Gesamtverbrauch in die Höhe (AlphaSense); Engineering-Analysten mahnen zur Vorsicht, dass extreme Verbräuche in beide Richtungen nicht kosteneffizient sind und die eigentliche Chance in der Art und Weise liegt, wie Tokens genutzt werden. Die Herkunft dieser Ära wird rückblickend betrachtet: der Moment im März, als Jens Huang von Nvidia sagte, er wäre „zutiefst beunruhigt“, wenn ein 500.000-Dollar-Ingenieur nicht massiv in Tokens investieren würde; die internen Bestenlisten in großen Laboren und Plattformen, die diese Stimmung operationalisierten; und die berichteten Extreme (der monatliche Verbrauch eines einzelnen Power-Users in Höhe von Hunderten Milliarden Tokens; jährliche KI-Rechnungen von Unternehmen im neunstelligen Bereich), die die Kehrtwende unvermeidlich machten. Als ein zusammenhängender Bogen gelesen: Der Diskurs drehte sich innerhalb von etwa neunzig Tagen von Anreizen zum Verbrauch hin zur Deckelung des Verbrauchs – und der institutionelle Wandel ist eher noch im Gange als abgeschlossen: Anfang August beschrieb Ubers eigener CTO das Unternehmen als am Ende seiner Tokenmaxxing-Ära (Business Insider). Das ist das Tempo, mit dem eine Proxy-Metrik stirbt, und die Vorbereitung auf den Fehler, der auf das Sterben von Proxy-Metriken folgen kann.
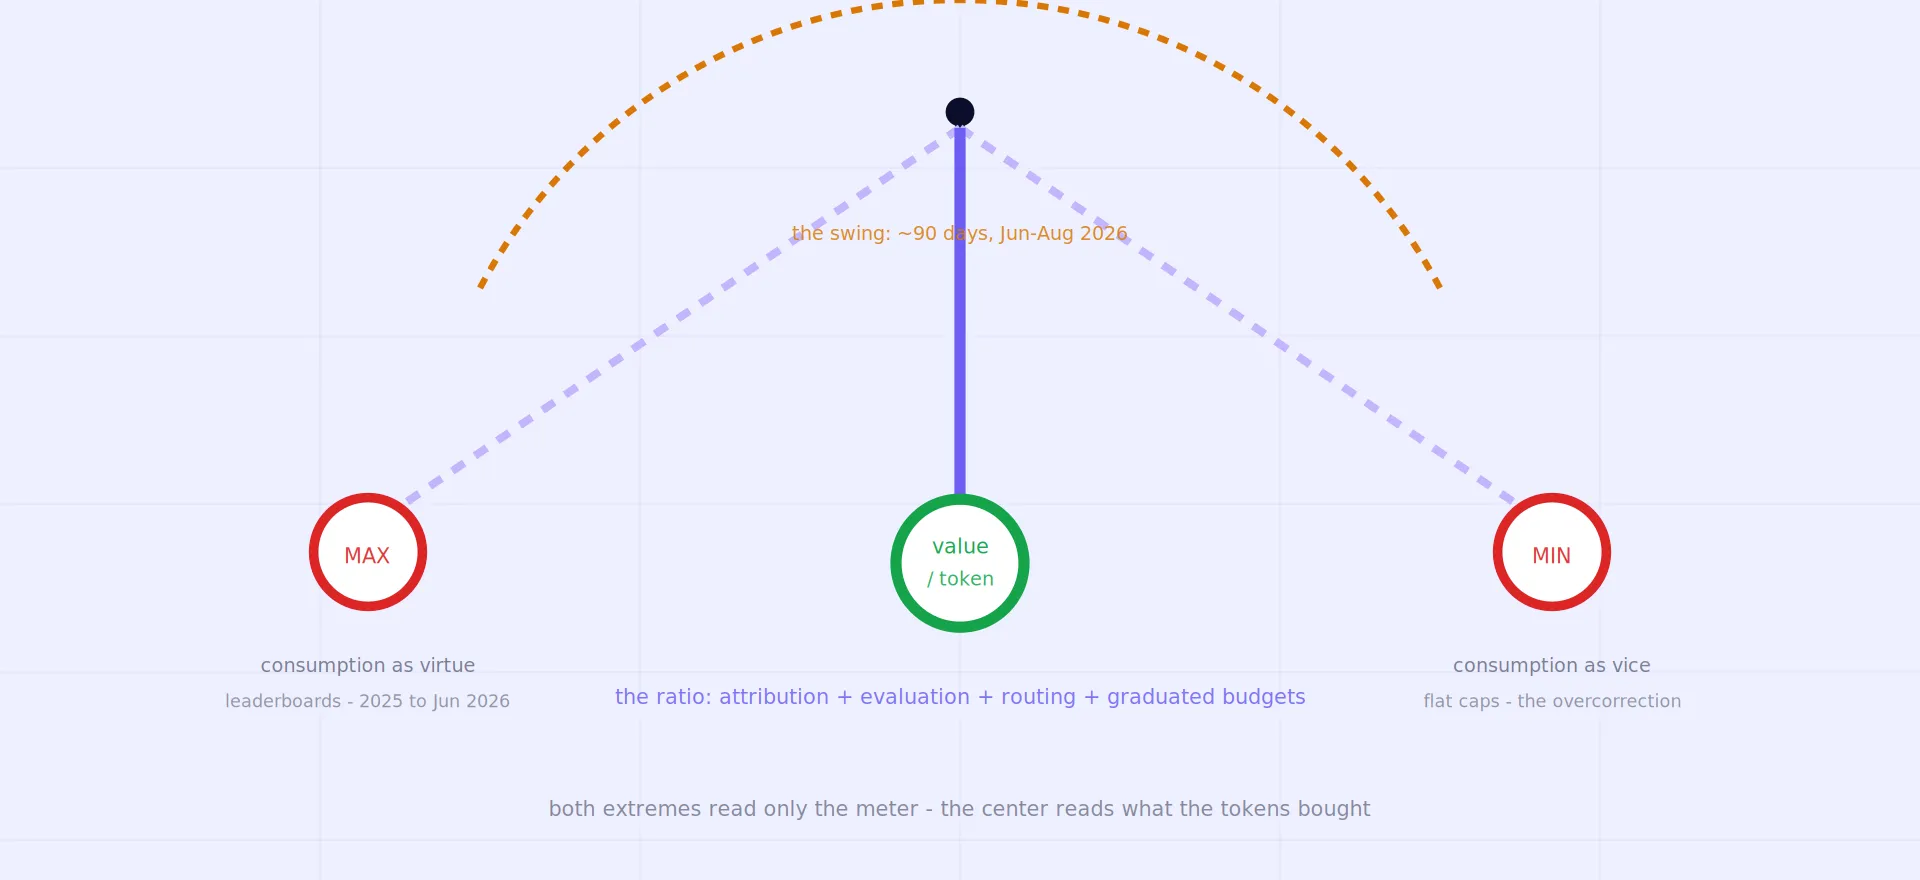
Die Warnung von IBM verdient eine genauere Betrachtung, da sie der operativ nützlichste Satz des Sommers ist. Beide Regime – Maximierung und Minimierung – teilen ein Axiom: dass die Token-Anzahl die zu verwaltende Kennzahl ist. Unter der Maximierung führte das Axiom zu aufgeblähten Prompts, unkontrollierten Wiederholungen und Agenten, die für Geschwätzigkeit belohnt wurden; unter der Minimierung erzeugt es die umgekehrte Pathologie, und der Mechanismus ist subtiler, weil er wie Disziplin aussieht. Die ersten Kürzungen sind tatsächlich kostenlos: zu große Tool-Kataloge, redundante Payloads, veralteter Kontext – der Abfall, den Caching und Kontext-Engineering beseitigen können. Aber das Kürzen hört nicht beim Abfall auf, weil die Metrik nicht zwischen Abfall und Nährwert unterscheiden kann: Aufgabenbeschreibungen werden bis zur Unkenntlichkeit komprimiert, geschäftliche Einschränkungen und architektonischer Kontext werden als Overhead entfernt, der Abruf wird rationiert – und das System, dem der Kontext entzogen wurde, der es erfolgreich machte, kompensiert dies nachgelagert durch zusätzliche Überlegungen, Wiederholungen, Tool-Aufrufe, Validierungszyklen und manuelle Nacharbeit. Die Input-Token-Linie sinkt; die tatsächlichen Kosten des Workflows steigen und verteilen sich auf Bereiche, die der Token-Bericht nicht erfasst – weshalb die Feier so langlebig ist: Die Zahl, die die Führungsebene beobachtet, verbessert sich, während die Zahl, die niemand berechnet, sich verschlechtert. Fügt man die beiden Verschärfer hinzu, die die Berichterstattung im Juli lieferte, ist das Bild komplett. Der agentische Nenner: Obergrenzen pro Mitarbeiter und Intuitionen pro Arbeitsplatz gehen davon aus, dass Menschen die Konsumenten sind, aber das strukturelle Wachstum findet bei Agenten statt – eine pauschale menschliche Ration bewirkt wenig bei der Steuerung einer agentischen CI/CD-Pipeline, deren Verbrauch unabhängig von der Anzahl der Arbeitsplätze wächst, während sie gleichzeitig den Menschen bestraft, dessen hoher Verbrauch produktiver Natur ist. Und die Multi-Modell-Abrechnungsoberfläche: Die Strategie der Vermischung, die die Stückkosten tatsächlich senkt (das Routing-Arbitrage: Modellwechsel können die Inferenzkosten materiell reduzieren, wenn günstigere Modelle die Aufgabenqualität beibehalten, wobei die realisierten Einsparungen vom Arbeitslast-Mix, der Modellvielfalt und der Routing-Richtlinie abhängen), vervielfacht auch Rechnungen, Preislisten und Abstimmungsaufwände – Forbes' Warnung vor Abrechnungsfehlern –, sodass das Unternehmen, das Modelle diversifizierte, ohne die Messung zu vereinheitlichen, eine Intransparenz gegen mehrere eintauschte. Die Synthese ist einfach: Das Token ist weder eine Tugend noch ein Laster; es ist ein Nenner. Jedes Regime, das diesen Nenner optimiert, ohne die Ergebnisse zu messen, wird letztlich den Aufwand falsch verteilen, daher muss auch der Zähler instrumentiert werden.
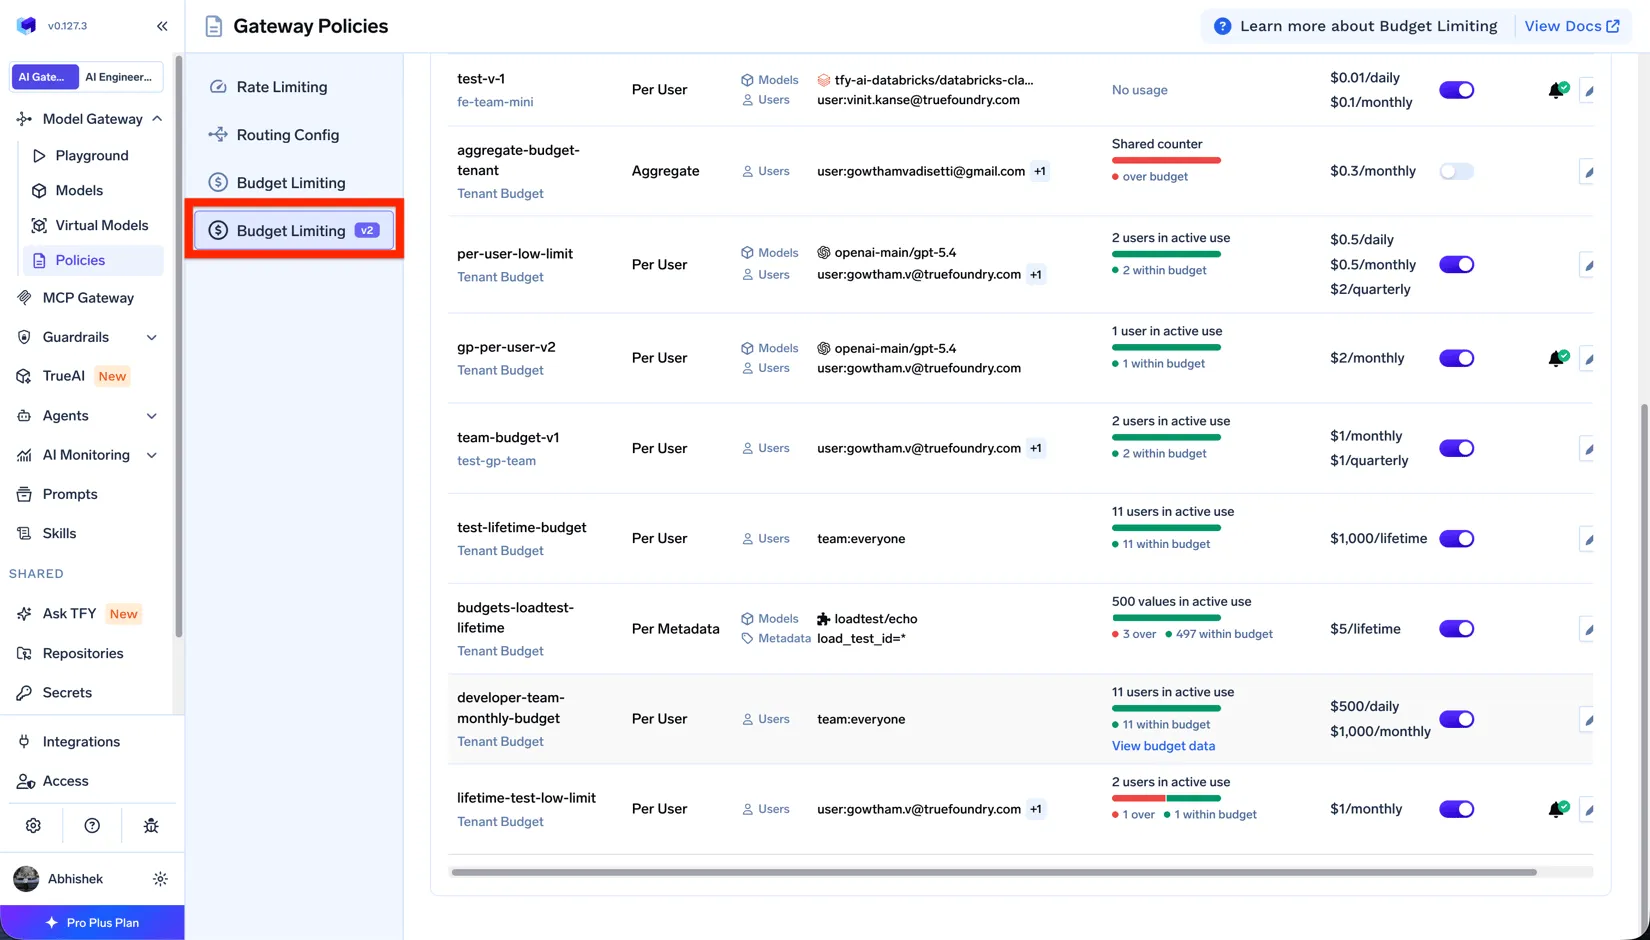
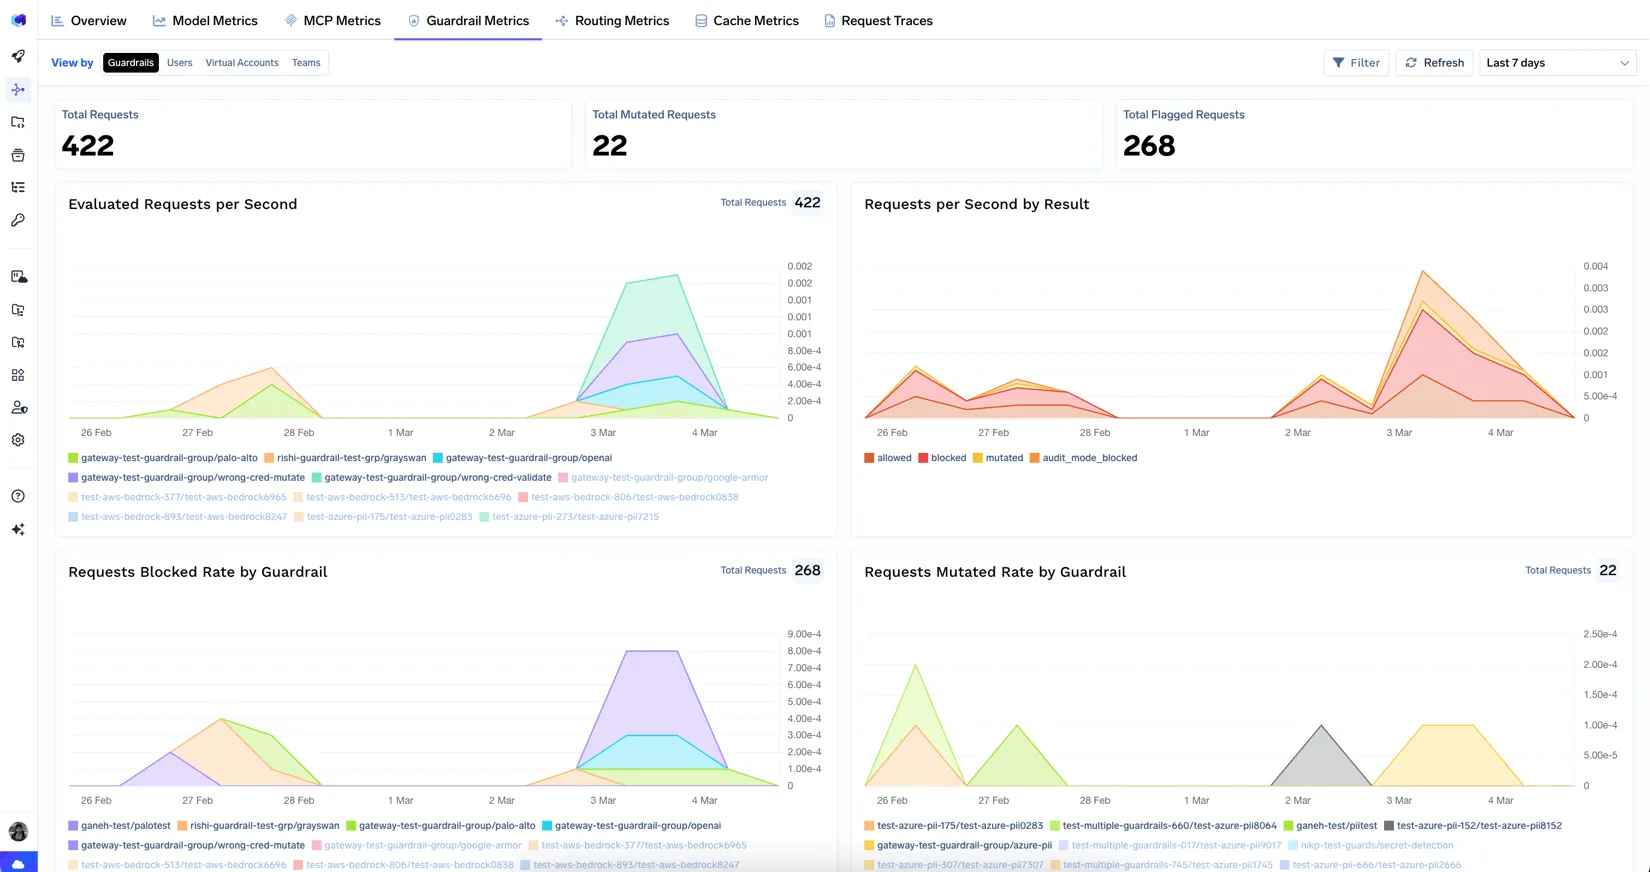
Die Verwaltung des Verhältnisses – Wert pro Token – erfordert vier Instrumente auf dem Weg, den die Tokens zurücklegen. Attribution unterteilt die Rechnung nach Team, Workflow und Agent (Kostenaufteilung pro Anfrage; Analytik) – die Voraussetzung für jede Aussage, die über ein simples „die Ausgaben sind gestiegen“ hinausgeht, und die Vereinheitlichungsebene, die durch die Multi-Modell-Abrechnung nun dringlich wird: eine einheitliche Messgrundlage für alle Anbieter, die von der Routing-Strategie angesprochen werden. Evaluierung liefert den Zähler – und in der aktuell dokumentierten Oberfläche von TrueFoundry ist dies ein zusammengesetzter Workflow, kein natives Dashboard-Maß: Gateway-Traces können via OTEL an verbundene Evaluierungsplattformen exportiert werden, wie etwa Braintrust, wo Qualitätsbewertungen und Evaluierungen erstellt werden. Diese Werte unterscheiden die hundert Millionen Token an wertvoller Arbeit von den hundert Millionen Token an Leerlauf (das Online-Evaluierungsmuster) – eine Unterscheidung, die weder durch Maximierung noch durch Minimierung allein getroffen werden kann, da beide nur den Zählerstand ablesen. Qualitätsbasiertes Routing operationalisiert die Mischung (kosten- und qualitätsbewusstes Routing; semantisches Caching für echte, kostenlose Einsparungen): das günstige Modell, wenn die Datenlage es zulässt, das Spitzenmodell, wenn nicht – so werden Kosten bei gleichbleibender Qualität gesenkt, was die einzige Einsparung ist, die nicht zulasten der Leistung geht. Und gestaffelte Budgets ersetzen die pauschale Zuteilung (Budgetbegrenzung): Kostenobergrenzen auf Mandanten- und Teamebene, unterteilbar nach Benutzer, Modell, virtuellem Konto oder Metadatenwert – so erhalten stabile Agenten- und Workflow-Kennungen eigene Budgets – mit Meilenstein-Benachrichtigungen bei Schwellenwerten von 75/90/95/100 % sowie Audit, soft_enforce, oder enforce Verhalten; ein Wechsel auf ein günstigeres Modell ist eine separate Routing-Richtlinie, die mit den Budgetkontrollen kombiniert werden kann, aber keine native Funktion der Budgetregel selbst. Zusammen bilden diese Kontrollen den Mittelweg: offensichtliche Verschwendung vermeiden, Kontext bewahren, wo er die Ergebnisse verbessert, bei gleichbleibender Qualität auf günstigere Modelle umleiten und ausufernde Kosten stoppen, ohne jede intensive Arbeitslast als Verschwendung zu betrachten. Es geht nicht darum, die Token-Anzahl in die eine oder andere Richtung zu optimieren, sondern den Wert pro ausgegebener Einheit zu maximieren.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet