October 5, 2023
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.




Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Fine-Tuning ist eine Technik im Bereich des Machine Learning, insbesondere beim Deep Learning, bei der ein vortrainiertes Modell auf einem kleineren, spezifischen Datensatz weiterverfolgt oder „feinabstimmend“ trainiert wird, der auf eine bestimmte Aufgabe zugeschnitten ist.
Nehmen wir an, Sie entwickeln ein Modell zur Erstellung technischer Handbücher für Elektronik mit GPT-3 (einem großen Sprachmodell mit 175 Milliarden Parametern), aber die generische Ausgabe von GPT-3 erfüllt nicht die erforderliche technische Genauigkeit und den gewünschten Tonfall.
In diesem Fall könnten Sie darüber nachdenken, das Modell für Ihren spezifischen Anwendungsfall neu zu trainieren. Allerdings ist es aufgrund des immensen Bedarfs an Rechenressourcen und spezialisierten Daten unpraktisch, ein Modell wie GPT-3 für diese Nischenaufgabe direkt von Grund auf neu zu trainieren.
Hier kommt das Fine-Tuning ins Spiel.
Fine-Tuning ist wie das Beibringen eines neuen Kunststücks für GPT-3. Es weiß dank seines Trainings mit zahlreichen Texten von Büchern bis hin zu Websites bereits sehr viel über Sprache. Ihre Aufgabe ist es, es auf einem gezielten Datensatz weiter zu trainieren – in diesem Fall einem Korpus bestehender technischer Handbücher und Dokumentationen speziell für Elektronik.
Einige grundlegende Methoden des Fine-Tunings:
Parameter Efficient Fine-tuning (PEFT) ist eine Technik, die darauf abzielt, die Anzahl der zusätzlichen Parameter zu minimieren, die während des Fine-Tunings von vortrainierten neuronalen Netzmodellen erforderlich sind.
Dies hilft, die Rechenkosten und die Speicherbelegung zu reduzieren, während die Leistung beibehalten oder sogar gesteigert wird. PEFT erreicht dies, indem es Prompt-Embeddings als zusätzliche Modellparameter hinzufügt und nur eine kleine Anzahl zusätzlicher Parameter anpasst.
PEFT erfordert im Vergleich zum traditionellen Fine-Tuning auch einen deutlich kleineren Datensatz.
Laden Sie das von Ihnen gewählte Modell mithilfe eines Machine-Learning-Frameworks wie TensorFlow, PyTorch oder der Transformers-Bibliothek von Hugging Face. Diese Frameworks bieten APIs, um vortrainierte Modelle einfach herunterzuladen und zu laden.
Hier ist ein Beispielcode:
Vor dem Fine-Tuning müssen Sie mit verschiedenen Prompts experimentieren, um die Antworten des Modells zu steuern. Testen Sie verschiedene Prompts mit dem vortrainierten Modell, um zu sehen, wie sie sich auf die Ausgabe auswirken, und wählen Sie den am besten geeigneten aus. Sie können auch verschiedene Parameter wie max_length, temperature usw. ändern.
Es ist so, als ob Sie herausfinden möchten, wie Sie Ihre Frage am besten stellen, damit das Modell versteht, was Sie wollen.
In einem Datensatz für das Fine-Tuning gibt es typischerweise zwei Teile: Prompt (Eingabe) und Answer (Ausgabe). Der Prompt ist wie eine Frage oder ein Startpunkt, und die Answer ist das, was das Modell als Antwort auf diese Frage generieren soll. Es kann in Form von Spalten oder als Sequenz von Texteinträgen vorliegen (was üblicher ist).
Der im letzten Schritt ermittelte beste Prompt wird hier verwendet, und die Answer entspricht genau dem, was das Modell bei Eingabe dieses Prompts erzeugen soll.
Hier bringen Sie dem Modell bei, Ihre Aufgabe besser zu erledigen. Sie nutzen den Datensatz, um das „Wissen“ des Modells leicht anzupassen.
Hier ist eine vereinfachte Übersicht über die Einrichtung und Durchführung des Fine-Tuning-Prozesses mit PyTorch:
from transformers import AdamW
optimizer = AdamW(model.parameters(), lr=5e-5) # lr ist die Lernrate
Bei der Erkundung von Tools für das Prompt Engineering ist es hilfreich, sie in zwei Hauptbereiche zu unterteilen: Code-Plattformen und No-Code-Plattformen. Diese Unterscheidung vereinfacht den Auswahlprozess.
Code-Plattformen beziehen sich auf Plattformen, die virtuelle Maschinen bereitstellen, mit denen Sie Ihr benutzerdefiniertes Python-Skript für das Fine-Tuning (wie das zuvor erwähnte) ausführen können. No-Code-Plattformen hingegen beziehen sich auf Tools, die wenig bis gar kein Python-Skript erfordern. Sie verfügen über eine dedizierte Benutzeroberfläche, auf der Sie das Training mit wenigen Klicks starten können.
No-Code-Plattformen sind auf Einfachheit und Benutzerfreundlichkeit ausgelegt. Sie machen das Schreiben von Python-Skripten überflüssig und bieten eine intuitive Benutzeroberfläche, auf der das Training mit nur wenigen Klicks gestartet werden kann. dieser Bereich eignet sich für Benutzer ohne Programmierkenntnisse oder für diejenigen, die einen unkomplizierten Ansatz für das Prompt Engineering bevorzugen.
TrueFoundry ist ein Tool, das ML-Teams dabei hilft, ihre Modelle reibungslos in Betrieb zu nehmen. Es basiert auf Kubernetes, was bedeutet, dass es auf verschiedenen Clouds oder sogar auf Ihren eigenen Servern ausgeführt werden kann. Dies ist wichtig für Unternehmen, die auf Datensicherheit und Kostenkontrolle bedacht sind.
Für das Fine-Tuning ist es eines der besten Tools auf dem Markt und richtet sich sowohl an Einsteiger als auch an Experten. Hier haben Sie zwei Optionen: Die Bereitstellung eines Fine-Tuning-Notebooks zum Experimentieren oder das Starten eines dedizierten Fine-Tuning-Jobs.
Notebooks bieten das ideale Setup für exploratives und iteratives Fine-Tuning. Sie können mit einer kleinen Teilmenge von Daten experimentieren und verschiedene Hyperparameter ausprobieren, um die ideale Konfiguration für die beste Leistung zu ermitteln.
Sobald Sie durch Experimentieren die optimalen Hyperparameter und die beste Konfiguration ermittelt haben, hilft Ihnen der Übergang zu einem Deployment Job dabei, das Fine-Tuning auf dem gesamten Datensatz durchzuführen, und ermöglicht ein schnelles und zuverlässiges Training.
Daher werden Notebooks dringend für die Erkundung in der Frühphase und das Hyperparameter-Tuning empfohlen, während Deployment Jobs die bevorzugte Wahl für groß angelegtes LLM-Fine-Tuning sind, insbesondere wenn die optimale Konfiguration durch vorherige Experimente festgelegt wurde.
Hier ist eine Schritt-für-Schritt-Anleitung zum Fine-Tuning mit Notebooks und Jobs:
TrueFoundry unterstützt zwei verschiedene Datenformate:
Jede Zeile enthält einen Schlüssel namens messages. Jeder messages-Schlüssel enthält eine Liste von Nachrichten, wobei jede Nachricht ein Dictionary mit den Schlüsseln role und content ist. Der Schlüssel role kann entweder user, assistant oder system sein, und der Schlüssel content enthält den Nachrichteninhalt.
2. Fine-Tuning
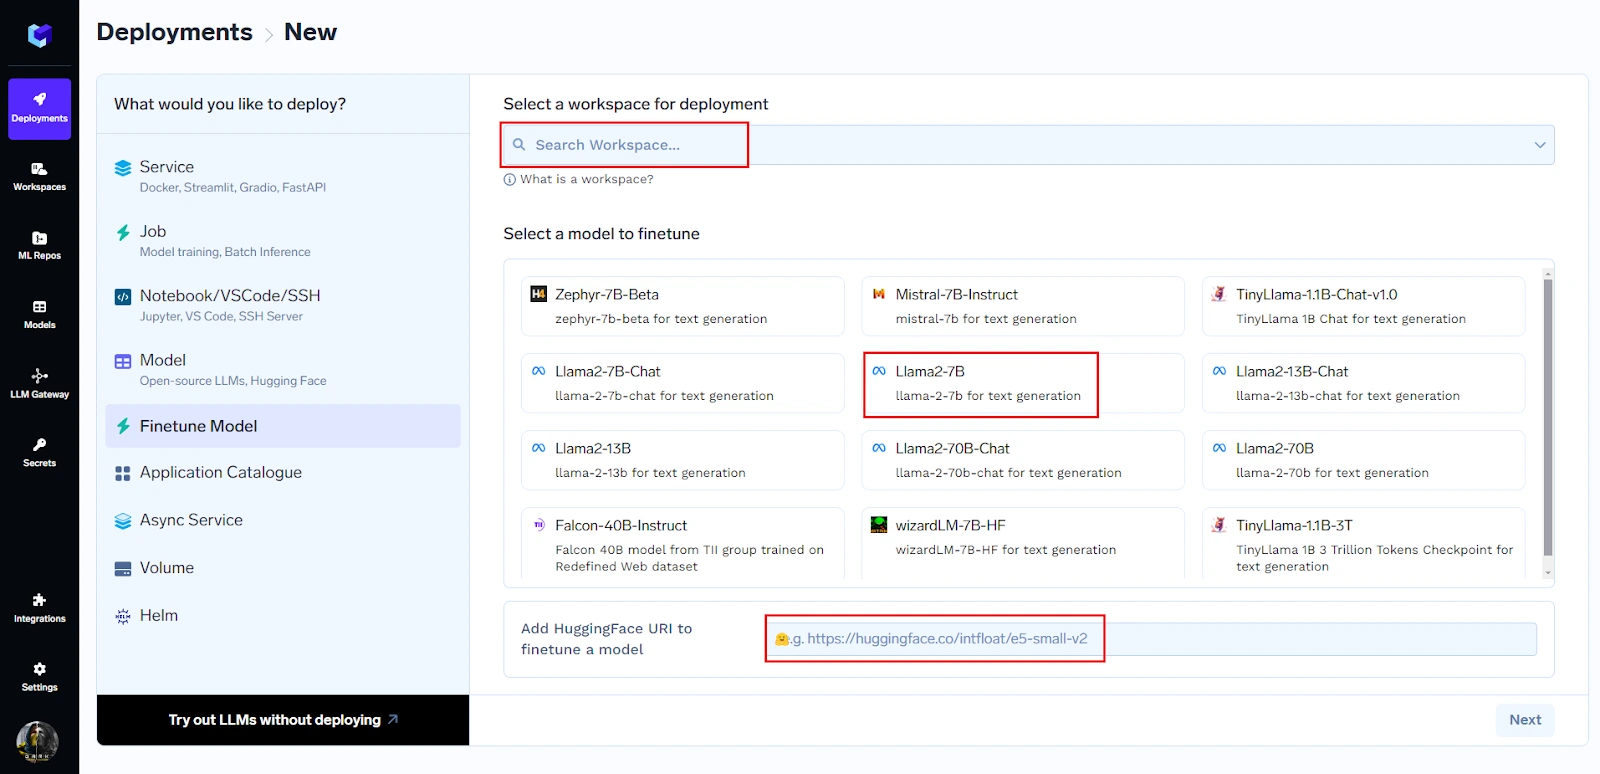
Sie können mit dem Fine-Tuning mit nur drei Klicks beginnen:
Sie können ein Modell aus der umfangreichen Liste auswählen oder einfach die Hugging Face-URL einfügen, um mit dem Fine-Tuning zu beginnen.
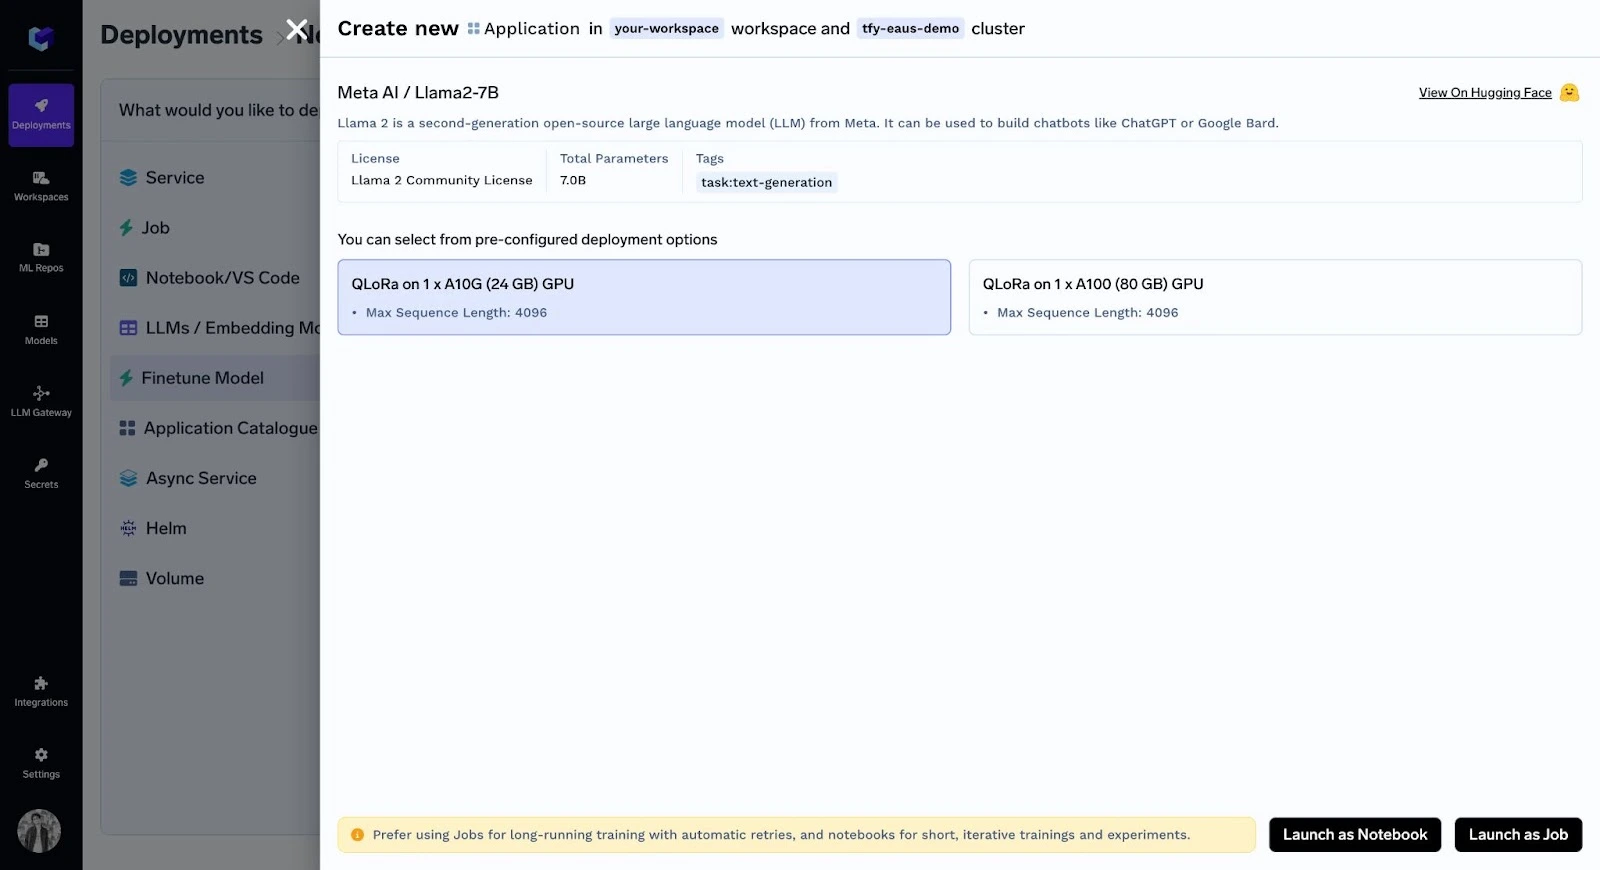
Nachdem Sie die gewünschte GPU ausgewählt haben, haben Sie zwei Optionen: Als Notebook ausführen oder als Job.
3. Fine-Tuning mit einem Notebook
Nachdem Sie „Launch as Notebook“ gewählt und die Standardwerte für die Hyperparameter ausgewählt haben, können Sie Ihr Notebook sehen:

4. Fine-Tuning als Job:
Bevor Sie beginnen, müssen Sie zuerst ein ML Repo erstellen (dieses wird zum Speichern Ihrer Trainingsmetriken und Artefakte wie Checkpoints und Modelle verwendet) und Ihrem Workspace Zugriff auf das ML Repo gewähren. Mehr über ML Repos erfahren Sie in der Dokumentation von TrueFoundry.
Jetzt müssen Sie „Launch as Job“ wählen und die Standardwerte der Hyperparameter auswählen, um das Fine-Tuning zu starten.
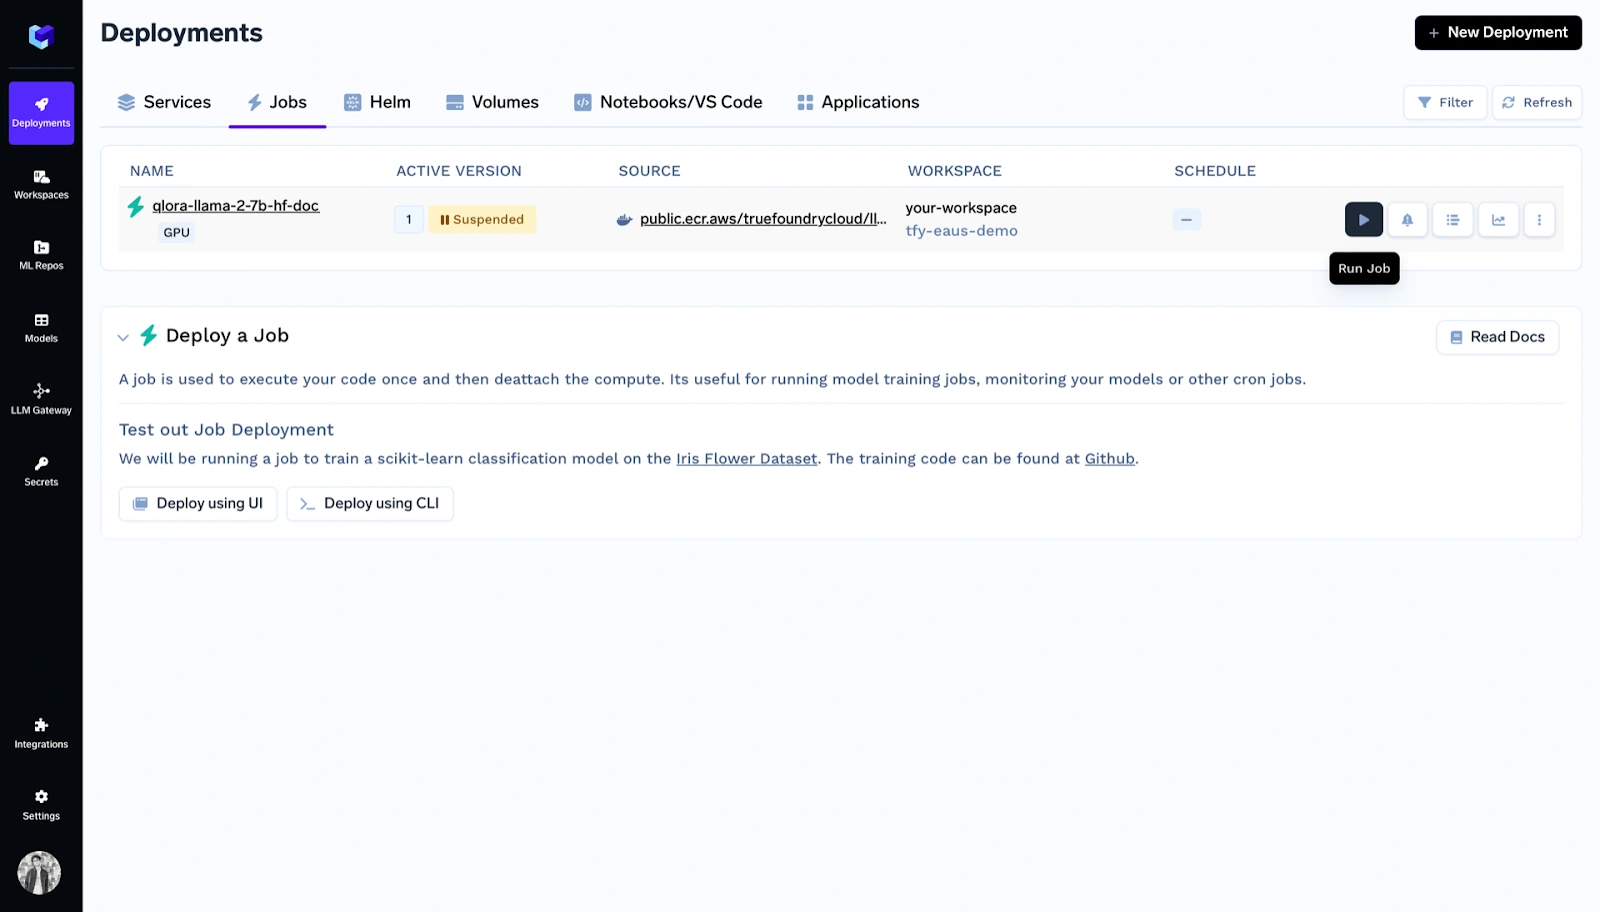
Unter Deployments sehen Sie den aufgelisteten Job und können auf „Run Job“ klicken.
Hauptmerkmale:
Die OpenAI API bietet Zugriff auf fortschrittliche Modelle für künstliche Intelligenz, die von OpenAI entwickelt wurden, einschließlich der neuesten Versionen von GPT (Generative Pre-trained Transformer). Eine der herausragenden Funktionen der OpenAI API ist die Möglichkeit, Modelle auf benutzerdefinierten Datensätzen feinabzustimmen.
So können Sie das Verhalten von Modellen wie GPT-3 oder neueren Versionen an spezifische Anwendungen anpassen oder an bestimmte Inhaltsstile und Präferenzen angleichen.
Da ich mich hier auf die API beziehe, ist es nicht ganz „No-Code“, aber dennoch lässt es sich im Vergleich zu anderen Tools im vorherigen Abschnitt leicht für das Training einrichten.
Beispielcode für Fine-Tuning:
Um ein Modell feinabzustimmen, müssen Sie Ihren Datensatz zunächst in einem Format vorbereiten, das die OpenAI API verstehen kann. Typischerweise müssten Sie eine JSON-Datei erstellen, die so aussieht:
Sie können den Datensatz ganz einfach über die OpenAI CLI (Command Line Interface) hochladen.
openai tools fine_tunes.prepare_data -f your_dataset.jsonl
Sobald Ihr Datensatz vorbereitet und hochgeladen ist, können Sie den Fine-Tuning-Prozess starten. Das folgende Beispiel verwendet die Python-Bibliothek von OpenAI:
Nachdem der Fine-Tuning-Prozess abgeschlossen ist, können Sie Ihr feinabgestimmtes Modell zur Generierung von Text oder für andere Aufgaben verwenden, indem Sie die ID des feinabgestimmten Modells angeben:
Sie können Ihr feinabgestimmtes Modell auch bereitstellen.
Hauptmerkmale:
Microsoft Azure ist eine Cloud-Computing-Plattform, die ein breites Spektrum an Diensten bietet, darunter Rechenleistung, Speicher, Analysen und mehr. Sie bietet Benutzern die Werkzeuge, um Anwendungen effizient zu erstellen, bereitzustellen und zu verwalten.
Ein bemerkenswertes Merkmal ist die intuitive Benutzeroberfläche, die Anfängern die Navigation ohne umfangreiche Programmierkenntnisse erleichtert. Mit einfachen Klicks statt komplexem Code können Benutzer ihre Anwendungen anpassen, was Azure zu einem zugänglichen Tool für eine stressfreie Entwicklung macht.
Hier ist eine einfache Anleitung zur Einrichtung eines Fine-Tuning-„Jobs“ in Azure:
Dies ist selbstverständlich die grundlegende Anforderung für alle Tools. Die Trainingsdaten können im Format JSON Lines (JSONL), CSV oder TSV vorliegen. Die Anforderungen an Ihre Daten variieren je nach der spezifischen Aufgabe, für die Sie Ihr Modell feinabstimmen möchten.
Für Textklassifizierung:
Zwei Spalten: Sentence (string) und Label (integer/string)
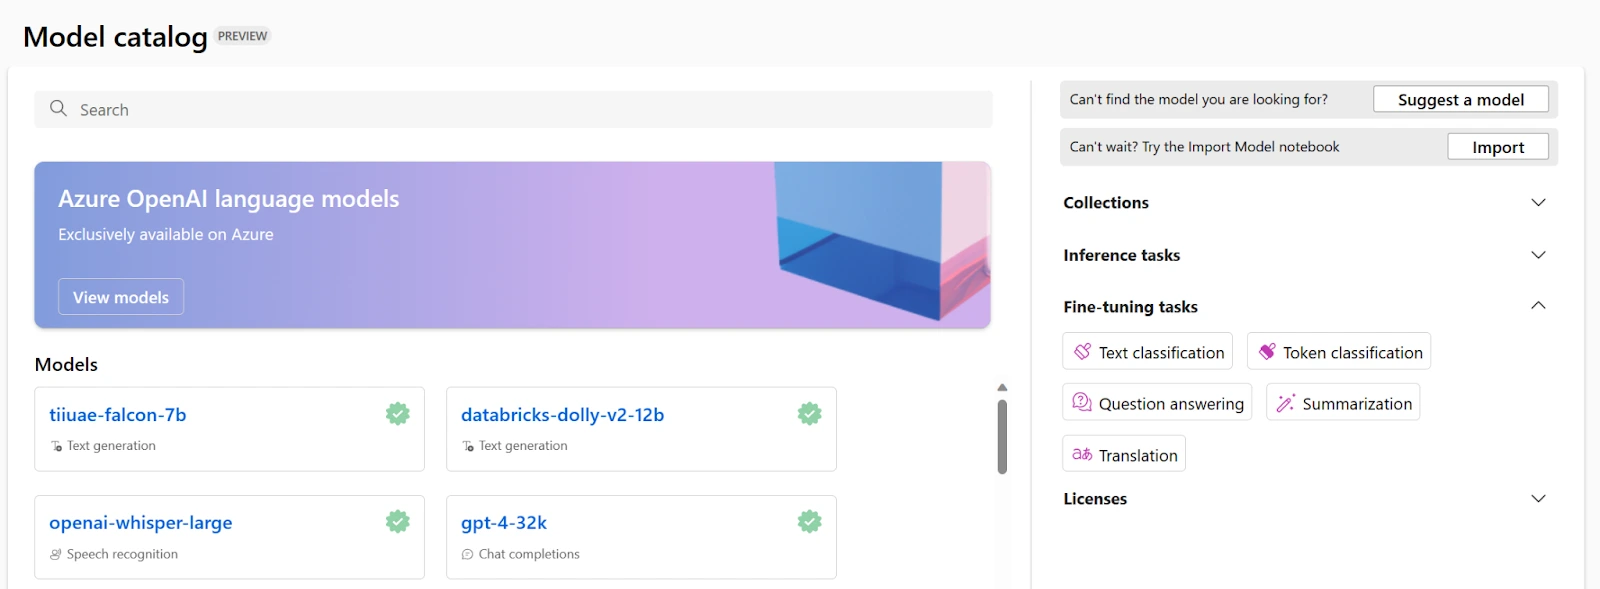
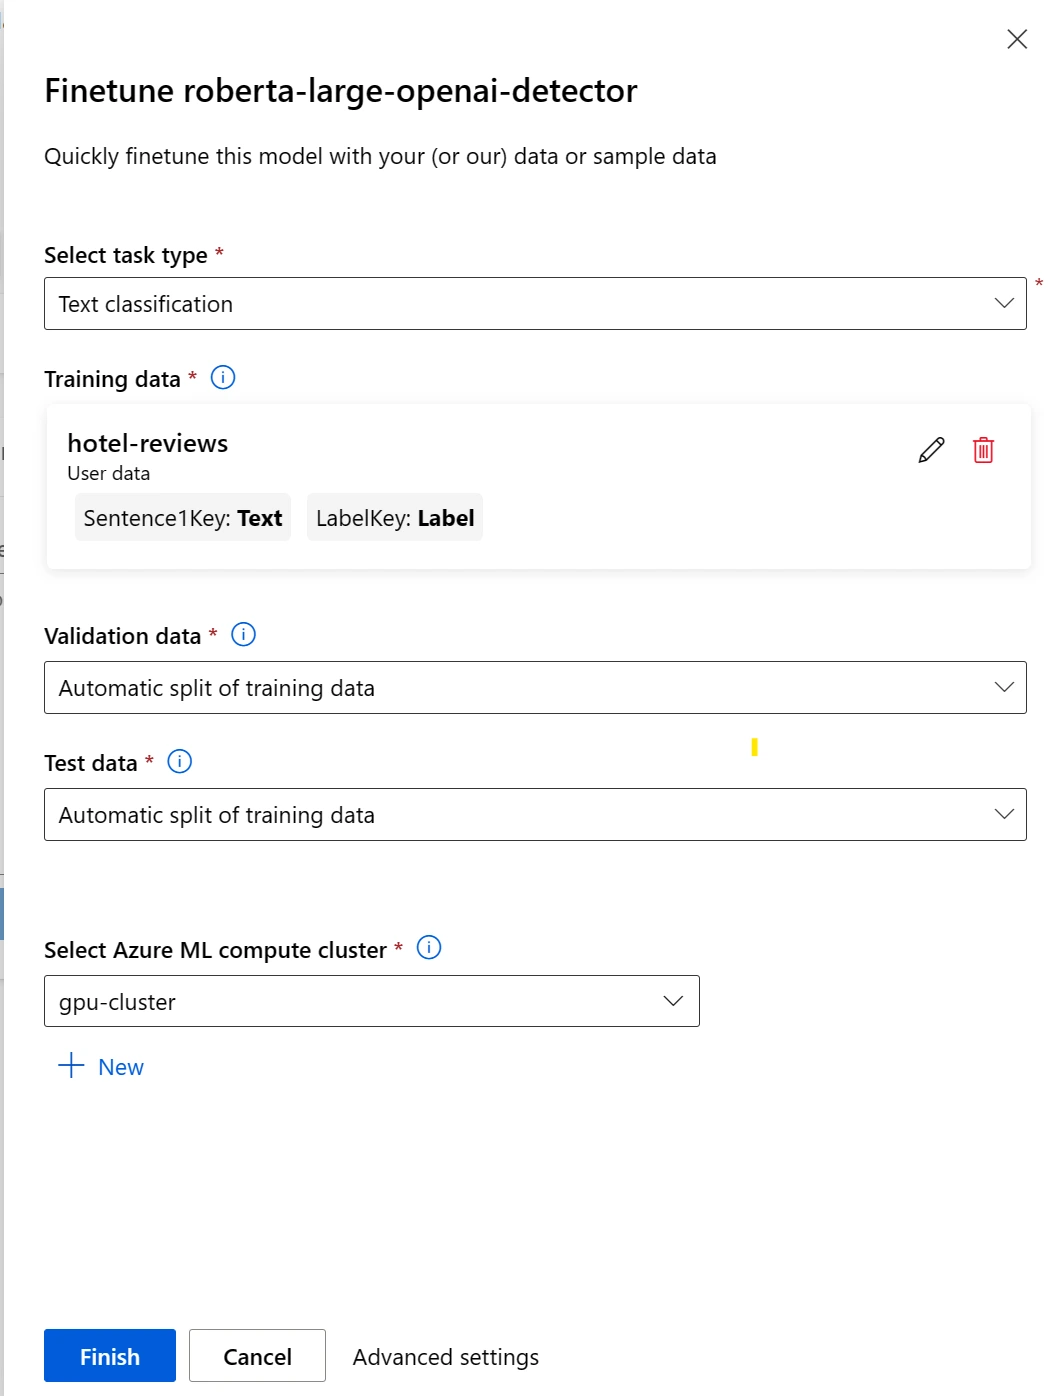
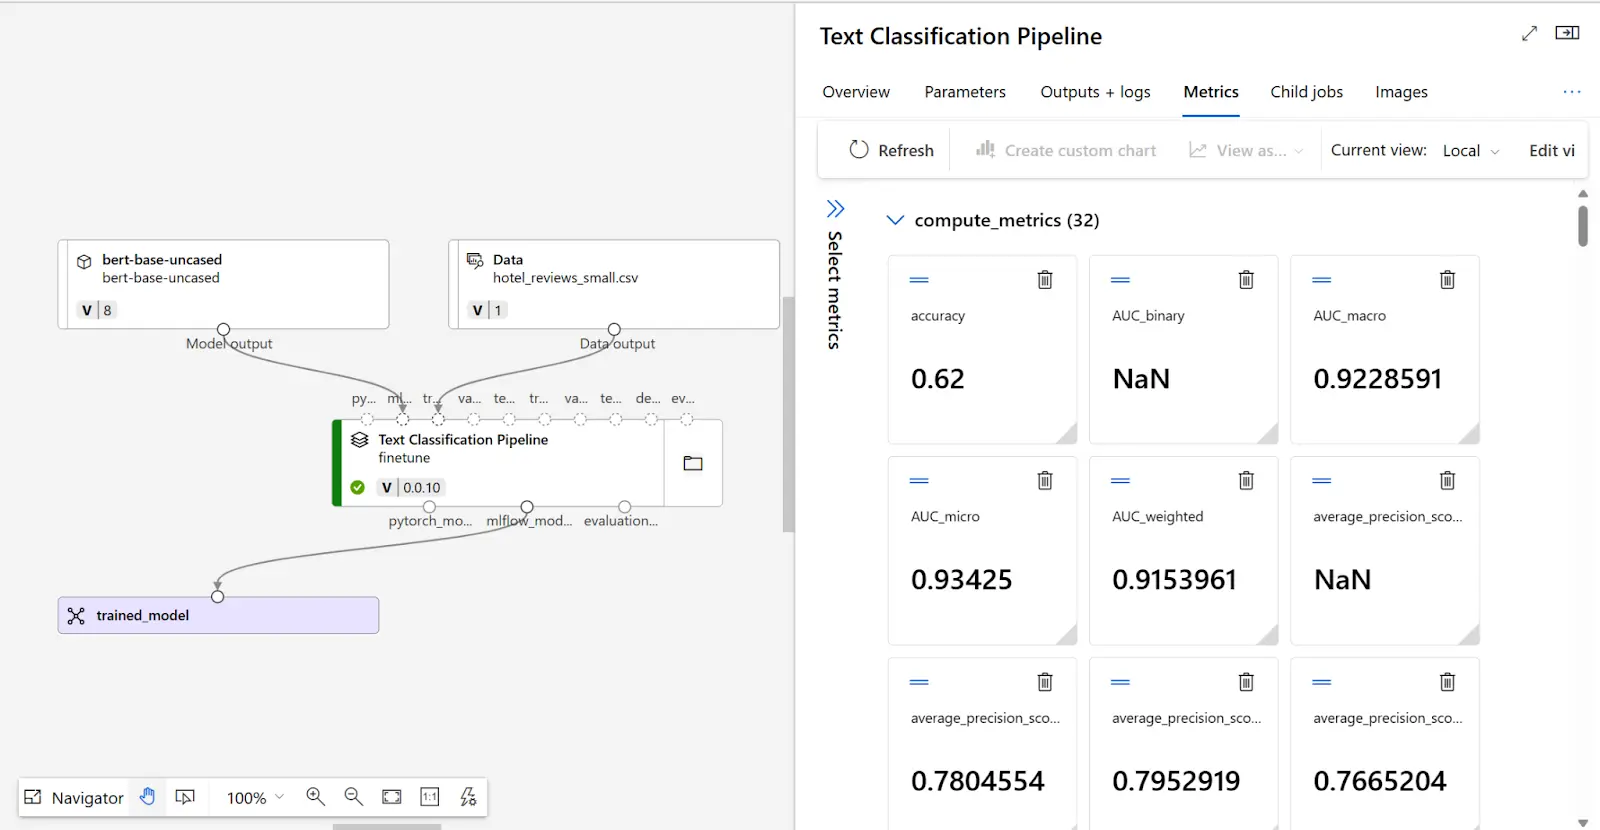
Nachdem Sie den Fine-Tuning-Job übermittelt haben, wird ein Pipeline-Job erstellt, um Ihr Modell zu trainieren. Sie können alle Eingaben überprüfen und das Modell aus den Job-Ausgaben abrufen.
Um zu entscheiden, ob Ihr feinabgestimmtes Modell wie erwartet funktioniert, können Sie die Trainings- und Evaluierungsmetriken überprüfen.
Hauptmerkmale:
Replicate ist ein vielseitiges Tool, das für das Fine-Tuning verschiedener Aspekte von Softwareanwendungen entwickelt wurde. Die Anwendungen von Replicate als Fine-Tuning-Tool umfassen die Optimierung der Leistung, das Anpassen von Konfigurationen und die Erweiterung der Funktionalität mit minimalem Aufwand. Es vereinfacht den Prozess, indem es das GPU-Setup übernimmt. Ähnlich wie die OpenAI API ist es nicht genau „No-Code“ wie andere Tools in der Liste, dennoch lässt es sich im Vergleich zu anderen Tools im vorherigen Abschnitt leicht für das Training einrichten.
Ihre Trainingsdaten müssen im JSONL-Format vorliegen. Nachfolgend finden Sie ein Beispiel dafür, wie Sie diese Datei strukturieren können:
Sie müssen Ihren Replicate-API-Token als Umgebungsvariable in Ihrem Terminal festlegen:
export REPLICATE_API_TOKEN=<your-token-here>
Sie können Ihre Daten in einen S3-Bucket oder direkt bei Replicate mithilfe von curl-Befehlen hochladen:
Sie müssen ein leeres Modell auf Replicate für Ihr trainiertes Modell erstellen. Wenn Ihr Training beendet ist, wird es als neue Version in dieses Modell hochgeladen.
Sie müssen einen Trainingsjob in Ihrer IDE erstellen, wie unten gezeigt:
Um den Fortschritt programmgesteuert zu überwachen, können Sie Folgendes verwenden:
Nachdem das Training abgeschlossen ist, können Sie Ihr Modell mit der API ausführen:
Hauptmerkmale:
Im Gen AI Studio haben Sie beide Optionen zum Einrichten von Fine-Tuning-Jobs: über die API oder die Website. Hier werde ich nur auf die API-Methode eingehen. Es bietet den am stärksten rationalisierten Prozess im Vergleich zu den oben besprochenen Tools.
Ihr Datensatz sollte im JSONL-Format vorliegen, wobei jede Zeile ein JSON-Objekt mit den Schlüsseln "input_text" und "output_text" sein muss. Es kann bereits mit nur 10 Beispielen mit dem Training begonnen werden, es werden jedoch mindestens 100 Beispiele empfohlen.
Sie müssen Ihren Datensatz in einen Google Cloud Storage (GCS) Bucket hochladen. Wenn Sie keinen haben, können Sie einen in Google Drive erstellen.
Jetzt müssen Sie Ihre Anmeldedaten angeben, um die Verbindung herzustellen:
Sie müssen eine Funktion für das Tuning mit den erforderlichen Parametern definieren.
Rufen Sie die zuvor angegebene Tuning-Funktion mit Ihren spezifischen Parametern auf. Der Parameter training_data kann eine GCS-URI oder ein Pandas DataFrame sein.
Hauptmerkmale:
Predibase ist eine spezialisierte Plattform, die entwickelt wurde, um das Fine-Tuning großer Sprachmodelle (LLMs) wie GPT-4 für spezifische Aufgaben oder Anwendungen zu erleichtern. Sie bietet Zugriff auf die fortschrittlichen Fähigkeiten von LLMs, indem sie eine optimierte, benutzerfreundliche Umgebung zur Anpassung dieser Modelle an individuelle Bedürfnisse bereitstellt.
Predibase bietet Ihnen sowohl das Python SDK als auch die Benutzeroberfläche zur Durchführung von Fine-Tuning-Jobs.
Hier ist eine Schritt-für-Schritt-Anleitung zum Fine-Tuning von Mistral-7b-instruct:
Registrieren Sie sich zuerst für ein Konto bei Predibase und tätigen Sie eine Einzahlung, um Guthaben hinzuzufügen. Generieren Sie anschließend Ihren API-Schlüssel.
Gehen Sie zu „Models“ und klicken Sie dann wie unten gezeigt auf „New Model Repository“:
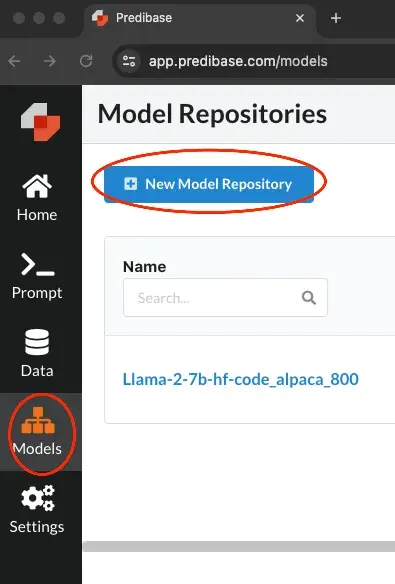
Benennen Sie nun Ihr Repository und fügen Sie eine Beschreibung hinzu.
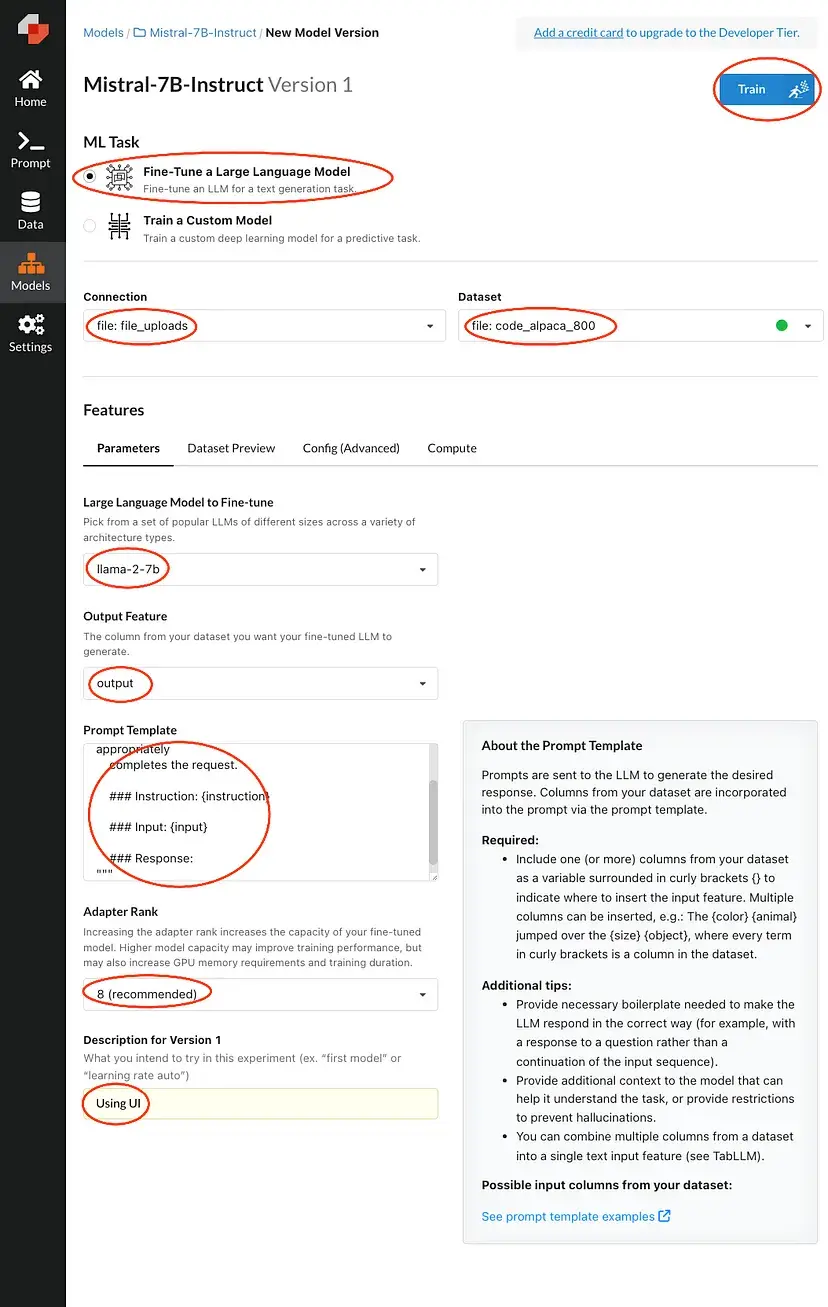
Füllen Sie die hervorgehobenen Bereiche aus und drücken Sie dann auf „Train“. Dadurch wird Ihre Anfrage in eine Warteschlange gestellt, bis Rechenleistung verfügbar ist.
Code-Plattformen sind für Benutzer mit fundierten Programmierkenntnissen konzipiert. Diese Plattformen stellen virtuelle Maschinen bereit, die das Ausführen benutzerdefinierter Python-Skripte für Aufgaben wie das Fine-Tuning ermöglichen. Sie sind perfekt für Projekte geeignet, die eine hohe Anpassung und eine präzise Kontrolle über die Trainings- und Bereitstellungsphasen erfordern.
Amazon SageMaker ist ein vollständig verwalteter Dienst, der Entwicklern und Data Scientists die Möglichkeit bietet, Modelle für maschinelles Lernen schnell zu erstellen, zu trainieren und bereitzustellen.
Amazon SageMaker verfügt über keine spezielle, integrierte „Fine-Tuning“-Funktion, die ausdrücklich so für große Sprachmodelle gekennzeichnet ist. Stattdessen bietet es eine leistungsstarke und flexible Plattform, auf der Sie benutzerdefinierte Python-Skripte ausführen können, um Fine-Tuning-Aufgaben zu erledigen.
Hier ist ein einfaches Beispiel dafür, wie Sie einen Fine-Tuning-Job für ein Sprachmodell mit Hugging Face auf SageMaker starten können. Dies setzt voraus, dass Sie bereits ein AWS-Konto eingerichtet und die AWS CLI konfiguriert haben. (Sie können TensorFlow oder PyTorch direkt auf Amazon SageMaker für Fine-Tuning-Aufgaben verwenden)
Typischerweise schreiben Sie ein Fine-Tuning-Skript (train.py), das Sie an den Estimator übergeben. Dieses Skript sollte Ihre Logik zum Laden des Modells, zum Fine-Tuning und zum Speichern enthalten.
Hauptmerkmale:
Google Colab ist ein beliebter cloudbasierter Jupyter-Notebook-Dienst, der kostenlosen Zugriff auf Rechenressourcen wie GPUs und TPUs bietet, was ihn zu einer hervorragenden Plattform für das Fine-Tuning großer Sprachmodelle (LLMs) macht.
Es ist besonders anfängerfreundlich. Colab-Notebooks laufen in der Cloud direkt über Ihren Browser, ohne dass eine lokale Einrichtung erforderlich ist.
Hier ist der einfache Code-Ausschnitt für das Fine-Tuning eines Transformer-Modells mit Hugging Face Transformers und PyTorch in Google Colab
!pip install torch torchvision transformers
model.save_pretrained("/content/drive/My Drive/Colab Models/my_finetuned_model")
Hauptmerkmale:
Paperspace Gradient ist eine Suite von Tools, die entwickelt wurde, um den Prozess der Entwicklung, des Trainings und der Bereitstellung von Machine-Learning-Modellen in der Cloud zu vereinfachen.
Gradient ist besonders effektiv für Aufgaben wie das Fine-Tuning großer Sprachmodelle (LLMs), da es über eine skalierbare Infrastruktur und Unterstützung für Container verfügt, was es zu einer hervorragenden Wahl für Data Scientists und ML-Experten macht.
Hier ist ein Beispiel für das Fine-Tuning eines Transformer-Modells mit PyTorch auf Paperspace Gradient.
model.save_pretrained("./my_finetuned_model")
Hauptmerkmale:
Run.AI ist eine Plattform zur Optimierung von GPU-Ressourcen für Machine-Learning-Workloads, die es Data Scientists und AI-Forschern erleichtert, komplexe AI-Modelle auszuführen und zu verwalten, einschließlich des Fine-Tunings großer Sprachmodelle (LLMs).
Sie basiert auf Kubernetes, einem Tool, das Computerressourcen effizient organisiert. Dadurch wird die Ausführung komplexer AI-Projekte vereinfacht und Teams können ihre Projekte problemlos skalieren.
Sie können die Run.AI-Dokumentation für detaillierte Einblicke konsultieren. Hier ist ein vereinfachtes Beispiel, das auf dem allgemeinen Workflow für das Fine-Tuning eines Modells wie LLaMA-2 auf der Run.AI-Plattform basiert.
runai submit my-fine-tuning-job -p my-project --gpu 2 --image my-llama2-fine-tuning-image train.py
Ihr train.py-Skript sollte die Logik zum Laden von LLaMA-2 (oder Ihres gewählten Modells), Ihres Datensatzes und zur Ausführung des Fine-Tuning-Prozesses enthalten. Dies kann die Verwendung von Bibliotheken wie Hugging Face Transformers für das Laden des Modells und TensorFlow oder PyTorch für die Trainingsschleife umfassen.
from transformers import LlamaForConditionalGeneration, LlamaTokenizer
Run.AI bietet Tools zur Überwachung der GPU-Auslastung und des Fortschritts Ihrer Trainings-Jobs sowie zur effektiven Verwaltung der Rechenressourcen. Verwenden Sie das Run.AI-Dashboard oder die CLI, um den Status und die Leistung Ihres Jobs zu verfolgen.
runai list jobs
Dieser Befehl listet alle aktuellen Jobs auf, sodass Sie den Fortschritt und die Ressourcennutzung Ihrer Fine-Tuning-Aufgabe überwachen können.
Hauptmerkmale:
Auswahl des richtigen Tools für Sie:
Benutzerfreundlichkeit: Wählen Sie Tools, die einfach zu bedienen sind, insbesondere wenn Sie nicht viel programmieren möchten. Einige Tools erfordern nicht einmal das Schreiben von Code!
Skalierbarkeit: Stellen Sie sicher, dass das Tool mit Ihrem Projekt wachsen kann und größere Datensätze sowie komplexere Modelle reibungslos verarbeitet.
Modell- und Datensatzunterstützung: Wählen Sie Tools, die gut mit den spezifischen Daten- und Modelltypen funktionieren, die Sie verwenden.
Rechenressourcen: Achten Sie auf den Zugriff auf GPUs oder TPUs, wenn Ihr Projekt hohe Rechenleistung benötigt.
Kosten: Bedenken Sie, wie viel Sie ausgeben möchten. Einige Tools sind kostenlos; andere berechnen Kosten basierend auf den genutzten Ressourcen.
Anpassbarkeit und Kontrolle: Wenn Sie sich mit Code auskennen, bevorzugen Sie möglicherweise Tools, mit denen Sie alles feineinstellen können.
Integration: Es ist einfacher, wenn sich das Tool nahtlos in Ihren bestehenden Workflow und Ihre Tools einfügt.
Community und Support: Eine unterstützende Community und eine gute Dokumentation können Ihnen viel Ärger ersparen.
Zu den führenden Fine-Tuning-Tools gehören Hugging Face für den Modellzugriff, SiliconFlow für cloudbasiertes Training und TrueFoundry für Orchestrierung auf Enterprise-Niveau. Open-Source-Bibliotheken wie Axolotl und LLaMA-Factory unterstützen zudem fortgeschrittene Techniken wie LoRA. TrueFoundry vereint auf einzigartige Weise Modellzugriff, Experiment-Tracking und Deployment-Governance auf einer einzigen sicheren Plattform.
Die Kosten für Cloud-Fine-Tuning hängen von den GPU-Rechenstunden, der Modellgröße und den Speicheranforderungen ab. Das Training eines Modells mit 7B Parametern kostet typischerweise zwischen 100 $ und 400 $, während Modelle mit 70B Parametern 10.000 $ übersteigen können. Die Verwendung parametereffizienter Methoden wie QLoRA reduziert diese Ausgaben erheblich auf etwa 50–300 $ pro Trainingsdurchlauf.
PEFT-Fine-Tuning-Tools nutzen Techniken wie LoRA, um nur einen winzigen Bruchteil der Parameter eines Modells anzupassen. Dies reduziert den GPU-Speicherbedarf und ermöglicht es Teams, riesige Modelle auf Consumer-Hardware oder einer einzelnen GPU zu trainieren. Diese Tools beschleunigen die Trainingsgeschwindigkeit und liefern gleichzeitig eine Genauigkeit, die mit dem vollständigen Nachtrainieren des Modells vergleichbar ist.
Fine-Tuning-Tools trainieren Modelle auf spezialisierten Datensätzen nach und passen Parameter an, um die Leistung bei domänenspezifischen Aufgaben zu verbessern. Prompt Engineering modifiziert den Eingabetext, um Ausgaben zu steuern, ohne die internen Modellgewichte zu ändern. Während Prompt Engineering schneller ist, bietet Fine-Tuning eine tiefere Kontrolle und überlegene Genauigkeit für komplexe Enterprise-Anwendungsfälle.
TrueFoundry vereinfacht das Fine-Tuning durch die Bereitstellung einer einheitlichen Schnittstelle für Datenintegration, Experiment-Tracking und Modellbereitstellung. Benutzer laden proprietäre Daten hoch und starten Fine-Tuning-Jobs auf optimierter Infrastruktur unter Verwendung von Hochleistungs-Backends. Sobald das Training abgeschlossen ist, können Teams aktualisierte Checkpoints mit einem einzigen Klick direkt in die Produktion deployen.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet