October 26, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Die Ausgaben für LLM-APIs in Unternehmen haben sich innerhalb von sechs Monaten von 3,5 Milliarden US-Dollar Ende 2024 auf 8,4 Milliarden US-Dollar Mitte 2025 mehr als verdoppelt – und ein Ende ist nicht in Sicht. Gartner prognostiziert weltweite KI-Ausgaben von 2,52 Billionen US-Dollar für das Jahr 2026, was einem Anstieg von 44 % gegenüber dem Vorjahr entspricht.
Die Ironie dabei ist, dass die Token-Preise so niedrig sind wie nie zuvor. Modelle der GPT-4-Klasse kosten nur noch einen Bruchteil dessen, was sie vor achtzehn Monaten gekostet haben. Die Rechnung explodiert, weil das Nutzungsvolumen schneller wächst als die Preise sinken, angetrieben durch agentische Workflows, die pro Sitzung 10- bis 100-mal mehr Token verbrauchen als herkömmliche Chatbots, sowie durch die Verbreitung von LLM-Aufrufen in Produktfunktionen, die von Teams ohne jegliche Kostendisziplin entwickelt wurden.
Praxis-Audits offenbaren eine unangenehme Wahrheit: 40–60 % der Token-Budgets in produktiven LLM-Anwendungen sind reine Verschwendung. Redundante Aufrufe für identische Prompts. Flaggschiff-Modelle, die Aufgaben übernehmen, die auch günstigere Modelle genauso gut erledigen könnten. Fehlende Ratenbegrenzungen für Entwickler- oder CI-Pipelines. Keine Budgetobergrenzen, die greifen, bevor die Monatsrechnung eintrifft. Keine Transparenz darüber, welches Team, welche Funktion oder welcher Anwendungsfall die Kosten treibt.
Die Optimierungstechniken existieren – semantisches Caching, intelligentes Modell-Routing, hierarchische Budgetlimits, Fallback-Ketten zwischen On-Premise und Cloud. Das Problem ist, dass man diese ohne eine zentrale Steuerungsebene nicht skalierbar implementieren kann. Ohne eine Instanz zwischen Ihren Anwendungen und Ihren Modellanbietern findet jede Optimierung im Anwendungscode statt – dupliziert in jedem Team, ohne Governance und ohne Observability.
Ein AI Gateway ist genau diese Steuerungsebene. Dieser Leitfaden erklärt, warum das so ist, und zeigt genau, wie das AI Gateway von TrueFoundry – ausgezeichnet in Gartners „Best Practices for Optimizing Generative & Agentic AI Costs 2026“ – jeden Kostenhebel auf Infrastrukturebene implementiert, unabhängig davon, was die einzelnen Teams in ihren Anwendungen tun.
Die meisten Unternehmen gehen bei der LLM-Kostenoptimierung genauso vor wie vor fünf Jahren beim API-Kostenmanagement: Jedes Team ist für seine eigene Nutzung verantwortlich, die Anbieter schicken monatliche Rechnungen und irgendjemand aus der Technikabteilung schaut sich den Gesamtbetrag an und zuckt zusammen.
Dieser Ansatz führt bei LLM-Workloads zu vier strukturellen Problemen:
1. Fehlende Zuordnung. Wenn Ihre OpenAI-Rechnung eintrifft, sehen Sie den gesamten Token-Verbrauch Ihres Unternehmens. Sie sehen jedoch nicht, welche Anwendung, welches Team, welche Funktion oder welcher Nutzer diesen Verbrauch verursacht hat. Sie können keine Nachforschungen anstellen. Sie können keine Kosten zuordnen. Sie können nicht identifizieren, welche 20 % der Anwendungsfälle für 80 % der Ausgaben verantwortlich sind – obwohl dieses 80/20-Verhältnis mit an Sicherheit grenzender Wahrscheinlichkeit auch in Ihren Daten vorhanden ist.
2. Fehlende Prävention. Kostenanomalien bei LLM-Workloads treten schnell auf. Ein Fehler, der einen Agenten in eine Endlosschleife schickt, kann innerhalb von Minuten Tausende von Dollar verschlingen. Ein Entwickler, der eine neue Funktion mit einem kontextintensiven Prompt testet, kann das Monatsbudget an einem Nachmittag aufbrauchen. Ohne Ratenbegrenzungen und Budgetobergrenzen auf Infrastrukturebene werden diese Vorfälle erst auf der monatlichen Rechnung entdeckt und nicht in dem Moment, in dem sie passieren.
3. Fehlende Hebelwirkung. Die effektivsten Kostenoptimierungen – semantisches Caching, Modell-Routing, Fallback-Ketten zwischen On-Premise und Cloud – funktionieren am besten auf Infrastrukturebene, wo sie gleichzeitig auf alle Anwendungen angewendet werden können. Werden sie in einzelnen Anwendungen implementiert, muss jedes Team dieselbe Infrastruktur neu aufbauen, was zu inkonsistenter Abdeckung und fehlender gemeinsamer Cache-Nutzung über Anwendungen hinweg führt.
4. Fehlende Modellflexibilität. Wenn Sie Anfragen direkt aus dem Anwendungscode an die Anbieter leiten, erfordert ein Modellwechsel Codeänderungen in jeder Anwendung. Diese Reibungsverluste hindern Teams daran, günstigere Modelle zu nutzen, sobald diese verfügbar sind, und machen es für ein Plattform-Team unmöglich, Richtlinien für Modell-Tiers unternehmensweit durchzusetzen.
Das AI Gateway löst alle vier Probleme, indem es als zentraler Durchsetzungspunkt für jeden LLM-Aufruf in Ihrem Unternehmen fungiert. Leiten Sie alles über das Gateway und Sie erhalten Zuordnung, Prävention, Hebelwirkung und Flexibilität – zentral und ohne den Anwendungscode anzupassen.
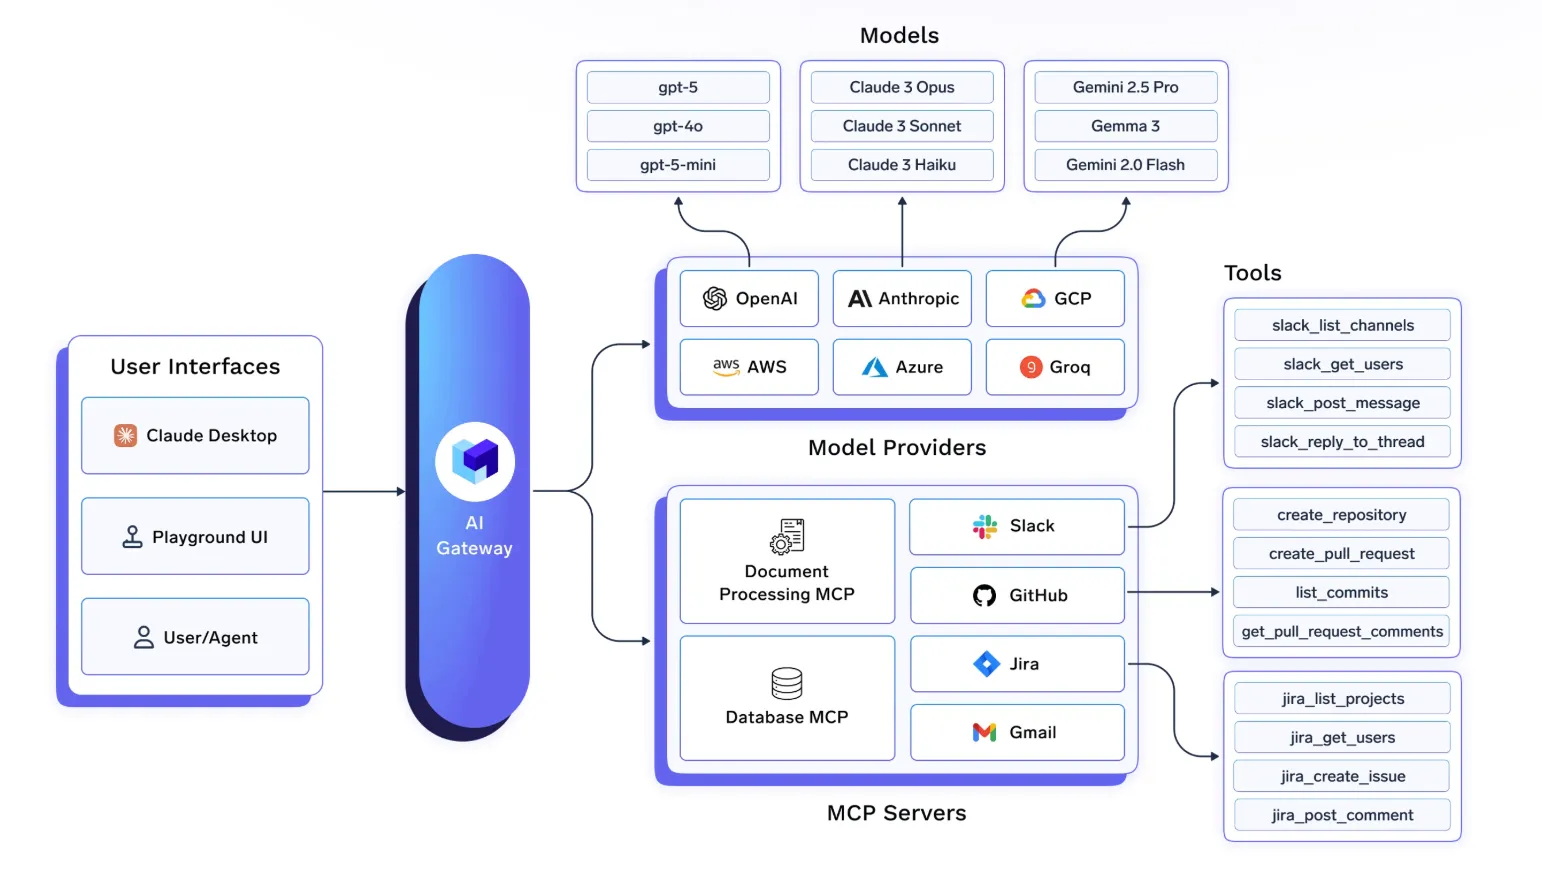
Was man nicht sehen kann, kann man nicht optimieren. Das erste Ergebnis des Gateway-Routings für den gesamten LLM-Datenverkehr ist ein vollständiger, zuordenbarer und abfragbarer Datensatz jedes Modellaufrufs – unterteilt nach Nutzer, Team, virtuellem Konto, Anwendung und Modell.
TrueFoundry AI Gateway erfasst automatisch die Kosten pro Anfrage mithilfe eines Open-Source-Preiskatalog der stets auf dem neuesten Stand der von Anbietern veröffentlichten Tarife bleibt, einschließlich gestaffelter Preise (z. B. die unterschiedlichen Tarife von Gemini 2.5 Pro ab 200.000 Token) und regionsspezifischer Preise (z. B. die Tarife von AWS Bedrock Nova Lite pro Region). Für Modelle mit individuellen Verträgen oder Preisen für Feinabstimmungen Private Kosten ermöglicht die Konfiguration die Festlegung exakter Token-Preise, die direkt in alle Dashboards einfließen.
Das Ergebnis: ein Live-Dashboard, das die Kosten aufgeschlüsselt nach Team, Benutzer, virtuellem Konto, Modell und Anwendung anzeigt – filterbar nach jedem Metadaten-Tag, das Sie im X-TFY-METADATA Header übergeben. Versehen Sie jede Anfrage mit project_id, feature, customer_id oder environment, und Ihre Kostendashboards segmentieren automatisch nach diesen Dimensionen.
Siehe TrueFoundry-Dokumentation zur Kostenverfolgung für die Einrichtung.
Dies ist die wichtigste Kontrollmaßnahme, die Sie implementieren sollten. Bevor Sie Ausgaben optimieren, müssen Sie katastrophale Kosten verhindern. Budget- und Ratenbegrenzungen auf Gateway-Ebene fungieren als Schutz schalter, die auslösen, bevor die Rechnung eintrifft.
Die Budgetbegrenzung von TrueFoundry ist hierarchisch aufgebaut – Regeln lassen sich stapeln und kombinieren:
Ratenbegrenzung am TrueFoundry-Gateway deckt drei verschiedene Szenarien ab:
Hier liegen die größten Kosteneinsparungen. Untersuchungen zeigen konsistent, dass 60–80 % der LLM-Kosten in Unternehmen auf 20–30 % der Anwendungsfälle entfallen. Diese Konzentration betrifft fast immer Aufgaben mit hohem Volumen und geringer Komplexität, bei denen ein Spitzenmodell völlig überdimensioniert ist.
RouteLLM (veröffentlicht auf der ICLR 2025) hat gezeigt, dass ein gut trainierter Komplexitäts-Router 95 % der GPT-4-Leistung erreichen kann, während nur 14–26 % der Anfragen an das teure Modell weitergeleitet werden – eine Kostenreduzierung von 75–85 % bei gerouteten Workloads. Diese Einsparungen sind ohne Qualitätseinbußen möglich. Die Voraussetzung dafür ist eine Routing-Ebene.
TrueFoundrys virtuelle Modelle implementieren drei Routing-Strategien, die direkt auf Szenarien zur Kostenoptimierung zugeschnitten sind:
Das Muster „On-Premise primär mit Cloud-Fallback“ ist die Routing-Konfiguration mit dem höchsten ROI für Unternehmen mit eigener GPU-Infrastruktur:
name: loadbalancing-config
type: gateway-load-balancing-config
rules:
  - id: priority-failover
    type: priority-based-routing
    when:
      models:
        - gpt-4
    load_balance_targets:
      - target: onprem/llama
        priority: 0
        fallback_status_codes: ["429", "500", "502", "503"]
      - target: bedrock/llama
        priority: 1
        retry_config:
          attempts: 2
          delay: 100
Der Datenverkehr bleibt auf Ihren GPUs (null Grenzkosten), bis die Kapazität erschöpft ist, und weicht dann automatisch auf Bedrock aus. Die Cloud-API fungiert als Kapazitätspuffer, nicht als Standardlösung. Siehe TrueFoundry-Dokumentation zum Load Balancing für vollständige Konfigurationsoptionen.
Das Routing kann auch nach Metadaten gefiltert werden – leiten Sie Entwicklungsumgebungen an ein günstigeres Modell-Tier und die Produktion an das Premium-Modell weiter, ganz ohne Änderungen am Anwendungscode:
- id: dev-environment
  type: weight-based-routing
  when:
    models: [gpt-4]
    metadata:
      environment: development
  load_balance_targets:
    - target: openai-dev/gpt4-mini
weight: 100Caching ist der unmittelbarste Hebel zur Kostensenkung bei Workloads mit wiederkehrenden Abfragen. Wiederholte oder semantisch ähnliche Prompts liefern sofort zwischengespeicherte Antworten – null verbrauchte Token, null Provider-Kosten und eine drastisch geringere Latenz.
TrueFoundry AI Gateway unterstützt zwei Caching-Modi:
Exact Match Caching speichert und liefert Antworten für byte-identische Prompts. Keine Fehlalarme – derselbe Prompt liefert immer dieselbe zwischengespeicherte Antwort. Die Trefferquote hängt vom Workload ab; am besten geeignet für API-gesteuerte, vorlagenbasierte Prompts mit konsistenten Parametern.
Semantisches Caching nutzt Embedding-Ähnlichkeit, um Prompts abzugleichen, die dasselbe bedeuten, auch wenn sie anders formuliert sind. Eine Frage wie „Wie setze ich mein Passwort zurück?“ und „Ich habe mein Passwort vergessen, was soll ich tun?“ liefern dieselbe zwischengespeicherte Antwort. Typische Kostensenkung: 30–50 % bei Kundensupport-, FAQ- und Dokumentations-Workloads mit repetitiven Abfragemustern. Siehe TrueFoundry-Leitfaden für semantisches Caching für Implementierungsdetails und die Anpassung von Ähnlichkeitsschwellenwerten.
Beide Modi unterstützen konfigurierbare Cache-Ablaufrichtlinien und manuelle Invalidierung – so bleiben zwischengespeicherte Antworten für zeitkritische Daten aktuell, während statische Inhalte unbegrenzt im Cache verbleiben können.
Provider-natives Prompt-Caching fungiert neben dem Gateway-Caching als ergänzender Hebel. Das Prompt-Caching der Claude-API von Anthropic reduziert die Kosten für Input-Token um bis zu 90 % bei zwischengespeicherten Präfixen mit einer Verbesserung der Time-to-First-Token um 13–31 %. Dies geschieht auf Anbieterebene – das Gateway leitet die Anfrage an den richtigen Endpunkt weiter und der Anbieter wendet bei unterstützten Modellen automatisch Prompt-Caching an.
Jede vom Gateway verarbeitete Anfrage wird automatisch mit folgenden Informationen versehen:
X-TFY-METADATA (project_id, feature, customer_id, environment) übermitteln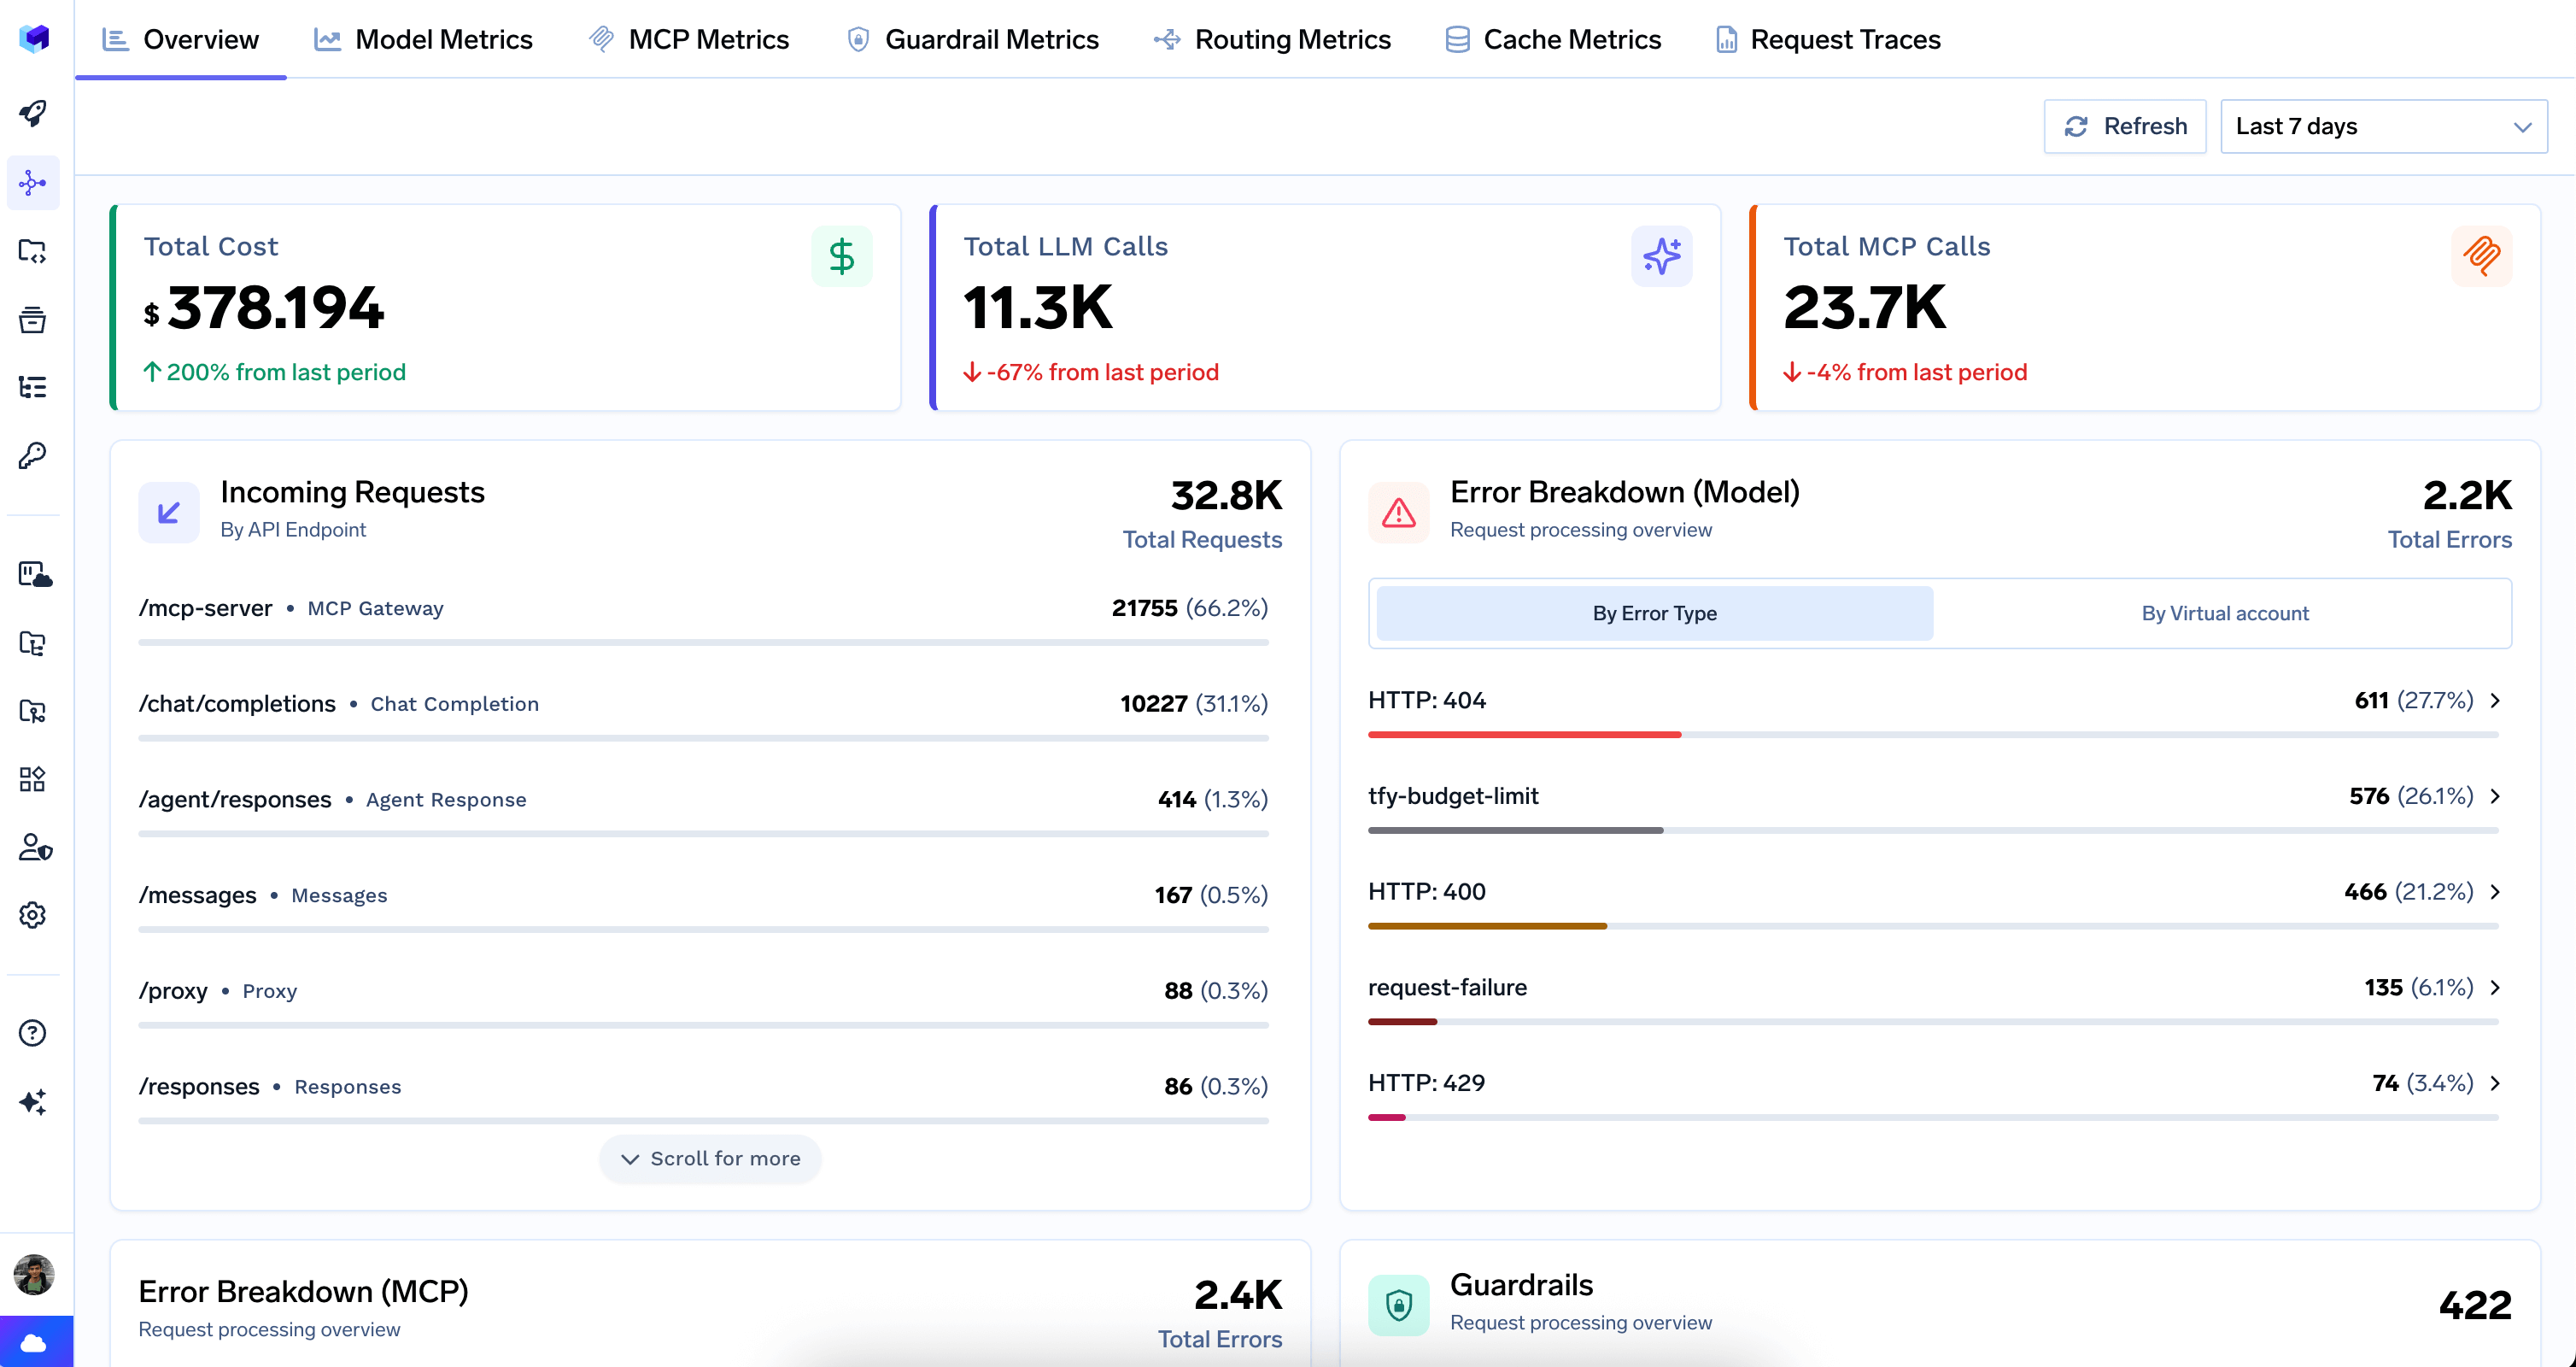
Das Analytics-Dashboard stellt all dies in vorgefertigten Ansichten dar, gruppiert nach Benutzern, virtuellen Konten, Teams und Konfigurationen. Der Tab für Routing-Metriken zeigt an, welche Budget- und Ratenbegrenzungen von wem erreicht werden. So wissen Sie genau, welches Team sein Budget ausschöpft, bevor der Monat endet – und nicht erst danach.
Alle Traces exportieren via OpenTelemetry an jedes beliebige SIEM oder jede Observability-Plattform – wie Grafana, Datadog, Splunk oder Ihren bestehenden Stack – und ermöglichen so benutzerdefinierte Dashboards, automatisierte Benachrichtigungen sowie die Integration in Ihre vorhandenen FinOps-Tools.
Die Budget-Engine von TrueFoundry wertet pro Anfrage mehrere Regeln aus, wobei die restriktivste zutreffende Regel greift. Die Regeln sind geordnet und kombinierbar:
Praxisbeispiel: Tägliche Limits pro Entwickler mit Team-Überschreibungen
Mitglieder des ML-Teams greifen zuerst auf Regel 1 zu (100 $/Tag). Alle anderen Entwickler unterliegen Regel 2 (10 $/Tag). Beide Regeln werden zur Nachverfolgung ausgewertet, aber die erste Übereinstimmung bestimmt die Entscheidung über Zulassung oder Sperrung.
Ein Sicherheitsnetz auf Modellebene hinzufügen
Einzelne Nutzer bleiben innerhalb von 10 $/Tag. Doch selbst wenn jeder Nutzer sein Limit einhält, sind die gesamten GPT-4-Ausgaben unternehmensweit auf 500 $/Monat begrenzt – dies verhindert, dass viele Nutzer, die individuell innerhalb ihrer Limits liegen, gemeinsam Ihr Modellbudget ausschöpfen.
Siehe Dokumentation zur Budgetbegrenzung von TrueFoundry für das vollständige Regelschema.
Ratenlimits können über Nutzer und Teams hinaus definiert werden – mit gezieltem Fokus auf bestimmte Umgebungen, Modelle oder Anwendungen:
name: ratelimiting-config
type: gateway-rate-limiting-config
rules:
  - id: openai-gpt4-dev-env
    when:
      models: ['openai-main/gpt4']
      metadata:
        env: dev
    limit_to: 1000
    unit: requests_per_day
Dies begrenzt die GPT-4-Nutzung in der Entwicklungsumgebung auf 1.000 Anfragen pro Tag, ohne den Produktionsverkehr zu beeinträchtigen. CI/CD-Pipelines, die während des Tests auf LLMs zugreifen – eine häufige Quelle unerwarteter Kosten –, werden so begrenzt, ohne die CI-Konfiguration anpassen zu müssen.
Siehe die Dokumentation zur Ratenbegrenzung von TrueFoundry für alle Konfigurationsoptionen.
Fallbacks sind nicht nur Funktionen zur Zuverlässigkeit – sie sind Mechanismen zur Kostenkontrolle. Ein automatisches Failover bei 429-Antworten (Ratenbegrenzung) eines Anbieters stellt sicher, dass Sie nicht für Wiederholungsversuche oder fehlgeschlagene Anfragen bezahlen.
Die Fallback-Kette des Gateways bewältigt die folgenden Szenarien automatisch:
TrueFoundry Lastverteilung und Fallbacks unterstützen alle drei Routing-Strategien (Priorität, Gewichtung, Latenz) mit zielspezifischer Konfiguration für Wiederholungsversuche – Sie müssen also nicht in jeder Anwendung eine eigene Logik für Wiederholungsversuche implementieren.
Die genauen Einsparungen hängen von der Zusammensetzung Ihrer Arbeitslast ab, aber dieses Rahmenwerk bietet einen richtungsweisenden Überblick über das Potenzial:
Ein realistisches kombiniertes Szenario: Eine Engineering-Organisation mit 500 Mitarbeitern und monatlichen LLM-API-Kosten von 150.000 $. Semantisches Caching mit einer Trefferquote von 40 % spart insgesamt 20 %. Das Routing von Entwicklungsumgebungen auf günstigere Modelle spart 15 %. Die Nutzung von On-Premise-Lösungen für 60 % des Datenverkehrs spart weitere 25 %. Kombiniert: 60 % Reduzierung oder 90.000 $ Ersparnis pro Monat. Bei der Preisgestaltung des TrueFoundry Gateways misst sich der ROI in Tagen, nicht in Quartalen.
Woche 1 – Transparenz zuerst. Leiten Sie den gesamten LLM-Traffic über das TrueFoundry AI Gateway. Aktivieren Sie die Kostenverfolgung mit öffentlichen Preisen. Versehen Sie jede Anfrage mit Ihren Attributions-Metadaten (team, project_id, environment). Nach einer Woche wissen Sie genau, wohin Ihr Geld fließt. Allein das ändert die Diskussion von „unsere KI-Rechnung ist zu hoch“ hin zu „die Dokumentenanalyse-Pipeline in Team X verursacht 40 % der Kosten.“
Woche 2 – Prävention. Konfigurieren Sie Budget- und Ratenbegrenzungen basierend auf den Erkenntnissen aus Woche 1. Deckeln Sie die täglichen Ausgaben pro Entwickler. Fügen Sie umgebungsbasierte Ratenbegrenzungen für Dev/Staging hinzu. Legen Sie ein monatliches Limit auf Modellebene für Ihr teuerstes Modell fest. Diese Kontrollmechanismen verhindern den nächsten Vorfall. Sie optimieren nicht – sie schützen.
Woche 3 – Routing. Erstellen Sie virtuelle Modelle, die umgebungsbasiertes Routing (Dev → günstigeres Modell, Prod → Premium-Modell) und Prioritätsketten für Anbieter implementieren. Wenn Sie über On-Premise-GPU-Kapazitäten verfügen, konfigurieren Sie ein prioritätsbasiertes Routing mit Cloud-Fallback. Hier zeigen sich die signifikanten Einsparungen.
Woche 4+ – Caching und Optimierung. Aktivieren Sie semantisches Caching für Workloads mit wiederkehrenden Mustern. Passen Sie die Ähnlichkeitsschwellenwerte an. Überprüfen Sie das Dashboard für Routing-Metriken, um zu verstehen, welche Budget- und Ratenbegrenzungen am häufigsten erreicht werden, und nehmen Sie entsprechende Anpassungen vor. Die Analyseschicht zeigt Ihnen, wo Sie als Nächstes ansetzen sollten.
Jedes Team erhält ein eigenes virtuelles Konto mit unabhängiger Budgetverfolgung. Das Plattform-Team legt Modellobergrenzen auf Organisationsebene und standardmäßige Ratenbegrenzungen fest. Die jeweiligen Teamleiter können die Kostenaufschlüsselung ihres Teams einsehen, ohne Zugriff auf die Daten anderer Teams zu haben.
Wichtige Konfiguration: Projektbasierte Budgets unter Verwendung von Metadaten + wöchentliche Obergrenzen für virtuelle Konten + monatliche Obergrenzen auf Modellebene als organisationsweite Sicherheitsnetze.
Siehe TrueFoundry AI Gateway-Analysen für die Einrichtung des Dashboards auf Teamebene.
KI-Produkte für Endkunden benötigen eine nutzungsbasierte Nachverfolgung pro Kunde, um Rückbelastungen oder gestaffelte Abrechnungen zu implementieren. Versehen Sie jede Anfrage mit customer_id in den Metadaten. Das Gateway erfasst die Kosten pro customer_id automatisch. Legen Sie Ratenbegrenzungen pro Kunde fest, die den jeweiligen Tarifstufen entsprechen.
Wichtige Konfiguration: Metadatenbasierte Budgetregeln pro customer_id + Ratenbegrenzungen basierend auf der Kundenebene. Dies liefert Ihnen präzise Daten für Ihre Abrechnungspipeline, ganz ohne eigene Infrastruktur für die Messung.
Agentenbasierte Workloads sind das kostenintensivste LLM-Muster. Eine einzelne Agentenaufgabe kann Tausende von Token über Dutzende von Modellaufrufen hinweg verbrauchen. Budgetobergrenzen sind bei agentenbasierten Workloads keine Option, sondern der wichtigste Sicherheitsmechanismus.
Leiten Sie den gesamten Agenten-Traffic über das Gateway mittels ANTHROPIC_BASE_URL (oder Äquivalent). Legen Sie virtuelle Schlüssel pro Agenten-Identität mit täglichen Budgetlimits fest. Konfigurieren Sie Fallback-Ketten zwischen On-Premise und Cloud, damit langlebige Agenten für Routineaufgaben bevorzugt günstigere On-Premise-Kapazitäten nutzen.
Siehe TrueFoundry Claude Code Integrationsanleitung für die Konfiguration der Agenten-Bereitstellung.
Das Fehlen eines Gateways verursacht selbst Kosten. Diese zeigen sich auf vier Arten:
Vorfallkosten. Eine Agentenschleife ohne Ratenbegrenzung, ein Entwickler, der kontextintensive Prompts testet, ein Fehler, der redundante API-Aufrufe generiert – solche Ereignisse kommen vor. Die Frage ist nur, ob sie bei 50 $ gestoppt werden oder erst bei 5.000 $ auf der monatlichen Abrechnung auffallen.
Optimierungsverzögerung. Ohne zentrales Routing baut jedes Team, das günstigere Modell-Fallbacks oder Caching implementieren möchte, eine eigene Lösung. Plattformweite Optimierungen, die einen Ingenieur eine Woche kosten würden, führen stattdessen zu sechs Monaten fragmentierter Arbeit über verschiedene Teams hinweg.
Zuordnungslücke. Wenn Sie Kosten nicht Teams, Anwendungen oder Funktionen zuordnen können, können Sie niemanden für die KI-Ausgaben verantwortlich machen und die effektivsten Optimierungsziele nicht identifizieren.
Compliance-Risiken. In regulierten Branchen oder bei Multi-Tenant-Produkten ist die Unfähigkeit, Kosten und Nutzung pro Kunde oder Team nachzuweisen, nicht nur ein finanzielles Problem, sondern ein Problem der Governance und der Abrechnungsgenauigkeit.
Die Kostenoptimierung für LLMs umfasst Strategien und Kontrollmechanismen, mit denen Unternehmen ihre Ausgaben für Large-Language-Model-API-Aufrufe senken können, ohne die Qualität der Ergebnisse zu beeinträchtigen. Dies ist aktuell von entscheidender Bedeutung, da sich die Ausgaben für Unternehmens-LLM-APIs innerhalb von sechs Monaten verdoppelt haben und bis Ende 2026 voraussichtlich 15 Milliarden US-Dollar erreichen werden – getrieben durch agentische Workloads, die weitaus mehr Token verbrauchen als herkömmliche Chatbot-Anwendungen. Ohne eine systematische Kostenoptimierung sind 40–60 % dieser Ausgaben reine Verschwendung: redundante Aufrufe, überdimensionierte Modelle für einfache Aufgaben, fehlendes Caching und mangelnde Budgetkontrollen.
Sie können zwar einzelne Optimierungen direkt im Anwendungscode implementieren, stoßen dabei jedoch auf drei Probleme: Jedes Team baut dieselbe Infrastruktur inkonsistent neu auf; Sie haben keine zentrale Übersicht, um zu erkennen, wo Optimierungen am sinnvollsten sind; und die Optimierungen sind immer nur so gut wie die am wenigsten gewartete Anwendung in Ihrem Stack. Ein AI-Gateway wendet Kostenkontrollen universell, zentral und für alle Anwendungen gleichzeitig an, ohne dass einzelne Teams selbst etwas implementieren müssen. Eine einzige Routing-Regel im Gateway ersetzt Hunderte von Codeänderungen in Dutzenden von Anwendungen.
Semantisches Caching senkt die Kosten bei Workloads mit häufig wiederkehrenden Abfragen in der Regel um 30–50 % – etwa bei Kundensupport, FAQ-Systemen, Dokumentationssuche oder Klassifizierungs-Pipelines. Die Einsparungen entstehen dadurch, dass für Anfragen, die semantisch bereits beantworteten Fragen ähneln, zwischengespeicherte Antworten zurückgegeben werden (keine Kosten beim Anbieter, nahezu null Latenz). Die Trefferquoten hängen stark von den Workload-Mustern ab; bei Workloads mit vielfältigen, einzigartigen Anfragen sind die Trefferquoten niedriger. Weitere Informationen zur Bewertung von Workloads und zur Anpassung von Schwellenwerten finden Sie im TrueFoundry-Leitfaden für semantisches Caching .
Beim Modell-Routing wird jede LLM-Anfrage basierend auf Komplexität, Team, Umgebung oder anderen Kriterien an das kosteneffizienteste Modell weitergeleitet. Untersuchungen (RouteLLM, ICLR 2025) haben gezeigt, dass bereits die Weiterleitung von nur 14–26 % der Anfragen an ein Spitzenmodell, während der Rest von einem günstigeren Modell verarbeitet wird, 95 % der Leistung eines Spitzenmodells bei 75–85 % geringeren Kosten ermöglicht.In der Praxis ist für Unternehmen mit eigener GPU-Infrastruktur das Routing mit On-Premise-Priorität und Cloud-Fallback am effektivsten: Der Datenverkehr bleibt auf Ihren eigenen GPUs (nahezu null Grenzkosten) und weicht nur dann auf Cloud-APIs aus, wenn die Kapazität erschöpft ist. Virtuelle Modelle von TrueFoundry implementieren alle drei Routing-Strategien (Priorität, Gewichtung, Latenz) ohne Änderungen am Anwendungscode.
Die Budgetbegrenzung von TrueFoundry ist hierarchisch und regelbasiert. Sie definieren Regeln, die festlegen, für wen sie gelten (einzelne Nutzer, Teams, virtuelle Konten, Modelle oder Metadatenwerte), sowie einen Budgetbetrag und ein Zeitfenster (z. B. 10 $/Tag pro Nutzer). Zudem legen Sie fest, ob das Limit individuell oder geteilt gilt. Mehrere Regeln können kombiniert werden – ein Entwickler kann beispielsweise ein persönliches Limit von 10 $/Tag haben und gleichzeitig zu einem organisationsweiten GPT-4-Budget von 500 $/Monat beitragen. Sobald ein geltendes Limit überschritten wird, blockiert das Gateway die Anfrage und gibt eine Fehlermeldung aus, bevor Token-Kosten entstehen. Es lassen sich Benachrichtigungen konfigurieren, die ausgelöst werden, bevor das Limit erreicht ist.
Das Kostenproblem bei LLMs ist ein Infrastrukturproblem, kein Anwendungsproblem. Es lässt sich nicht lösen, indem man einzelne Teams dazu anhält, ihre Prompts effizienter zu gestalten oder eigene Ratenbegrenzungen einzuführen. Es erfordert eine zentrale Steuerungsebene, die eine Kostenkontrolle für jeden LLM-Aufruf anwendet, bevor Token verbraucht werden – und nicht erst, wenn die Rechnung eintrifft.
Ein AI Gateway bildet genau diese Ebene. Es macht Kosten transparent (Attribution), verhindert Verschwendung (Budgetlimits und Ratenkontrollen), macht teure Modelle zur Ausnahme (intelligentes Routing) und macht wiederholte Berechnungen kostenlos (Caching). Jeder dieser Vorteile ist unabhängig nutzbar; in Kombination führen sie bei produktiven LLM-Workloads regelmäßig zu Kosteneinsparungen von 50–80 %.
Das AI Gateway von TrueFoundry implementiert alle vier Hebel in einer einzigen Plattform, die 2026 von Gartner für die Kostenoptimierung von agentischer KI ausgezeichnet wurde. Mit einem Overhead von unter 4 ms und über 350 RPS auf 1 vCPU fügt das Gateway keine nennenswerte Latenz hinzu, bietet jedoch alle wesentlichen Kostenkontrollmechanismen.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet