November 10, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Deepgram ist ein Anbieter für Speech-to-Text und Text-to-Speech, der für Echtzeit-Sprachanwendungen in der Produktion entwickelt wurde. Das aktuelle Flaggschiff-Transkriptionsmodell, Nova-3, verarbeitet sowohl vorab aufgezeichnetes als auch gestreamtes Audio mit Smart Formatting, Diarization und mehrsprachiger Unterstützung. Auf der Ausgabeseite wandelt Aura Text in natürliche Sprache für Voice Agents und IVR-Systeme um.
Innerhalb jeder Interaktion einer Sprachanwendung besetzen sie die entgegengesetzten Seiten: Der Anrufer sagt etwas, Nova-3 wandelt das Audiosignal in Text um, ein LLM zieht daraus Rückschlüsse, und Aura (oder eine andere TTS-Engine) spricht das Ergebnis laut aus. Da Deepgram schnell und präzise ist, entwickelt es sich zum Standardwerkzeug sowohl für Transkriptions- als auch zunehmend für Sprachausgabe-Schritte.
Das Problem liegt in der Praxis. Deepgram ist ein weiterer Anbieter mit einem weiteren API-Schlüssel, einem weiteren SDK und weiteren Kosten. Da es auf Basis der Dauer und der Anzahl der transkribierten Zeichen und nicht nach Tokens abgerechnet wird, ist es nicht Teil Ihres LLM-Kostentrackings. Für ein einzelnes Projekt mag das akzeptabel sein. In einem Unternehmen mit einem ganzen Team von Voice Bots führt dies jedoch zu einem Governance-Problem.
Hier ist die Pay-as-you-go-Preisliste für die Modelle, die Sie am wahrscheinlichsten verwenden werden.
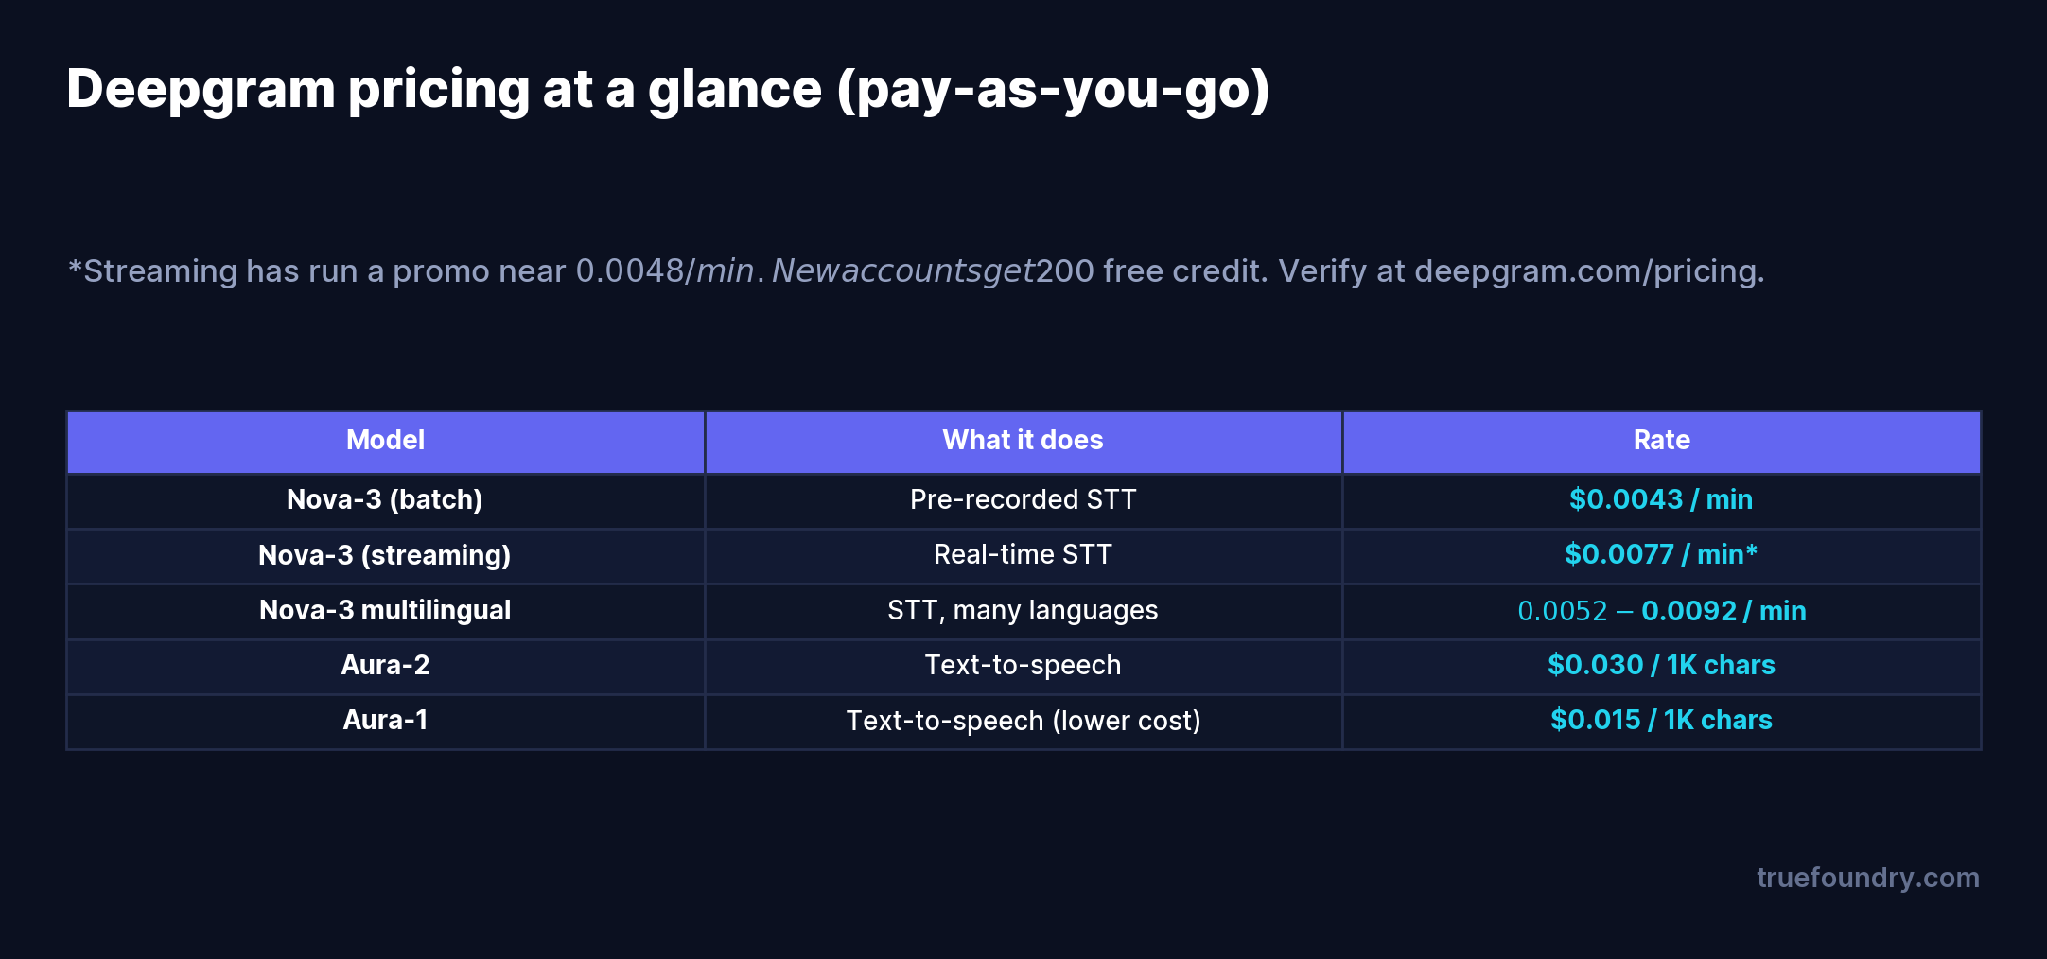
Zwei Dinge sind zu beachten. Erstens: Die Abrechnungseinheit ist nicht das Token. STT wird pro Audiominute abgerechnet, TTS pro 1.000 Zeichen Eingabetext. Diese Abweichung ist genau der Grund, warum Sprachkosten in tokenbasierten Dashboards oft fehlen. Zweitens: Streaming kostet mehr als Batch-Verarbeitung — Echtzeit-Transkription ist teurer als die Verarbeitung vorab aufgezeichneter Audiodateien. Ein Live-Voice-Agent wird also anders kalkuliert als eine Offline-Transkriptions-Pipeline. Neue Konten erhalten zu Beginn ein Startguthaben von 200 $ [Prüfen Sie aktuelle Tarife und Guthaben auf deepgram.com/pricing; Aktionspreise für Streaming können variieren].
Ein Voice Agent besteht nicht aus einem einzelnen Modellaufruf — er ist eine Kette. Jeder Schritt repräsentiert einen Anbieter, den Sie bezahlen, überwachen und der ausfallen kann. Wenn Sie die gesamte Kette hinter ein Gateway stellen, wird aus dieser Verteilung ein einzelner, kontrollierter Pfad.
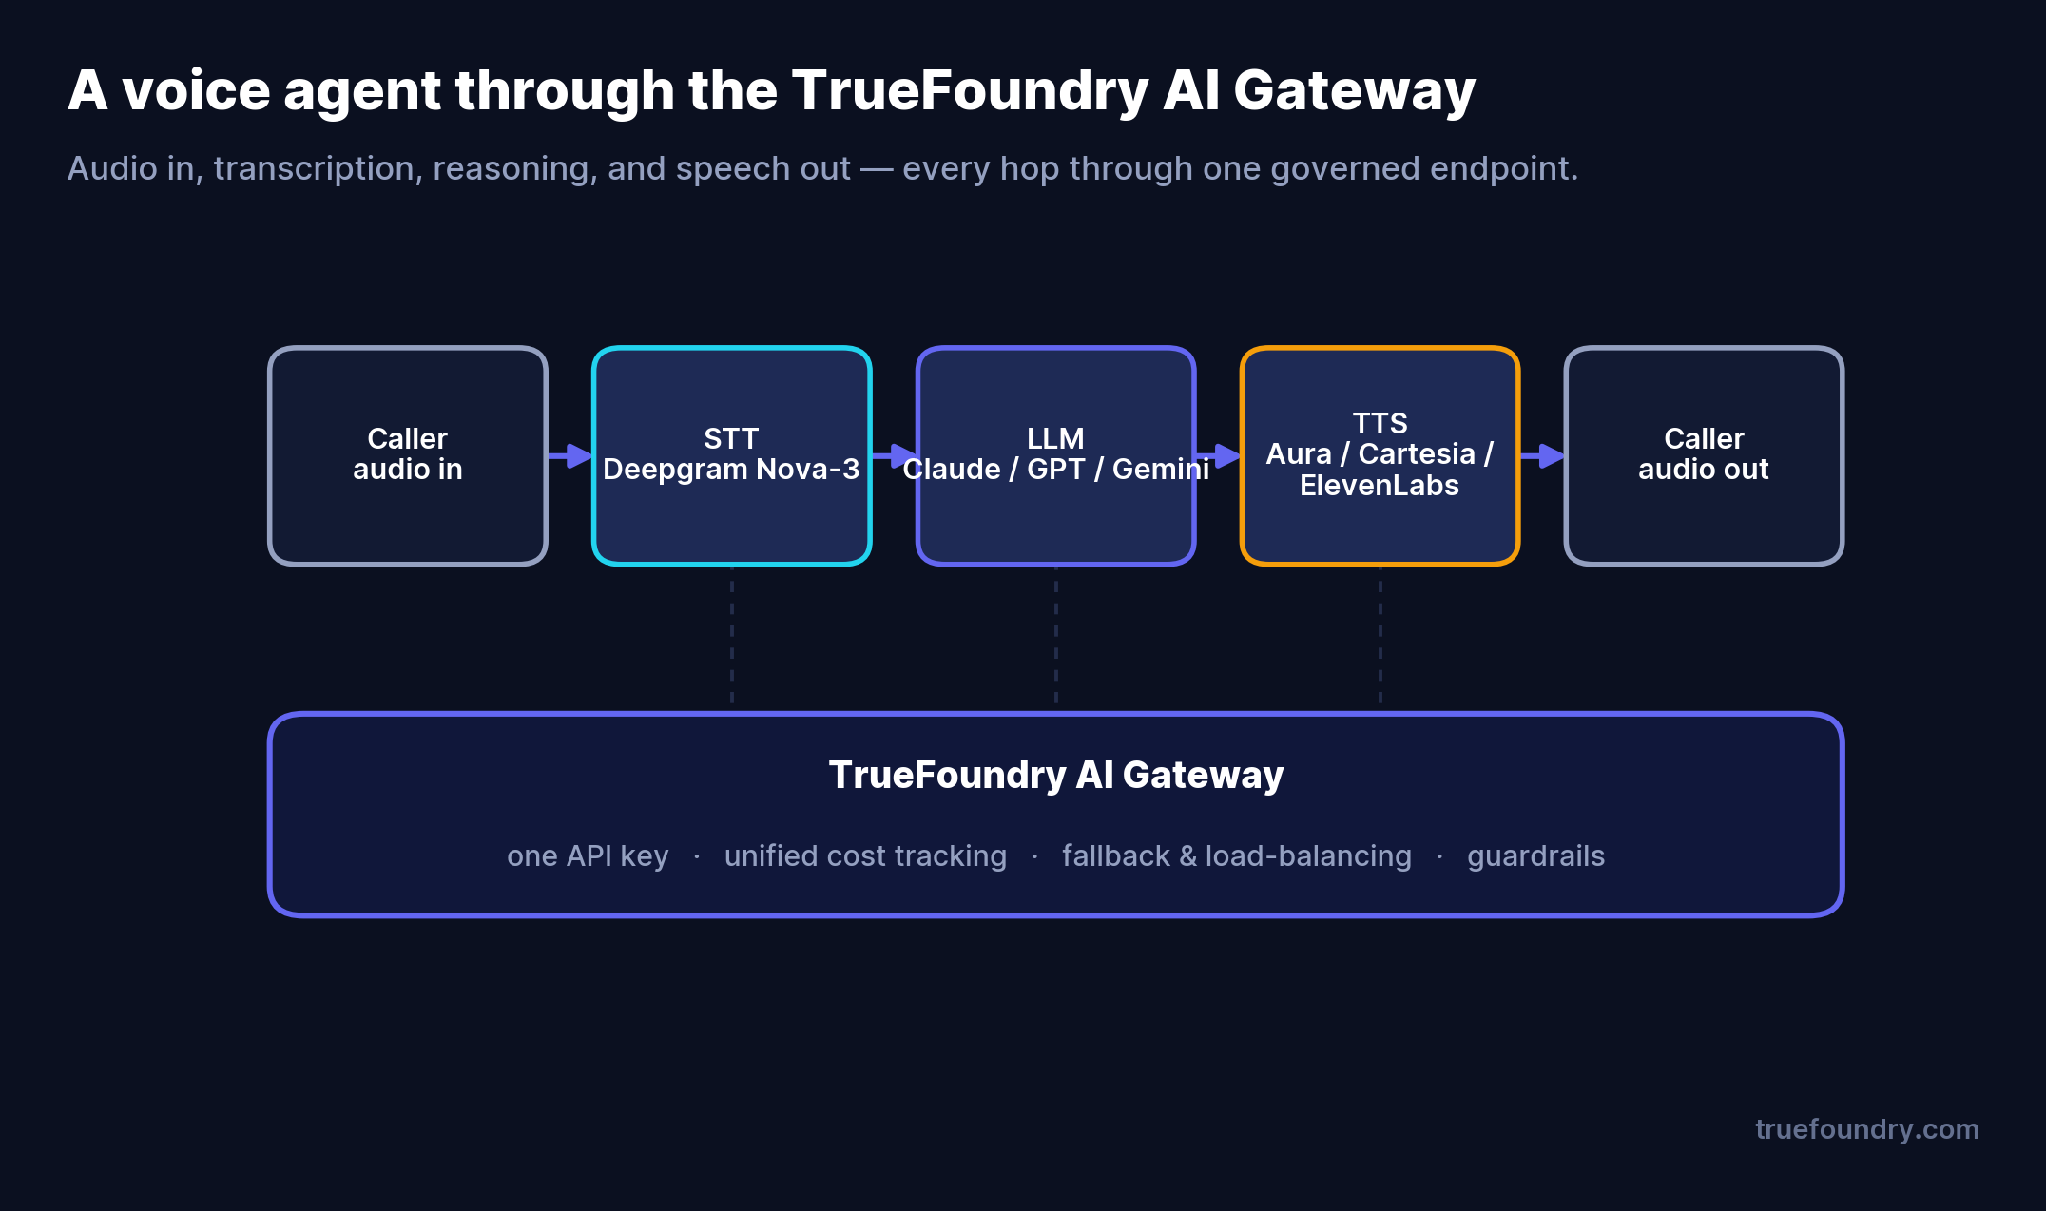
Das Routing von Deepgram über das TrueFoundry AI Gateway bietet Ihnen vier Vorteile, die Sie beim direkten Aufruf nicht erhalten:
Deepgram ist nicht der einzige Sprachanbieter, den das Gateway unterstützt, was Ausfallsicherheit und Vergleiche erst möglich macht.
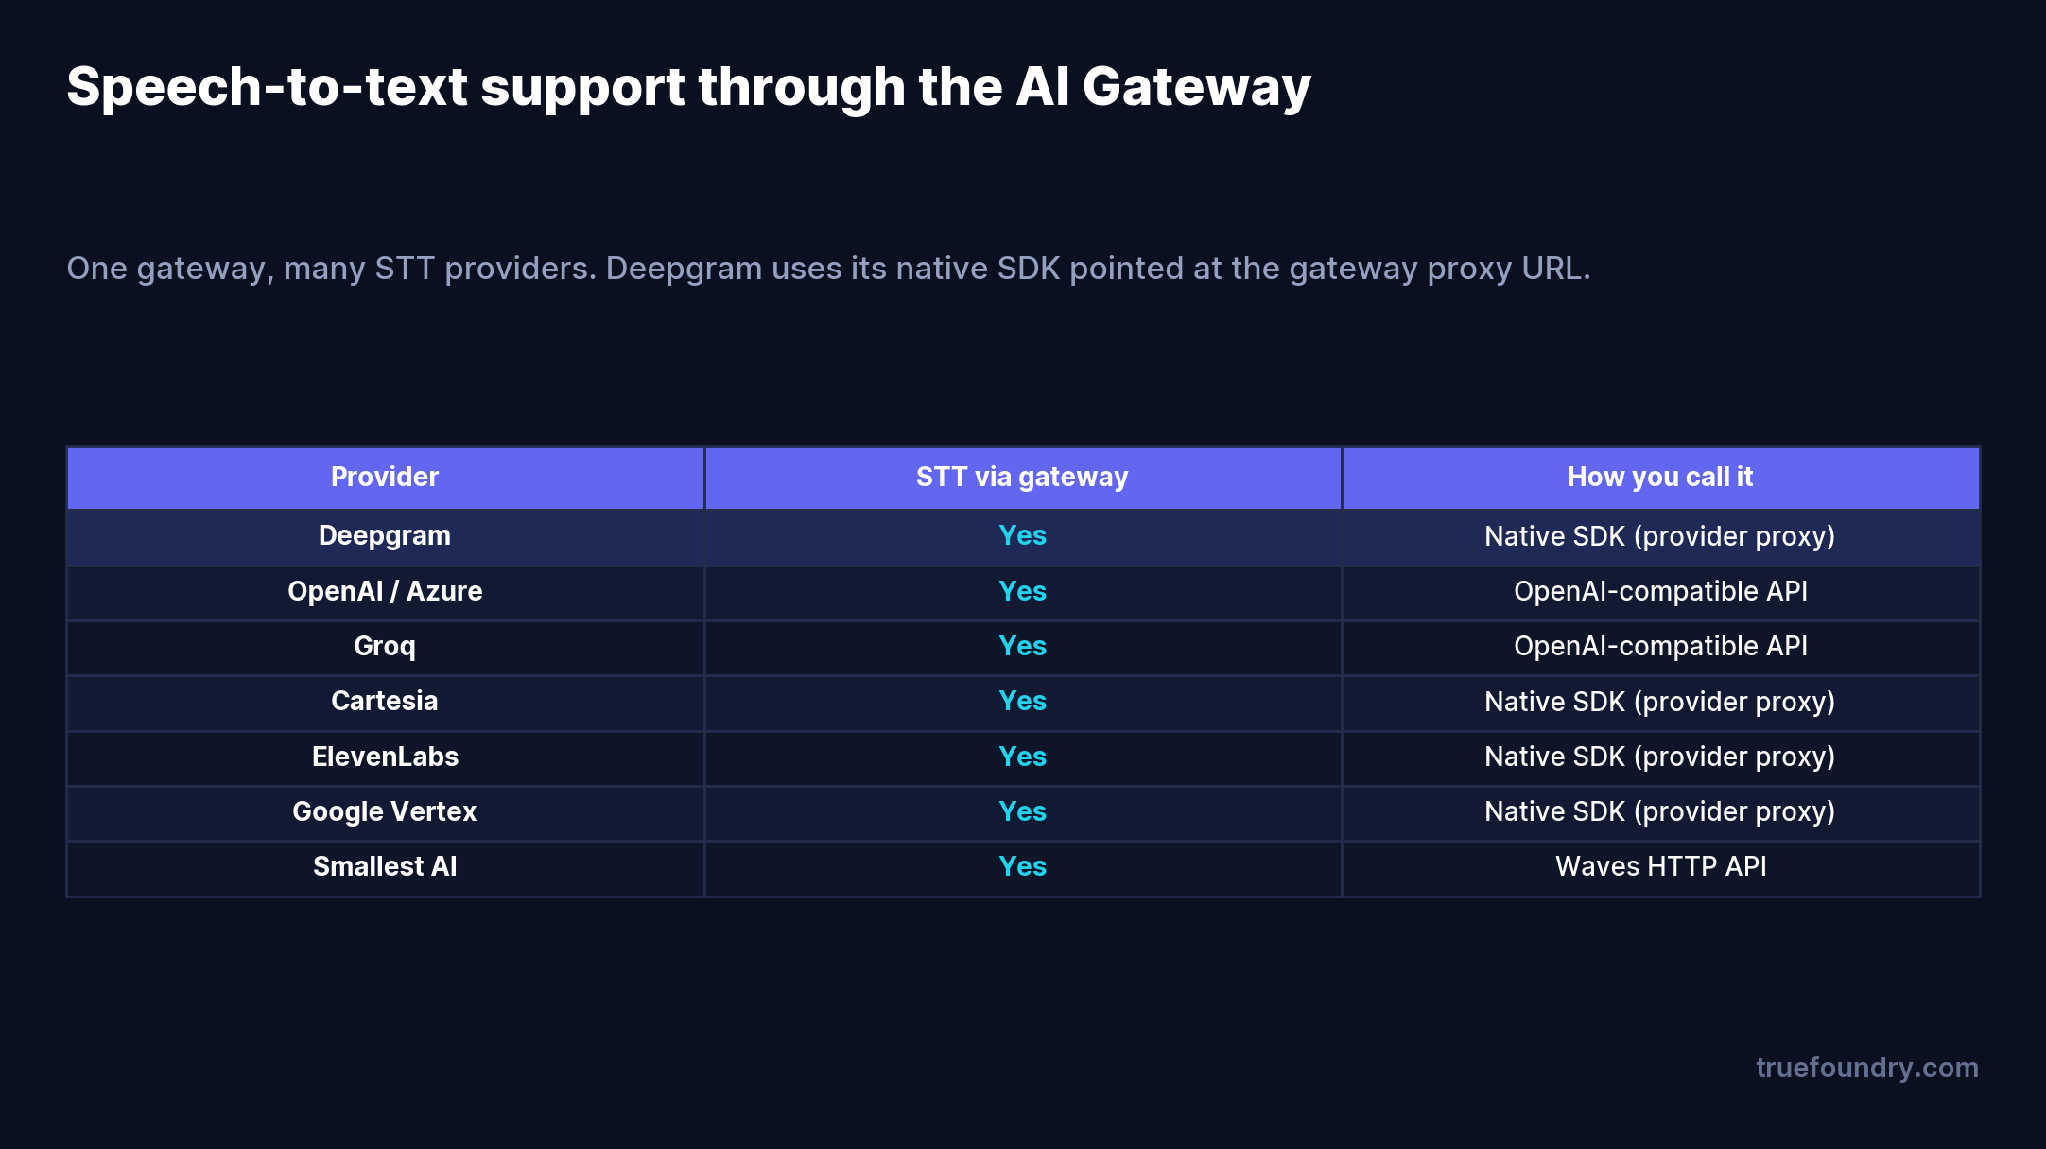
Deepgram, Cartesia, ElevenLabs, Google Vertex und Smallest AI werden über den Provider-Proxy des Gateways unter Verwendung des jeweiligen nativen SDKs aufgerufen, während OpenAI, Azure und Groq die OpenAI-kompatible API nutzen. Das bedeutet, dass Sie den exakten Funktionsumfang von Deepgram beibehalten — ohne ihn auf einen kleinsten gemeinsamen Nenner zu reduzieren — und gleichzeitig von einem einzigen Schlüssel, einer Rechnungsstellung und einer Fallback-Ebene profitieren.
Sie erfassen LLM-Kosten, vergessen aber Audio. Token-Dashboards erfassen Minuten- und Zeichenausgaben überhaupt nicht. Bei einem viel genutzten Sprachprodukt können die Transkriptions- und Sprachkosten die LLM-Rechnung erreichen — und niemand bemerkt es, bis die Finanzabteilung nachfragt.
Sie hardcoden den Deepgram-Schlüssel in jedem Dienst. Wenn jeder Sprachdienst eigene Deepgram-Zugangsdaten enthält, erfordert jede Schlüsseländerung ein Re-Deployment. Zudem gibt es keinen zentralen Ort, um die Nutzung zu begrenzen oder zuzuordnen.
Sie haben kein Fallback für die Spracheschritte. Teams bauen Fallbacks für das LLM ein, lassen STT/TTS jedoch als Single Points of Failure bestehen. Wenn Deepgram eine Störung hat, verstummt der gesamte Agent.
Sie verwechseln Streaming- und Batch-Preise. Der Betrieb eines Echtzeit-Agents unter der Annahme von Batch-Preisen unterschätzt die Kosten. Streaming ist teurer; berücksichtigen Sie das in Ihrer Planung.
Die Einrichtung umfasst drei Schritte. Gehen Sie im Dashboard zu AI Gateway → Models und wählen Sie Deepgram aus.
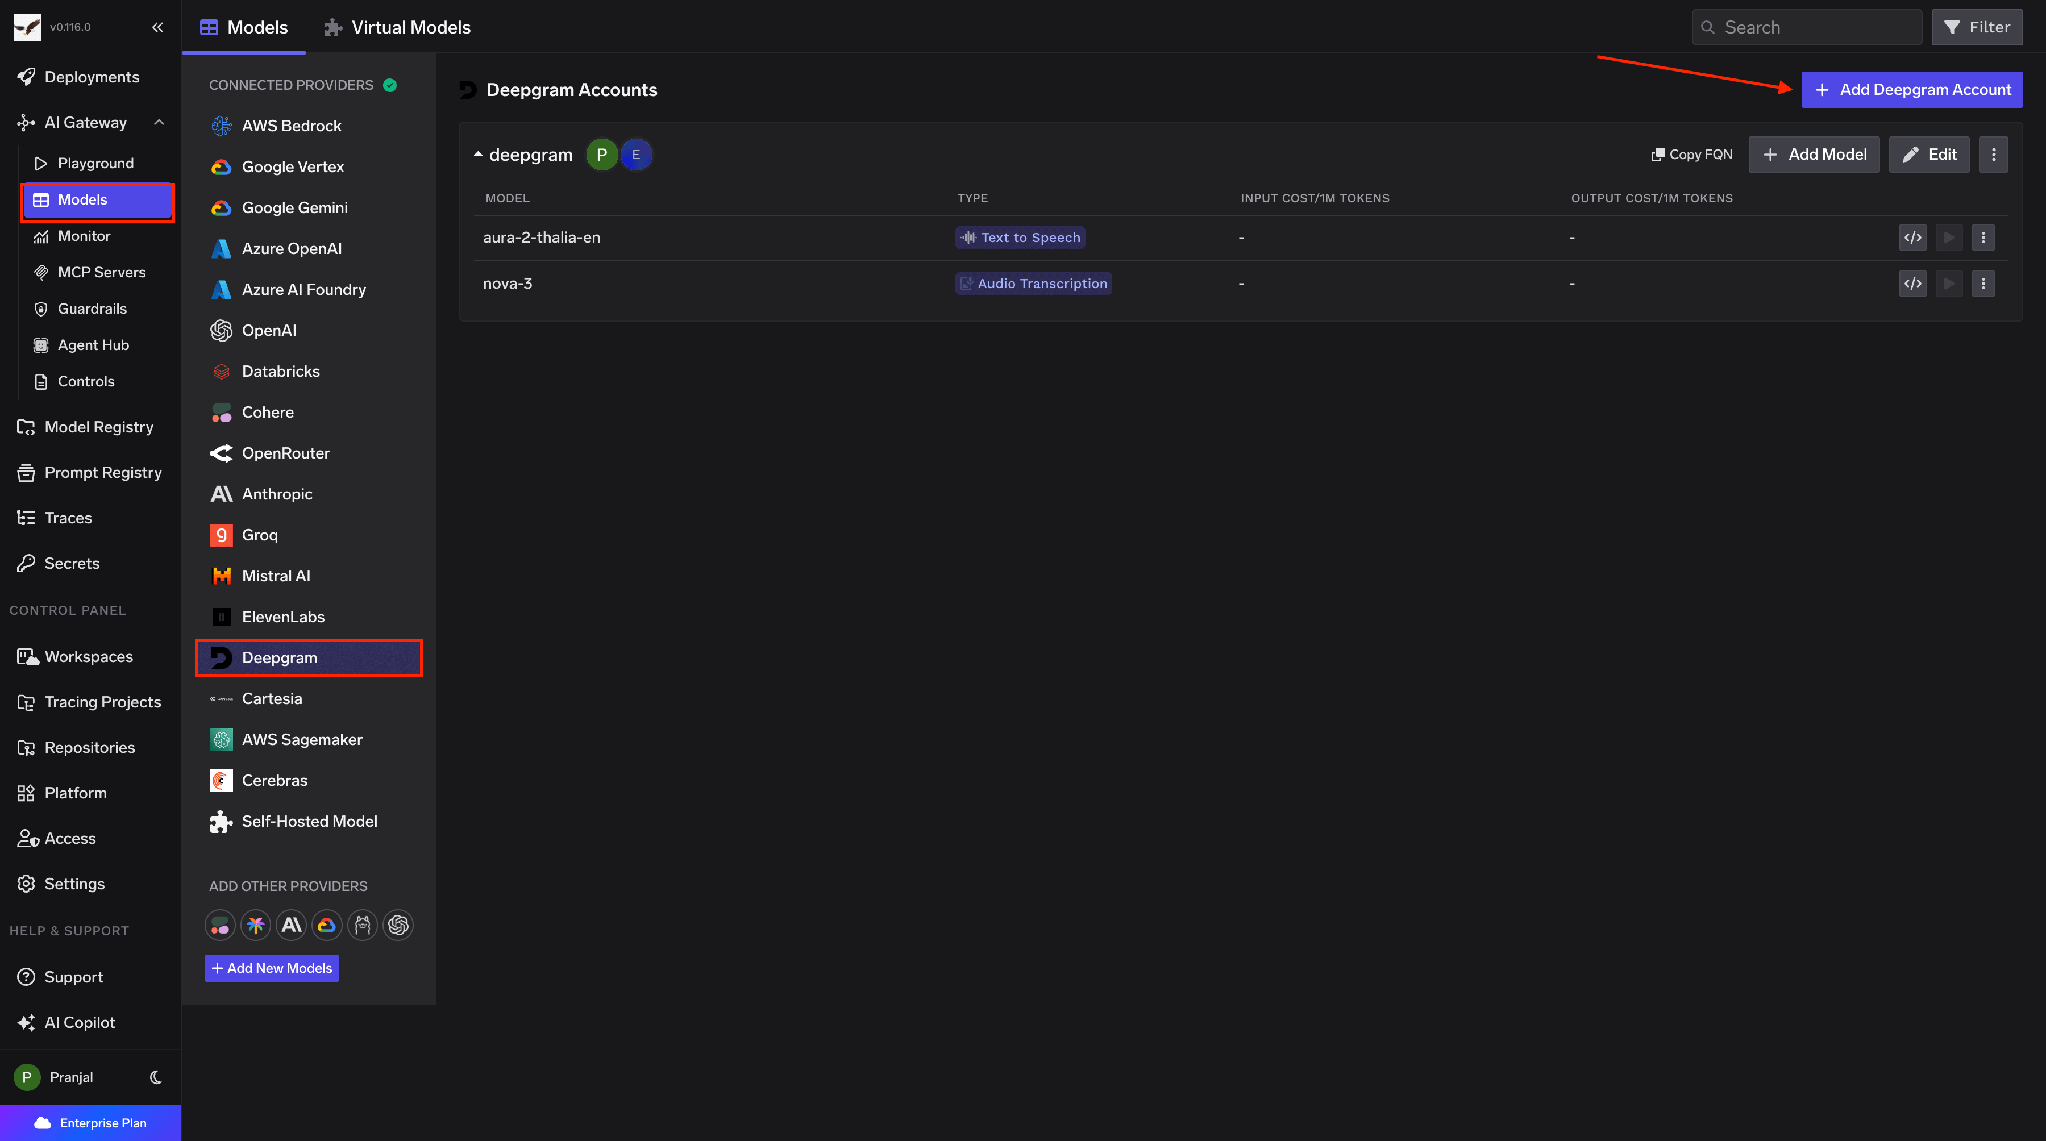
Fügen Sie Ihr Deepgram-Konto mit dem zugehörigen API-Schlüssel hinzu, benennen Sie es, legen Sie optional eine benutzerdefinierte Base-URL fest und fügen Sie Collaborators für die Zugriffskontrolle hinzu.
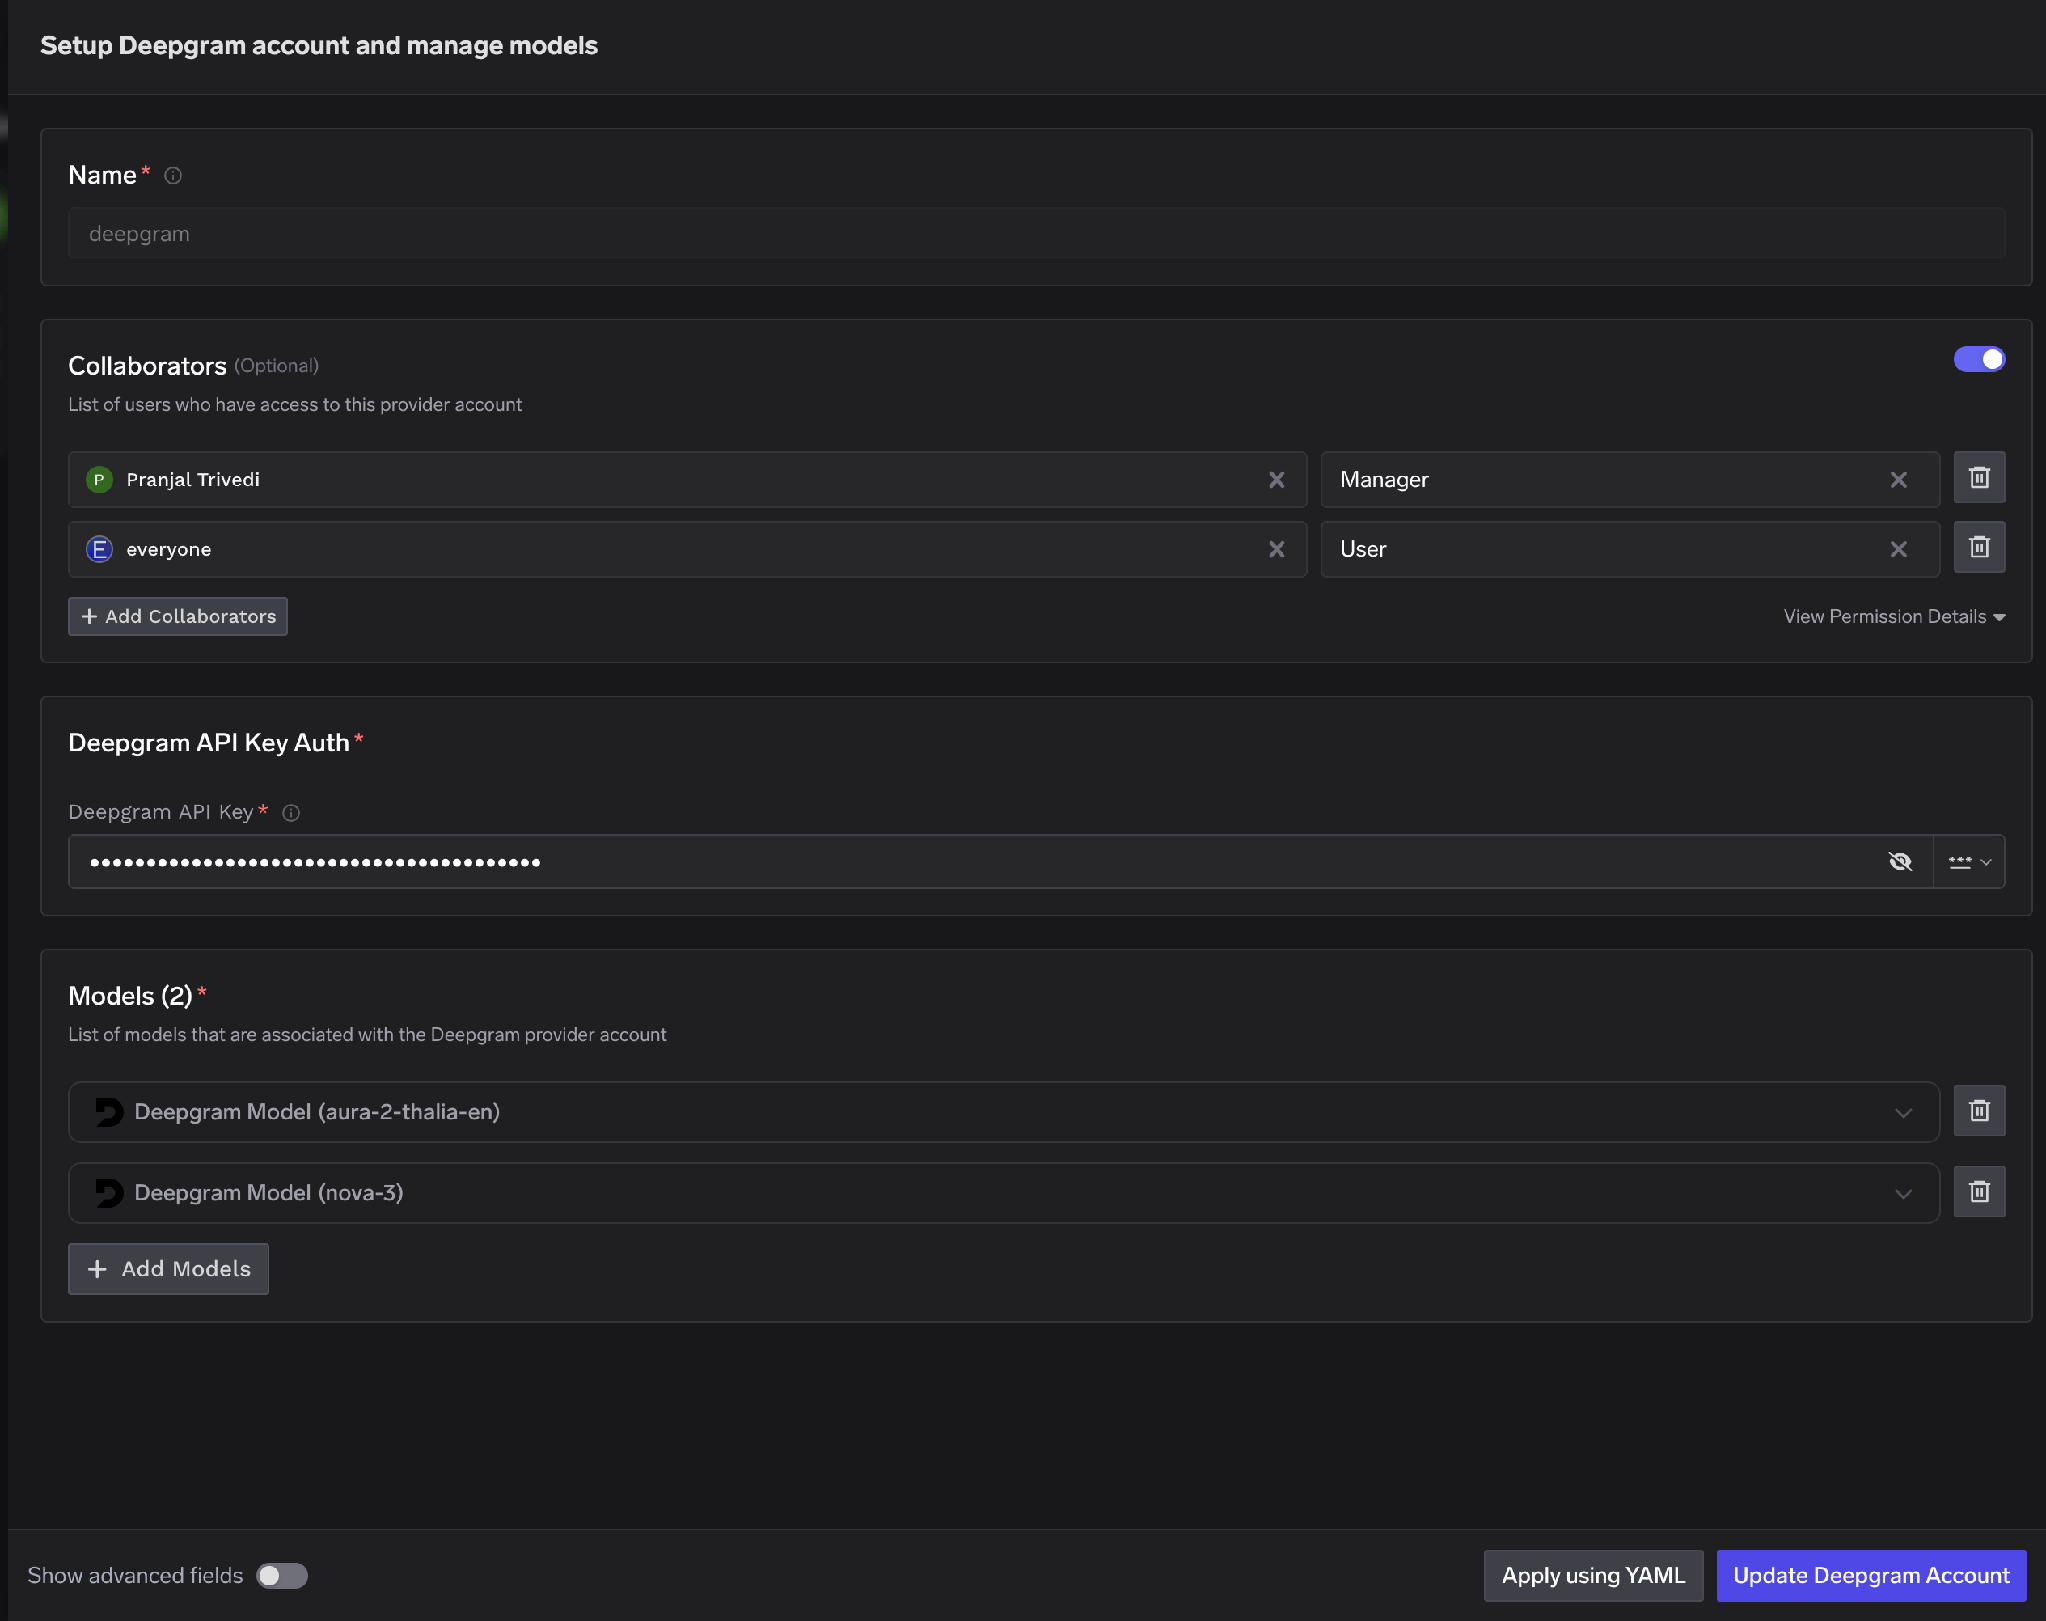
Das Deepgram-Kontoformular mit API-Schlüssel und Collaborators. Quelle: TrueFoundry-Dokumentation.
Fügen Sie dann das Modell mit seinem Display Name, seiner Model ID und seinem Model Type hinzu. Ein wichtiges Detail: Bei Deepgram müssen Model ID und Display Name identisch sein.
Sobald es hinzugefügt wurde, rufen Sie Deepgram mit seinem eigenen nativen SDK auf, das auf die Provider-Proxy-URL des Gateways verweist:
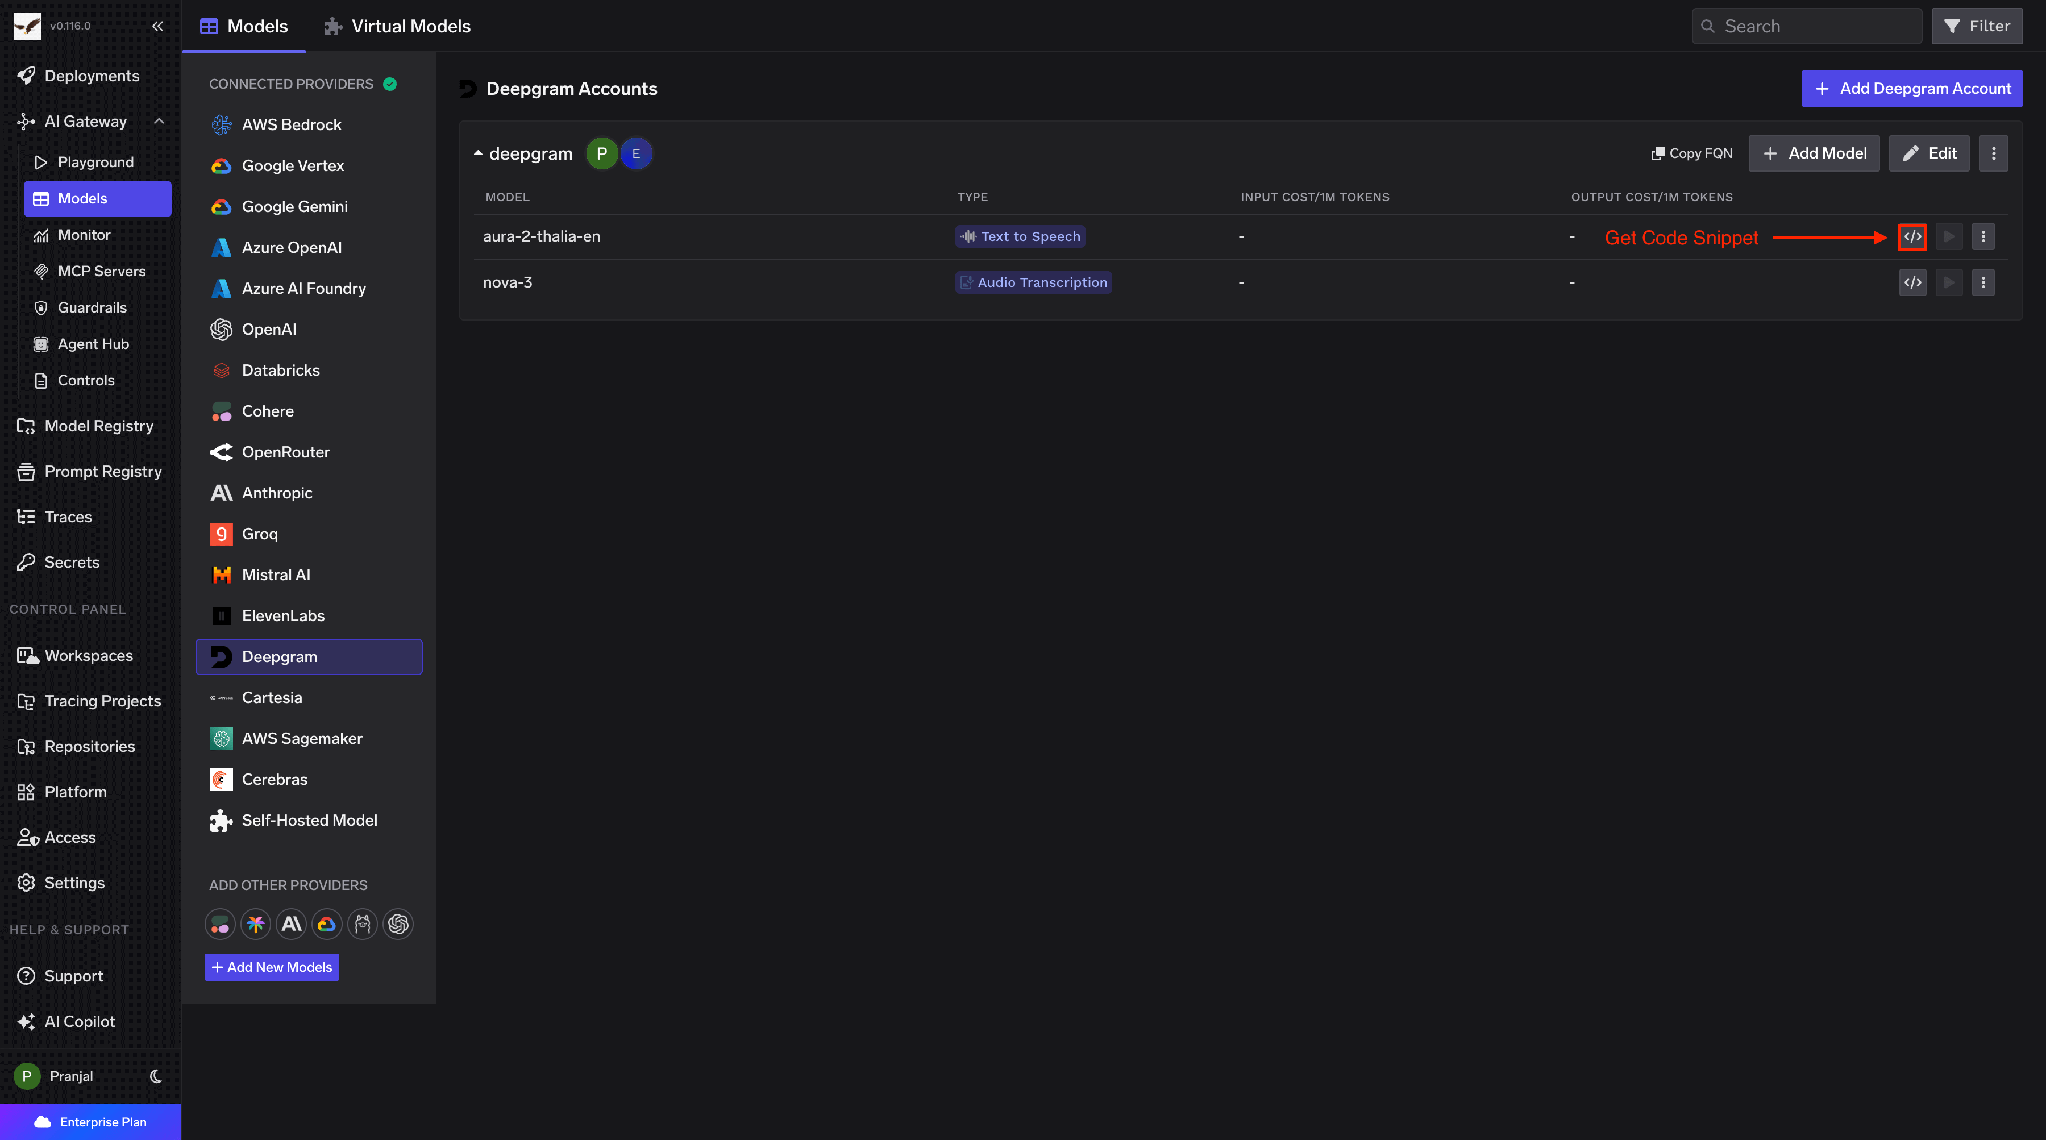
Die Anwendung verwendet einen TrueFoundry-Schlüssel (ein Platzhalter ersetzt den Deepgram-Schlüssel, der im Gateway hinterlegt ist). Sie behalten smart_format, diarize, die Sprachauswahl und alle anderen Deepgram-Parameter bei — das Gateway leitet sie unverändert weiter.
Ein Unternehmen betreibt einen Voice Agent für den Telefon-Support: 20.000 Anrufe pro Monat mit durchschnittlich 4 Minuten Streaming-Transkription und etwa 2.500 Zeichen gesprochener Antwort pro Anruf, unterbrochen von einem LLM-Schritt.
Eine ungefähre Monatsrechnung zu Pay-as-you-go-Tarifen:
Der Punkt ist: Zwei Drittel dieser Sprachrechnung entfallen auf Audio, nicht auf das LLM. Ohne Erfassung auf Gateway-Ebene stehen diese über 2.100 $ an Deepgram-Ausgaben auf einer separaten Rechnung, ohne Zuordnung zum verantwortlichen Team oder Feature. Über das Gateway wird es zu einer einzelnen Position, die Sie direkt neben den Modellkosten aufschlüsseln, begrenzen und optimieren können.
Deepgram lässt sich leicht einführen, aber auch leicht aus den Augen verlieren. Das Modell ist schnell, das SDK ist aufgeräumt und der Minutenpreis wirkt gering — bis Sie eine Vielzahl von Voice Agents betreiben, eine unvollständige Deepgram-Rechnung vorliegt und kein Fallback vorhanden ist, wenn die Transkription eine Störung aufweist.
Das Routing von Deepgram über das TrueFoundry AI Gateway schließt diese Lücke, ohne Kompromisse einzugehen: natives SDK, voller Funktionsumfang plus ein zentraler Schlüssel, einheitliches Kostentracking für Audio und LLM, Zugriffskontrollen und anbieterübergreifende Fallbacks. Ihr Sprach-Stack wird so zu einem einzelnen, kontrollierten Pfad statt zu drei separaten Baustellen.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.




Deepgram provides speech-to-text (Nova-3) and text-to-speech (Aura) for real-time and pre-recorded audio. It is commonly used for voice agents, call transcription, meeting notes, and IVR, where low latency and accuracy matter.
Pay-as-you-go, Nova-3 transcription is about $0.0043 per minute pre-recorded and $0.0077 per minute streaming; Aura-2 text-to-speech is $0.030 per 1,000 characters (Aura-1 is $0.015). Audio is billed per minute and per character, not per token.
Yes. Add Deepgram as a model account, then call it with Deepgram’s native SDK pointed at the gateway’s provider-proxy URL. You keep Deepgram’s full feature set while gaining one key, unified cost tracking, and fallback.
Yes. The gateway meters STT per minute of audio and TTS per character, and shows that spend alongside LLM cost, attributed by model, team, user, and request.
Yes. Create a virtual model with the Audio Transcription type spanning multiple providers; the gateway load-balances and fails over across them without a code change.
Yes. TrueFoundry’s data plane runs in your VPC or on-prem, so audio and usage data stay in your environment.



Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet