August 27, 2025
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Published: October 7, 202615
Blazingly fast way to build, track and deploy your models!
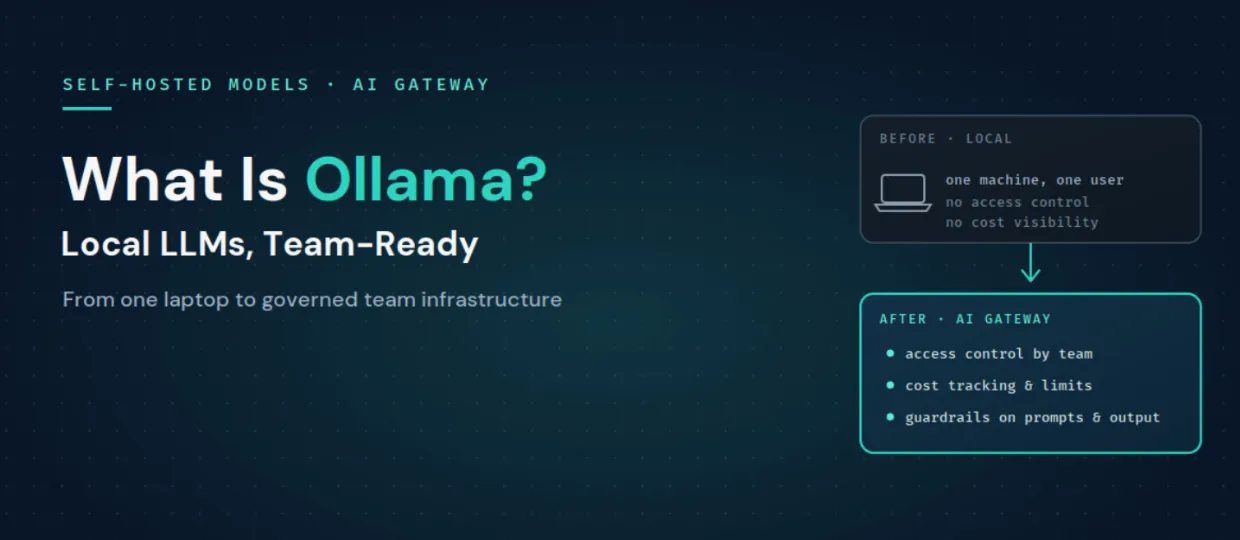
O Ollama é um runtime de código aberto para executar LLMs em sua própria infraestrutura, seja um laptop, um servidor GPU local ou uma instância de nuvem privada. Você baixa um modelo de pesos abertos, como Llama, Mistral ou Qwen, e o Ollama o disponibiliza localmente por trás de um endpoint HTTP. Fundamentalmente, esse endpoint utiliza uma API compatível com OpenAI, portanto, o código escrito para o SDK da OpenAI pode se comunicar com um modelo local do Ollama apenas alterando a URL base.
As equipes escolhem o Ollama por alguns motivos claros:
A comparação mais comum é entre Ollama e vLLM, pois ambos expõem APIs compatíveis com OpenAI e ambos permitem a auto-hospedagem de modelos de pesos abertos. Eles são otimizados para propósitos diferentes.
Em resumo, o Ollama é a maneira mais fácil de executar um modelo para uma única pessoa, enquanto o vLLM foi criado para atender muitos usuários simultâneos com alto rendimento. Muitas equipes usam ambos: o Ollama para desenvolvimento local e o vLLM para produção. A boa notícia é que, como ambos são compatíveis com a OpenAI, qualquer solução que você padronizar pode ficar atrás do mesmo gateway, e você pode até mesmo rotear o tráfego entre eles.
O Ollama faz bem o seu trabalho, mas executá-lo em uma organização revela lacunas que estão fora do seu escopo.
Essas são exatamente as preocupações que um gateway existe para resolver, sendo essa a forma de transformar um executor de modelos local em infraestrutura de equipe.
O TrueFoundry trata um servidor Ollama como um modelo auto-hospedado. Você o conecta ao Gateway de IA fornecendo a URL do endpoint e os detalhes de autenticação. Uma vez registrado, ele aparece no catálogo de modelos do gateway ao lado de provedores de nuvem, com todos os recursos do gateway aplicados: roteamento, mecanismos de proteção, limitação de taxa, rastreamento de custos e observabilidade. O Ollama é explicitamente suportado aqui porque expõe uma API compatível com a OpenAI, o formato com o qual o gateway funciona melhor.
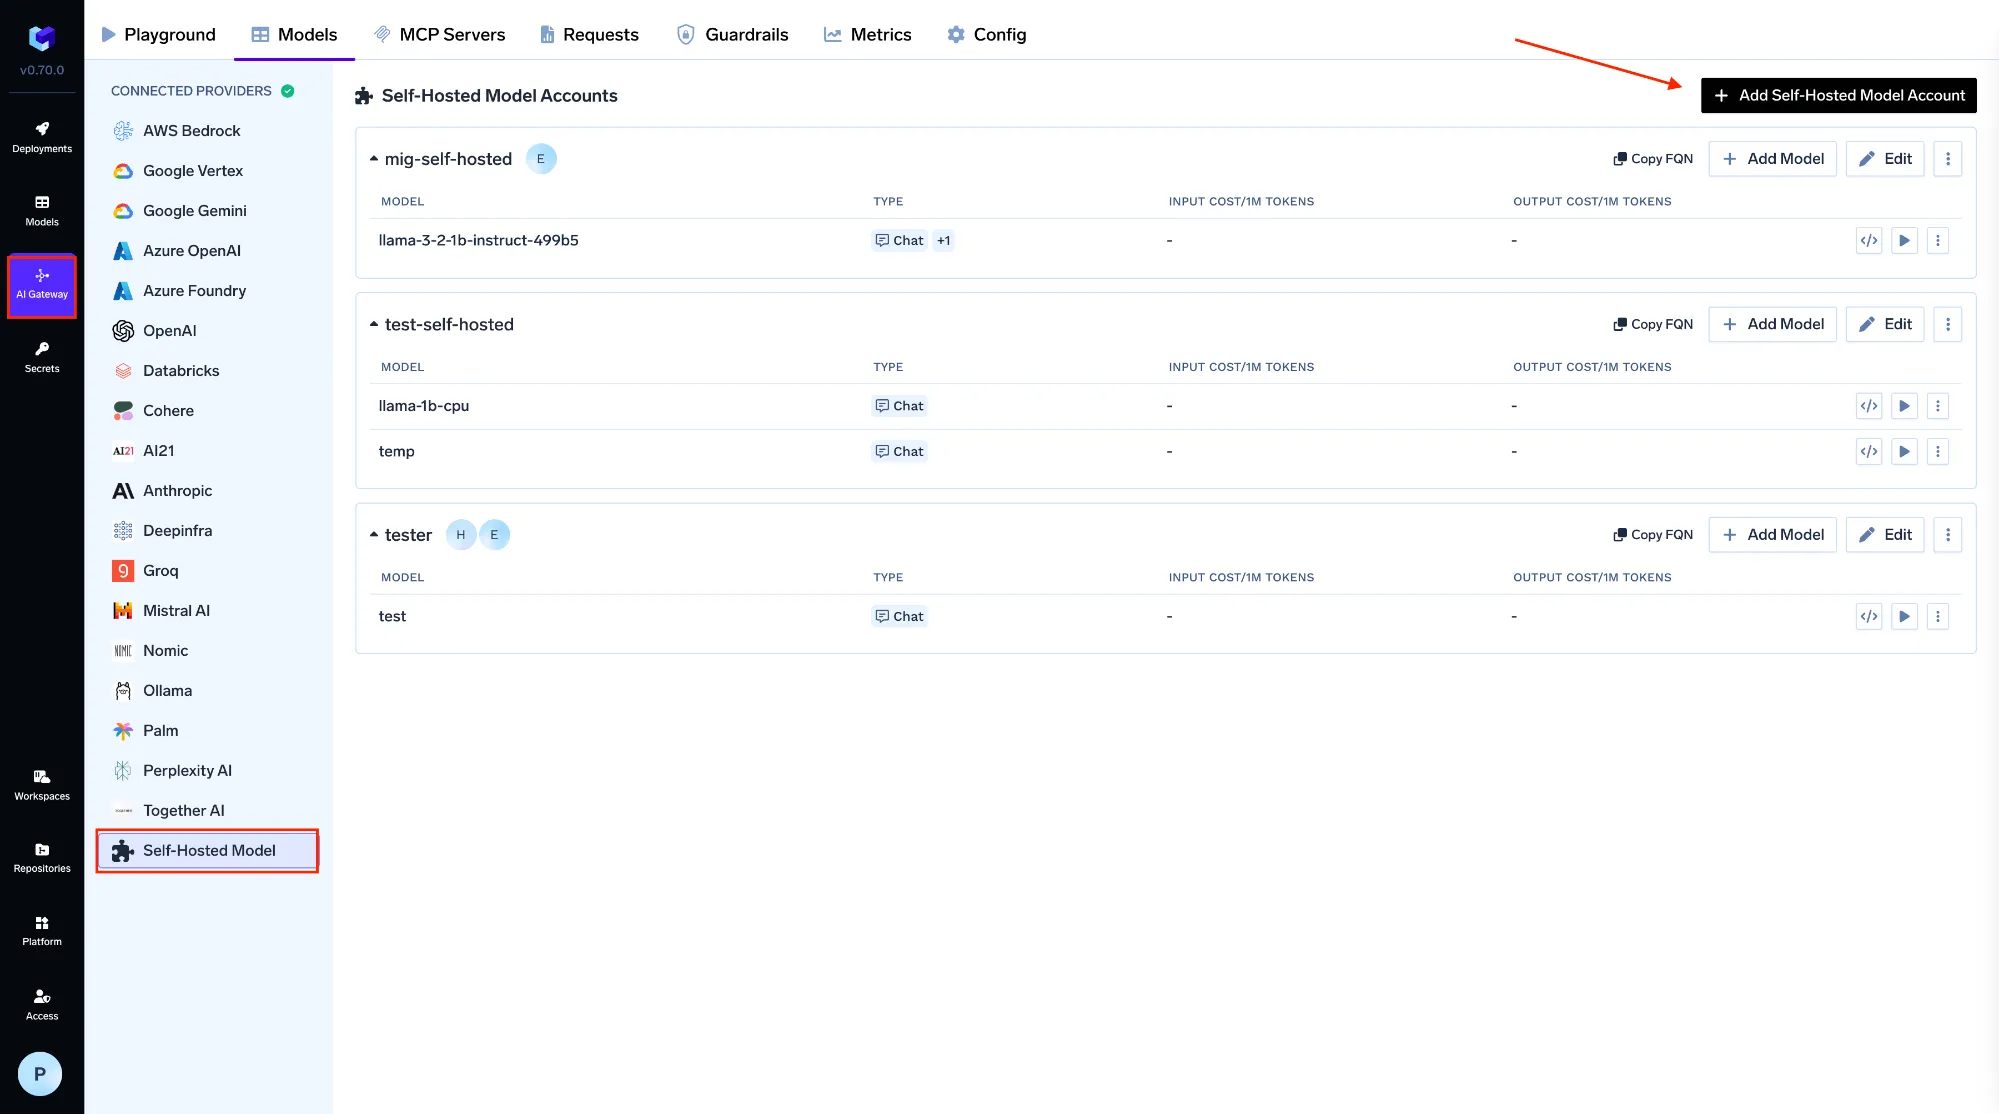
Você registra o modelo em AI Gateway, depois em Models e, em seguida, em Self Hosted Models, atribuindo um nome, um ID de modelo, a URL do seu servidor Ollama e o tipo de servidor de modelo, com autenticação opcional. A partir desse momento, aplicações e agentes param de se comunicar com um endpoint localhost bruto e passam a chamar o gateway com uma API unificada:
from openai import OpenAI

client = OpenAI(
    api_key="your-truefoundry-api-key",   # a gateway token, not a raw endpoint
    base_url="https://gateway.truefoundry.ai",
)

resp = client.chat.completions.create(
    model="self-hosted/llama-3-8b-ollama",   # your registered Ollama model
    messages=[{"role": "user", "content": "Summarize this ticket"}],
)
Essa única mudança é o que torna o Ollama utilizável por uma equipe:
Como o gateway é independente de provedor e compatível com OpenAI em mais de 1.000 modelos, você também pode combinar um modelo Ollama local com uma implementação vLLM e APIs em nuvem sob a mesma interface, o que se conecta diretamente à portabilidade de agentes de IA. E como o TrueFoundry é executado dentro da sua própria VPC, a privacidade que o levou a escolher o Ollama em primeiro lugar é preservada de ponta a ponta.
O Ollama é a maneira mais rápida de colocar um modelo em execução localmente e, em termos de privacidade e custo, é difícil de superar. Ele simplesmente não foi criado para ser uma infraestrutura de equipe, que é onde entram o controle de acesso, a visibilidade de custos, as diretrizes de segurança e o roteamento. Conecte o Ollama ao AI Gateway como um modelo auto-hospedado e ele manterá sua privacidade e baixo custo, ganhando tudo o que uma equipe precisa para operá-lo em produção.
Veja como o TrueFoundry transforma modelos locais em uma infraestrutura governada e pronta para equipes. Agende uma demonstraçãooucomeçar gratuitamente.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.


O Ollama é uma ferramenta de código aberto que executa grandes modelos de linguagem localmente, no seu próprio hardware, e os disponibiliza por trás de uma API HTTP simples e compatível com a OpenAI. As equipes o usam para inferência privada, offline e de baixo custo com modelos de pesos abertos, como Llama, Mistral e Qwen.
O Ollama é otimizado para inferência local simples em uma única máquina, enquanto o vLLM foi criado para servir em produção com alta vazão e alta concorrência. Ambos expõem APIs compatíveis com a OpenAI, então muitas equipes usam o Ollama no desenvolvimento e o vLLM em produção, e colocam os dois atrás do mesmo gateway.
O modelo é executado em uma infraestrutura que você controla, o que é bom para a privacidade, mas um endpoint do Ollama sem nada à frente não tem controle de acesso, atribuição de custos nem guardrails de conteúdo. Para usá-lo com segurança em uma equipe, coloque-o atrás de um gateway que adicione autenticação, RBAC, limites de taxa e inspeção de PII e de segredos.
Conecte o servidor do Ollama a um AI Gateway como um modelo auto-hospedado, informando uma URL e a autenticação. Os aplicativos passam a chamar a API unificada do gateway em vez de um endpoint direto, o que acrescenta ao Ollama controle de acesso compartilhado, acompanhamento de custos, guardrails e roteamento.
Any LLM, embedding, or custom model via high-performance backends like vLLM, TGI, and Triton, all deployable in the same control plane as the gateway.
Sim. O TrueFoundry é executado na sua VPC, on-prem, em ambiente air-gapped ou híbrido, de modo que a inferência local e privada que o Ollama oferece continua privada em toda a pilha.



As últimas notícias, artigos e recursos enviados para sua caixa de entrada