


novembro 21, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Blazingly fast way to build, track and deploy your models!
A requisição 51 falha.
Você verifica a página do modelo e ela ainda diz gratuito. Você verifica seu saldo e há dinheiro nele. Você verifica a documentação e encontra um limite de 20 requisições por minuto, do qual você estava longe, pois estava fazendo cerca de três.
O que você atingiu foi o limite diário. E a altura desse limite depende de algo a que nenhum outro gateway pensaria em vinculá-lo: quanto dinheiro você já deu ao OpenRouter na história da sua conta. Com menos de 10 créditos comprados ao longo da vida da sua conta, os modelos gratuitos oferecem 50 requisições por dia. Com 10 ou mais, você recebe 1.000. O upgrade é permanente, então você pode gastar tudo, voltar a um saldo zero e manter o teto mais alto.
Essa é a coisa mais útil de se saber sobre os limites de taxa do OpenRouter, e não é a única surpresa. Passamos duas semanas testando a plataforma intensamente para uma avaliação de gateway. Aqui está o que descobrimos, incluindo algumas coisas que a documentação não diz.
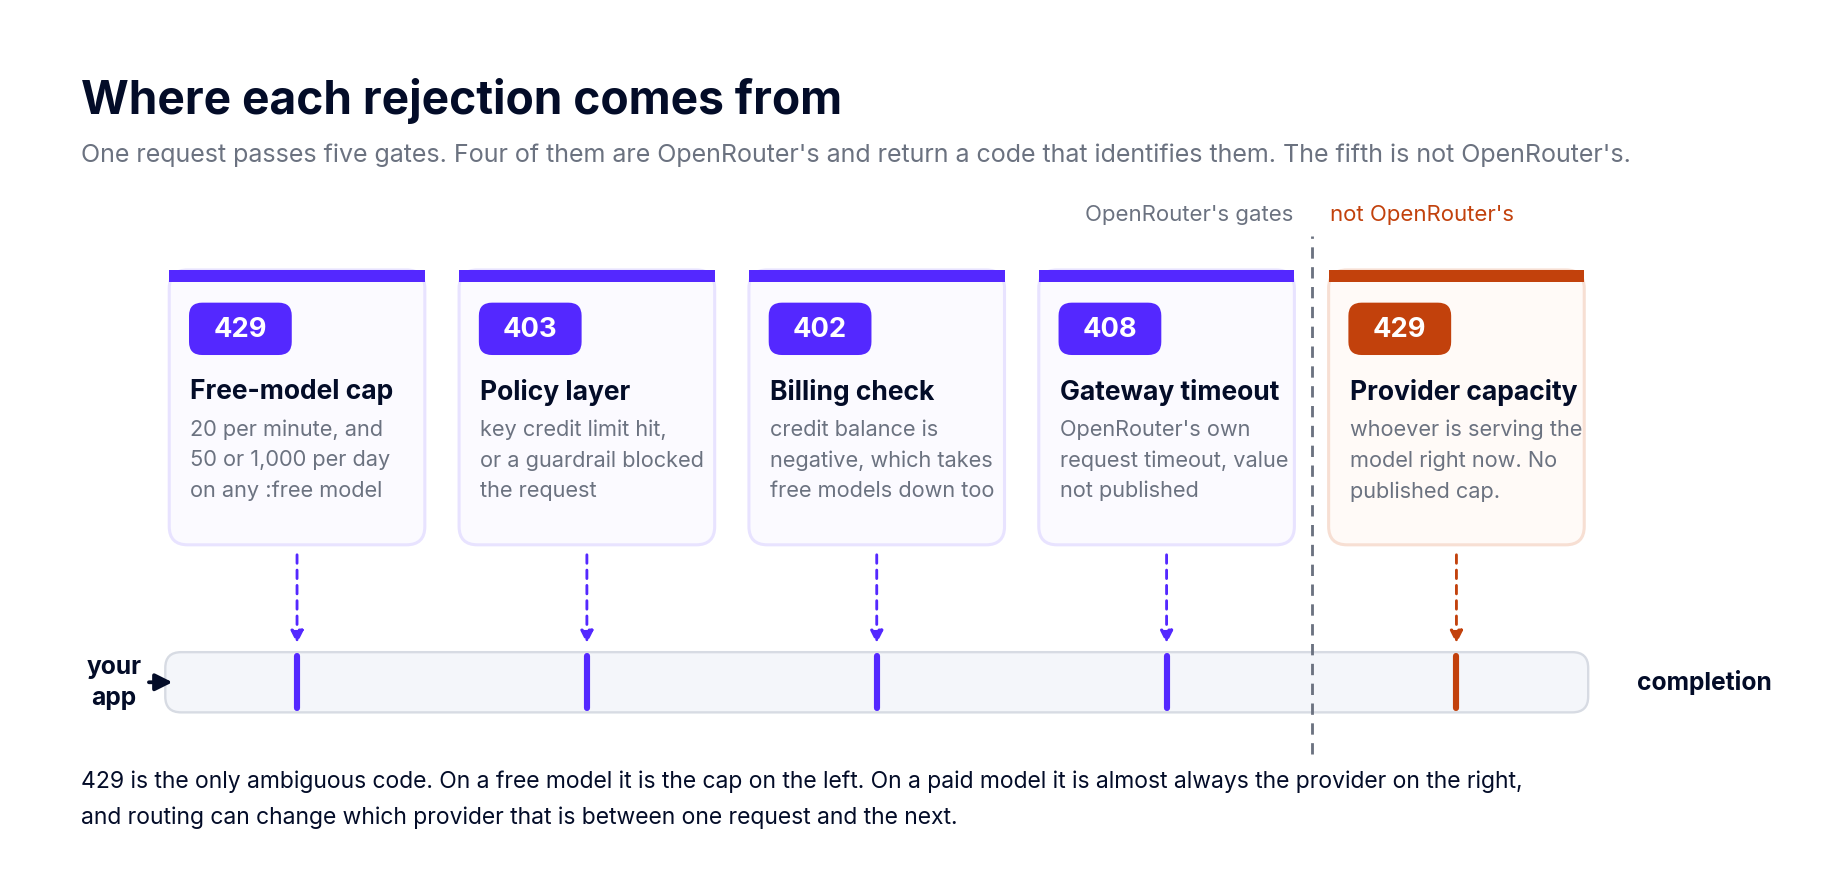
Quatro mecanismos separados podem rejeitar sua requisição, e eles são fáceis de confundir entre si.
O primeiro é o limite para modelos gratuitos: 20 por minuto, 50 ou 1.000 por dia, aplicado a qualquer ID de modelo terminado em :free. Esse é publicado e previsível. O segundo é a capacidade de qualquer provedor que esteja realmente servindo sua requisição paga, a qual o OpenRouter não publica e não pode realmente controlar. O terceiro é a proteção DDoS da Cloudflare, descrita em seus documentos apenas como o bloqueio de requisições que excedam dramaticamente o uso razoável, sem nenhum número associado. O quarto é qualquer orçamento ou limite de crédito que você mesmo configurou, o que não é um limite de taxa propriamente dito, mas rejeita o tráfego da mesma maneira.
Apenas o primeiro deles é um limite de taxa no sentido em que você se refere quando diz limite de taxa. O restante é a capacidade de outra pessoa, uma rede de segurança bruta e a sua própria contabilidade.
O limite de 20 por minuto é fixo. Ele não muda com o status da sua conta, seu saldo ou seus gastos. Se você precisa de mais de 20 requisições por minuto, modelos gratuitos não são a solução e nenhuma quantia em dinheiro muda isso.
O limite diário é aquele vinculado ao histórico de pagamento, e o limite mínimo baseia-se em compras acumuladas ao longo da vida da conta, e não no saldo atual. A compra mínima de crédito no OpenRouter é de $5, portanto $10 é um segundo passo deliberado, não o preço de entrada. Comprar em dois blocos de $5 leva você ao mesmo lugar que uma única compra de $10, até onde pudemos verificar.
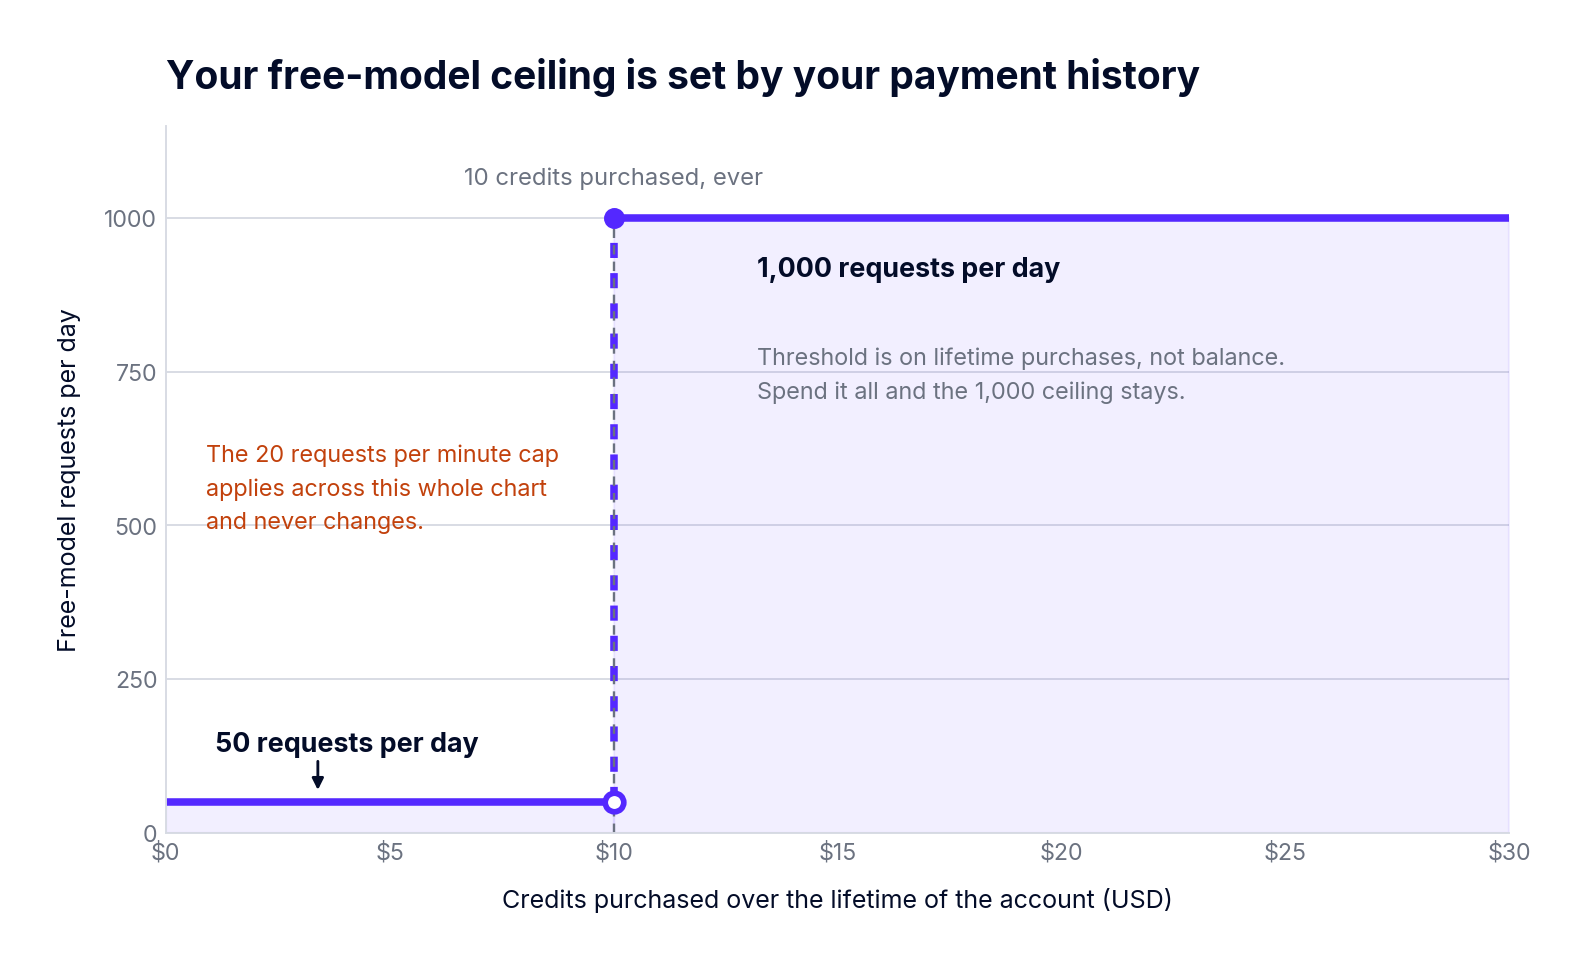
O que torna isso estranho é a direção da causalidade. O seu teto de vazão não é uma função do seu plano ou do seu padrão de tráfego. É uma função de uma decisão de aquisição, o que significa que uma questão financeira agora responde a uma questão de disponibilidade. Em um projeto pessoal, tudo bem. Mas quando você tem usuários, está a um atraso contábil de distância de uma mudança de capacidade.
Existe uma segunda armadilha por baixo disso: requisições com falha ainda podem contar para a cota diária. Um loop de repetição (retry loop) bombardeando um modelo gratuito ocupado pode consumir suas 50 requisições sem retornar uma única conclusão aproveitável. Se você for fazer tentativas de repetição, limite os privilégios.
Seus limites reais vivem em uma única chamada de API
O painel de controle (dashboard) não mostrará um contador de limite. O endpoint GET /api/v1/key mostrará, e ele retorna exatamente o que o OpenRouter está aplicando para essa chave no momento.
Duas coisas a notar. Primeiro, is_free_tier é a mecânica do histórico de pagamento novamente, agora como um booleano que a sua lógica de throughput precisa ler. Segundo, e esta é a parte que confunde as pessoas, a resposta ainda carrega um objeto rate_limit que a própria documentação do OpenRouter agora marca como obsoleto (deprecated) e manda você ignorar.
Muitos guias de terceiros e habilidades de codificação de AI não se atualizaram. Você encontrará tabelas de limites de taxa citando 20 requisições por 10 segundos para contas sem fundos e 200 por 10 segundos para contas financiadas, tudo derivado desse campo descontinuado. Esses números não descrevem nada que a plataforma aplique hoje. Se um dashboard, uma regra de alerta ou uma biblioteca de cliente sua lê rate_limit, está lendo um valor que ninguém mantém.
O OpenRouter não publica nenhum limite de requisição de plataforma para modelos pagos, e fomos procurar um. Um teste de concorrência no tráfego faturado por crédito a 1, 4, 8 e 16 requisições em andamento produziu zero rejeições em todos os níveis. Nenhum 429, sem descarte, sem filas. O tempo médio para o primeiro token quase não mudou entre uma requisição em andamento e dezesseis.
Não encontramos o teto. O teste parou em 16 e rodou contra modelos servidos pela OpenAI, portanto considere isso um piso e não uma figura definitiva: o gateway não nos desacelerou abaixo de 16 concorrentes, e onde isso começa ainda é uma questão em aberto.
O que significa que um 429 em um modelo pago geralmente não é o OpenRouter pedindo para você desacelerar. É o provedor que está servindo aquela string de modelo no momento. E como o roteamento pode mover você entre hosts sem que a string do modelo mude, a capacidade com a qual você está trabalhando pode mudar entre uma requisição e a próxima. Você pode torná-la previsível fixando com provider.order ou provider.only, ao custo do failover que você presumivelmente adotou ao usar um roteador.
Nada na documentação do OpenRouter reúne isso em um só lugar, e o código é a maneira mais rápida de saber qual camada acabou de rejeitar você.
O 402 pega as pessoas de surpresa, porque significa que "gratuito" é condicional a não estar no vermelho. Fique negativo e os modelos gratuitos param de funcionar também.
Mantenha o 403 completamente fora do seu fluxo de tentativas (retry path). Tentar novamente não alcança nada, já que o que está bloqueando você é uma política e não uma fila. Atingimos um limite de chave esgotado durante os testes e recebemos um 403 limpo com a mensagem "Key limit exceeded (total limit)" com um link direto para a página de configurações dessa chave. Dando o crédito a quem merece: os erros do OpenRouter para suas próprias decisões são excelentes. Os erros retransmitidos dos provedores são o que quer que o provedor tenha tido vontade de dizer, e ambos chegam sob a mesma mensagem de nível superior, portanto o código de status é seu único sinal confiável de em qual mundo você está.
Esta é a parte que nos custou mais tempo. Tentativas de repetição (retries), backoff e jitter não são configuráveis. Enviamos max_retries e um objeto estruturado de política de retry, e ambos retornaram HTTP 200 sem erro, o que significa aceito e ignorado em vez de honrado. A mesma história com timeout.
A causa é uma lacuna de validação. O OpenRouter verifica chaves dentro do objeto provider contra uma lista conhecida e rejeita as desconhecidas adequadamente. As chaves de nível superior não são verificadas. Portanto, uma diretiva de nível superior não suportada garante uma resposta bem-sucedida e nenhuma dica de que não fez nada, o que é uma falha pior do que um 400 seria.
Também não há timeout de inatividade de stream (stream-idle timeout), seja no servidor ou como um parâmetro do cliente. Em cerca de 4.300 requisições, tivemos duas streams que terminaram precocemente sem nenhum erro HTTP. Raro, mas seu cliente precisa perceber, porque nada mais avisará.
Tudo isso coloca o ritmo, as retentativas e os timeouts na sua aplicação. O blog de engenharia do OpenRouter diz o mesmo, e preferimos que eles digam isso do que finjam o contrário. No entanto, isso significa que se você executa vários serviços, está escrevendo essa lógica várias vezes.
As equipes colapsam isso em uma única ideia e depois se perguntam por que nenhum dos dois disparou quando esperado. Limites de taxa protegem a capacidade dentro de uma janela de tempo. Orçamentos protegem o dinheiro ao longo de um período. No OpenRouter, eles são recursos separados que retornam códigos de status diferentes.
Os limites de crédito das chaves são redefinidos diariamente, semanalmente ou mensalmente à meia-noite UTC, com as semanas indo de segunda a domingo. Deixe o reset sem definir e você terá um teto vitalício. a âncora não é configurável, portanto, se o seu mês fiscal começa no dia 25, ou se sua equipe trabalha em IST, seus resets não alinharão com seus relatórios.
Orçamentos de segurança se aninham em janelas vitalícias, mensais, semanais e diárias, e os limites precisam diminuir estritamente à medida que a janela diminui. Eles também não se somam em grupo (pool), o que surpreende as pessoas: dê a três engenheiros a mesma regra de orçamento diário e cada um terá esse orçamento separadamente, enquanto uma única requisição conta tanto para o orçamento da chave quanto para o orçamento de quem possui a chave. Os gastos com BYOK permanecem invisíveis para os orçamentos, a menos que include_byok_in_budgets seja ativado, o que é um padrão defensável para faturamento e ruim para governança.
A aplicação é um bloqueio rígido e não um aviso. Nenhum modo apenas de aviso é documentado, portanto o primeiro sinal de que um orçamento existe é o tráfego falhando. O lado de taxas de tudo isso fica fora deste artigo, mas nosso detalhamento de preços do OpenRouter cobre a taxa de compra de crédito de 5,5% e a cota BYOK em detalhes.
O limite diário gratuito conta requisições, não tokens. Uma conversa de 100.000 tokens e um prompt de duas palavras custam exatamente o mesmo a você: um. Isso parece generoso até você executar um loop de ferramenta, onde uma tarefa pode fazer vinte chamadas e o teto de requisições limita muito antes que qualquer coisa no formato de token limite.
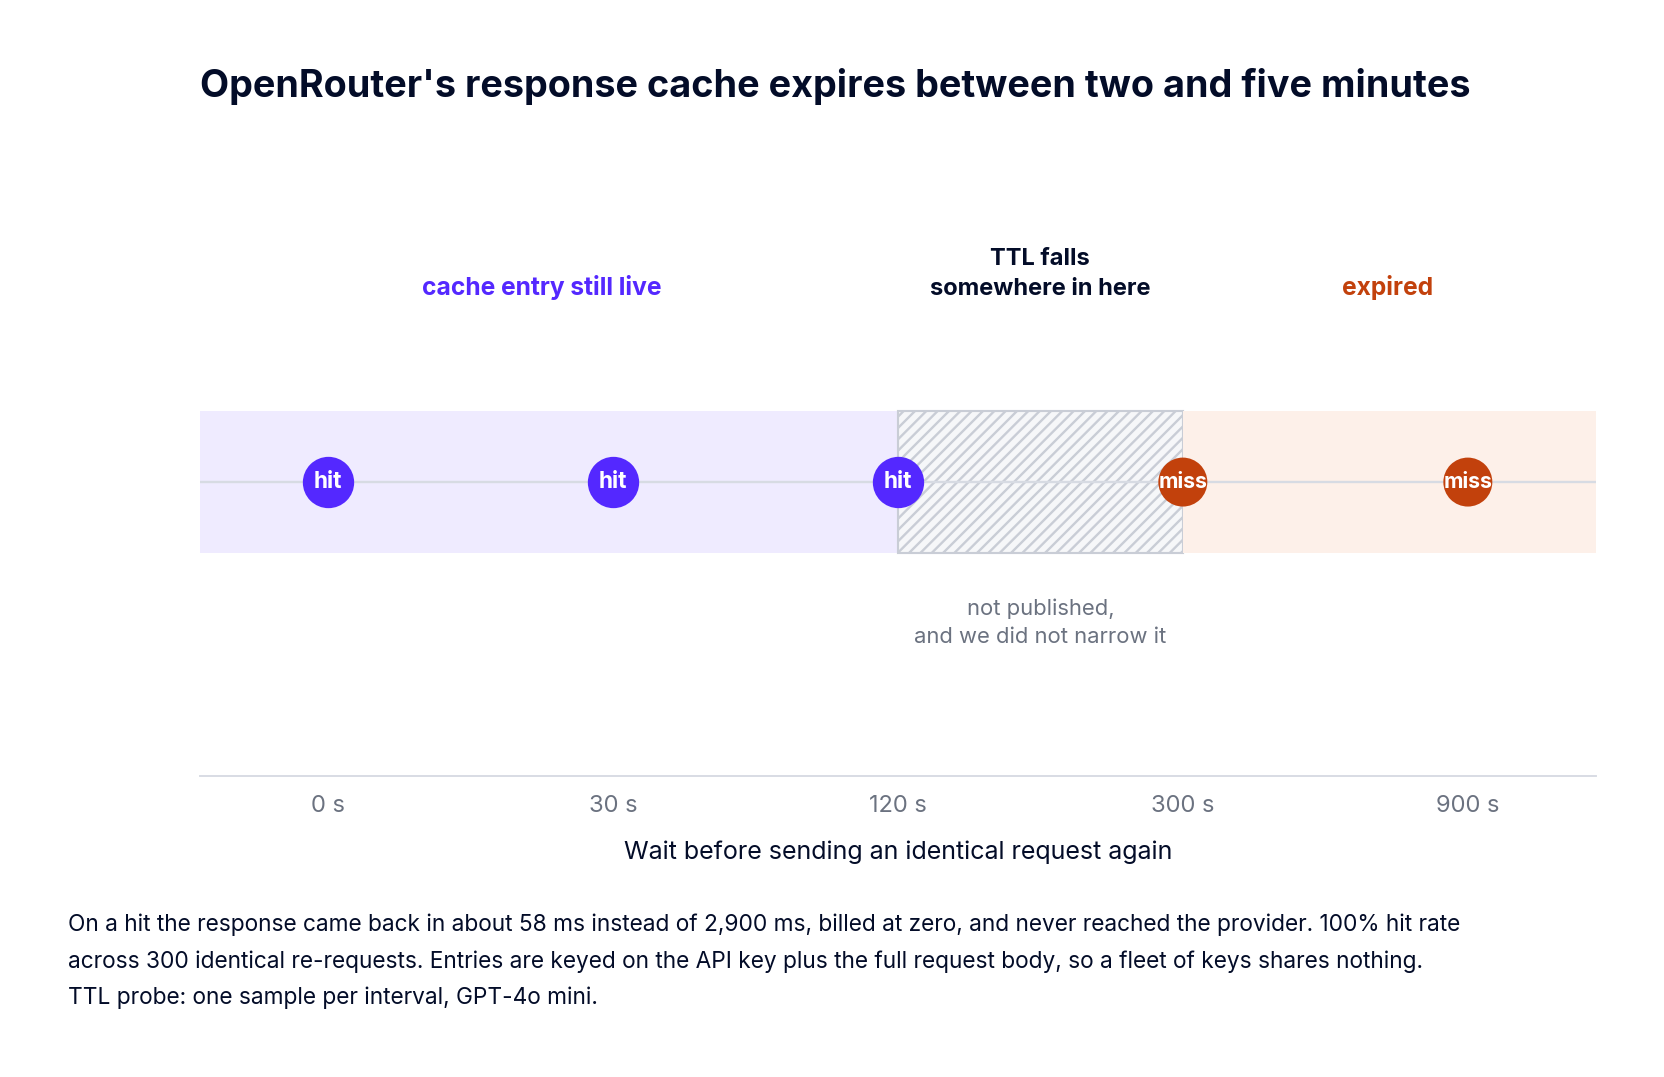
O cache de respostas ajuda, pontualmente. Ative por requisição com o cabeçalho X-OpenRouter-Cache: true e uma requisição idêntica retorna em cerca de 58 ms em vez de 2.900 ms, cobrada a zero, e a chamada não consome o limite de taxa do provedor porque a requisição nunca chega até ele. Medimos uma taxa de acerto de 100% em 300 requisições reenviadas idênticas. As restrições são onde fica interessante: as entradas são indexadas pela sua chave de API mais todo o corpo da requisição, de modo que uma frota de serviços, cada um com sua própria chave, não compartilha nada, e o TTL medido fica entre dois e cinco minutos. Ainda presente aos 120 segundos, sumido aos 300. O OpenRouter não publica esse número. Ele cobre tempestades de retentativas e envios duplicados dentro de uma sessão, e não uma consulta que retorna a cada hora.
Mais um teto que afeta durante a avaliação e não na produção: uma conta de organização tem limite de 10 membros, que pode ser aumentado entrando em contato com o suporte. Fazer um teste em uma equipe de plataforma de cinquenta pessoas começa com um chamado ao suporte.
Nosso gateway adota uma posição diferente em duas coisas: qual unidade você conta e se capacidade e dinheiro são o mesmo controle.
Aplicamos limites de taxa em seis unidades, requests_per_minute, requests_per_hour, requests_per_day, e as mesmas três para tokens. Requisições por minuto é um indicador fraco para carga quando uma chamada pode ter 200 tokens ou 200.000, portanto um contador permitindo 1.000 requisições não pode dizer se você está prestes a gastar um dólar ou quatro dígitos. Unidades de token podem. As regras são limitadas com rate_limit_applies_per, portanto um limite se aplica por usuário, por equipe ou por modelo em vez de ficar preso a uma chave, e permitimos no máximo dois valores por regra para manter o comportamento previsível.
O formato da janela importa mais para agentes do que para humanos, por isso usamos uma janela deslizante de 60 segundos de largura em blocos de 10 segundos, somando os últimos seis. Um pico cobrindo o final de um minuto fixo e o início do próximo não consegue passar despercebido com o dobro do limite. Nosso guia para limites de taxa baseados em token e orçamentos detalha a configuração.
Os orçamentos permanecem separados, apenas custo, em USD, aplicados antes do encadeamento de inferência (inference) rodar em vez de serem descobertos na fatura. O gateway adiciona cerca de 3 a 4 ms de sobrecarga e lida com mais de 350 RPS em uma única vCPU, portanto a avaliação dessas regras não custa nada que você note.
E mudar de gateway não é a única opção disponível, o que preferimos dizer abertamente. A TrueFoundry suporta o OpenRouter como provedor, para que você possa manter seu catálogo e seu failover enquanto coloca limites conscientes de tokens, orçamentos por equipe e logs atribuídos por usuário à frente dele. Para muitas equipes, esse é o primeiro passo correto. Se você está mais avançado no processo e as restrições acima são o motivo pelo qual você está lendo isto, nossa análise sobre alternativas ao OpenRouter compara as opções para uso em produção.
Os limites de taxa do OpenRouter são fáceis de declarar e complicados para construir uma aplicação em torno deles. Os números publicados cobrem apenas modelos gratuitos. O teto pago pertence a um provedor que você não escolheu. Tentativas de repetição e timeouts caem no seu código, quer você tenha planejado para isso ou não. E a sua vazão gratuita é uma função do seu histórico de pagamentos, o que é uma frase estranha de se ter que escrever.
Essa é uma troca razoável para ter centenas de modelos atrás de uma única chave, e a maioria das equipes a faz de bom grado. Apenas ajuda saber onde estão os limites antes que um loop de agente os encontre por você.
Se você deseja limites contados em tokens, orçamentos mantidos separados da capacidade e ambos aplicados dentro da sua própria infraestrutura, veja como o TrueFoundry AI Gateway lida com limites de taxa.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada














