


novembro 21, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.


Blazingly fast way to build, track and deploy your models!
Nosso ambiente de testes indicava que o OpenRouter prompt caching funcionava em modelos da Anthropic. Nosso artigo publicado poucos dias depois afirmava o contrário. Ambos estavam errados.
O teste enviou um longo bloco de texto de referência para o Claude Haiku 4.5 com cache_control, exatamente onde a documentação da OpenRouter orienta colocar. O ambiente de testes identificou campos de cache na resposta e marcou o recurso como funcional. Quando analisamos os números posteriormente, cache_write_tokens era zero, portanto consideramos que a funcionalidade havia sido descartada. A resposta esteve na documentação o tempo todo: o Haiku 4.5 não faz cache de prompts com menos de 4.096 tokens, e o nosso tinha cerca de 3.600.
A maioria dos problemas com prompt caching na OpenRouter se manifesta da mesma forma. A requisição é concluída com sucesso e a funcionalidade está ativa. A resposta apenas não informa com clareza quando o caching não ocorreu, ou quando ele ocorreu e custou mais do que economizou.
A OpenRouter usa a mesma palavra para duas funcionalidades que quase não têm nada em comum.
O prompt caching do provedor pertence ao provedor. Ele armazena o prefixo processado do seu prompt para que a próxima requisição com o mesmo prefixo pule a re-leitura, cobrando esses tokens com desconto. O modelo ainda executa e gera uma nova resposta. O cache de resposta pertence à OpenRouter. Ele armazena a resposta completa e a retorna diante de uma requisição idêntica, sem que o modelo precise ser executado.
Os preços, limites mínimos e TTLs a seguir referem-se ao prompt caching do provedor. Se você está decidindo entre cache de resposta por correspondência exata ou semântica, nosso guias sobre quando perguntas similares devem compartilhar uma resposta aborda esse tópico. O cache de resposta da OpenRouter possui sua própria seção próximo ao final.
A OpenRouter repassa o preço de cache de cada provedor sem adicionar margem por token. Suas taxas incidem sobre as compras de créditos, o que é detalhado em nossa análise de preços da OpenRouter. Os multiplicadores abaixo são relativos ao preço normal de entrada do modelo.
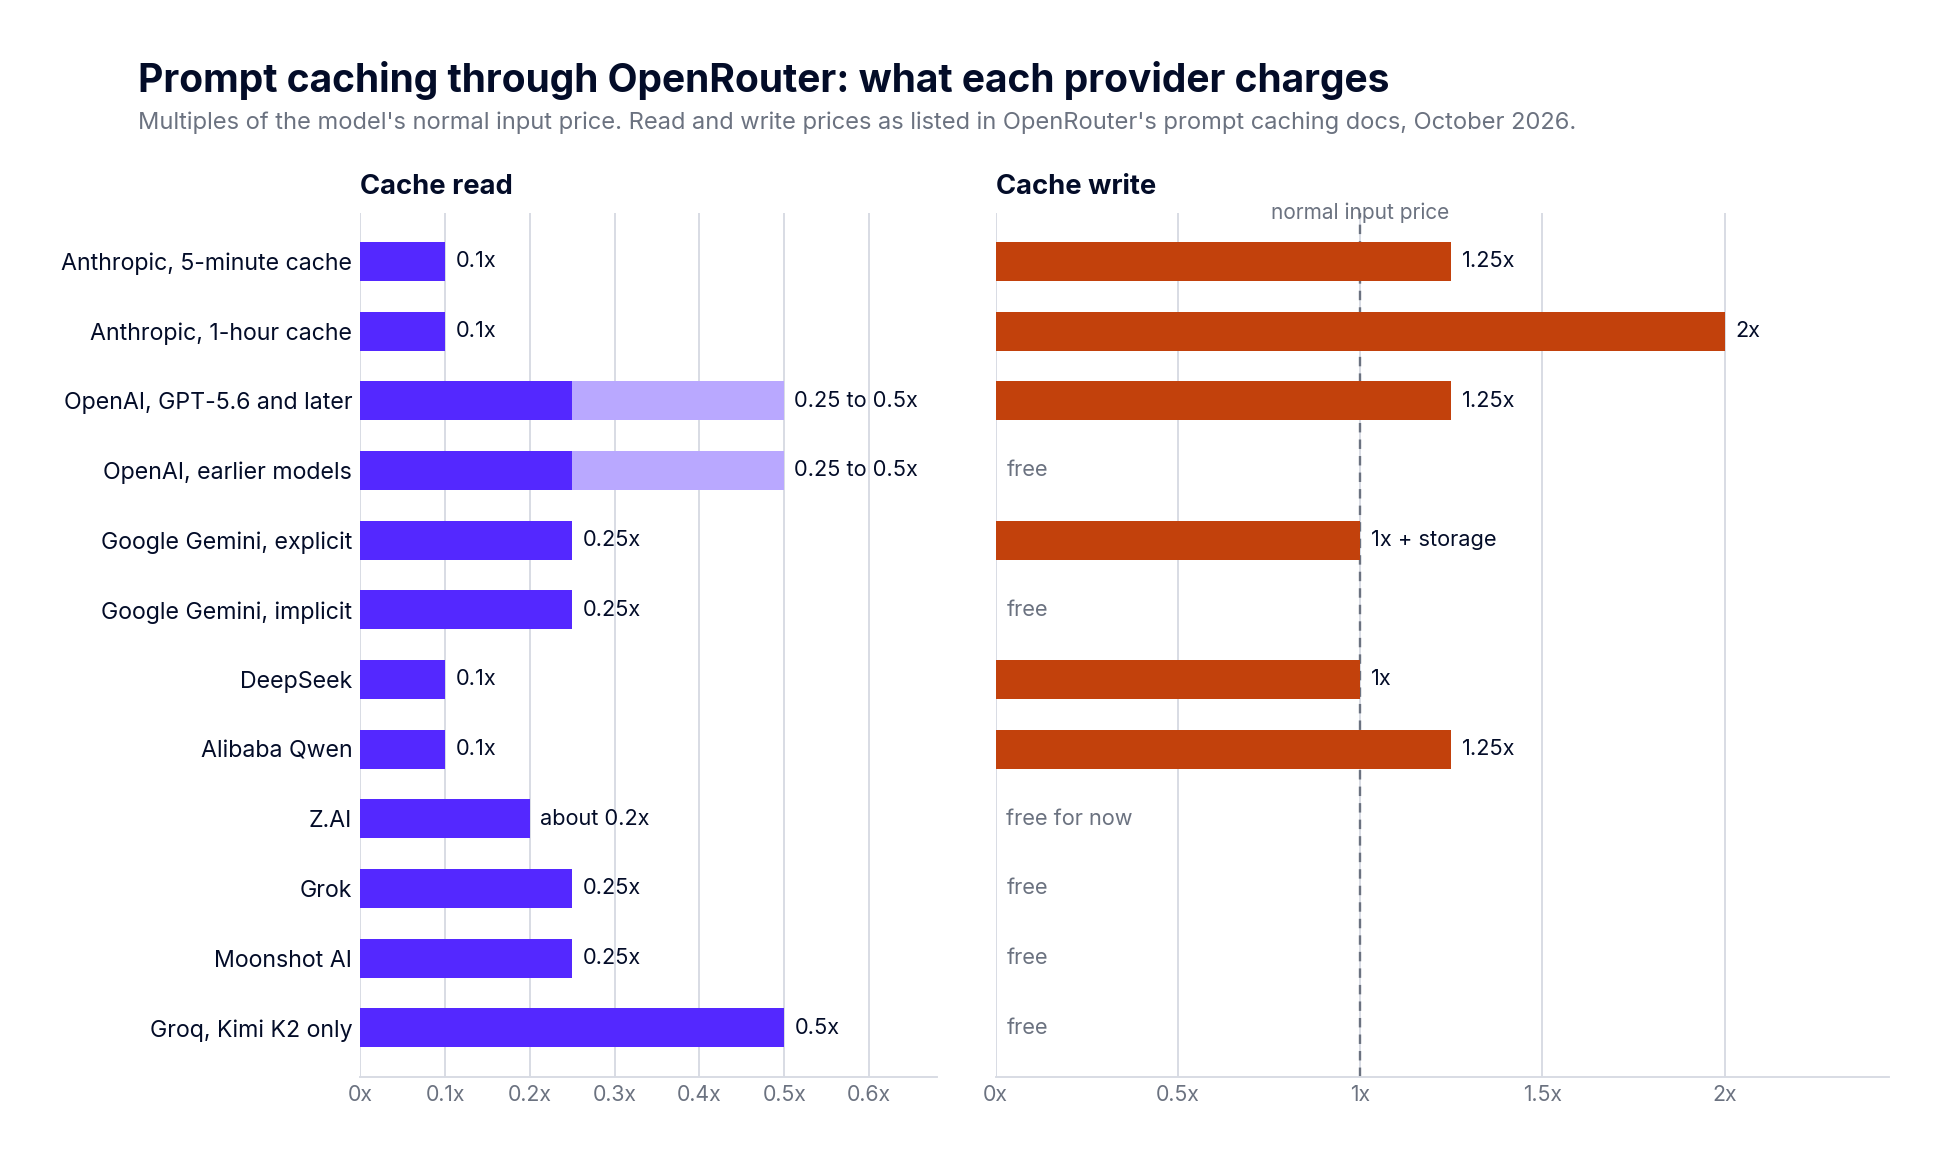
As leituras variam de um décimo a metade do preço de entrada, e as gravações variam de gratuitas ao dobro. Cinco dos nove provedores não possuem tamanho mínimo de prompt listado na documentação da OpenRouter. Além disso, com fallbacks de modelos ou o Auto Router, uma requisição pode cair em uma linha diferente da anterior, resultando em um cache frio.
Se o caching economiza dinheiro ou não, isso depende de quantas vezes o mesmo prefixo é enviado enquanto o cache ainda está ativo. Utilizando os multiplicadores acima e considerando apenas a parte do prompt que está em cache:
O restante de cada requisição — a pergunta do usuário e qualquer conteúdo após o último bloco em cache — é cobrado da mesma forma em ambos os casos, portanto essas proporções se aplicam apenas ao prefixo.
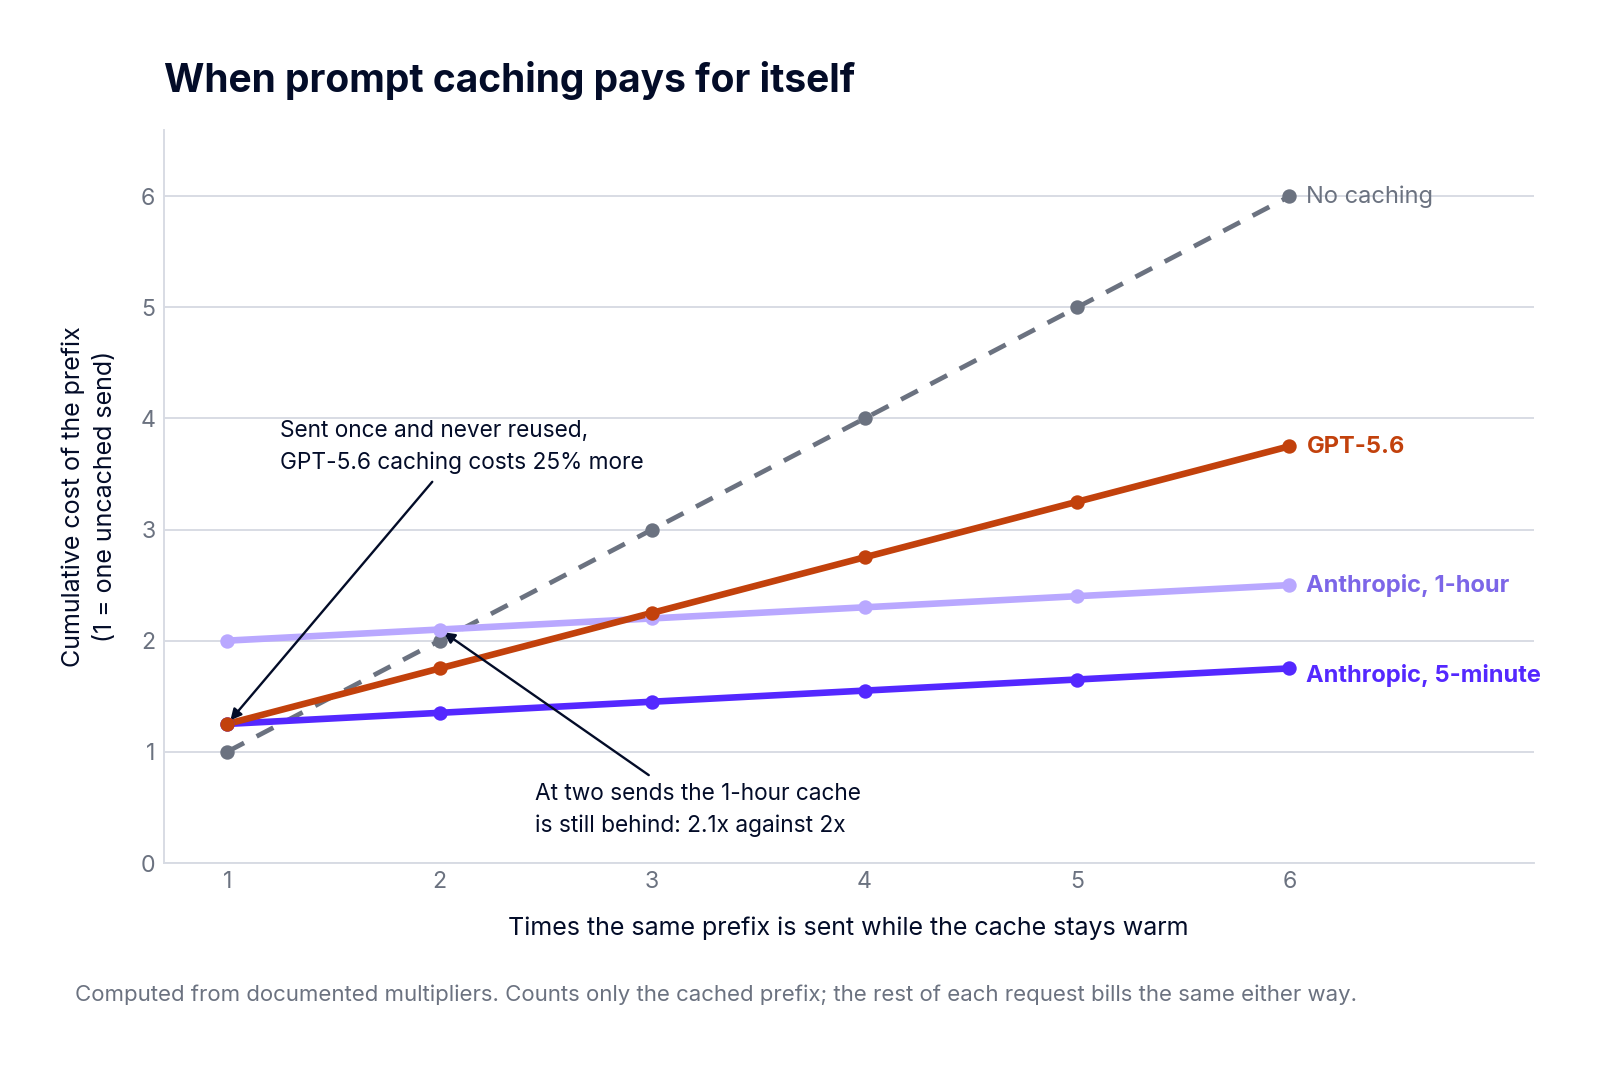
Para a maior parte da tabela, a gravação de cache é gratuita ou quase isso, tornando o caching uma opção sem custos adicionais. O GPT-5.6 mudou essa realidade para a OpenAI. A partir dessa família de modelos, a gravação de cache é cobrada a 1.25x do preço de entrada mesmo no modo automático, e o cache automático fica ativo quer você tenha solicitado ou não. Qualquer prompt de 1.024 tokens ou mais enviado apenas uma vez paga pela gravação e nunca obtém o retorno da leitura.
Considere um prompt de 2.000 tokens enviado uma única vez. Sem cache, ele é cobrado como 2.000 tokens de entrada. Com o cache ativo, você paga algo próximo ao custo de um prompt de 2.500 tokens. Em uma rotina noturna que resume um milhão de documentos longos e exclusivos, onde o documento vem primeiro e nada no início se repete, isso representa uma taxa adicional de 25% na maior parte da sua entrada.
A solução é ajustar a configuração. Defina prompt_cache_options.mode como "explicit" e não marque nenhum bloco de conteúdo com prompt_cache_breakpoint. O modo explícito desativa os pontos de interrupção automáticos da OpenAI e, sem pontos explícitos, não há prefixo passível de cache, portanto nada é gravado. cache_write_tokens retorna como zero, o que neste artigo é a única situação em que um zero representa o resultado desejado.
Analisemos agora o outro cenário. Claude Sonnet 4.6 com um prompt de sistema de 5.000 tokens, 100 requisições ao longo de um dia de trabalho, recebidas em 20 picos de cinco requisições, espaçados por cerca de 20 minutos. Contabilizando apenas o prompt de sistema, em tokens cobrados ao preço normal de entrada:
O cache de 5 minutos economiza dois terços do custo. O cache de 1 hora economiza 88%, pois um intervalo de 20 minutos expira o cache curto todas as vezes, sem atingir o limite do cache longo. A Anthropic renova o tempo de vida do cache a cada leitura, mantendo o registro de 1 hora ativo ao longo de todo o dia.
Altere o padrão de tráfego e o resultado mudará. Se essas 100 requisições chegassem de forma espaçada, uma a cada quatro minutos, o cache de 5 minutos também nunca expiraria, e a opção de 1 hora significaria pagar 10.000 por uma gravação que o cache curto processa a 6.250. Escolha o TTL com base nos intervalos entre suas requisições, e não na quantidade total enviada.
Cada provedor estabelece um tamanho mínimo de prompt abaixo do qual nada entra em cache. Para o Claude, de acordo com a documentação da OpenRouter:
O limite mínimo da OpenAI é de 1.024. O do Gemini é de 1.024 no 2.5 Flash e 4.096 no 2.5 Pro. Abaixo desse limite, a requisição é concluída com sucesso, cobrada pelo preço integral de entrada e retorna com os campos de cache zerados. Sem erros, sem avisos.
Duas consequências desse comportamento costumam passar despercebidas.
Modelos mais recentes possuem limites mínimos mais altos. Um prompt de sistema de 3.000 tokens faz cache no Sonnet 4.6, mas deixa de fazer cache no dia em que você o migrar para o Opus 4.7, sem nenhuma alteração de código e sem nenhuma sinalização na resposta. A migração do Haiku 3.5 para o Haiku 4.5 causa o mesmo efeito para qualquer prompt entre 2.048 e 4.096 tokens. Uma atualização de modelo impacta o caching, portanto verifique a taxa de acerto de cache (cache hit rate) após realizar alterações.
Além disso, não é possível confirmar o funcionamento do cache apenas identificando a presença de campos de cache. Foi exatamente isso que induziu nosso próprio teste ao erro. A OpenRouter retorna cached_tokens e cache_write_tokens nas respostas de todos os provedores, incluindo aqueles onde o caching não é nativo, portanto a presença desses campos não comprova nada. Valores zerados também não dizem muito: indicam que o marcador foi ignorado ou que o prompt estava abaixo do limite mínimo — e no Haiku 4.5 com 3.600 tokens, o motivo era o limite mínimo.
Um procedimento de teste conclusivo:
cache_write_tokens esteja acima de zero na primeira chamada. Confirme que cached_tokens esteja acima de zero na segunda.cache_discount no corpo da resposta. O valor é negativo em uma gravação da Anthropic e positivo em uma leitura.A OpenRouter converte marcadores de cache entre diferentes provedores, o que é um recurso útil. Um bloco de texto com marcador estilo Anthropic cache_control torna-se um prompt_cache_breakpoint quando roteado para um modelo GPT-5.6, e um prompt_cache_breakpoint torna-se um cache_control padrão na Anthropic ou no Google.
No entanto, o TTL não é mantido nessa conversão. Um marcador ttl em cache_control é removido no envio para a OpenAI. O parâmetro prompt_cache_options, que define o TTL da OpenAI, aplica-se exclusivamente a ela. O campo prompt_cache_breakpoint não possui parâmetro de TTL, portanto, qualquer conversão realizada do lado da Anthropic assumirá o padrão de 5 minutos.
O tempo de vida dos registros também apresenta comportamentos distintos após ser definido. O cache da Anthropic é renovado a cada leitura. O cache explícito do Gemini dura cinco minutos a partir da gravação e não se renova. O cache implícito do Gemini é documentado com duração média variável de três a cinco minutos. Dessa forma, um mesmo corpo de requisição solicitando uma hora de cache pode resultar em uma hora, cinco minutos fixos ou na política aplicada pela OpenAI, dependendo de onde for processado. A API de Responses adiciona outra limitação: ela não expõe o parâmetro cache_control por bloco da Anthropic. Portanto, utilize o Chat Completions ou o endpoint Messages caso precise de um TTL em um bloco específico.
O cache só oferece benefícios se a requisição seguinte atingir o mesmo provedor que contém os dados armazenados. A OpenRouter gerencia isso por meio do roteamento fixo por provedor (provider sticky routing): após uma requisição que utiliza cache, as chamadas subsequentes para o mesmo modelo são direcionadas para o mesmo endpoint do provedor.
A fixação é rastreada por conta, por modelo e por conversa, onde a conversa é identificada pelo hash da primeira mensagem do sistema e da primeira mensagem do usuário. Esse registro expira após 10 minutos sem novas requisições.
Agentes inteligentes costumam quebrar esse comportamento padrão, pois suas mensagens iniciais mudam entre os turnos. Ao passar session_id no corpo da requisição ou um cabeçalho x-session-id, a OpenRouter utiliza esse valor como chave de fixação, iniciando a retenção a partir da primeira requisição bem-sucedida em vez de aguardar por um acerto de cache. O parâmetro prompt_cache_key da OpenAI funciona como chave de fallback caso você já o utilize.
Definir provider.order desativa o roteamento fixo, priorizando a sua lista de provedores. Enquanto sua primeira opção mantiver um estado saudável, o impacto financeiro é baixo, visto que a fixação mantém as chamadas no mesmo provedor. A diferença se torna evidente após um failover: enquanto o roteamento fixo acompanharia o provedor que atendeu a requisição, a fixação por lista reinicia a avaliação a partir do topo. A definição fixa de provedor é recomendada quando há necessidade de capacidade previsível, conforme detalhado em nosso artigo sobre limites de taxa da OpenRouter. O Auto Router apresenta uma dinâmica similar: se o modelo selecionado deixar de fazer parte dos candidatos em um turno posterior, o cache associado é perdido.
De forma independente de tudo o que foi descrito acima, a OpenRouter pode realizar o cache de respostas completas caso você envie X-OpenRouter-Cache: true. Um acerto de cache (hit) retorna a resposta armazenada sem realizar chamadas ao provedor, sem custos de bilhetagem e sem consumir os limites de taxa do provedor.
Avaliamos esse comportamento em três execuções de 100 requisições idênticas cada, utilizando o GPT-4o mini e o Claude Haiku 4.5. Todas as novas requisições resultaram em acertos de cache. A latência mediana foi de 2.867 ms em uma falha de cache (miss) e de 59 ms em um acerto (hit), sendo que os acertos no Haiku foram ainda mais rápidos, atingindo 39 ms contra 64 a 69 ms no GPT-4o mini. Na bateria de testes faturada por créditos, 100 falhas custaram $0,0174 e 100 acertos não geraram custos.
Os registros são indexados pela chave de API combinada ao modelo, tipo de endpoint, modo de streaming e corpo completo da requisição. Dessa forma, serviços com chaves distintas não compartilham dados e qualquer alteração de parâmetro resulta em uma falha de cache. Nosso teste de TTL, com uma amostragem por intervalo, identificou registros ativos aos 120 segundos e expirados antes dos 300 segundos. Não há TTL público documentado, correspondência semântica ou mecanismo de limpeza exposto. Essa funcionalidade é adequada para absorver reconfigurações de tentativas (retries) e envios duplicados. Uma execução repetida a cada hora resultará em falha de cache.
Nosso gateway realiza o cache na camada de resposta em dois modos distintos. A correspondência exata (exact-match) retorna uma resposta armazenada para uma requisição idêntica. O modo semântico gera embeddings da última mensagem e retorna uma resposta armazenada quando uma requisição anterior for suficientemente próxima, além de atender aos acertos por correspondência exata, dispensando a execução simultânea dos dois modos. O recurso é ativado via cabeçalho de requisição, sustentado por Redis, e integra-se ao prompt caching do provedor: em caso de falha no gateway, o cache de prefixo do próprio provedor continua sendo aplicado.
No modelo SaaS, o modelo de embedding utilizado é o text-embedding-3-small com 1.536 dimensões, não sendo configurável; em ambientes on-premises, a escolha do modelo é feita em nível de gateway. A correspondência semântica apresenta um cenário de falha inexistente no modo exato. Nosso guia de cache semântico exemplifica esse cenário: dois clientes fazem perguntas sobre suas entregas com poucos minutos de diferença; as perguntas geram vetores quase idênticos e o segundo cliente recebe uma resposta contendo os dados do pedido do primeiro. Isso caracteriza uma falha de escopo. Ajustar o limite de similaridade altera a frequência do problema, mas não resolve o risco em um cache compartilhado entre múltiplos clientes.
A busca no cache adiciona aproximadamente 3 a 4 ms de latência, e o gateway suporta mais de 350 RPS em uma única vCPU.
session_id para sessões de agentes, garantindo que o roteamento permaneça no provedor que contém seu cache.cached_tokens, e nunca apenas pela presença do campo na resposta.O OpenRouter prompt caching funciona adequadamente, e a documentação é mais clara neste ponto do que em diversas outras funcionalidades correlatas. Ainda assim, é necessário lidar com nove tabelas de preços, limites mínimos que aumentam em modelos mais recentes, tempos de vida que mudam no processo de conversão e respostas com estrutura idêntica, independentemente de o cache ter ocorrido ou não. Valide o limite mínimo, organize o texto estável no início e confirme o funcionamento com métricas numéricas em vez de apenas verificar a presença de campos.
Para configurar o cache de forma unificada para todos os provedores, com suporte a correspondência semântica integrado ao cache de prefixo nativo do provedor, veja como o TrueFoundry AI Gateway gerencia o caching.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



It's OpenRouter passing through each provider's prompt caching, where a repeated prompt prefix is stored and billed at a discount on later requests. Some providers cache automatically, while Anthropic and Alibaba need cache_control markers on the content you want cached. Prices differ by provider, from free writes and 0.1x reads to 2x writes on Anthropic's 1-hour cache.
Yes, as long as the prompt clears the model's minimum length. Claude Haiku 4.5 and Opus 4.5 and later need 4,096 tokens, and Sonnet 4.x needs 1,024. Below that floor the request succeeds at full price with cache fields at zero, which looks exactly like the marker being ignored.
Most likely you're paying for cache writes on prompts that never get reused. GPT-5.6 and later bill writes at 1.25x even under automatic caching, and Anthropic's 1-hour cache bills writes at 2x. If the prefix doesn't repeat while the cache is warm, you pay for the write and never get the discount.
Sim. O TrueFoundry é executado na sua VPC, on-prem, em ambiente air-gapped ou híbrido, de modo que os prompts e as respostas nunca saem do seu domínio, mesmo quando você roteia entre muitos provedores.



As últimas notícias, artigos e recursos enviados para sua caixa de entrada














