


novembro 21, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.


Blazingly fast way to build, track and deploy your models!
Nove dos dezenove modelos gratuitos no OpenRouter executam em provedores cujas políticas publicadas dizem que podem treinar com seus prompts. O rótulo é do OpenRouter, proveniente da política de dados estruturados que ele publica para cada provedor para o qual faz o roteamento.
Alguém está pagando pelas GPUs. A troca geralmente é razoável: inferência gratuita em troca de dados de uso, feedback e adoção. "US$ 0 por token" é a fatura. A política de dados, o host único e por quanto tempo o modelo permanece listado são o restante do custo real, a partir de 5 de outubro de 2026.
Os modelos gratuitos no OpenRouter geralmente possuem o sufixo :free no ID do modelo, como nvidia/nemotron-3.5-lightning:free. Em 5 de outubro, a API de modelos listava 17 deles, além de mais dois com preço zero sem o sufixo: inclusionai/ling-3.1-flash, adicionado dois dias antes, e stealth/space-bunny-alpha, um modelo anônimo servido pelo provedor stealth do OpenRouter. Isso soma 19 modelos de texto gratuitos. Há também o openrouter/free, um roteador que seleciona um deles aleatoriamente para cada requisição, filtrando os recursos necessários para a sua solicitação.
A página de preços do OpenRouter descreve o plano gratuito como "mais de 25 modelos gratuitos" de "4 provedores gratuitos". A API mostra 19 modelos de 10 provedores. Essa diferença provavelmente se deve à rotatividade do catálogo e a diferentes formas de contagem, em vez de algo oculto, mas serve como um lembrete para consultar a API em vez do material de marketing.
Agrupados de acordo com a política de dados do host:
O OpenRouter publica uma política de dados para cada um dos 92 provedores que lista: se o provedor pode treinar com prompts, se os retém e por quanto tempo. Apenas cinco desses 92 estão marcados como possivelmente treinando com prompts. Quatro dos cinco servem modelos gratuitos: NVIDIA, Thinking Machines, Liquid e o provedor stealth. O quinto, DeepSeek, é pago.
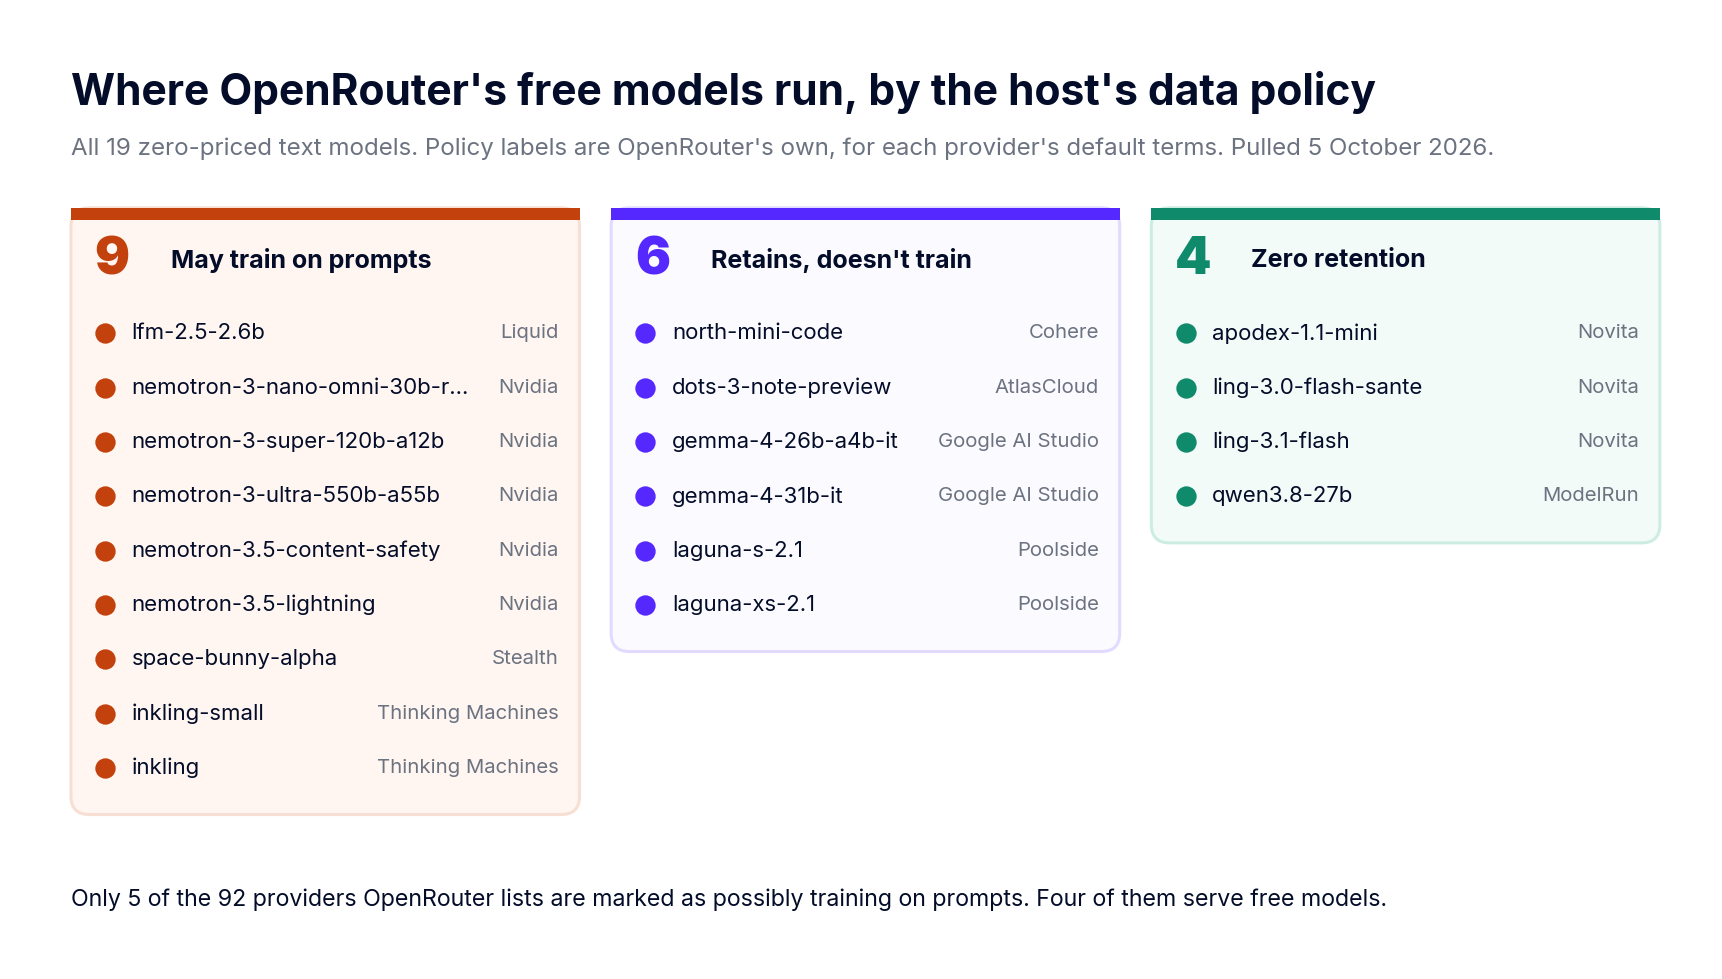
Portanto, especificamente para modelos gratuitos, a divisão é: nove em hosts que podem treinar, seis em hosts que mantêm seus prompts sem treinar com eles (Google AI Studio por 55 dias, Cohere por 30, Poolside e AtlasCloud por um período não informado) e quatro com zero retenção, sendo três deles na Novita.
Três ressalvas mantêm essa análise justa. Primeiro, esses são os termos padrão de cada provedor. O OpenRouter afirma que um endpoint individual pode conter uma política diferente do padrão do seu provedor, e às vezes negocia termos mais rígidos, portanto, algumas rotas gratuitas podem ser melhores do que o mostrado. Segundo, quando o OpenRouter não consegue estabelecer uma política, ele marca o endpoint como realizando treinamento e retenção, pecando pela cautela. Terceiro, "pode treinar" descreve o que os termos permitem, não o que acontece com um prompt específico.
Os termos explicam essa divisão. Os links que o OpenRouter fornece para a NVIDIA são seus termos de teste de API, e para a Thinking Machines, seus termos de nível de pesquisa gratuita. Criadores de modelos oferecerem inferência gratuita para aprender com o uso é um arranjo normal e perfeitamente adequado para dados públicos e projetos paralelos. É uma péssima opção para dados de clientes, código interno ou qualquer coisa sob um NDA.
O OpenRouter oferece controles. Suas configurações de privacidade têm seletores separados para endpoints pagos e gratuitos que podem treinar com entradas, além de um modo de retenção zero de dados, e as requisições podem definir data_collection: "deny". Há duas coisas importantes sobre eles. A tabela de preços do OpenRouter lista o roteamento baseado em política de dados como um recurso do plano Standard, não parte do plano Free. E nenhum dos 92 provedores está atualmente marcado como capaz de publicar prompts, portanto, o seletor "endpoints gratuitos que podem publicar prompts" não bloqueia nada hoje.
Cada um dos 19 modelos gratuitos possui exatamente um endpoint. Um modelo pago no OpenRouter pode ter uma dúzia de hosts e fazer fallback entre eles. Um modelo gratuito tem um único host; portanto, quando ele está ocupado ou fora do ar, não há para onde fazer fallback.
Isso afeta diretamente os controles de privacidade mencionados acima. Desative a opção "endpoints gratuitos que podem treinar" e o OpenRouter para de rotear para esses hosts, conforme documentado. Com apenas um host por modelo, isso não o direciona para um local mais seguro. Isso simplesmente torna nove dos dezenove modelos indisponíveis.
O uptime de um dia variou de 97% a 100% para a maioria dos endpoints gratuitos no dia em que coletamos os dados, com uma exceção, Nemotron 3 Nano Omni, a 86%. Além disso, existem os limites (caps): 20 requisições por minuto em qualquer modelo gratuito, e 50 por dia até que você tenha comprado pelo menos 10 créditos, passando para 1.000 por dia. Requisições que falharam ainda podem contar contra a cota diária. Nosso artigo sobre limites de taxa do OpenRouter aborda como esses limites funcionam e por que dependem do seu histórico de pagamento.
Uma variante gratuita nem sempre é o mesmo deployment do modelo pago com o mesmo nome. O Gemma 4 31B é o exemplo mais claro: o endpoint gratuito limita a saída a 32.768 tokens, enquanto os hosts pagos para o mesmo modelo chegam a 262.141, existindo 13 deles para escolher.
Isso funciona nos dois sentidos. O endpoint gratuito do Nemotron 3 Ultra oferece um contexto de um milhão de tokens contra 262.144 em seus hosts pagos, e o endpoint gratuito do Inkling dobra seu contexto pago. O gratuito pode ser maior ou menor do que a rota paga. Apenas a string do modelo não diz qual é o caso, o que é verdade para o OpenRouter em geral, conforme abordamos em o que é o OpenRouter e como ele roteia requisições.
Os modelos gratuitos no OpenRouter são recentes. Em 5 de outubro, a mediana de listagem de um modelo gratuito era de 75 dias, 8 dos 19 haviam surgido nos 60 dias anteriores, e o mais antigo, Nemotron 3 Super, estava lá há 207 dias. Dois nomes são rotulados como prévias: um tem "preview" em seu ID e o outro é um alpha stealth.
Eles também desaparecem. Dois IDs gratuitos recomendados por um guia de julho amplamente compartilhado, qwen/qwen3-coder:free e deepseek/deepseek-r1:free, não estão mais listados, enquanto as versões pagas de ambos os modelos ainda estão. A variante gratuita foi retirada, não o modelo. Trate um modelo gratuito como uma promoção com data de término não informada com antecedência e defina um fallback pago se algo depender dele.
O roteador openrouter/free retorna um endpoint funcional a cada requisição escolhendo um modelo gratuito aleatoriamente, de modo que duas requisições na mesma conversa podem ser respondidas por modelos diferentes, de empresas diferentes, sob políticas de dados diferentes.
Esta é a parte que a maioria dos guias de planos gratuitos pula. Para seis dos nove modelos gratuitos cujo host pode treinar com os dados, o mesmo modelo também é servido pela DeepInfra, que os dados do OpenRouter marcam como um provedor que não treina nem retém prompts.
Considere o Nemotron 3.5 Lightning. Gratuito na NVIDIA, ou US$ 0,06 por milhão de tokens de entrada e US$ 0,16 por milhão de tokens de saída na DeepInfra. No próprio limite do plano gratuito de 1.000 requisições por dia, com 2.000 tokens de entrada e 500 de saída por requisição, isso dá 20 centavos por dia: US$ 6,00 por 30 dias, ou US$ 6,33 após a taxa de crédito de 5,5% do OpenRouter. Para obter 1.000 requisições gratuitas por dia você precisa comprar US$ 10 em créditos de qualquer forma, o que por si só cobriria mais de um mês e meio da rota paga.
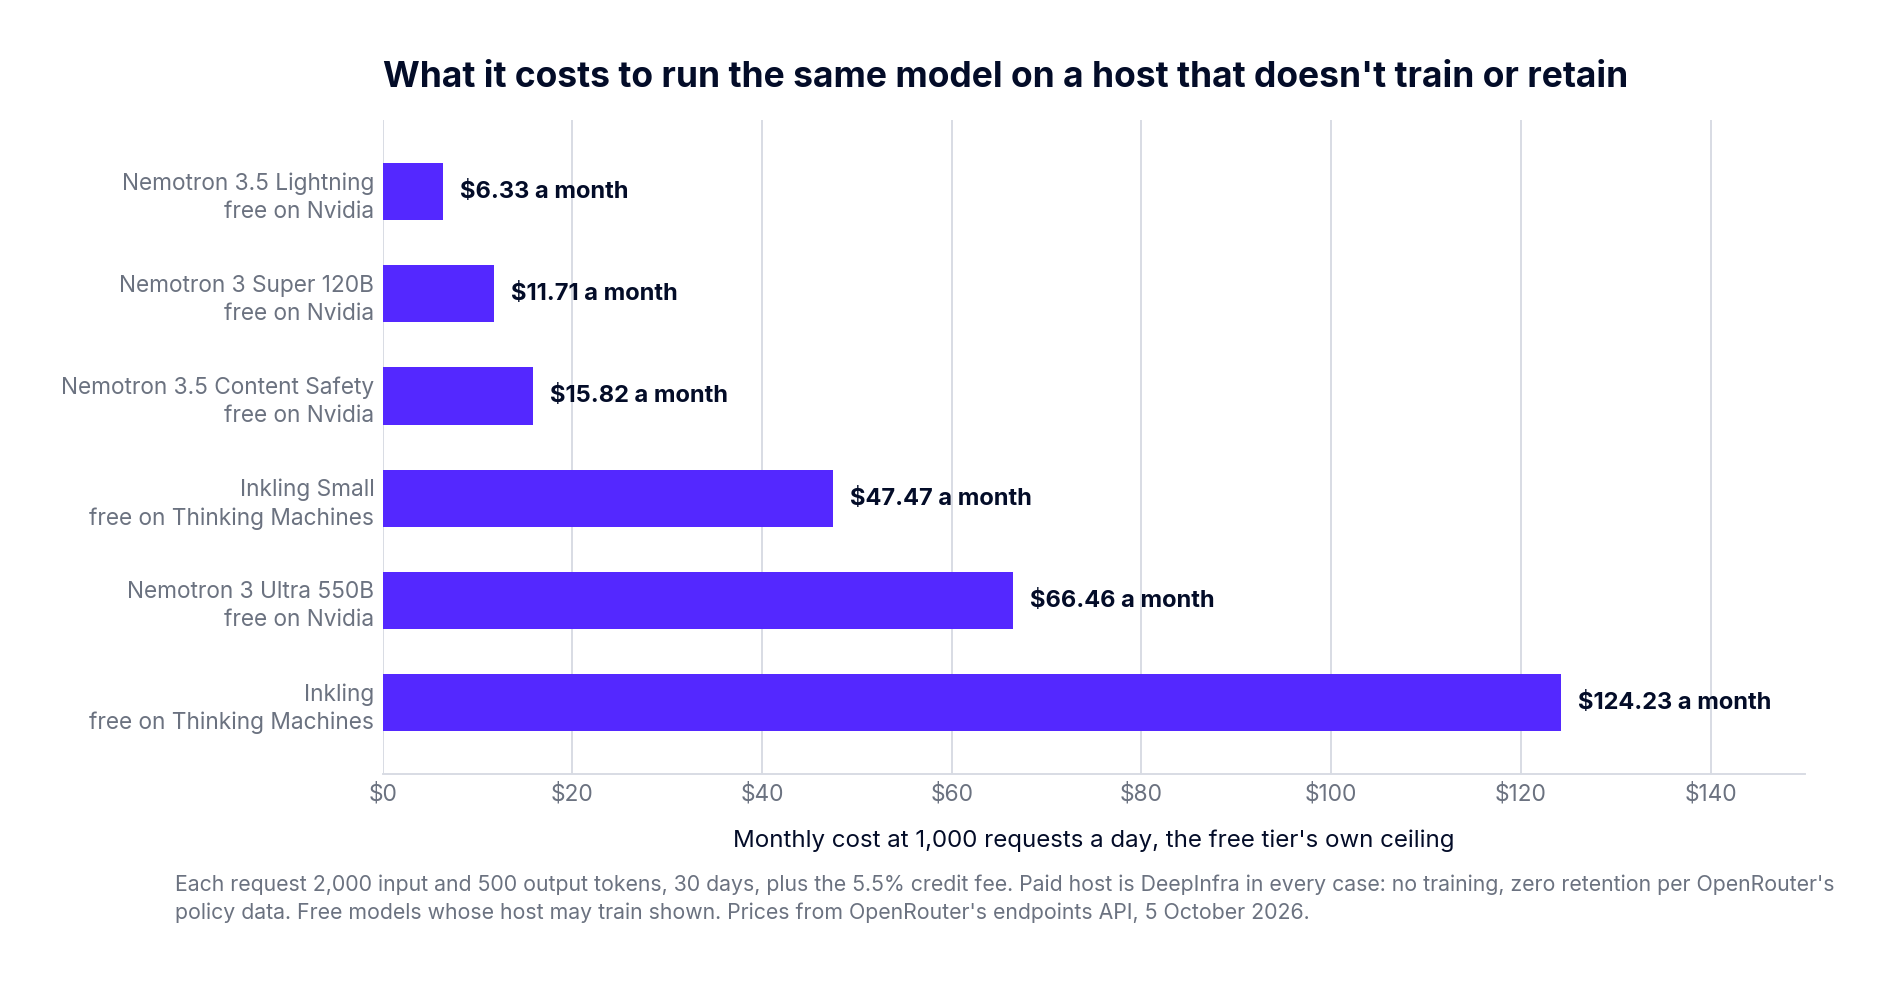
A variação é ampla, de US$ 6 por mês para o Lightning até US$ 124 para o Inkling, então "apenas pagar" não é automaticamente trivial para os maiores modelos. Mas para os três modelos Nemotron menores, manter seus prompts fora de uma pipeline de treinamento custa menos de US$ 16 por mês.
Os modelos gratuitos do OpenRouter são uma boa opção para prototipagem, para comparar modelos antes de se comprometer e para avaliações em dados públicos ou sintéticos. Projetos paralelos, demonstrações e aprendizado também se encaixam bem. Qualquer coisa vagamente sensível pode ir para os quatro modelos de retenção zero e deve ficar longe dos demais.
Eles são uma péssima opção para dados de clientes, código interno ou qualquer coisa coberta por um NDA ou DPA. O mesmo vale para qualquer aplicação que precise permanecer online, já que há apenas um host e nenhum fallback, e para qualquer coisa que você vá colocar em produção, pois o modelo pode ser retirado sem aviso prévio. Em qualquer volume real, a rota paga costuma custar apenas alguns dólares por mês.
Vários desses modelos gratuitos vêm de famílias que publicam pesos abertos, entre elas Gemma e Qwen. Executar esses pesos nas suas próprias GPUs é a maneira de usar o modelo sem nenhum terceiro no caminho da requisição. A TrueFoundry os implanta com vLLM, TGI e Triton, atrás do mesmo AI Gateway que faz a frente dos seus provedores hospedados.
Se você preferir manter o OpenRouter, o gateway pode ser posicionado na frente dele e restringir quais modelos cada equipe pode chamar, garantindo que os endpoints gratuitos fiquem com as equipes de desenvolvimento, enquanto o tráfego de produção vai para hosts previamente auditados. Ele expõe mais de 1.000 LLMs por meio de uma única API compatível com a OpenAI, adiciona cerca de 3 a 4 ms de overhead e suporta mais de 350 RPS em um único vCPU.
Os modelos gratuitos do OpenRouter custam US$ 0 por token e são úteis para testar um modelo antes de se comprometer. Quase metade roda em hosts que podem treinar com seus prompts, todos eles rodam em um único host e poucos estão listados há mais de alguns meses. Use-os para explorar, mantenha dados sensíveis em rotas de retenção zero ou pagas, e verifique o endpoint antes de confiar no nome do modelo.
Para executar pesos abertos sem terceiros no caminho, veja como o TrueFoundry AI Gateway serve modelos auto-hospedados e hospedados juntos.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



They cost nothing per token. You pay in other ways: nine of the nineteen free models run on hosts whose policy says they may train on your prompts, each free model has only one host and no fallback, and usage is capped at 20 requests a minute and 50 a day, or 1,000 a day once you've bought 10 credits.
It depends on the host. As of 5 October 2026, nine of the nineteen free models ran on providers that OpenRouter marks as possibly training on prompts, six on providers that retain prompts without training, and four on zero-retention hosts. OpenRouter itself says it doesn't train on API data; the policy that matters is the provider's.
On 5 October 2026 OpenRouter's API listed 19 free text models: 17 with a :free suffix and two priced at zero without one, served by 10 providers. Its pricing page says "25+". The list changes often, so query /api/v1/models for the current set.
Sim. O TrueFoundry é executado na sua VPC, on-prem, em ambiente air-gapped ou híbrido, de modo que os prompts e as respostas nunca saem do seu domínio, mesmo quando você roteia entre muitos provedores.
Qualquer LLM por meio de backends de alto desempenho como vLLM, TGI e Triton, além de servidores compatíveis com a OpenAI, como o Ollama, todos conectados ao mesmo AI Gateway e governados da mesma forma.



As últimas notícias, artigos e recursos enviados para sua caixa de entrada














