


novembro 18, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Blazingly fast way to build, track and deploy your models!
Quando uma chamada de LLM é lenta, cara ou apresenta um resultado incorreto, você precisa ver o que realmente aconteceu. Um guardrail ocultou o prompt? Quanto tempo o modelo levou em comparação com a rede? O que o gateway enviou para o provider? O request logging e o tracing no AI Gateway respondem a essas perguntas para cada chamada.
Como todas as requisições já passam pelo gateway, você obtém essa visibilidade sem precisar instrumentar cada aplicação manualmente.
A documentação de request logging permite controlar quais requisições são registradas em log. O controle mais simples é por requisição, usando o cabeçalho X-TFY-LOGGING-CONFIG com um valor JSON em formato de string. Defina enabled como true para registrar a requisição em log ou false para ignorá-la.
Um detalhe importante que vale a pena notar: o valor desse cabeçalho é um JSON em formato de string, e não um objeto JSON bruto, porque a maioria dos SDKs serializa cabeçalhos como strings. Os modos globais de logging mais antigos estão sendo substituídos pela configuração de logging baseada em regras, que permite controlar o logging por subject, modelo ou metadados e ocultar valores sensíveis.
Para ver as requisições registradas na UI, acesse AI Gateway, depois Monitor e, em seguida, Requests. Isso exibe a lista de todas as chamadas registradas em log, que você pode abrir para inspecionar uma única requisição em detalhes.
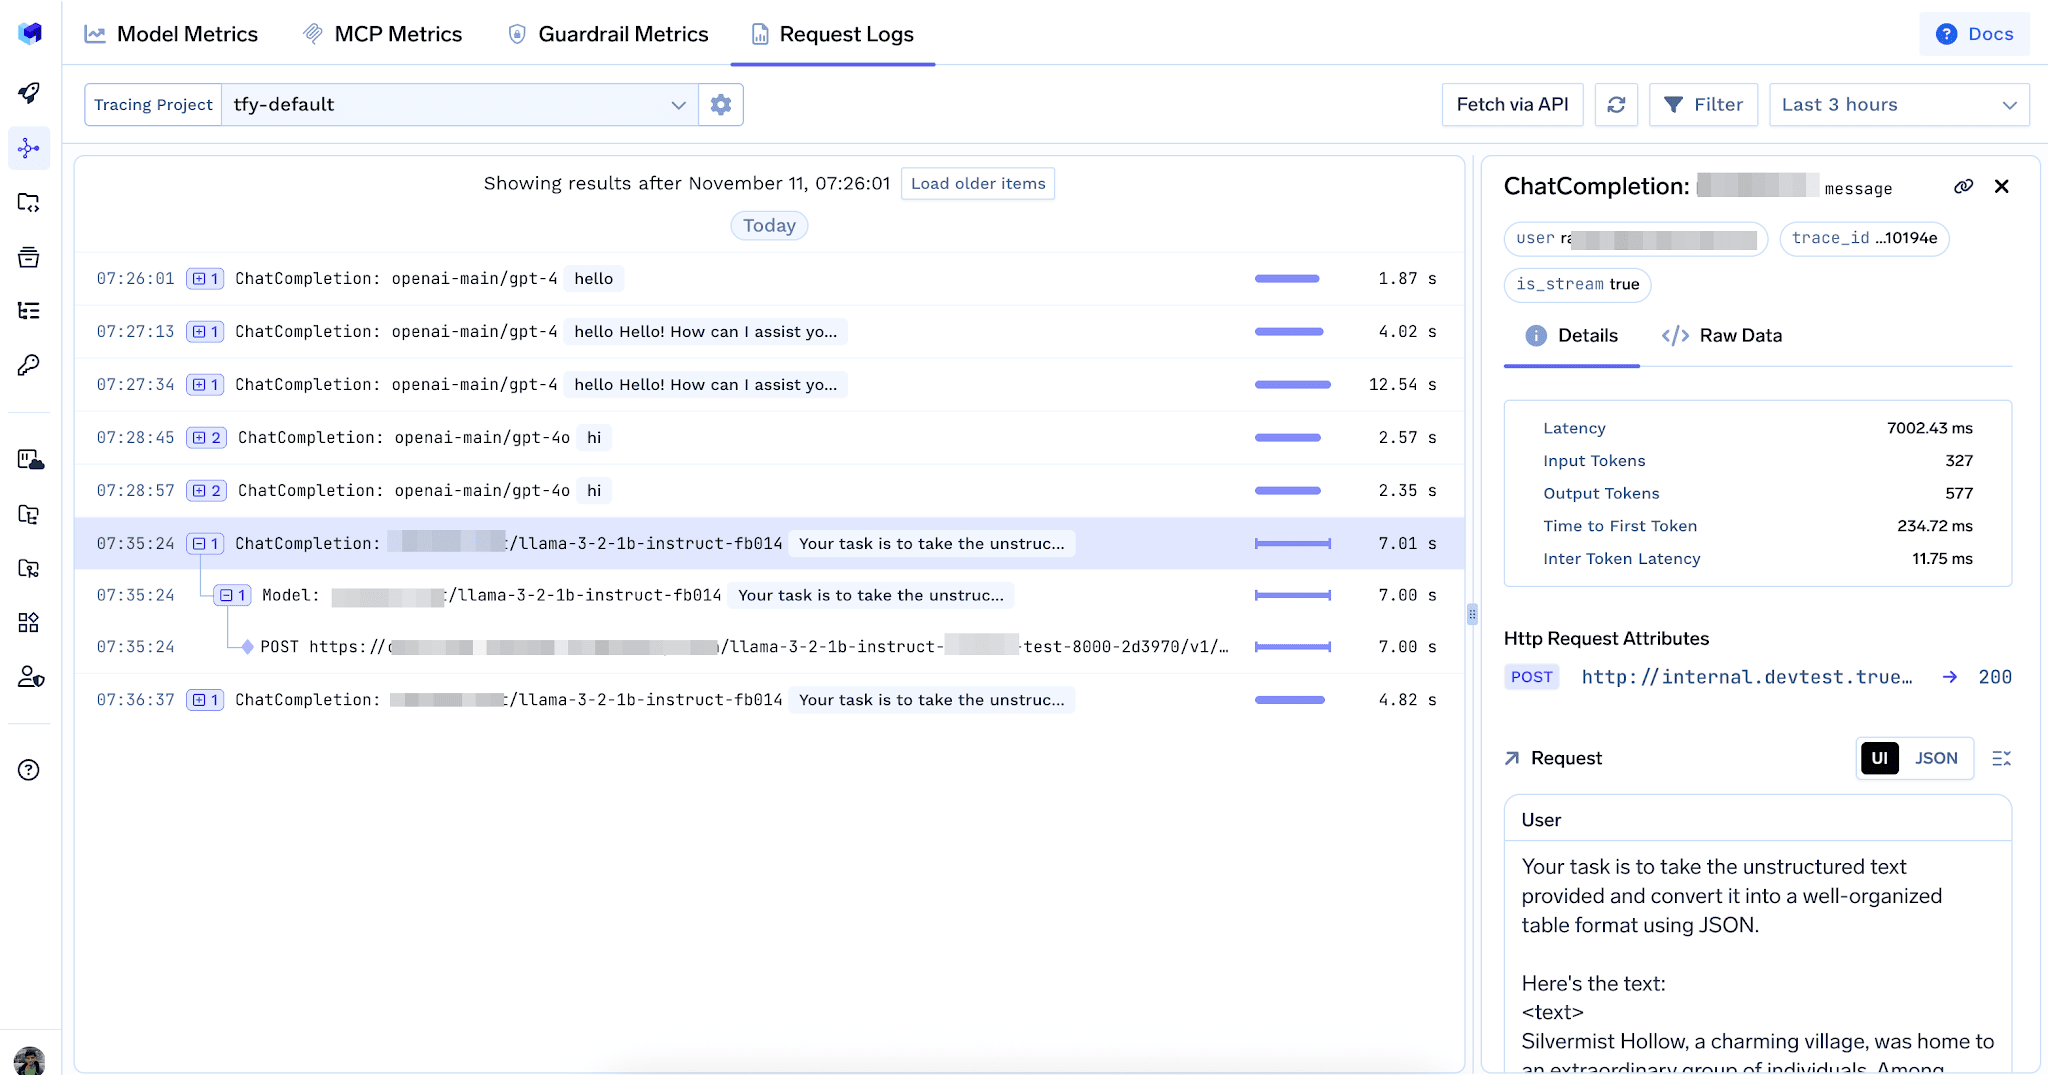
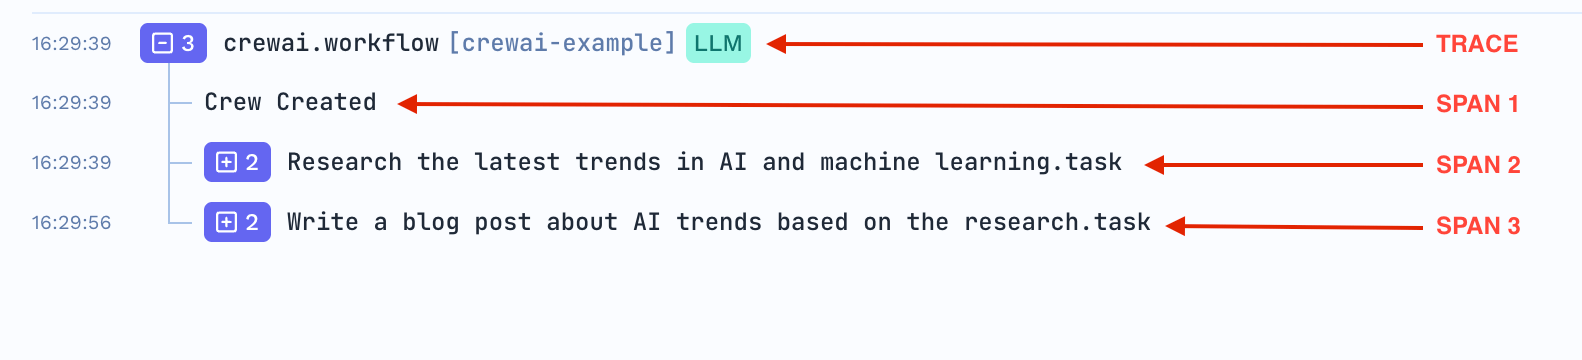
A documentação de tracing descreve um trace como o ciclo de vida completo de uma requisição à medida que ela flui pelos serviços que interagem com o LLM. Normalmente, um trace corresponde a uma única chamada de API de uma aplicação.
Um span é uma unidade individual de trabalho dentro desse trace, como uma chamada de função, uma requisição HTTP ou uma inferência de modelo. Um trace é uma árvore de spans com relações de pai e filho, onde um span filho geralmente é provocado por seu pai. O TrueFoundry fornece um backend collector de OpenTelemetry que armazena esses traces e uma UI para consultá-los e analisá-los, além de poder receber traces de qualquer SDK compatível com OpenTelemetry.
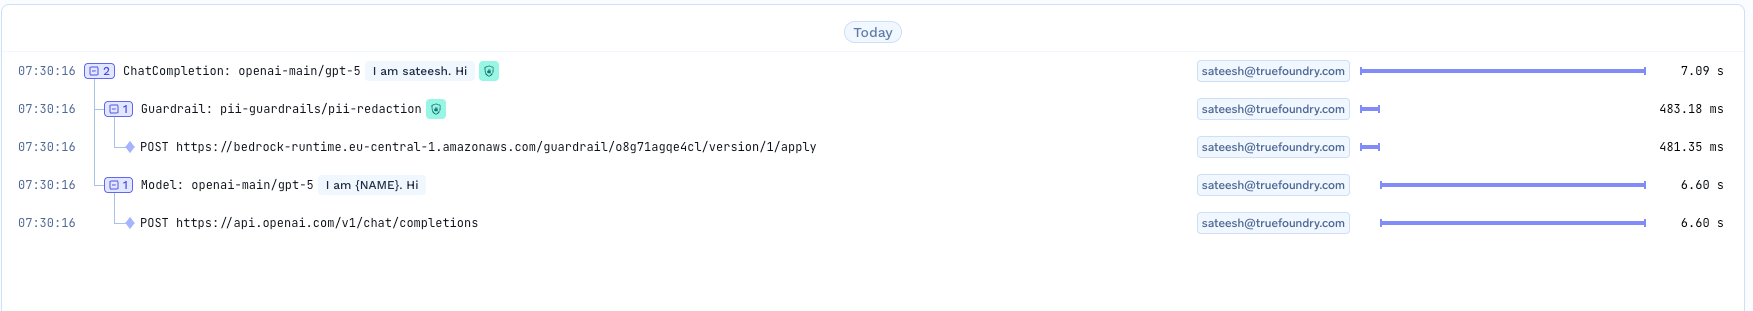
A documentação de inspeção de traces apresenta um exemplo real: uma chat completion com um guardrail de redação de PII, capturada como cinco spans que formam uma hierarquia.
Nesse mesmo exemplo, a entrada é visivelmente redigida de um nome para um placeholder, o que mostra o guardrail de PII funcionando de ponta a ponta dentro do trace.
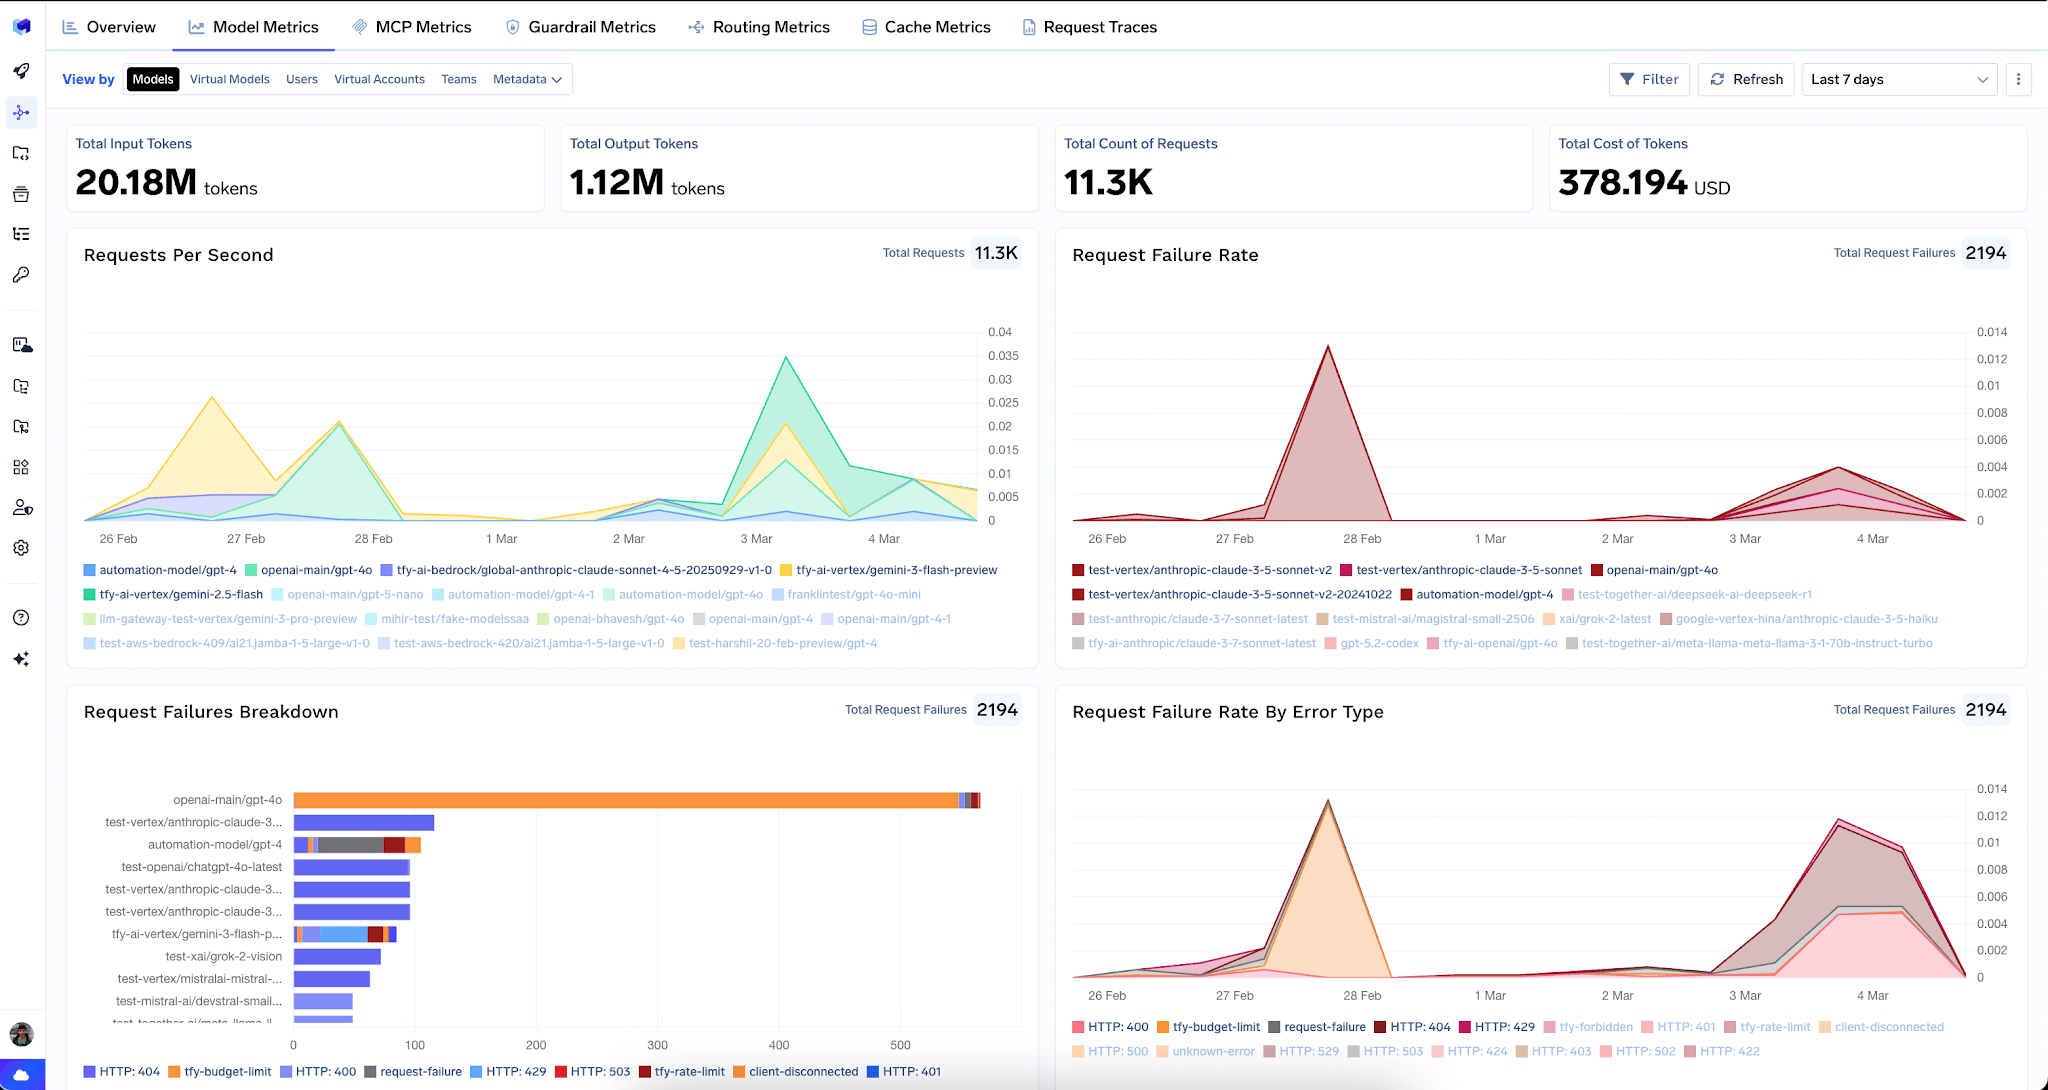
Traces individuais servem para depuração. Para analisar tendências, o painel de analytics agrega os mesmos dados. As abas cobrem Overview, Model Metrics, MCP Metrics, Guardrail Metrics, Routing Metrics e Cache Metrics.
As métricas de modelo podem ser agrupadas por modelos, modelos virtuais, usuários, contas virtuais, equipes ou metadados, e as visualizações de latência detalham a latência da requisição, time to first token, latência entre tokens e tempo por token de saída. Junto com os traces por requisição, isso oferece tanto o microscópio quanto o painel geral.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



Send the X-TFY-LOGGING-CONFIG header with a stringified JSON value and set enabled to true or false. Remember that the value is stringified JSON, not a raw object, because most SDKs serialize headers as strings.
Logged requests appear under AI Gateway, then Monitor, then Requests. Opening a request shows its trace, which is the tree of spans covering guardrails, the model, and the outbound provider calls.
A trace is the full lifecycle of a single request. A span is one unit of work inside that trace, such as a guardrail check or a model inference. Spans form a parent and child tree within the trace
Yes. TrueFoundry runs an OpenTelemetry collector backend and can receive traces from any OpenTelemetry compatible SDK. For LLM use cases the docs recommend an LLM focused SDK that captures model specific traces and metrics.



As últimas notícias, artigos e recursos enviados para sua caixa de entrada

















