



October 9, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.


Published: October 9, 2026

Blazingly fast way to build, track and deploy your models!
A página inicial do OpenRouter costumava dizer que ele adiciona cerca de 25 ms entre seus usuários e a inferência, e muitos guias ainda repetem esse número. A página inicial agora diz apenas "latência mínima". No Claude, medimos várias vezes o tempo antes da chegada do primeiro token, e o custo maior vinha depois dele.
As medições são para a Anthropic: quanto o OpenRouter adiciona, para onde vai o tempo e por que nossa própria chave da Anthropic eliminou a maior parte disso. Uma execução usou prompts curtos. A outra usou prompts de até 20.000 tokens. Os limites de ambas as execuções estão na seção sobre o que não testamos, e eles restringem os números tanto quanto as medianas.
Cada solicitação seguiu três caminhos: diretamente para a API da Anthropic, através do OpenRouter cobrado em créditos do OpenRouter e através do OpenRouter usando nossa própria chave da Anthropic (BYOK). Os mesmos prompts foram executados em cada um, intercalados e com a ordem alternada por prompt, para que a variação da rede afetasse todos os três igualmente. Cada comparação é pareada: cada prompt é comparado consigo mesmo em outra rota, de modo que o conteúdo do prompt é anulado na diferença.
As solicitações do OpenRouter foram fixadas no próprio endpoint da Anthropic, em vez do Bedrock ou Vertex, com fallbacks desativados, e verificamos em cada resposta qual endpoint a atendeu e se ela usou nossa chave. A temperatura foi definida como 0 e as conexões foram reutilizadas.
Houve duas execuções. Em 7 de setembro, duas sessões separadas de 100 prompts curtos cada, de 4 a 37 tokens de comprimento, extraídos de conjuntos de dados públicos. Em 14 de setembro, 99 prompts foram ajustados para três tamanhos: 200 tokens de entrada com 100 de saída, 2.000 com 500 e 20.000 com 1.000. Tudo foi executado a partir de um laptop em Wi-Fi doméstico através do edge do OpenRouter em Los Angeles. Isso infla a latência absoluta, portanto, relatamos apenas as diferenças entre as rotas, o que o pareamento torna válido.
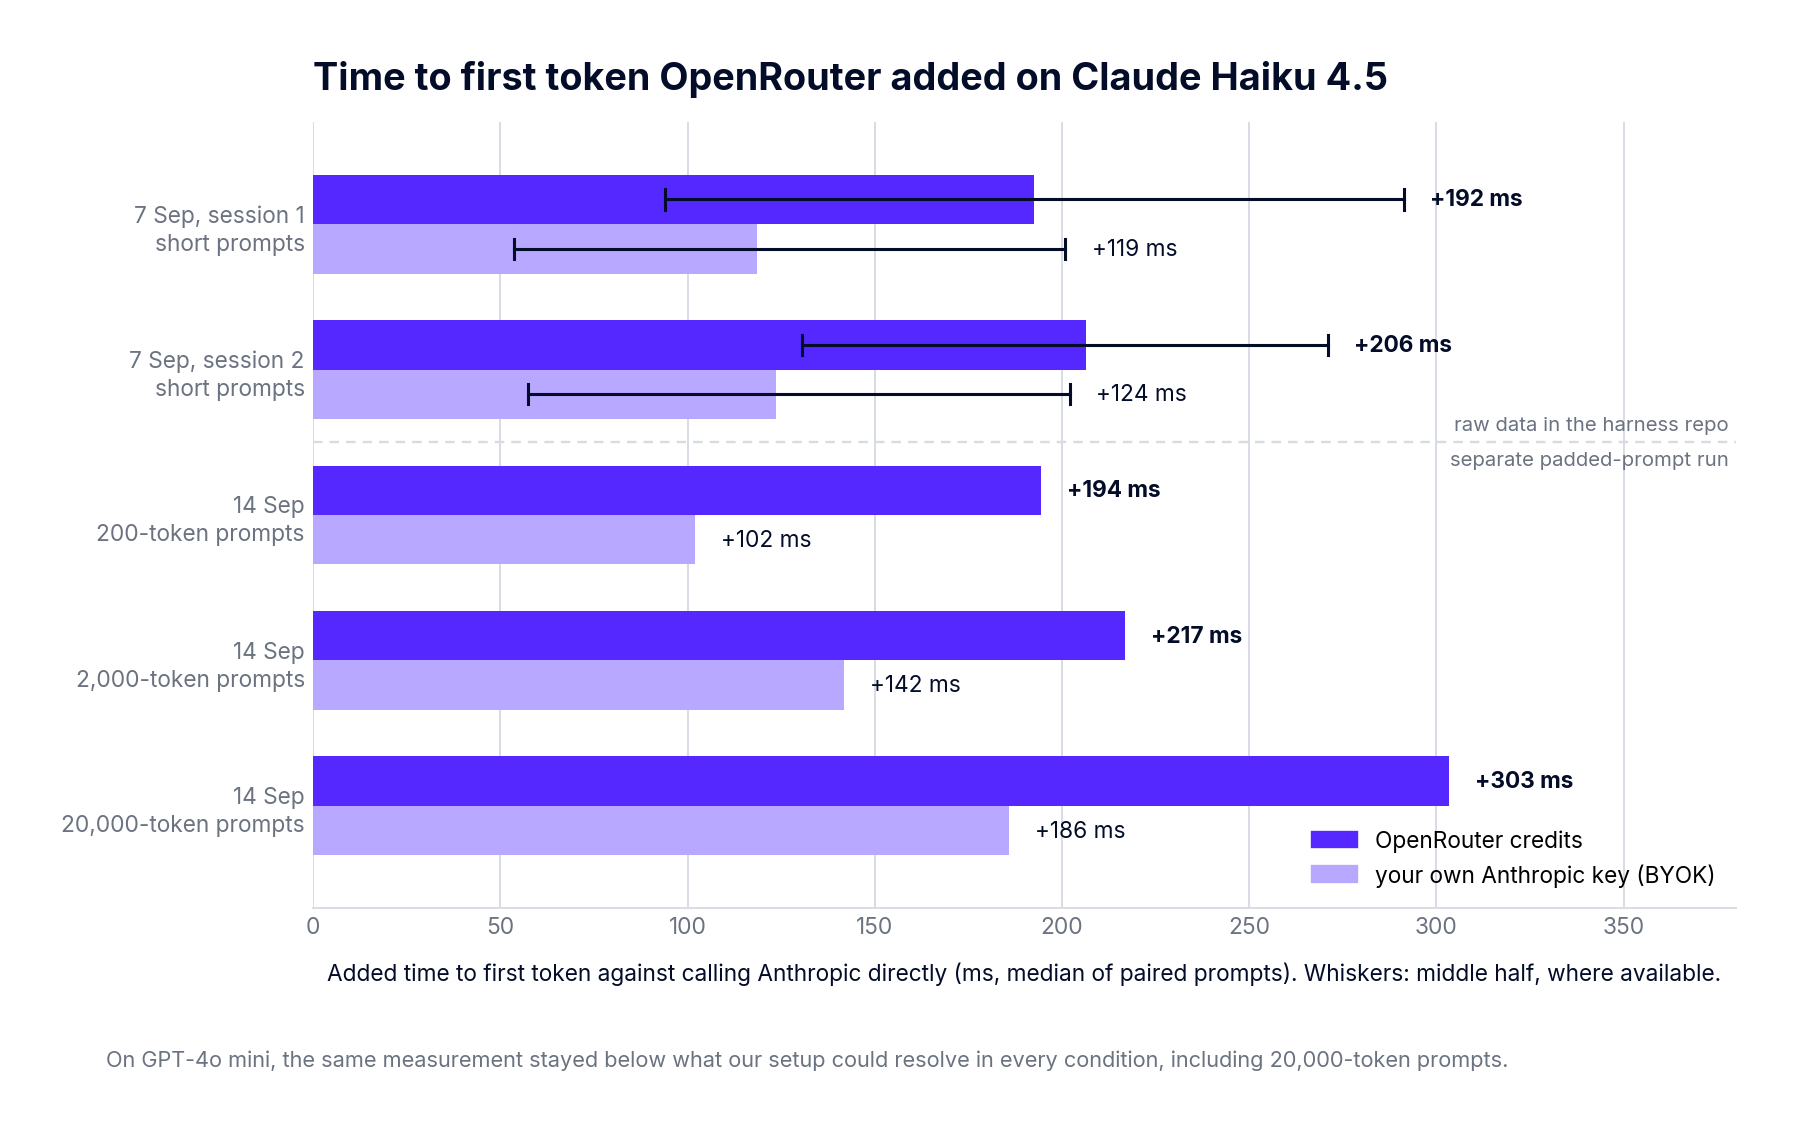
O custo do primeiro token foi estável. Com créditos, foi de 192 ms na primeira sessão e 206 ms na segunda, e 194 ms com 200 tokens uma semana depois. Com nossa própria chave, foi de 119, 124 e 102 ms. Duas execuções com uma semana de intervalo, em conjuntos de prompts diferentes, chegando a uma diferença de cerca de 20 ms entre si, é o máximo de replicação que um teste do lado do cliente pode oferecer. Em quatro sessões onde os créditos e nossa própria chave foram executados lado a lado, os créditos foram mais lentos para o primeiro token todas as vezes, com uma mediana de 50 a 115 ms.
Isso também cresce com o tamanho do prompt. De 200 a 20.000 tokens de entrada, o tempo adicionado até o primeiro token aumentou de 194 para 303 ms com créditos e de 102 para 186 ms com nossa própria chave. O crescimento é sublinear, aproximadamente 1,6 a 1,8 vezes para cem vezes a entrada, e só se tornou visível em 20.000 tokens; uma varredura anterior que parou em 5.000 não encontrou nada. Nas execuções de prompts curtos, onde as entradas variavam apenas de 4 a 37 tokens, não houve relação alguma.
No GPT-4o mini, a mesma medição permaneceu dentro do ruído em todas as condições, incluindo prompts de 20.000 tokens. O tempo mediano adicionado até o primeiro token foi de 19,7 ms com créditos, mas a metade central dos resultados variou de 85 ms mais rápido a 157 ms mais lento do que ir direto, portanto, o valor real é menor do que nossa configuração consegue resolver.
O tempo até o primeiro token é apenas parte de uma resposta transmitida. Dividir cada resposta na espera pelo primeiro token e no tempo para transmitir o restante mostra dois custos separados.
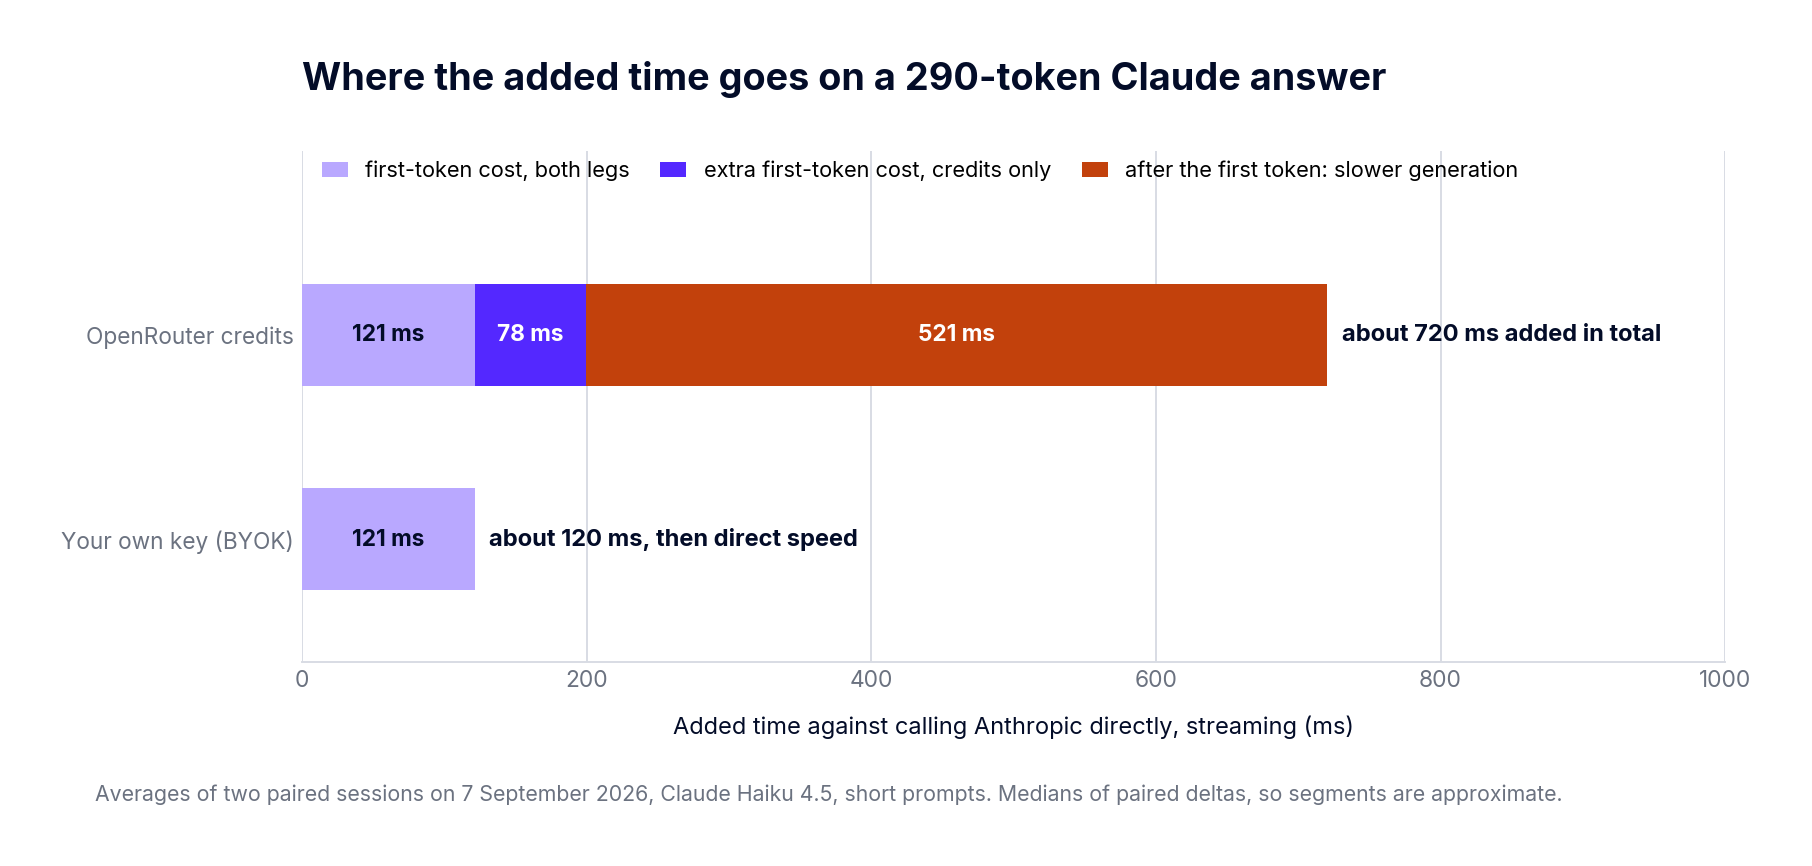
Com nossa própria chave, o OpenRouter adicionou cerca de 120 ms antes do primeiro token e nada depois dele. Nossa chave transmitiu a 115 e 116 tokens por segundo nas duas sessões, contra 115 e 113 indo direto. Seja qual for esse custo, ele é pago uma vez, antecipadamente.
Com créditos, as mesmas respostas foram transmitidas mais lentamente, a 94 e 95 tokens por segundo, cerca de 17% mais lento. As respostas não eram mais longas: a saída mediana era de cerca de 290 tokens em cada rota. Em uma resposta de 290 tokens, essa transmissão mais lenta adiciona cerca de 520 ms, além do custo do primeiro token. A aritmética fecha: 290 tokens a 94 em vez de 114 tokens por segundo dá cerca de 540 ms, mais cerca de 200 ms até o primeiro token, contra os 711 e 730 ms que medimos para a resposta completa.
Essa penalidade de geração foi real em ambas as execuções, mas não do mesmo tamanho. Em 14 de setembro, o tempo extra após o primeiro token foi de aproximadamente 130, 215 e 280 ms para respostas de 100, 500 e 1.000 tokens, muito menor do que em 7 de setembro. Esses números vêm de medianas em vez de diferenças pareadas, portanto, trate-os como aproximados, mas a direção é clara: o custo do primeiro token permaneceu estável ao longo dos dias e tamanhos de prompt, e a penalidade de geração variou.
Os dois custos apontam para duas causas diferentes.
O custo do primeiro token aparece tanto com nossa própria chave quanto com créditos, portanto, pertence ao caminho do OpenRouter para a Anthropic, e não à conta que realiza o pagamento. Os candidatos mais prováveis são o trabalho de traduzir uma solicitação no formato da OpenAI para o formato Messages da Anthropic e traduzir o fluxo de volta, além do caminho de rede da borda do OpenRouter até a Anthropic. O crescimento com o tamanho do prompt se ajusta à primeira hipótese, já que o trabalho de tradução escala com a solicitação. Nossos dados não conseguem separar os dois, e a ausência de qualquer custo mensurável no GPT-4o mini, que não precisa de tradução de formato, é consistente com ambos. Enviar as mesmas solicitações através do endpoint nativo da Anthropic no OpenRouter, /api/v1/messages, é o experimento que resolveria essa questão, e ainda não o realizamos.
A penalidade de geração é diferente. Créditos e nossa própria chave passam pelo mesmo gateway, pela mesma tradução e pelo mesmo endpoint da Anthropic. O que difere é a conta da Anthropic por trás da solicitação: a do OpenRouter, compartilhada entre seus clientes, ou a nossa. Nossa melhor explicação é que as solicitações na conta do OpenRouter foram atendidas com menos capacidade do que as solicitações na nossa, e que o montante varia conforme a demanda, o que também explicaria por que a penalidade diminuiu entre nossas duas execuções. Isso é uma inferência. Nem o OpenRouter nem a Anthropic publicam como as contas são categorizadas em níveis.
Na OpenAI, o padrão se inverteu. No GPT-4o mini, os créditos alcançaram o primeiro token de 23 a 50 ms mais rápido do que nossa própria chave em todas as três sessões em que ambos foram executados, e na sessão em que comparamos a velocidade de streaming, ambos geraram na mesma taxa. A conta que atende sua solicitação afeta a velocidade, e qual conta é mais rápida depende do provedor. Você não consegue ver o nível em que está de fora. Você só pode medi-lo.
O meio da distribuição representa a solicitação típica. As caudas são importantes para trabalhos voltados ao usuário. Nas duas sessões com prompts curtos, o tempo de 95º percentil para o primeiro token foi de cerca de 700 ms indo direto, 950 a 985 ms com créditos e 885 a 905 ms com nossa própria chave. O 99º percentil aumentou muito mais em ambas as rotas do OpenRouter, de cerca de 750 a 765 ms direto para 1,2 a 2,6 segundos com créditos, mas com 100 solicitações por sessão, o 99º percentil é efetivamente a segunda solicitação mais lenta, então interprete isso como um sinal de uma cauda mais pesada, e não como um valor absoluto.
Sem streaming, o cenário é o mesmo. Comparado ao acesso direto, os créditos adicionaram 548 e 629 ms à resposta completa em duas sessões, e nossa própria chave adicionou 42 e 56 ms.
Estes resultados cobrem um modelo, Claude Haiku 4.5, no próprio endpoint da Anthropic. Não testamos o Sonnet ou o Opus, o Claude no Bedrock ou Vertex através do OpenRouter, outras bordas do OpenRouter ou diferentes horários do dia. As execuções com prompts curtos são reproduzíveis a partir do nosso conjunto de testes publicado. A execução com prompt preenchido foi uma sessão separada. Não realizamos uma varredura de simultaneidade nos créditos da Anthropic, que é o teste mais direto da explicação de capacidade compartilhada, ou a /api/v1/messages comparação descrita acima. E tudo foi executado a partir de um único cliente, o que é adequado para verificar diferenças entre rotas, mas não diz nada sobre a latência absoluta da sua infraestrutura.
X-OpenRouter-Experimental-Metadata: enabled e leia openrouter_metadata na resposta, que informa o endpoint de atendimento e se sua própria chave foi usada. Sem isso, você está confiando apenas na configuração.Os limites de taxa são o outro motivo comum pelo qual o Claude parece lento através do OpenRouter, e nossa publicação sobre limites de taxa do OpenRouter explica como diferenciar uma resposta lenta de uma limitada.
O AI Gateway da TrueFoundry é executado em sua própria VPC ou data center e chama a Anthropic diretamente com sua própria chave e contrato, portanto, as solicitações nunca compartilham uma conta upstream com outros clientes e não há um salto de terceiros entre sua rede e o provedor. Nosso número publicado é de aproximadamente 3 a 4 ms de sobrecarga do gateway, processando mais de 350 RPS em uma única vCPU.
Esse número de 3 a 4 ms é o benchmark publicado pela TrueFoundry. Nós não o medimos com o mecanismo por trás desta publicação. Se você quiser comparar gateways, o método pareado acima é como faríamos, e ele funciona com qualquer endpoint compatível com OpenAI, incluindo o nosso.
A latência do OpenRouter na Anthropic ocorre em duas partes. Um custo de primeiro token de aproximadamente 100 a 300 ms que aumenta com o tamanho do prompt e aparece independentemente da conta que você usa e, nos créditos do OpenRouter, uma geração mais lenta que adicionou mais de meio segundo a uma resposta típica em uma execução e menos em outra. Trazer sua própria chave removeu a geração mais lenta em nossos testes e manteve o custo do primeiro token. A única maneira de saber quanto essa espera extra custa em seus prompts é medi-la da maneira que fizemos, pareada.
Para chamar a Anthropic com sua própria chave, a partir de sua própria rede, sem conta upstream compartilhada, veja como o AI Gateway da TrueFoundry se conecta diretamente à Anthropic.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.


It depends on the provider. In our paired testing, the added time to first token on GPT-4o mini was too small to measure, while Claude Haiku 4.5 on OpenRouter credits added about 206 ms, or about 124 ms with our own Anthropic key. OpenRouter itself no longer publishes an overhead figure.
Sim. O gateway é compatível com OpenTelemetry e se integra com Grafana, Datadog, Prometheus ou a sua stack preferida. Ele rastreia cada requisição, do prompt à execução da ferramenta e do modelo, para que você obtenha logs unificados sem precisar remover o que você já usa.
On Anthropic it did in our tests: our own key added about 120 ms to the first token against about 200 ms on credits, and then streamed at direct speed. On OpenAI, credits was slightly faster. Which route is faster depends on the provider and the account behind it.
Sim. O gateway é compatível com OpenTelemetry e exporta traces para backends externos, e é assim que os dados do gateway chegam a plataformas como Braintrust, Langfuse ou Arize. O TrueFoundry em si não executa jobs de pontuação offline.



As últimas notícias, artigos e recursos enviados para sua caixa de entrada
















