


novembro 21, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.


Blazingly fast way to build, track and deploy your models!
Cinco provedores de modelos significam cinco SDKs, cinco chaves de API, cinco faturas e cinco conjuntos de limites de taxa (rate limits). O OpenRouter reduz tudo isso a um único endpoint. Aponte o SDK da OpenAI para um URL base diferente, altere a string do modelo e o mesmo cliente poderá chamar Claude, Gemini, Llama ou DeepSeek.
Isso é o que está em todo guia de início rápido. Por baixo dos panos, o OpenRouter é um marketplace. Ele escolhe qual empresa atende cada requisição, guarda seu dinheiro e paga os provedores. Rastreamos o que acontece entre o seu código e o modelo, com números de nossos próprios testes onde os temos disponíveis.
O OpenRouter é uma API HTTP hospedada que roteia requisições de inferência para provedores de modelos terceirizados por meio de um único endpoint e credencial, cobrando por padrão pelo uso do modelo. Ele aceita três formatos de requisição: OpenAI Chat Completions, a OpenAI Responses API e a Messages API da Anthropic em /api/v1/messages. Existem SDKs de cliente para TypeScript, Python e Go, mas eles são apenas uma camada tipada sobre a mesma API REST, então o SDK padrão da OpenAI com um baseURL alterado funciona igualmente bem.
O OpenRouter possui dois lados. De um lado, ele recruta provedores, define o contrato com o qual eles se integram e os paga. Do outro, ele mantém seus créditos pré-pagos e consolida o faturamento entre todos eles. Ele se posiciona no seu fluxo de pagamento e também no seu fluxo de requisições, o que o torna conveniente — e é também a razão pela qual deixá-lo exige mais do que apenas alterar um URL.
Você está alugando o acesso a modelos de outras empresas. Não existe uma versão auto-hospedada (self-hosted) ou isolada (air-gapped) do OpenRouter, e o produto principal é de código fechado. Os SDKs e as documentações são públicos. Ele começou como Window, uma extensão do Chrome para usar vários modelos ao mesmo tempo, e desde então adicionou ferramentas no lado do servidor, como busca na web, coleta de dados na web (web fetch) e execução de shell em ambiente isolado (sandbox) que os modelos podem chamar no meio de uma requisição.
Uma requisição passa pelas seguintes etapas:
https://openrouter.ai/api/v1 com uma única chave de API, em qualquer um dos três formatos.vendor/model, é resolvida para uma lista de endpoints de provedores que atendem a esse modelo.sort, order, only e políticas de dados se sobrepõem a isso.attempt na resposta é o único sinal in-band de que isso aconteceu.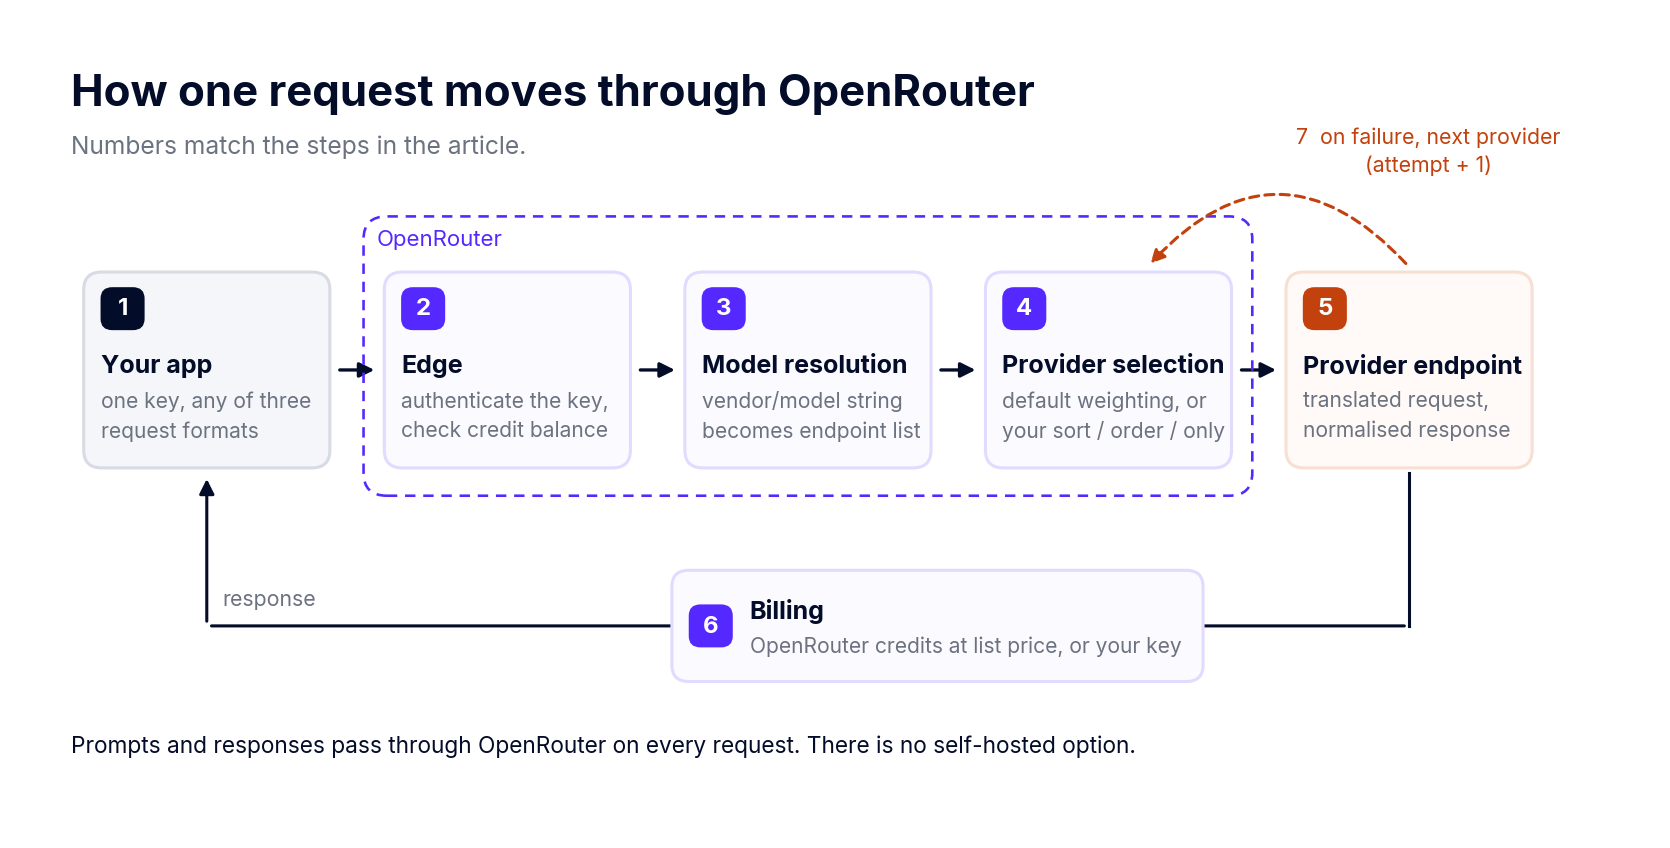
A string do modelo não diz quem está executando o modelo. O prefixo do fornecedor indica de quem é o modelo, não em quais servidores ele está. Quando testamos o anthropic/claude-3-haiku, ele estava sendo servido pelo Amazon Bedrock.
Para modelos de pesos abertos (open-weight), essa diferença é ainda maior. Em 5 de outubro, a API do OpenRouter listava 11 endpoints para o meta-llama/llama-3.3-70b-instruct. Entre esses 11:
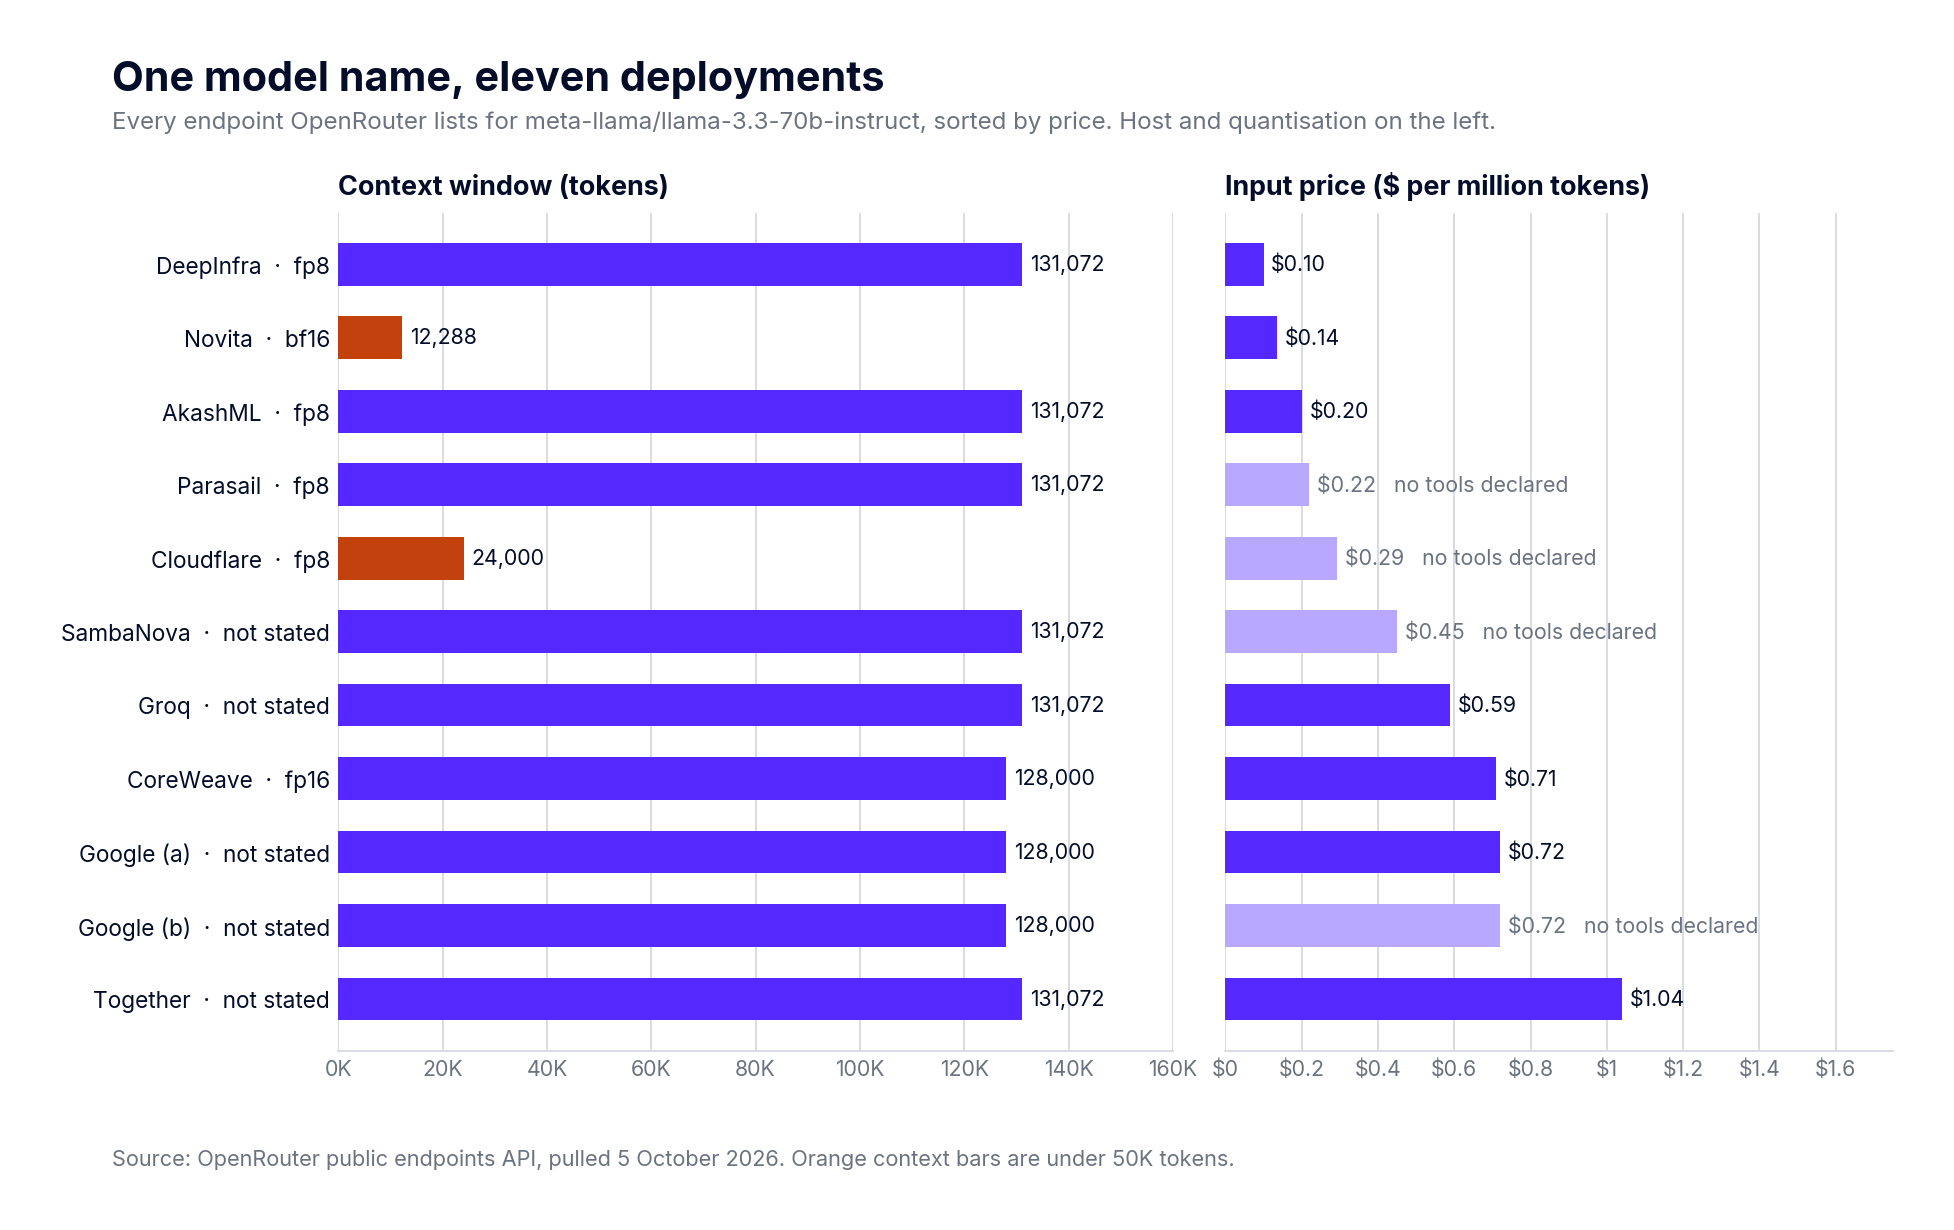
Mesmo nome, produtos materialmente diferentes. Se seus prompts forem longos, o endpoint de 12K e o de 131K não são intercambiáveis, e o roteador padrão escolhe parcialmente com base no preço. O OpenRouter filtra por capacidade quando uma requisição precisa: quando enviamos oito requisições com tool_choice: required e sem fixação de provedor, todas caíram em um host que declara suporte a ferramentas. Mas declarar não é o mesmo que funcionar. Um host que declara suporte a ferramentas não retornou nenhuma chamada de ferramenta quando nos fixamos a ele e forçamos uma.
Leia o /api/v1/models/{model}/endpoints antes de confiar em uma string de modelo, e fixe ou filtre provedores sempre que a quantização, o tamanho do contexto ou o comportamento de ferramentas forem importantes.
A API do OpenRouter listava 466 modelos em 65 namespaces de fornecedores em 5 de outubro, em comparação aos 428 de quando os dados foram coletados pela primeira vez em 8 de setembro. Os modelos de embedding ficam em um endpoint separado, /api/v1/embeddings/models, que listava mais 33. Adicione esses e você estará perto dos "500+ modelos" da página de preços do OpenRouter. A contagem de provedores bate com menos precisão: o endpoint de provedores retornou 112 entradas, uma delas chamada FakeProvider, em comparação com "80+" no marketing. Consulte a API em vez de confiar na contagem de um post de blog, incluindo este.
A rota padrão distribui o tráfego. Ela não otimiza para preço ou velocidade. No nosso teste de setembro com o Llama 3.3 70B, com oito requisições por estratégia, o padrão foi a opção mais lenta, com uma mediana de 935 ms, e custou o dobro do sort: price. O sort: throughput foi o mais rápido com 289 ms, à frente do sort: latency com 347 ms, e as estratégias mais barata e mais cara tiveram uma diferença de 10x para o mesmo prompt. Oito requisições são suficientes para mostrar que as diretivas funcionam e diferem. É uma amostra muito pequena para ranquear hosts. Se o custo ou a velocidade forem importantes para você, defina uma ordenação.
Dois detalhes sobre fallbacks. Um slug de provedor com erro de digitação em order é descartado silenciosamente em vez de rejeitado, de modo que um erro de digitação apenas estreita sua lista. E, conforme observado acima, o attempt é o único sinal de que um fallback foi ativado.
O SDK da OpenAI funciona diretamente como substituto (drop-in), e para a maioria do tráfego de chat isso é tudo o que importa. Os casos de borda são parâmetros que uma rota específica não suporta, os quais tendem a ser aceitos com um status 200 e não aplicados. Enviamos o parâmetro prediction da OpenAI para o GPT-4o mini, que declara suporte para ele, e recebemos uma resposta normal sem nenhum sinal de que ele tenha surtido efeito. Se um parâmetro altera sua saída ou sua fatura, verifique a resposta em busca de evidências de que ele funcionou.
Você paga o preço de tabela do provedor por token. O OpenRouter não adiciona uma margem de lucro sobre isso. Sua receita vem de uma taxa quando você compra créditos: 5,5% no plano Standard com um mínimo de $0,80, 8% no Business e 5% para cripto. Com sua própria chave de provedor, os primeiros $25.000 por mês de uso a preço de tabela não possuem taxa, e 5% após isso. Os créditos podem expirar um ano após a compra. Os preços mudaram duas vezes em quatorze meses, portanto, verifique a página de preços do OpenRouter antes de modelar os custos. A nossa análise detalhada dos preços do OpenRouter vai mais além.
Prompts e respostas sempre passam pelo OpenRouter. Você não pode executar o serviço por conta própria ou mantê-lo isolado (air-gapped). Os controles disponíveis no serviço hospedado são o roteamento sem retenção de dados, um filtro data_collection: "deny" que só roteia para provedores que não coletam seus dados e o roteamento regional (in-region). O roteamento regional costumava exigir um contrato Enterprise. Desde setembro, ele está disponível no plano self-serve Business: envie requisições para eu.openrouter.ai ou us.openrouter.ai e elas serão processadas apenas nessa região, falhando com erro se nenhum endpoint regional existir. As concessões documentadas: os logs de prompt e resposta do próprio OpenRouter são ignorados em endpoints regionais, e as ferramentas de Batch, busca na web, shell isolado, arquivos e imagens, além do Auto Router, não estão disponíveis lá.
Ambos são abordados em seus próprios posts. O artigo sobre limites de taxa do OpenRouter explica por que o limite para modelos gratuitos depende do valor que você pagou, e o artigo sobre prompt caching no OpenRouter explica por que o mesmo recurso de caching tem nove preços diferentes.
A documentação do OpenRouter diz que ele roda na borda para manter o overhead mínimo. Sua página inicial costumava definir um número para isso, em torno de 25 ms, e muitos guias ainda repetem esse valor. Desde 5 de outubro, a página inicial diz apenas "latência mínima". A documentação adiciona um detalhe: quando seu saldo de créditos fica baixo, o OpenRouter expira seus caches de borda de forma mais agressiva para manter o faturamento preciso, o que adiciona latência até que você faça uma recarga.
Nós medimos isso. Os mesmos 100 prompts foram enviados de três maneiras: diretamente para o provedor, pelo OpenRouter com créditos e pelo OpenRouter com a nossa própria chave de provedor. As requisições foram intercaladas e pareadas por prompt, de modo que o conteúdo do prompt é cancelado na diferença, e cada uma foi fixada no provedor oficial do modelo e verificada por requisição.
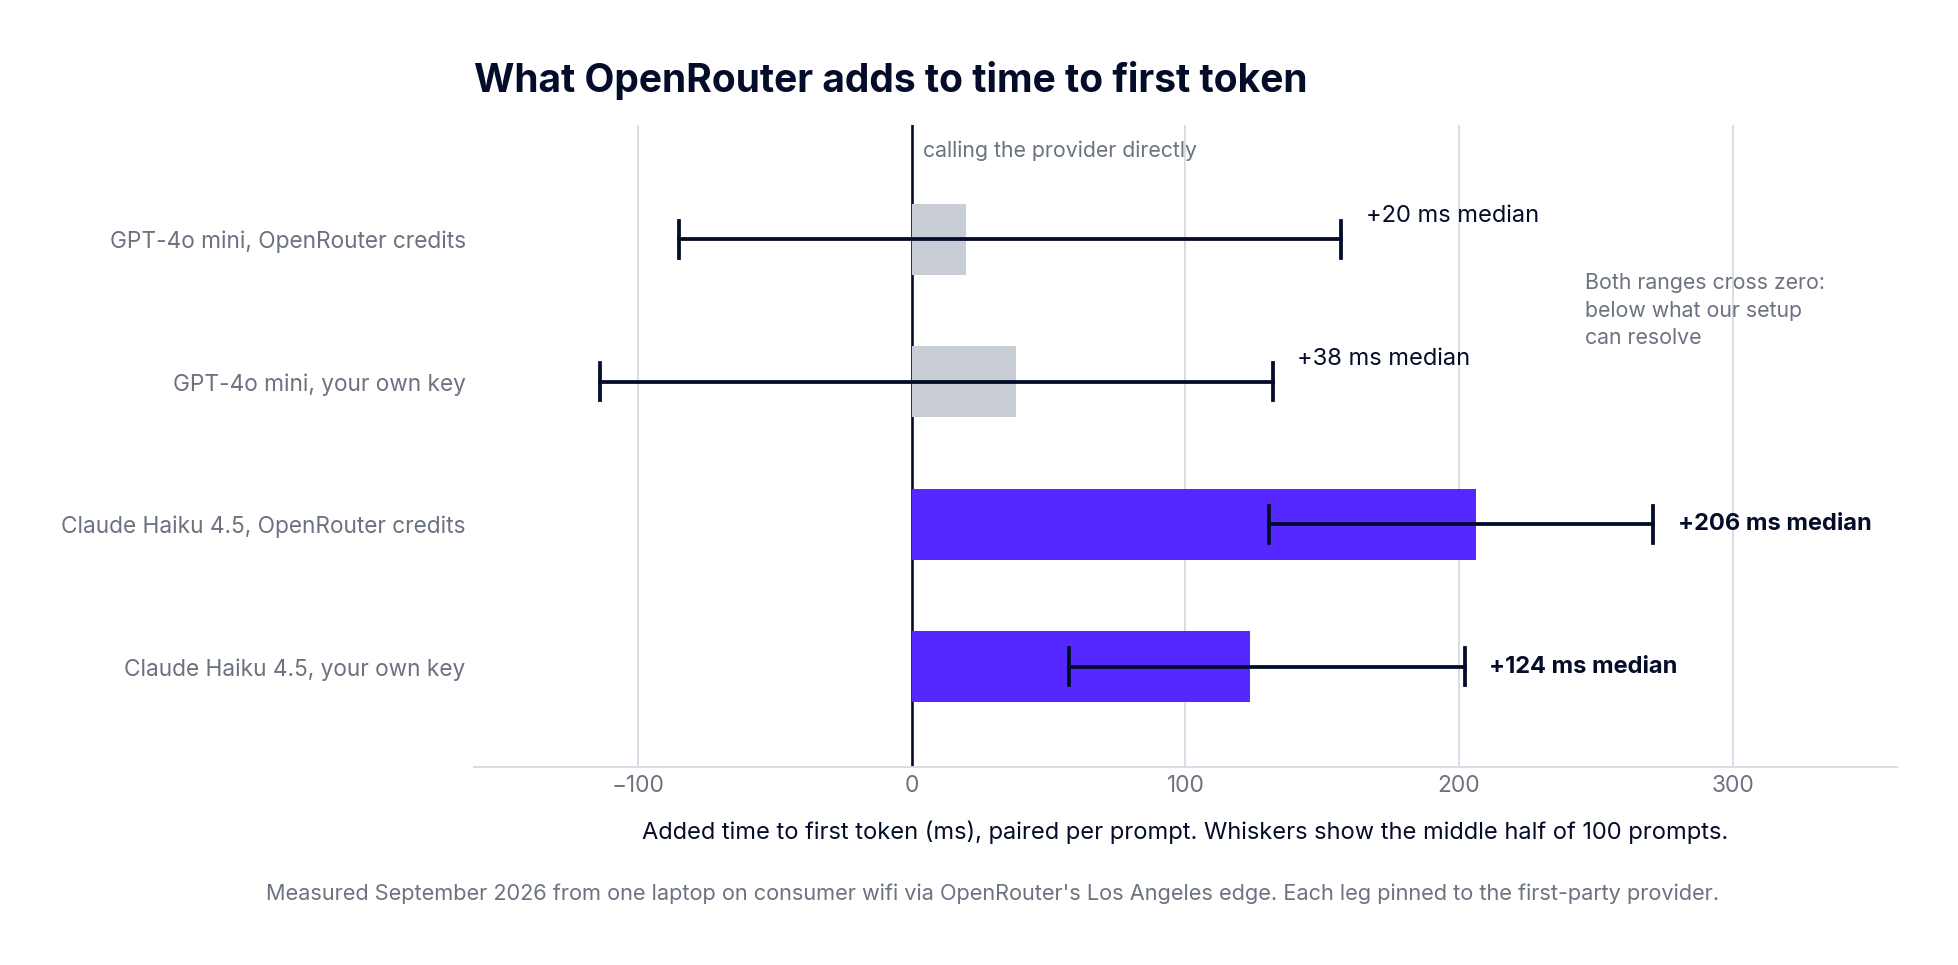
No GPT-4o mini não conseguimos medir nenhum overhead. A mediana do tempo adicionado até o primeiro token foi de 19,7 ms com créditos, mas o intervalo interquartil variou de 85 ms mais rápido a 157 ms mais lento, de modo que a taxa real está abaixo do que nossa estrutura consegue resolver. No Claude Haiku 4.5 foi inequívoco: 206 ms adicionados com créditos e 124 ms com nossa própria chave, com o intervalo interquartil bem acima de zero. Sem streaming, em duas execuções, os créditos adicionaram 837 e 883 ms à resposta completa, enquanto nossa própria chave permaneceu dentro de 42 ms em relação à chamada direta.
Os créditos e sua própria chave passam pelo mesmo gateway e pela mesma tradução, portanto o que difere é a conta upstream. Nossa melhor explicação — e trata-se de uma inferência — é a contenção na capacidade compartilhada da Anthropic no OpenRouter. Em um provedor com tráfego intenso, usar sua própria chave reduz a latência, além de fornecer controle de faturamento.
Tudo isso foi executado a partir de um laptop em um Wi-Fi residencial através do endpoint do OpenRouter em Los Angeles, em setembro de 2026. Considere as diferenças como reais e os números absolutos como específicos da nossa estrutura de teste.
O OpenRouter foi fundado em 2023 por Alex Atallah, anteriormente cofundador do OpenSea. Em 19 de agosto de 2026, a Stripe anunciou um acordo para adquiri-lo. Até o início de outubro, a transação não havia sido reportada como concluída, e nenhuma das empresas divulgou o valor; relatos da imprensa estimam acima de US$ 7 bilhões. O OpenRouter declarou que seu produto e compromissos não mudarão.
A receita do OpenRouter vem de uma taxa sobre pagamentos, seus preços serão definidos por uma empresa de pagamentos e sua neutralidade entre provedores é um compromisso declarado, e não algo embutido em sua estrutura. Uma equipe prestes a construir sobre ele pelos próximos dois anos deve incluir isso na avaliação, ao lado dos números de roteamento e latência, antes de decidir.
O OpenRouter é comparado com LLM gateways como o LiteLLM ou o nosso. Ambos colocam uma única API à frente de vários modelos. São produtos diferentes. Nossa explicação sobre o que é um LLM gateway cobre a ideia geral.
Duas linhas precisam de uma breve explicação. O plano de controle e o plano de dados do OpenRouter são o mesmo sistema, portanto, quando ele está fora do ar, tudo o que está atrás dele também fica. O blog de engenharia da própria empresa descreve uma queda no banco de dados de aproximadamente 50 minutos em agosto de 2025 que interrompeu o roteamento, argumentando que a disponibilidade agregada ainda supera a de qualquer provedor individual; em nossos próprios testes em cerca de 4.300 requisições, não vimos um único erro 4xx ou 5xx. E sobre identidade: as chaves pertencem ao membro que as criou, e desativar essa pessoa via SCIM desativa suas chaves — o que é o padrão correto para pessoas, mas inconveniente para cargas de trabalho de produção.
O OpenRouter é ideal para prototipagem entre vários modelos, quando você deseja uma única chave e uma única fatura e prefere não fechar um contrato com cada provedor que testar. Ele também é ideal para modelos de pesos abertos (open-weight), nos quais escolher o host pelo preço ou pela capacidade de processamento (throughput) gera economias reais, desde que seus prompts possam sair da sua rede, com ou sem restrição regional.
Ele não é indicado quando os prompts precisam permanecer na sua rede, quando as cargas de trabalho exigem identidades de máquina em vez de chaves associadas a pessoas, ou quando é inaceitável que a queda de um único fornecedor tire todos os modelos do ar. O mesmo se aplica se a latência for crítica em um provedor concorrido e você não puder usar sua própria chave, ou se a equipe de compras exigir contratos diretos com cada provedor de qualquer maneira.
O TrueFoundry AI Gateway roda na sua VPC, on-premises ou em ambiente isolado (air-gapped), e chama os provedores diretamente com seus próprios contratos e chaves. Ele expõe mais de 1.000 LLMs por meio de uma API compatível com a OpenAI, adiciona cerca de 3 a 4 ms de overhead e suporta mais de 350 RPS em uma única vCPU.
Você pode manter o OpenRouter nessa estrutura. Ele é suportado como um provedor no TrueFoundry, de modo que o catálogo continua disponível para experimentos enquanto seus próprios limites de taxa, orçamentos, controle de acesso e logs ficam posicionados à frente dele. Para equipes que já usam o OpenRouter, esse costuma ser o primeiro passo de menor risco.
O OpenRouter é uma API única à frente de um marketplace. Ele escolhe quem atende cada requisição, guarda seus créditos e paga os provedores. Antes de tratar uma string de modelo como um produto estável, consulte a lista de endpoints, defina uma ordenação de roteamento e meça o overhead nos provedores que você realmente utiliza.
Se você deseja essa API única dentro da sua própria infraestrutura, veja como o TrueFoundry AI Gateway funciona.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



OpenRouter is a hosted, OpenAI-compatible API that gives you access to hundreds of AI models from many providers through one endpoint and one API key. It picks which provider serves each request, bills you at the provider's list price, and charges a fee when you buy credits. You cannot run it yourself, so prompts always pass through OpenRouter's infrastructure.
Partly. OpenRouter offers free variants of some models, capped at 20 requests per minute and 50 requests per day, rising to 1,000 a day once you've bought at least 10 credits. Paid models are billed at the provider's list price, plus a fee on each credit purchase. Our post on OpenRouter rate limits has the detail.
It depends on the provider. In our paired testing, the added time to first token on GPT-4o mini was too small to measure, while Claude Haiku 4.5 on OpenRouter credits added about 206 ms, or about 124 ms with our own Anthropic key. OpenRouter itself no longer publishes an overhead figure.
Sim. O TrueFoundry é executado na sua VPC, on-prem, em ambiente air-gapped ou híbrido, de modo que os prompts e as respostas nunca saem do seu domínio, mesmo quando você roteia entre muitos provedores.



As últimas notícias, artigos e recursos enviados para sua caixa de entrada














