Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.
9,9
Mapeando o mercado de AI On-Premise: Das placas de vídeo aos planos de controle
À medida que as empresas levam a GenAI para a produção, muitas estão redescobrindo os benefícios das implantações on-premise — seja para conter os custos de nuvem, atender a requisitos rigorosos de conformidade ou oferecer latência ultrabaixa. No entanto, uma stack de AI on-premise não é um equipamento único que você pode instalar no rack e esquecer. Trata-se de um ecossistema em camadas de hardware, orquestração, plataformas de dados e frameworks de servimento que devem funcionar todos em harmonia.
Este guia detalha cada camada da stack moderna de AI on-premise e apresenta a proposta de valor de cada componente.
Por que a AI On-Premise está ganhando força
Empresas dos setores financeiro, de saúde, manufatura e governamental estão enfrentando regulamentações de soberania de dados mais rígidas, faturas de nuvem crescentes e SLAs de desempenho que a nuvem pública nem sempre consegue atender. Juntas, essas camadas formam a base de uma plataforma de AI on-premise que as empresas podem dimensionar, governar e operar independentemente das restrições da nuvem pública.
Controle de Dados e Conformidade: Mantenha dados confidenciais totalmente atrás do seu firewall. Quando os dados são enviados para uma nuvem pública, sua localização física exata e a jurisdição legal à qual estão sujeitos podem se tornar ambíguas, criando riscos significativos de conformidade e complicando auditorias. Uma configuração on-premise permite que uma organização adapte toda a sua stack de AI para cumprir essas regulamentações, fornecendo uma estrutura defensável que adere aos padrões legais e evita as complexidades das transferências transfronteiriças de dados.
Desempenho e Latência: Co-localize computação e armazenamento para inferência em tempo real. Ao processar dados localmente, a AI on-premise pode oferecer uma latência significativamente menor e, mais importante, mais previsível. Esse desempenho consistente e de alto throughput é essencial para aplicações que exigem tomada de decisão instantânea e cross-modal, como analisar um fluxo de dados de sensores ao mesmo tempo em que os cruza com registros históricos. Essa vantagem de desempenho se estende à integração com sistemas empresariais existentes. As soluções on-premise, devido à sua flexibilidade e capacidade de personalização, muitas vezes podem ser integradas de forma mais fácil e confiável com bancos de dados legados, sistemas ERP e outras tecnologias operacionais que podem não ser compatíveis com ambientes de nuvem padronizados.
Previsibilidade de Custos: Transição de tarifas variáveis no modelo pay-as-you-go para investimentos fixos em infraestrutura. Taxas ocultas de saída de dados (egress), chamadas de API, níveis de armazenamento e oscilações nos preços de computação podem corroer rapidamente os benefícios iniciais do baixo CapEx, levando ao que algumas análises chamam de "puro desperdício" nos gastos com nuvem. Em contrapartida, uma implantação on-premise, apesar do alto custo inicial, oferece um OpEx de longo prazo previsível e gerenciável. Para organizações com uso contínuo de AI, a infraestrutura on-premise frequentemente se mostra a opção mais econômica em um horizonte de três a cinco anos.
Integração Personalizada: Conecte-se perfeitamente a sistemas legados, dispositivos de borda ou hardware proprietário.
No entanto, construir e operar essa stack internamente traz despesas de capital, exigência de talentos especializados e custos contínuos de manutenção.
O que é uma stack moderna de AI On-Premise?
Uma stack moderna de AI on-premise é um sistema complexo e multicamadas em que cada componente desempenha um papel crucial. Não se trata de uma entidade monolítica, mas de um ecossistema interdependente de hardware e software projetado para fornecer recursos de AI robustos, escaláveis e eficientes. Compreender essa stack exige uma desconstrução camada por camada, desde a infraestrutura física que fornece a capacidade bruta de processamento até as plataformas de alto nível que viabilizam o fluxo de trabalho de AI.
Cada camada deve ser arquitetada para maximizar a utilização, garantir a confiabilidade e permitir o escalonamento contínuo — sem prender você a um único fornecedor.
Hardware e Infraestrutura Física
Esta é a base de toda a stack de AI, a manifestação física do poder computacional. Ela compreende os motores de computação que realizam os cálculos, os sistemas de armazenamento que guardam os vastos conjuntos de dados e a estrutura de rede que conecta tudo. O desempenho e as limitações desta camada ditam o potencial de todas as camadas subsequentes.
Motores de Computação
GPUs: Originalmente projetadas para renderização de gráficos 3D, as GPUs se tornaram a força de trabalho da revolução da AI devido à sua arquitetura massivamente paralela. A NVIDIA estabeleceu uma posição dominante nesse mercado com suas GPUs para data centers, como as séries A100, H100 e a futura B200. Esses chips, equipados com milhares de núcleos especializados (ex.: Tensor Cores), podem oferecer um desempenho para treinamento de AI até 20 vezes mais rápido do que os CPUs tradicionais. Eles são o padrão de fato atual para a construção de clusters de treinamento de AI on-premise de alto desempenho.
CPUs: Embora as GPUs liderem o processamento paralelo pesado, os CPUs permanecem como componentes essenciais do servidor de AI. Eles gerenciam as operações gerais do sistema, lidam com tarefas de processamento sequencial e orquestram o fluxo de dados de e para as GPUs. A geração mais recente de CPUs multi-core da Intel e da AMD fornece a capacidade computacional de uso geral necessária para dar suporte aos aceleradores especializados.
ASICs/TPUs: A tendência emergente e disruptiva na computação de AI é o avanço dos Circuitos Integrados de Aplicação Específica (ASICs). Trata-se de chips projetados do zero para uma única finalidade: executar cargas de trabalho de AI. As Tensor Processing Units (TPUs) do Google são um excelente exemplo, otimizadas para as operações matriciais no coração das redes neurais. No mercado on-premise, uma nova classe de startups está desafiando o monopólio das GPUs com ASICs especializados. Empresas como a Groq estão desenvolvendo chips para inferência de ultrabaixa latência, enquanto a SambaNova Systems e a Cerebras estão criando arquiteturas inovadoras (Reconfigurable Dataflow Units e Wafer-Scale Engines, respectivamente) que prometem maior TCO e eficiência energética para treinamento e inferência em larga escala. Esses aceleradores especializados representam o futuro do hardware de AI, oferecendo um caminho além das limitações de energia e custo das GPUs de uso geral.
Servidores Empresariais e Armazenamento
Servidores de Alto Desempenho: Os principais fornecedores de hardware empresarial, como a Hewlett Packard Enterprise (HPE) com suas linhas ProLiant e Apollo, a Dell Technologies com seus servidores PowerEdge, a Supermicro e a IBM com seus Power Systems, fornecem os chassi de servidores para AI on-premise. Eles não são servidores comuns; são especificamente projetados para acomodar múltiplas GPUs de alta potência, fornecer grandes quantidades de memória de alta velocidade (RAM) e incorporar soluções avançadas de refrigeração para lidar com a dissipação térmica dos aceleradores.
Armazenamento de Alto Desempenho: A AI é alimentada por dados, e a camada de armazenamento deve fornecer acesso rápido e concorrente a conjuntos de dados massivos sem criar gargalos. Isso exige ir além do armazenamento tradicional. Soluções de armazenamento de alto desempenho e baixa latência, como SSDs NVMe (Non-Volatile Memory Express) e sistemas de arquivos distribuídos, são essenciais. Os dados em si são normalmente organizados em data lakes para armazenar grandes quantidades de dados brutos e não estruturados (imagens, textos, logs) e data warehouses para dados estruturados e prontos para análise. Um componente emergente crítico, especialmente para a AI generativa, é o banco de dados vetorial, otimizado para armazenar e consultar embeddings vetoriais de alta dimensão que representam dados não estruturados.
Redes de Alta Velocidade
Estruturas InfiniBand e RDMA oferecem throughput de baixa latência de até 400 Gbps, garantindo que as GPUs permaneçam alimentadas com dados durante o treinamento distribuído ou a inferência paralela. A camada de rede é o "sistema nervoso" do data center de AI, responsável pela transferência fluida de dados entre os sistemas de armazenamento e os nós de computação. Para AI em larga escala, particularmente no treinamento distribuído em que um único modelo é treinado em centenas ou milhares de GPUs, a rede Ethernet padrão é insuficiente e pode se tornar um grande gargalo de desempenho. Para evitar que GPUs potentes fiquem ociosas aguardando dados, os clusters de AI on-premise dependem de estruturas de rede de alta largura de banda e baixa latência. Tecnologias como InfiniBand e RDMA (Remote Direct Memory Access) são críticas. O InfiniBand, por exemplo, pode suportar um throughput de até 400 gigabits por segundo, garantindo que os dados sejam movidos entre servidores e armazenamento na velocidade necessária para manter os motores de computação totalmente utilizados. Essa interconexão de alta velocidade é um componente indispensável de qualquer infraestrutura séria de AI on-premise.
A Camada de Orquestração e Gerenciamento
Situada acima do hardware físico, a camada de orquestração e gerenciamento consiste no software que abstrai, particiona e gerencia os recursos subjacentes. Essa camada transforma uma coleção rígida de servidores físicos em uma plataforma flexível, escalável e eficiente para o desenvolvimento e a execução de aplicações de AI.
O Papel da Virtualização e da Containerização
As tecnologias fundamentais para o gerenciamento de recursos são a virtualização e a containerização. Elas permitem o particionamento e o isolamento eficientes das cargas de trabalho.
Máquinas Virtuais (VMs): A virtualização tem sido a base dos data centers por décadas. Um hipervisor cria múltiplas máquinas virtuais em um único servidor físico, cada uma com seu próprio sistema operacional completo. Embora robustas e bem compreendidas, as VMs possuem um footprint de recursos maior e tempos de inicialização mais lentos em comparação aos contêineres. No entanto, elas permanecem relevantes, especialmente para modernizar aplicações legadas ao lado de novas cargas de trabalho de AI. Plataformas como IBM Fusion e Vates VMS são projetadas especificamente para fornecer uma plataforma on-premise unificada capaz de gerenciar VMs e contêineres, frequentemente com recursos como acesso direto à GPU.
Contêineres (ex.: Docker): A containerização é a abordagem moderna e leve para o isolamento de cargas de trabalho. Um contêiner empacota uma aplicação e todas as suas dependências (bibliotecas, arquivos de configuração) em uma unidade única e portátil que compartilha o kernel do sistema operacional do host. Isso resulta em um footprint muito menor, tempos de inicialização mais rápidos e maior eficiência de recursos do que as VMs. Para a AI, isso significa que um modelo e seu ambiente específico podem ser encapsulados em uma imagem de contêiner imutável. Essa imagem pode ser implantada de forma consistente no laptop de um desenvolvedor, em um servidor de testes e no cluster de produção, eliminando o problema do "funcionava na minha máquina" e garantindo a reprodutibilidade.
Kubernetes: O Sistema Operacional do Data Center de AI
Enquanto o Docker fornece o formato do contêiner, o Kubernetes fornece o gerenciamento em escala. O Kubernetes é uma plataforma open-source que automatiza a implantação, o escalonamento, a rede e o gerenciamento de aplicações containerizadas em um cluster de máquinas. Ele se tornou o padrão indiscutível para orquestração de contêineres e é o motor por trás da maioria das aplicações cloud-native modernas, seja na nuvem pública ou on-premise.
Para a AI on-premise, o Kubernetes é o elo crítico entre a camada de aplicação e o hardware. Distribuições do Kubernetes de nível empresarial, como o Red Hat OpenShift, são projetadas especificamente para implantações on-premise e de nuvem híbrida, fornecendo a segurança, o gerenciamento e o suporte de que as empresas precisam.
Os benefícios de usar o Kubernetes para cargas de trabalho de AI são profundos:
Escalonamento Automático e Balanceamento de Carga: O Kubernetes pode aumentar ou diminuir automaticamente o número de réplicas de contêineres com base na demanda computacional e distribuir requisições de inferência entre elas, garantindo alta disponibilidade e desempenho.
Gerenciamento de Recursos e Agendamento: O Kubernetes possui recursos de agendamento conscientes de GPU, permitindo que ele aloque inteligentemente cargas de trabalho de AI em nós que possuem o hardware acelerador necessário disponível, maximizando a utilização desses recursos caros.
Resiliência e Auto-recuperação: Se um contêiner ou nó falhar, o Kubernetes pode reiniciá-lo automaticamente ou reagendá-lo em um nó saudável, fornecendo a resiliência necessária para tarefas de treinamento de modelos de longa duração e serviços de inferência críticos para a missão.
Em essência, o Kubernetes fornece o sistema operacional dinâmico, automatizado e resiliente para o data center de AI on-premise.
Capacitação de Dados e ML
Plataformas de Dados e Governança
Esta é a camada de software mais alta da stack, contendo as ferramentas e plataformas especializadas que cientistas de dados e engenheiros de machine learning usam para executar o ciclo de vida ponta a ponta da AI. Essa camada aproveita o hardware e a orquestração subjacentes para gerenciar dados e para construir, treinar, implantar e monitorar modelos de AI.
A Data Fabric (Plataformas de Dados)
Antes que qualquer modelo possa ser construído, os dados devem ser gerenciados. As plataformas de dados fornecem um ambiente unificado para todo o ciclo de vida dos dados, desde a ingestão e processamento até o armazenamento e governança.
Cloudera Data Platform (CDP): Um player dominante no cenário de dados on-premise e híbrido, a Cloudera evoluiu de suas raízes no ecossistema Hadoop para se tornar uma plataforma de dados empresarial abrangente. A oferta CDP Private Cloud é projetada especificamente para rodar on-premise, geralmente sobre um cluster Kubernetes como o Red Hat OpenShift. Ela fornece uma arquitetura unificada de open data lakehouse que pode lidar com dados estruturados e não estruturados em escala de petabytes. De forma crítica para a AI empresarial, ela integra segurança robusta e centralizada por meio do Apache Ranger e uma estrutura unificada de governança e metadados chamada Shared Data Experience (SDX), garantindo a aplicação de políticas de segurança consistentes a todos os dados e análises no ambiente híbrido.
Databricks e Conectividade Híbrida: Embora o Databricks seja primariamente uma plataforma cloud-native, sua relevância no espaço de AI faz com que muitas organizações construam soluções para conectar suas fontes de dados on-premise, como um cluster Cloudera, ao seu ambiente Databricks. Essa realidade reforça a natureza híbrida da AI empresarial moderna, onde a gravidade dos dados frequentemente exige manter grandes conjuntos de dados on-premise enquanto se aproveitam ferramentas baseadas na nuvem para certas análises ou tarefas de colaboração.
MLOps e Experimentação
MLOps (Machine Learning Operations) é um conjunto de práticas que visa implantar e manter modelos de machine learning em produção de forma confiável e eficiente. As plataformas de MLOps são as ferramentas que viabilizam essas práticas, automatizando todo o ciclo de vida de ML e aproximando a ciência de dados (construção de modelos) das operações de TI (execução em produção).
As principais funções de uma plataforma de MLOps incluem: rastreamento de experimentos (registro de todos os parâmetros, métricas e artefatos), versionamento e registro de modelos, construção de pipelines automatizados de CI/CD (Integração Contínua/Implantação Contínua) para modelos, gerenciamento da implantação e monitoramento do desempenho dos modelos para identificar problemas como data drift.
O mercado de MLOps on-premise apresenta uma combinação de poderosas plataformas open-source e comerciais:
Open-Source: O MLflow é uma plataforma open-source líder em MLOps, amplamente adotada por sua flexibilidade, abordagem agnóstica de framework e recursos abrangentes para rastreamento de experimentos e gerenciamento de modelos. Ele permite que as equipes construam fluxos de trabalho de MLOps robustos sem vendor lock-in.
Plataformas Comerciais: Plataformas gerenciadas ponta a ponta, como DataRobot e Iguazio (adquirida pela McKinsey), oferecem soluções completas que cobrem todo o ciclo de vida, frequentemente com foco em facilidade de uso, automação e suporte de nível empresarial.
Complemente a escolha da plataforma com o RBAC, guardrails e orçamentos do AI Gateway da TrueFoundry para garantir a aplicação direta de políticas em todas as equipes e modelos.
Servindo e Escalonando AI em Produção
Uma vez que um modelo é treinado e validado, ele deve ser implantado em um ambiente de produção onde possa receber dados de entrada e retornar predições — um processo chamado inferência. O servimento de modelos é uma tarefa especializada que exige software otimizado para alto throughput e baixa latência.
NVIDIA Triton Inference Server: Um servidor de inferência open-source de alto desempenho da NVIDIA. Seus principais pontos fortes são a capacidade de executar modelos de praticamente qualquer framework (TensorFlow, PyTorch, ONNX, etc.) e sua capacidade de execução concorrente de modelos, o que permite que múltiplos modelos ou múltiplas instâncias do mesmo modelo rodem em uma única GPU, maximizando a utilização do hardware.
KServe: Um padrão para servimento de modelos no Kubernetes. O KServe fornece uma plataforma escalável e extensível para implantação de modelos. Seus recursos de destaque incluem capacidades de inferência serverless (com autoscaling capaz de reduzir os pods a zero quando não estiverem em uso, economizando recursos) e um "InferenceGraph" que suporta estratégias avançadas de implantação, como canary rollouts, testes A/B e ensembles de modelos.
Seldon Core: Outra plataforma open-source potente para servimento de modelos no Kubernetes. O Seldon Core também é conhecido por seu suporte robusto a padrões avançados de implantação, incluindo testes A/B, implantações canary e multi-armed bandits (MABs), sendo uma excelente escolha para organizações que precisam testar e otimizar modelos rigorosamente em produção.
Outros Frameworks: O ecossistema também inclui outras ferramentas open-source poderosas, como o Haystack, um framework para a construção de pipelines complexos de agentes e RAG, e o Ray, um motor de computação distribuída frequentemente usado como espinha dorsal para o treinamento e servimento de aplicações de AI em larga escala.
A TrueFoundry opera como um gateway/plano de controle acima desses servidores, permitindo combinar diferentes tecnologias (Triton para modelos de visão computacional, vLLM para LLMs, KServe para bordas serverless) enquanto mantém uma interface, política e camada de telemetria unificadas.
A Camada de Aplicação e Controle: AI Gateway e MCP
As camadas descritas até agora fornecem a base para construir e executar modelos de AI. No entanto, para tornar esses modelos acessíveis de forma segura e eficiente para as aplicações dos usuários finais e permitir fluxos de trabalho complexos baseados em agentes, uma camada final de software é necessária: a Camada de Aplicação e Controle. Essa camada atua como o sistema nervoso central para todas as interações de AI, fornecendo governança, segurança e uma interface padronizada para comunicação. Ela consiste em dois componentes emergentes e críticos: o AI Gateway e o Model Context Protocol (MCP).
O AI Gateway: Um Plano de Controle Centralizado
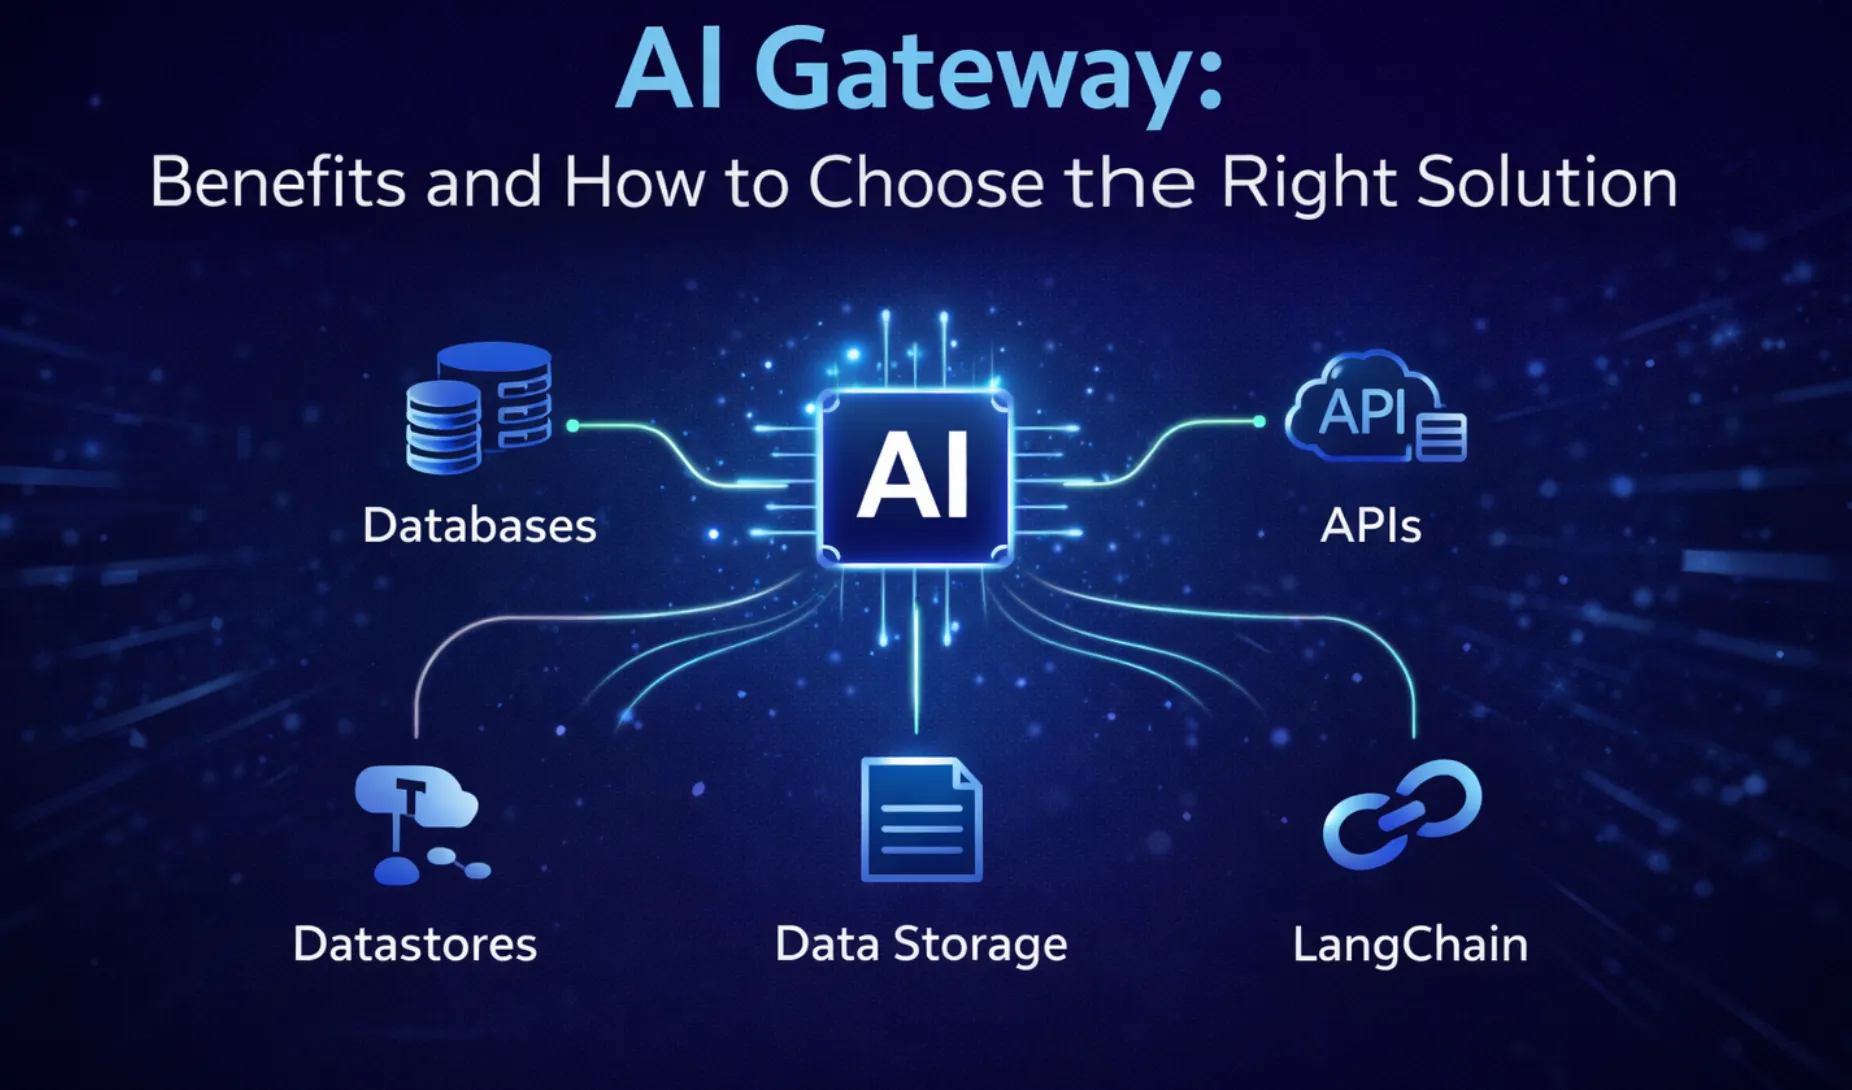
Um AI Gateway é um middleware especializado que serve como um ponto de controle único e centralizado para todo o tráfego relacionado à AI entre as aplicações e os modelos de AI subjacentes. Implantado no ambiente on-premise, frequentemente no Kubernetes, ele oferece um conjunto crítico de funções para gerenciar a AI em escala empresarial.
Acesso Unificado e Roteamento Inteligente: O gateway oferece um endpoint de API único e consistente para os desenvolvedores, abstraindo a complexidade de interagir com múltiplos modelos diferentes (ex.: uma mistura de modelos open-source ajustados e modelos comerciais especializados). Ele pode realizar roteamento baseado no contexto, direcionando requisições ao modelo mais adequado com base em fatores como custo, requisitos de desempenho ou o caso de uso específico, otimizando tanto a eficiência quanto os resultados.
Segurança Robusta e Governança: Para a AI on-premise, a segurança é primordial. O AI Gateway atua como um ponto de aplicação de políticas, integrando-se à arquitetura de segurança empresarial para gerenciar autenticação, autorização e controle de acesso baseado em funções (RBAC). Ele inspeciona prompts de entrada e respostas de saída em tempo real para prevenir ataques de prompt injection e vazamento de informações confidenciais, como Informações de Identificação Pessoal (PII), garantindo a conformidade com regulamentações como GDPR e HIPAA.
Observabilidade Abrangente e Controle de Custos: O gateway fornece um painel unificado para monitorar todas as interações de AI, rastreando métricas de desempenho chave como latência, taxas de erro e uso de tokens. Essa observabilidade centralizada é crucial para a solução de problemas e otimização de desempenho. Além disso, ele permite um controle granular de custos ao aplicar limites de taxa baseados em tokens e orçamentos de uso, evitando custos descontrolados e permitindo o rateio preciso de despesas (chargebacks) entre diferentes unidades de negócio.
O Model Context Protocol (MCP): A Linguagem Universal para Agentes de AI
Enquanto o AI Gateway gerencia o fluxo de requisições, o Model Context Protocol (MCP) é um padrão aberto que revoluciona o que essas requisições podem fazer. O MCP fornece uma forma padronizada para que modelos de AI descubram e interajam com ferramentas, dados e serviços externos, transformando-os de "cérebros" isolados em agentes capazes e integrados.
Uma Interface Padronizada para Ferramentas: Em vez de criar código personalizado e frágil para cada integração, o MCP permite que sistemas empresariais (como bancos de dados, CRMs ou APIs internas) anunciem suas capacidades por meio de um "MCP server" leve. A aplicação de AI, atuando como um "MCP host", pode então consultar esses servidores para entender quais ferramentas estão disponíveis e como usá-las, criando efetivamente um ecossistema plug-and-play para AI agents.
Viabilizando Agentic AI On-Premise: Uma vantagem fundamental do MCP é ser um protocolo aberto e auditável que pode ser implantado inteiramente dentro do firewall de uma organização. Isso permite que as empresas construam AI agents autônomos e poderosos que podem interagir com segurança com sistemas internos proprietários, sem expor dados sensíveis a serviços externos.
Evitando Lock-In de Fornecedor: Como o MCP é um padrão agnóstico de modelo suportado por grandes players como Anthropic, OpenAI e Microsoft, ele desacopla o modelo de AI das integrações de ferramentas. Isso dá às empresas a flexibilidade de trocar o LLM subjacente — por exemplo, migrando de uma API comercial para um modelo fine-tuned hospedado pelo próprio cliente — sem precisar reconstruir toda a pilha de integração, preservando assim a soberania tecnológica.
Juntos, o AI Gateway e o MCP formam uma poderosa camada de aplicação e controle que torna a AI on-premise não apenas possível, mas também segura, gerenciável e verdadeiramente integrada à estrutura da empresa.
O MCP Gateway da TrueFoundry combina ambos: governança e observabilidade para cada requisição, além de tool-calling seguro e auditado via MCP para que os agents possam atuar em seus sistemas internos sem que os dados saiam da sua rede.
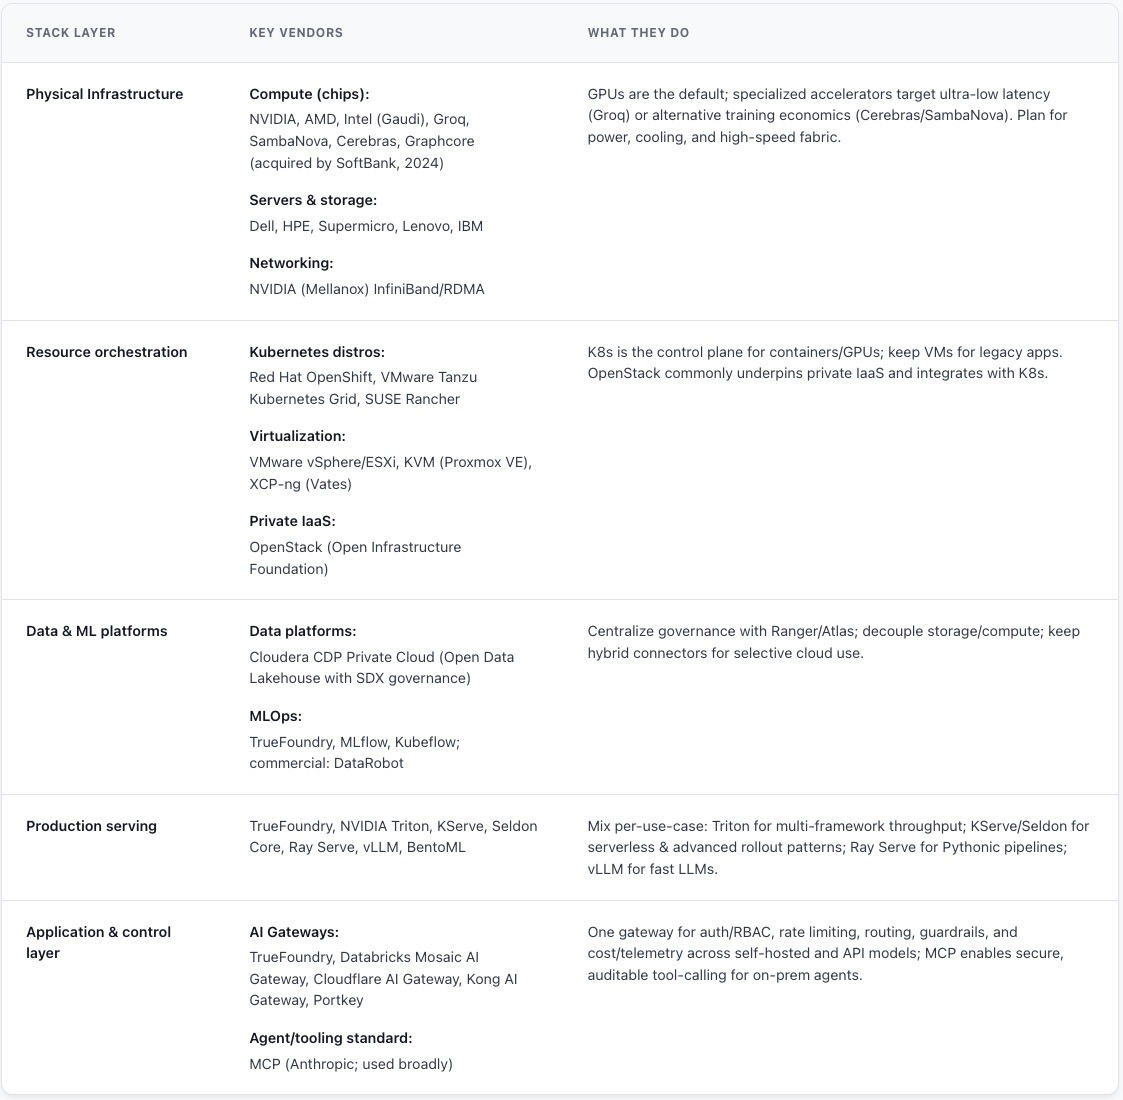
Mapeamento de Fornecedores na Pilha de AI On-Premise
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.