



November 14, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.


Blazingly fast way to build, track and deploy your models!
Uma semana após a chegada do GPT-6 Sol ao catálogo, a OpenAI lançou seu sucessor. GPT-6.1 Sol foi lançado na terça-feira, 29 de setembro, e já está no catálogo de modelos do TrueFoundry AI Gateway com preços, limites de contexto e capacidades preenchidos.
Você o chama pelo mesmo endpoint compatível com OpenAI que usa para todo o resto. Sem novo SDK, sem integração separada, sem esperar por uma atualização do gateway. Altere a string do modelo para gpt-6.1-sol na sua conta OpenAI (openai/gpt-6.1-sol no OpenRouter) e você estará usando o novo modelo.
Experimente o GPT-6.1 Sol no TrueFoundry AI Gateway →
O GPT-6.1 Sol substitui o GPT-6 Sol pelo mesmo preço, com cache mais barato e os mesmos limites. Os números que importam para um orçamento de produção:
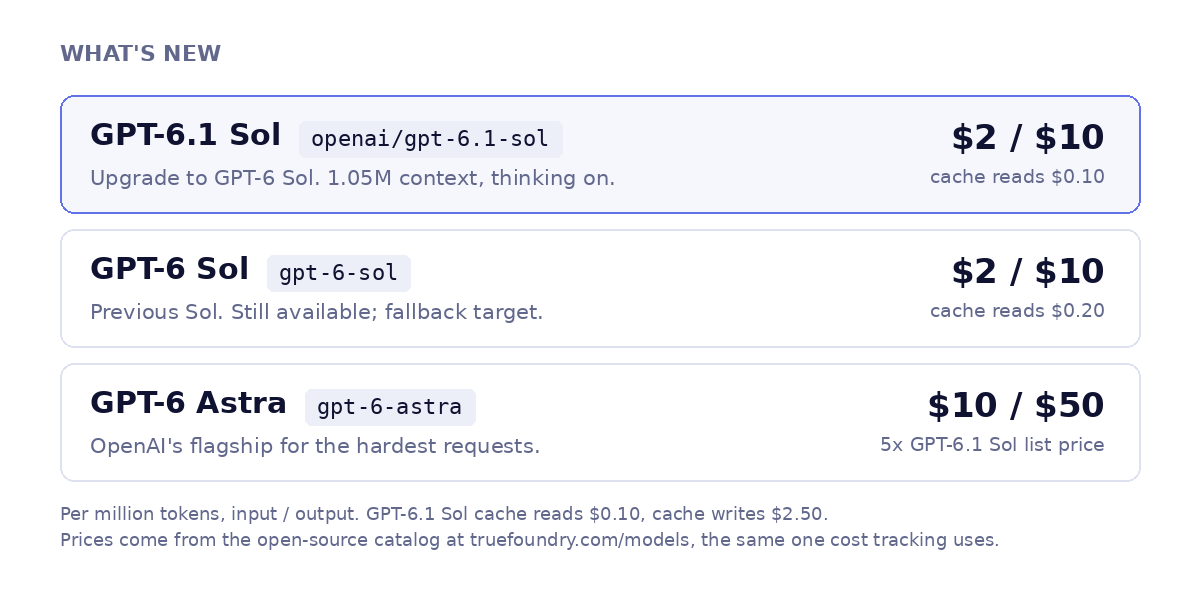
O catálogo coloca o GPT-6 Astra a $10 por milhão de tokens de entrada e $50 por milhão de saída. O GPT-6.1 Sol custa $2 e $10, exatamente um quinto em ambos os lados, e suas leituras de cache a $0,10 são um décimo dos $1 do Astra.
Compare os lançamentos do mês lado a lado: GPT-6 Luna a $0,10 por milhão de tokens de entrada, GPT-6 Sol, GPT-6.1 Sol e Claude Sonnet 5.5 a $2, Claude Opus 5.5 a $4, GPT-6 Astra a $10. O GPT-6.1 Sol ocupa o lugar do GPT-6 Sol na escala pelo mesmo preço, com a menor taxa de leitura de cache nessa faixa de $2.
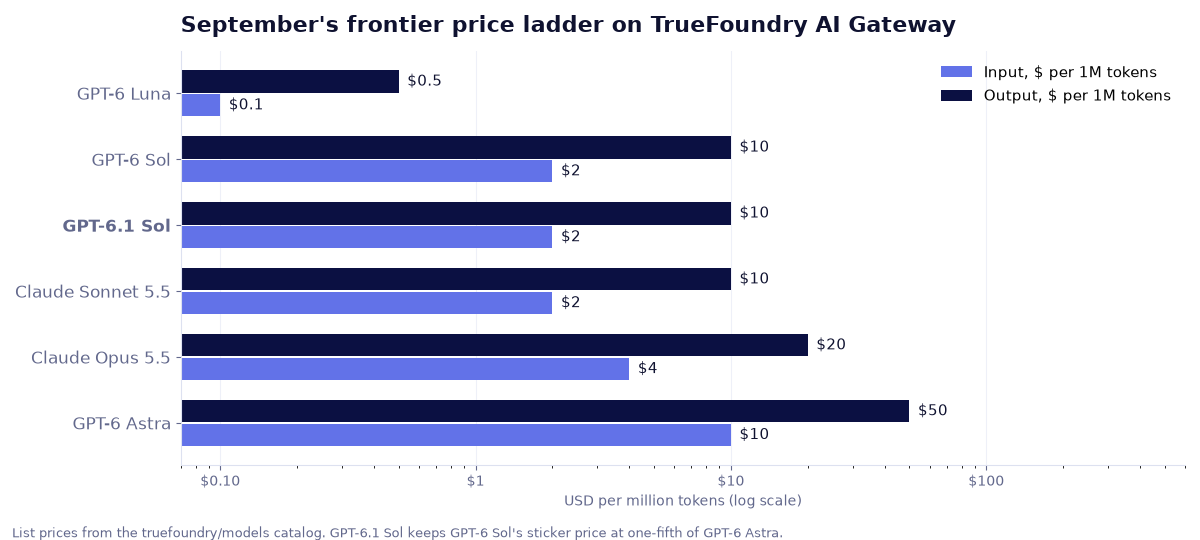
Esse é o argumento para tratar a escolha do modelo como uma configuração de gateway em vez de código de aplicação. A maior parte do tráfego de produção consiste em um grande número de solicitações fáceis e um pequeno número de solicitações difíceis. Se a maioria fácil for para o Luna, a intermediária para o GPT-6.1 Sol e apenas a parte difícil for para o Astra, a fatura combinada não se parecerá em nada com uma fatura apenas de Astra. Isso só funciona quando a troca é uma alteração de configuração, que é o que o Gateway de IAserve.
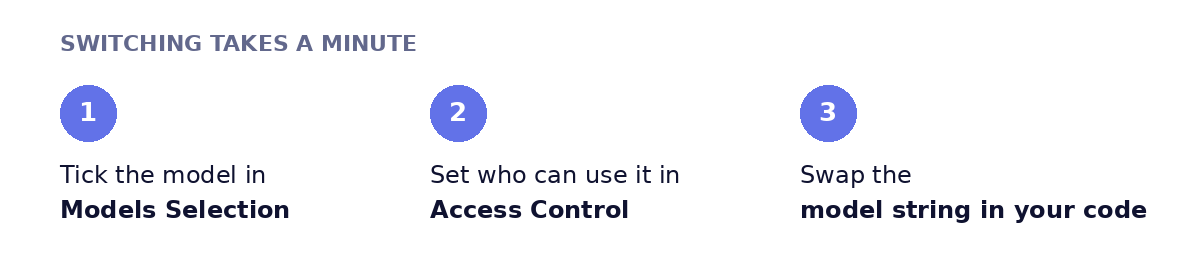
Passo 1: Habilite o modelo na sua conta de provedor. No gateway, abra Modelos → sua conta OpenAI → Seleção de Modelos, pesquise por gpt-6.1-sol e marque-o. O preço é exibido diretamente ($2 de entrada / $10 de saída por 1M de tokens) porque vem direto do catálogo. Em seguida, defina Controle de Acesso assim, o modelo é delimitado às equipes e chaves virtuais certas desde o primeiro dia.
OpenAI direto e OpenRouter (openai/gpt-6.1-sol) já estão no catálogo hoje; as entradas do Microsoft Foundry e AWS Bedrock estão chegando.
Não encontrou o modelo na sua lista? + Adicionar Modelo na parte inferior da lista permite adicioná-lo manualmente.
Passo 2: Faça a chamada. Abra o Playground, escolha o modelo e copie o snippet gerado no SDK que você utiliza. A versão Python da OpenAI:
from openai import OpenAI

client = OpenAI(
    api_key="<your-truefoundry-api-key>",
    base_url="https://gateway.truefoundry.ai",  # or your self-hosted gateway URL
)

# Model IDs are <provider-account>/<model>. Swap the string, keep everything else.
r = client.chat.completions.create(
    model="openai-main/gpt-6.1-sol",
    messages=[{"role": "user", "content": "Summarise this incident in three bullets: ..."}],
    extra_headers={"X-TFY-METADATA": '{"team": "platform", "feature": "incident-summary"}'},
)
print(r.choices[0].message.content)
Os IDs de modelo seguem o namespace <your-provider-account>/<model>, portanto openai-main/gpt-6-soleopenai-main/gpt-6.1-sol podem ser trocados em uma única linha. O cabeçalho X-TFY-METADATA marca cada chamada para que os gastos apareçam por equipe ou por funcionalidade na visualização de métricas.
Passo 3 (opcional): Coloque-o atrás de um modelo virtual. Crie um modelo virtuale escolhaAI Gateway. O gateway classifica cada solicitação como simples, média ou complexa e a envia para o destino que você atribuir a esse nível. GPT-6 Luna para simples, GPT-6.1 Sol para média, GPT-6 Astra para complexa, com GPT-6 Sol como fallback enquanto os limites de taxa da semana de lançamento se estabilizam, é um mapeamento inicial sensato. Em nossos benchmarks, esse tipo de roteamento reduziu os custos em 50–70% mantendo cerca de 98% da qualidade. Sua aplicação chama um único nome de modelo durante todo o processo.
O GPT-6.1 Sol é o modelo ideal quando uma solicitação exige mais do que o Luna, mas o preço do Astra é difícil de justificar, e quando agentes reenviam contextos longos que a taxa de cache de US$ 0,10 torna barata. Executá-lo através do TrueFoundry significa que a decisão sobre quais solicitações se encaixam nisso fica na configuração do gateway, onde você pode alterá-la sem precisar de um novo deploy.
Experimente o GPT-6.1 Sol no TrueFoundry AI Gateway →
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada


















