August 26, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.


Blazingly fast way to build, track and deploy your models!
Os Large Language Models (LLMs) se tornaram a espinha dorsal das aplicações modernas de IA, impulsionando desde chatbots e assistentes virtuais até ferramentas de pesquisa e soluções empresariais. No entanto, nem todos os LLMs são criados iguais — cada um possui pontos fortes, limitações e fatores de custo únicos. Alguns se destacam no raciocínio, enquanto outros são melhores em escrita criativa, programação ou no processamento de consultas estruturadas. É aqui que entra o LLM Router.
Um LLM Router atua como um controlador de tráfego inteligente, direcionando automaticamente os prompts do usuário para o modelo mais adequado com base na tarefa em questão. Em vez de depender de um único modelo, empresas e desenvolvedores podem otimizar o desempenho, a precisão e os custos roteando consultas para o LLM correto em tempo real. À medida que a adoção da IA cresce, o roteamento de LLM está se tornando uma camada essencial para a construção de sistemas de IA escaláveis, confiáveis e eficientes.
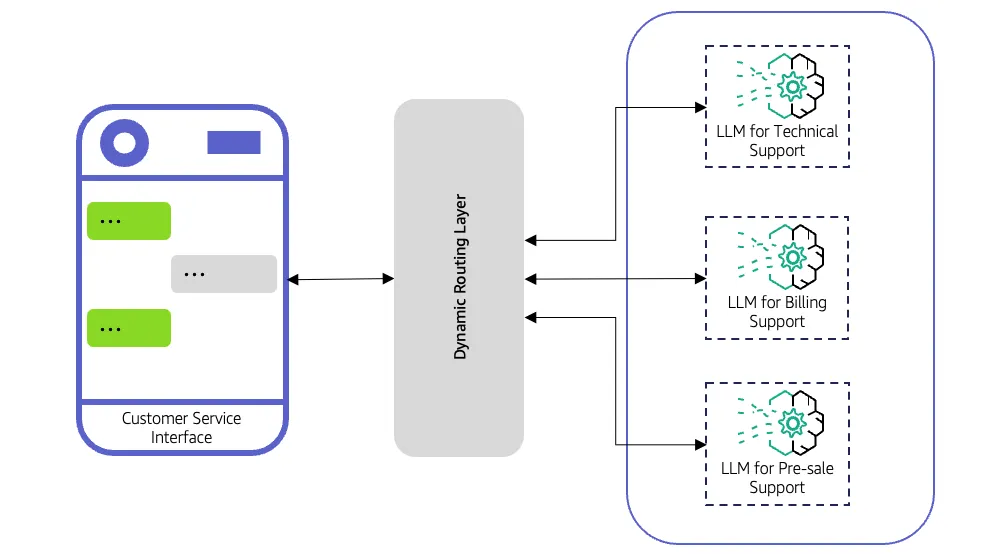
Um LLM Router decide qual Large Language Model deve processar cada requisição. Em vez de enviar todas as consultas para um único modelo, ele avalia a entrada, aplica a lógica de roteamento e a encaminha para o modelo mais adequado.
O roteador pode seguir regras simples, como direcionar consultas relacionadas a código para um modelo focado em programação, ou usar estratégias avançadas como classificadores, embeddings ou modelos preditivos leves para determinar qual LLM entregará a melhor resposta.
Como Funciona
Essa abordagem elimina o problema da solução "única para todos". Modelos leves lidam com consultas rotineiras de forma eficiente, enquanto tarefas complexas ou que exigem alto nível de raciocínio vão para LLMs mais capazes.
Na prática, o roteador fica entre as aplicações e múltiplos LLMs, otimizando o desempenho, reduzindo custos e minimizando a dependência de qualquer provedor único. Essa estrutura garante que cada requisição alcance o modelo certo, mantendo os sistemas de IA confiáveis e flexíveis.

As tecnologias de governança de IA operacionalizam as políticas de IA de uma organização fornecendo supervisão, gestão de riscos, conformidade, observabilidade e segurança ao longo do ciclo de vida da IA. Este Hype Cycle identifica as tecnologias que ajudarão as organizações a implementar a governança de IA de forma responsável e impulsionar a adoção em escala.
As empresas confiam cada vez mais nos Large Language Models para tarefas que vão desde chatbots e assistentes virtuais até criação de conteúdo e análise de dados.
Usar um único LLM para todas as tarefas, no entanto, cria desafios. Alguns modelos respondem rapidamente, mas carecem de profundidade, enquanto outros fornecem resultados precisos com alta latência e alto custo. Sem uma maneira de gerenciar essas diferenças, as equipes fazem concessões constantes entre desempenho, precisão e orçamento.
Um LLM Router resolve isso direcionando inteligentemente as requisições para o modelo mais adequado para a tarefa.
Considere este cenário -
Um sistema de suporte ao cliente recebe dois tipos de consultas.
Uma solicitação simples como "Qual é o seu horário de atendimento?" não precisa de um modelo altamente avançado, enquanto uma pergunta técnica complexa sobre solução de problemas do produto precisa. Sem um LLM Router, todas as consultas podem ir para um modelo de alto desempenho e dispendioso. Isso aumenta os custos e desacelera os tempos de resposta. Com um roteador, a consulta simples vai para um modelo rápido e leve, enquanto a complexa é roteada para um LLM mais capaz, otimizando velocidade, custo e precisão.
Benefícios para as Empresas
Ao rotear consultas de forma inteligente, as empresas entregam serviços de IA mais rápidos, precisos e econômicos. Os LLM Routers transformam a implantação de IA de uma abordagem "única para todos" em um sistema flexível, confiável e eficiente, tornando-os essenciais para a infraestrutura moderna de IA.
Um LLM Router é mais do que um direcionador de tráfego, ele fornece várias funções fundamentais que tornam os sistemas de IA mais inteligentes, rápidos e confiáveis. Entender essas funções ajuda as organizações a projetar fluxos de trabalho de IA que escalam com eficiência enquanto mantêm a qualidade.
Antes que qualquer roteamento aconteça, o roteador analisa as consultas recebidas. Ele examina metadados, tags, tipo de consulta, complexidade e, às vezes, intenção ou sentimento. Essa análise fornece contexto para que o roteador possa decidir qual modelo é o mais adequado para processar a requisição. Por exemplo, a dúvida de um cliente sobre faturamento pode ser roteada para um LLM de uso geral e leve, enquanto uma consulta de suporte técnico é enviada para um modelo específico do domínio.
O roteador seleciona o modelo mais apropriado com base em múltiplos critérios, incluindo:
Ao considerar esses fatores, o roteador garante que cada requisição obtenha o melhor equilíbrio entre velocidade, precisão e custo.
Quando múltiplos modelos podem lidar com a mesma tarefa, o roteador distribui as requisições de forma inteligente para evitar sobrecarregar qualquer modelo individual. Isso melhora a capacidade geral de resposta do sistema e garante um desempenho consistente durante os picos de uso.
Até mesmo os melhores modelos podem falhar, expirar o tempo limite ou retornar respostas com baixa confiança. O roteador implementa mecanismos de fallback, redirecionando automaticamente as consultas para modelos de backup. Isso garante continuidade e confiabilidade sem interromper o usuário.
Roteadores avançados rastreiam padrões de uso, desempenho dos modelos e resultados das consultas. Esses insights ajudam as equipes a otimizar estratégias de roteamento, selecionar melhores modelos e reduzir custos ao longo do tempo.
Um LLM Router atua como o centro de tomada de decisões de sistemas de IA multimodelo. Ao analisar requisições, selecionar o modelo certo, balancear a carga, tratar falhas e fornecer insights, ele garante que cada consulta seja processada com eficiência, precisão e confiabilidade. Essa combinação de funções torna os LLM Routers um componente crítico na construção de soluções de IA robustas, escaláveis e econômicas.
LLM Routers e AI Gateways são frequentemente discutidos juntos porque ambos se posicionam entre as aplicações de IA e os modelos de linguagem. No entanto, eles resolvem problemas diferentes e atuam em camadas diferentes da arquitetura de IA.
Um LLM Router foca em selecionar e direcionar requisições para o modelo de linguagem mais apropriado com base em fatores como custo, latência, desempenho, disponibilidade ou requisitos da tarefa. Seu objetivo principal é otimizar a utilização dos modelos e melhorar o desempenho da aplicação.
Um AI Gateway fornece um plano de controle mais amplo para o tráfego de IA. Além do roteamento de modelos, os AI Gateways oferecem recursos como autenticação, autorização, limitação de taxa (rate limiting), observabilidade, governança, rastreamento de custos e controles de segurança. Eles ajudam as organizações a gerenciar e proteger cargas de trabalho de IA em múltiplos modelos, equipes e ambientes.
Os roteadores de LLM usam diferentes estratégias para direcionar consultas ao modelo de linguagem mais adequado de forma eficiente. Essas estratégias geralmente se enquadram em três categorias: estática, dinâmica e híbrida, com sistemas avançados às vezes incorporando aprendizado por reforço.
O roteamento estático depende de regras predefinidas para decidir qual modelo processa uma consulta. Ele garante um comportamento de roteamento consistente e é fácil de implementar.
O roteamento dinâmico se adapta em tempo real, selecionando modelos com base no desempenho atual do sistema e no contexto da consulta.
As estratégias híbridas combinam abordagens estáticas e dinâmicas para maior flexibilidade e eficiência.
Alguns sistemas avançados usam aprendizado por reforço para melhorar continuamente as decisões de roteamento. Esses roteadores aprendem com consultas passadas e com o desempenho dos modelos, otimizando o roteamento ao longo do tempo para cargas de trabalho complexas ou em evolução.
Um LLM Router oferece vários benefícios principais que tornam os sistemas de IA mais eficientes, confiáveis e econômicos. Uma das principais vantagens é o desempenho otimizado.
Ao rotear inteligentemente cada consulta para o modelo mais adequado à tarefa, o roteador garante que modelos poderosos e com alta capacidade de raciocínio lidem com perguntas complexas, enquanto modelos leves e mais rápidos processem solicitações mais simples. Essa abordagem equilibra velocidade e precisão, melhorando a experiência geral do usuário.
Outro benefício significativo é a eficiência de custos. Sem um roteador, as empresas podem executar todas as consultas em modelos de alto desempenho, o que aumenta os custos operacionais desnecessariamente. O roteador garante que modelos caros sejam reservados para consultas complexas ou de alto valor, enquanto tarefas rotineiras ou repetitivas são tratadas por modelos menos intensivos em recursos, reduzindo despesas com computação e maximizando o ROI.
A confiabilidade também melhora com um LLM Router. Roteadores avançados incluem mecanismos de fallback que redirecionam automaticamente as consultas se um modelo falhar, expirar o tempo limite ou retornar resultados de baixa confiança. Isso garante um desempenho consistente e confiável, evitando interrupções em aplicações em tempo real, como suporte ao cliente ou assistentes virtuais.
Além disso, os LLM Routers oferecem flexibilidade. As organizações podem integrar múltiplos modelos de diferentes provedores, escolhendo o melhor para cada tarefa.
Isso reduz a dependência de um único fornecedor e permite que as equipes experimentem diferentes modelos à medida que novas capacidades surgem.
Por fim, os roteadores suportam a escalabilidade. À medida que os volumes de consulta crescem, o roteador distribui as requisições de forma inteligente entre os modelos, evitando sobrecargas e mantendo o desempenho fluido do sistema.
Ao combinar roteamento otimizado, economia de custos, confiabilidade, flexibilidade e escalabilidade, um LLM Router transforma as implantações de IA de uma abordagem rígida de modelo único em um sistema dinâmico, eficiente e resiliente.
Os LLM Routers são cada vez mais utilizados em empresas para otimizar o desempenho, a confiabilidade e a eficiência da IA. Eles permitem o roteamento inteligente de consultas, garantindo que o modelo certo processe cada tarefa com base na complexidade, no domínio e no contexto.
Automação de Suporte ao Cliente
As empresas lidam diariamente com milhares de consultas de clientes, desde FAQs simples até problemas técnicos complexos. Os LLM Routers direcionam perguntas rotineiras para modelos rápidos e leves, enquanto roteiam problemas complicados para modelos mais capazes. Isso garante respostas rápidas, precisas e consistentes, aumentando a satisfação do cliente e reduzindo a sobrecarga operacional.
Gestão de Conhecimento e Busca Empresarial
As empresas mantêm grandes repositórios de documentos internos, manuais e políticas. Os roteadores analisam as consultas e as direcionam para modelos otimizados para raciocínio, sumarização ou conhecimento específico do domínio. Os funcionários recebem informações precisas e contextualizadas sem sobrecarregar modelos de alto custo.
Automação de Tarefas e Fluxos de Trabalho
Os LLMs são amplamente utilizados para geração de relatórios, análise de dados e suporte à tomada de decisões. Os roteadores atribuem dinamicamente consultas de alta complexidade a modelos poderosos e tarefas rotineiras a modelos mais leves, equilibrando velocidade, precisão e custos computacionais nos fluxos de trabalho empresariais.
Orquestração Multimodelo
As organizações frequentemente implantam múltiplos LLMs de diferentes provedores ou domínios. Os roteadores gerenciam a seleção de modelos, o balanceamento de carga e os mecanismos de fallback, garantindo confiabilidade, flexibilidade e escalabilidade em sistemas de IA em grande escala.
Recomendações de Produtos e Personalização
Para plataformas de E-commerce ou SaaS, os LLM Routers podem atribuir tarefas de personalização a modelos treinados no comportamento e contexto do usuário, enquanto delegam recomendações genéricas a modelos mais simples. Isso melhora a precisão das recomendações e o desempenho, mantendo os custos sob controle.
Análise de Conformidade e Risco
Em empresas dos setores financeiro, jurídico ou de saúde, as consultas podem exigir adesão estrita a regulamentações ou diretrizes específicas do setor. Os roteadores podem direcionar consultas sensíveis ou de alto risco para modelos com especialização no domínio, garantindo conformidade enquanto tarefas gerais são tratadas por modelos padrão.
Geração de Conteúdo e Sumarização
Para marketing, compartilhamento de conhecimento ou documentação, os LLM Routers podem alocar tarefas complexas de criação de conteúdo para modelos de alta qualidade e tarefas simples de sumarização ou rascunho para modelos mais rápidos, otimizando a eficiência sem comprometer a qualidade do resultado.
Ao aplicar LLM Routers nesses diversos cenários, as empresas podem escalar a IA de forma inteligente, mantendo o desempenho, a confiabilidade e a relação custo-benefício em múltiplos fluxos de trabalho e aplicações.
Depois de explorar como os LLM Routers impulsionam uma ampla gama de aplicações empresariais, é importante entender como eles se diferenciam de outro componente-chave em sistemas de IA multimodelo.
Um LLM Router é focado no roteamento inteligente de requisições. Sua função principal é analisar as consultas recebidas, avaliar o contexto, a complexidade e os metadados, e então direcionar cada requisição para o modelo mais adequado. Os roteadores frequentemente incorporam estratégias avançadas, como roteamento dinâmico, tomada de decisão consciente do contexto e mecanismos de fallback para otimizar precisão, velocidade e custo.
Eles são particularmente críticos em ambientes onde as consultas variam amplamente em tipo, domínio ou requisitos computacionais, permitindo que as empresas balanceiem a carga e mantenham um alto desempenho.
Um LLM Gateway, por outro lado, atua como um ponto de acesso centralizado para interagir com um ou múltiplos LLMs. Seu papel principal é simplificar a integração, fornecer APIs padronizadas, gerenciar autenticação, lidar com limitação de taxa (rate limiting) e monitorar o uso.
Diferente dos roteadores, os gateways normalmente não tomam decisões inteligentes de seleção de modelos; eles fornecem acesso uniforme e controles operacionais para facilitar implantações multimodelo. Os gateways focam mais na gestão em nível de infraestrutura, segurança e escalabilidade do que na otimização em nível de consulta.
Principais diferenças
Roteadores e gateways frequentemente trabalham juntos em arquiteturas em camadas. O gateway fornece um ponto de entrada seguro e padronizado para as aplicações, enquanto o roteador opera atrás dele, tomando decisões inteligentes de seleção de modelos. Essa combinação permite que as empresas alcancem tanto o controle operacional quanto o processamento otimizado de consultas.
Entender a distinção entre LLM Routers e LLM Gateways ajuda as organizações a implantar sistemas de IA multimodelo com eficácia.
Os roteadores impulsionam o desempenho inteligente e consciente do contexto, enquanto os gateways garantem um acesso seguro, escalável e confiável, criando uma base robusta para a IA empresarial.
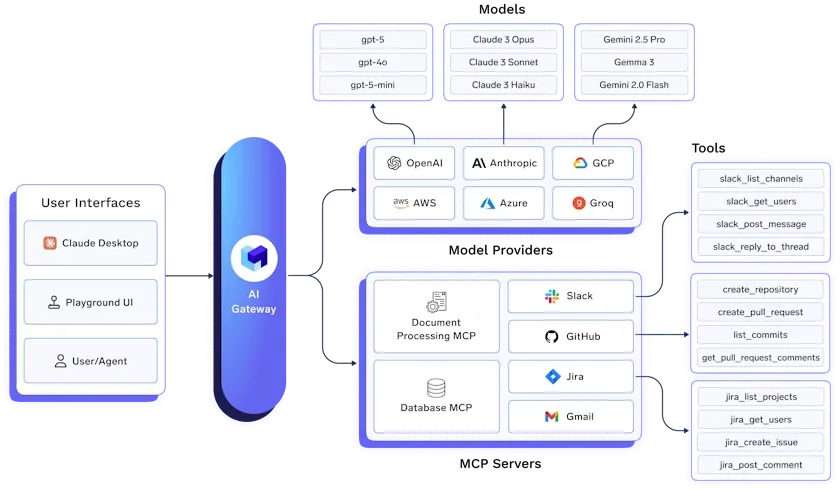
O TrueFoundry LLM Gateway é uma plataforma pronta para empresas que unifica o acesso a todos os principais Large Language Models (LLMs) por meio de uma API única, segura e de alto desempenho.
Ele simplifica a infraestrutura de GenAI ao integrar mais de 250 modelos, incluindo OpenAI, Anthropic Claude, Gemini, Groq, Mistral e frameworks de código aberto, sem exigir alterações no código. As equipes podem usar uma API consistente para cargas de trabalho de chat, completion, embedding e reranking, centralizando a autenticação e o gerenciamento de chaves de API.
Principais Recursos:
À medida que as empresas dependem cada vez mais de múltiplos Large Language Models, ferramentas como LLM Routers e LLM Gateways tornaram-se indispensáveis para gerenciar AI em escala. Os LLM Routers trazem inteligência ao sistema, analisando cada consulta e garantindo que ela alcance o modelo mais adequado para a tarefa. Isso melhora o desempenho, reduz custos e aumenta a confiabilidade, especialmente em fluxos de trabalho complexos e de alto volume.
Os Gateways, por sua vez, fornecem a espinha dorsal para um acesso seguro e padronizado aos modelos, simplificando a integração, monitorando o uso e aplicando controles operacionais.
Juntos, esses componentes formam uma arquitetura de AI em camadas que equilibra inteligência com eficiência operacional. Ao combinar as capacidades de tomada de decisão dos roteadores com a confiabilidade estrutural dos gateways, as organizações podem maximizar o valor de múltiplos LLMs enquanto mantêm a escalabilidade e o controle.
A adoção de LLM Routers não é mais opcional; é uma necessidade para empresas que visam entregar serviços de AI rápidos, precisos e econômicos. Compreender o papel deles, juntamente com os gateways, capacita as equipes a projetar infraestruturas de AI robustas que atendem a diversas necessidades de negócios.
À medida que os modelos de AI continuam a evoluir e se multiplicar, dominar o roteamento inteligente e o acesso estruturado será crítico para empresas que buscam permanecer competitivas no cenário de AI em rápido avanço.
O roteamento de LLM funciona avaliando as solicitações de entrada contra lógicas predefinidas, embeddings semânticos ou regras de classificação. O sistema roteia o tráfego com base no contexto, na precisão necessária ou na latência do provedor upstream. Um gateway centralizado gerencia essas configurações complexas para automatizar a seleção de modelos e o failover sem exigir alterações manuais de código para cada atualização de modelo.
A classificação de roteamento de LLM usa um modelo altamente eficiente para categorizar prompts antes da execução da inferência. Esta etapa identifica a intenção, como saudações simples versus tarefas complexas de codificação. A classificação automatizada evita a superutilização de modelos de ponta caros, filtrando consultas de baixa complexidade para alternativas menores, mais rápidas e mais econômicas.
A TrueFoundry unifica capacidades de roteamento de LLM e AI Gateway mesclando a orquestração de tráfego com governança e segurança. A plataforma lida com failover de modelo, rate limiting e roteamento consciente de custos em um único plano de controle centralizado. Essa infraestrutura garante que as implantações de AI corporativas sejam altamente resilientes e econômicas para ambientes de produção em grande escala.
Os principais LLM routers incluem a TrueFoundry para orquestração de nível corporativo, o LiteLLM para uma API de proxy unificada e a Martian para seleção automatizada de modelos. Outras opções de destaque no setor incluem o Portkey para guardrails avançados, o Helicone para observabilidade extremamente rápida e o OpenRouter para acesso simples a centenas de modelos open-source e proprietários.
Os LLM Routers examinam os metadados, o tipo e o contexto da consulta para escolher um modelo. Os fatores de seleção incluem especialidade no domínio, capacidade de raciocínio, latência e custo. Consultas simples vão para modelos leves, enquanto tarefas complexas vão para modelos de alta capacidade. Roteadores avançados podem usar embeddings ou classificadores preditivos para um roteamento inteligente de modelos em tempo real.
As funções centrais de um LLM router incluem análise de solicitações, seleção inteligente de modelos, balanceamento de carga, tratamento de fallbacks e monitoramento. Os roteadores distribuem consultas entre múltiplos LLMs, redirecionam solicitações com falha e rastreiam o desempenho. Isso garante que as tarefas sejam processadas com eficiência, os modelos sejam otimizados e o sistema permaneça confiável e escalável em fluxos de trabalho de AI corporativa.
Os tipos comuns de LLM routers incluem roteamento baseado em regras, roteamento baseado em custo, roteamento baseado em desempenho e roteamento baseado em tarefas. Roteadores baseados em regras seguem condições predefinidas, roteadores baseados em custo escolhem modelos mais baratos, roteadores baseados em desempenho selecionam modelos com melhor precisão ou velocidade, e roteadores baseados em tarefas enviam solicitações para modelos especializados em tarefas como codificação, chat ou sumarização.
O roteamento de LLM é feito analisando a solicitação do usuário e direcionando-a para o modelo mais adequado. Os desenvolvedores definem regras ou usam algoritmos que consideram fatores como tipo de tarefa, custo, latência e capacidade do modelo. Uma camada de roteamento avalia a entrada e envia automaticamente a consulta para o LLM apropriado.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada