


September 18, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Published: October 7, 202615
Blazingly fast way to build, track and deploy your models!
A portabilidade de agentes de IA é a propriedade pela qual a lógica de um agente permanece a mesma enquanto o modelo subjacente pode ser alterado. O agente referencia um modelo pelo nome e chama uma interface estável. Qual provedor realmente atende à solicitação e quais credenciais são usadas são aspectos que residem inteiramente fora do agente.
Compare isso com o ponto de partida comum. Um agente é escrito com base no SDK de um provedor específico, a chave de API do provedor fica no ambiente do agente e o nome do modelo fica espalhado pelo código. Cada um desses elementos é um vínculo que prende o agente a um único fornecedor. A portabilidade é o que acontece quando você corta todos os três.
O benefício é prático: você pode adotar um modelo mais novo no dia em que ele for lançado, recorrer a um segundo provedor quando o primeiro sofrer uma interrupção, direcionar solicitações baratas para um modelo menor e manter modelos auto-hospedados e comerciais atrás da mesma interface. Nada disso deve exigir alterações no agente.
Para um chatbot de turno único, trocar de modelo já é quase uma mudança de uma única linha. Os agentes elevam a dificuldade por alguns motivos que vale a pena mencionar, pois eles definem o que uma boa camada de portabilidade precisa gerenciar.
Uma camada de portabilidade que apenas troca uma string de modelo, mas deixa credenciais, roteamento e fallbacks dentro do agente, não tornou o agente realmente portátil. Ela apenas deslocou o problema.
A abordagem da TrueFoundry é gerenciar o acesso ao modelo uma única vez, no Gateway de IA, e permitir que cada agente referencie modelos pelo nome. O gateway mantém as credenciais do provedor, impõe políticas de acesso e roteia o tráfego. Os agentes herdam tudo isso.
Cada modelo, seja OpenAI, Anthropic, Azure OpenAI, Google Vertex, AWS Bedrock, Databricks, Together AI ou algo que você mesmo hospeda, fica atrás de uma única API compatível com OpenAI. Você aponta seu código para o gateway uma vez e troca de modelo alterando o nome do modelo na solicitação. Mesma URL, mesmas credenciais.
from openai import OpenAI

client = OpenAI(
    api_key="your-truefoundry-api-key",   # a gateway token, never a provider key
    base_url="https://gateway.truefoundry.ai",
)

# Today:
resp = client.chat.completions.create(
    model="openai-main/gpt-4o",
    messages=[{"role": "user", "content": "Draft the release notes"}],
)

# Tomorrow, swap the model. Nothing else changes:
resp = client.chat.completions.create(
    model="anthropic-main/claude-sonnet-4",
    messages=[{"role": "user", "content": "Draft the release notes"}],
)
O código do agente não sofreu nenhuma alteração significativa. As credenciais não mudaram. A única edição é o nome do modelo, e até isso pode ser abstraído, que é o próximo passo.
No Agent Harness da TrueFoundry, o modelo é uma seleção no construtor, não um valor no código. Você escolhe qualquer modelo habilitado para você no gateway, e a alternância é feita com um clique, sem edições de código e sem novas credenciais.
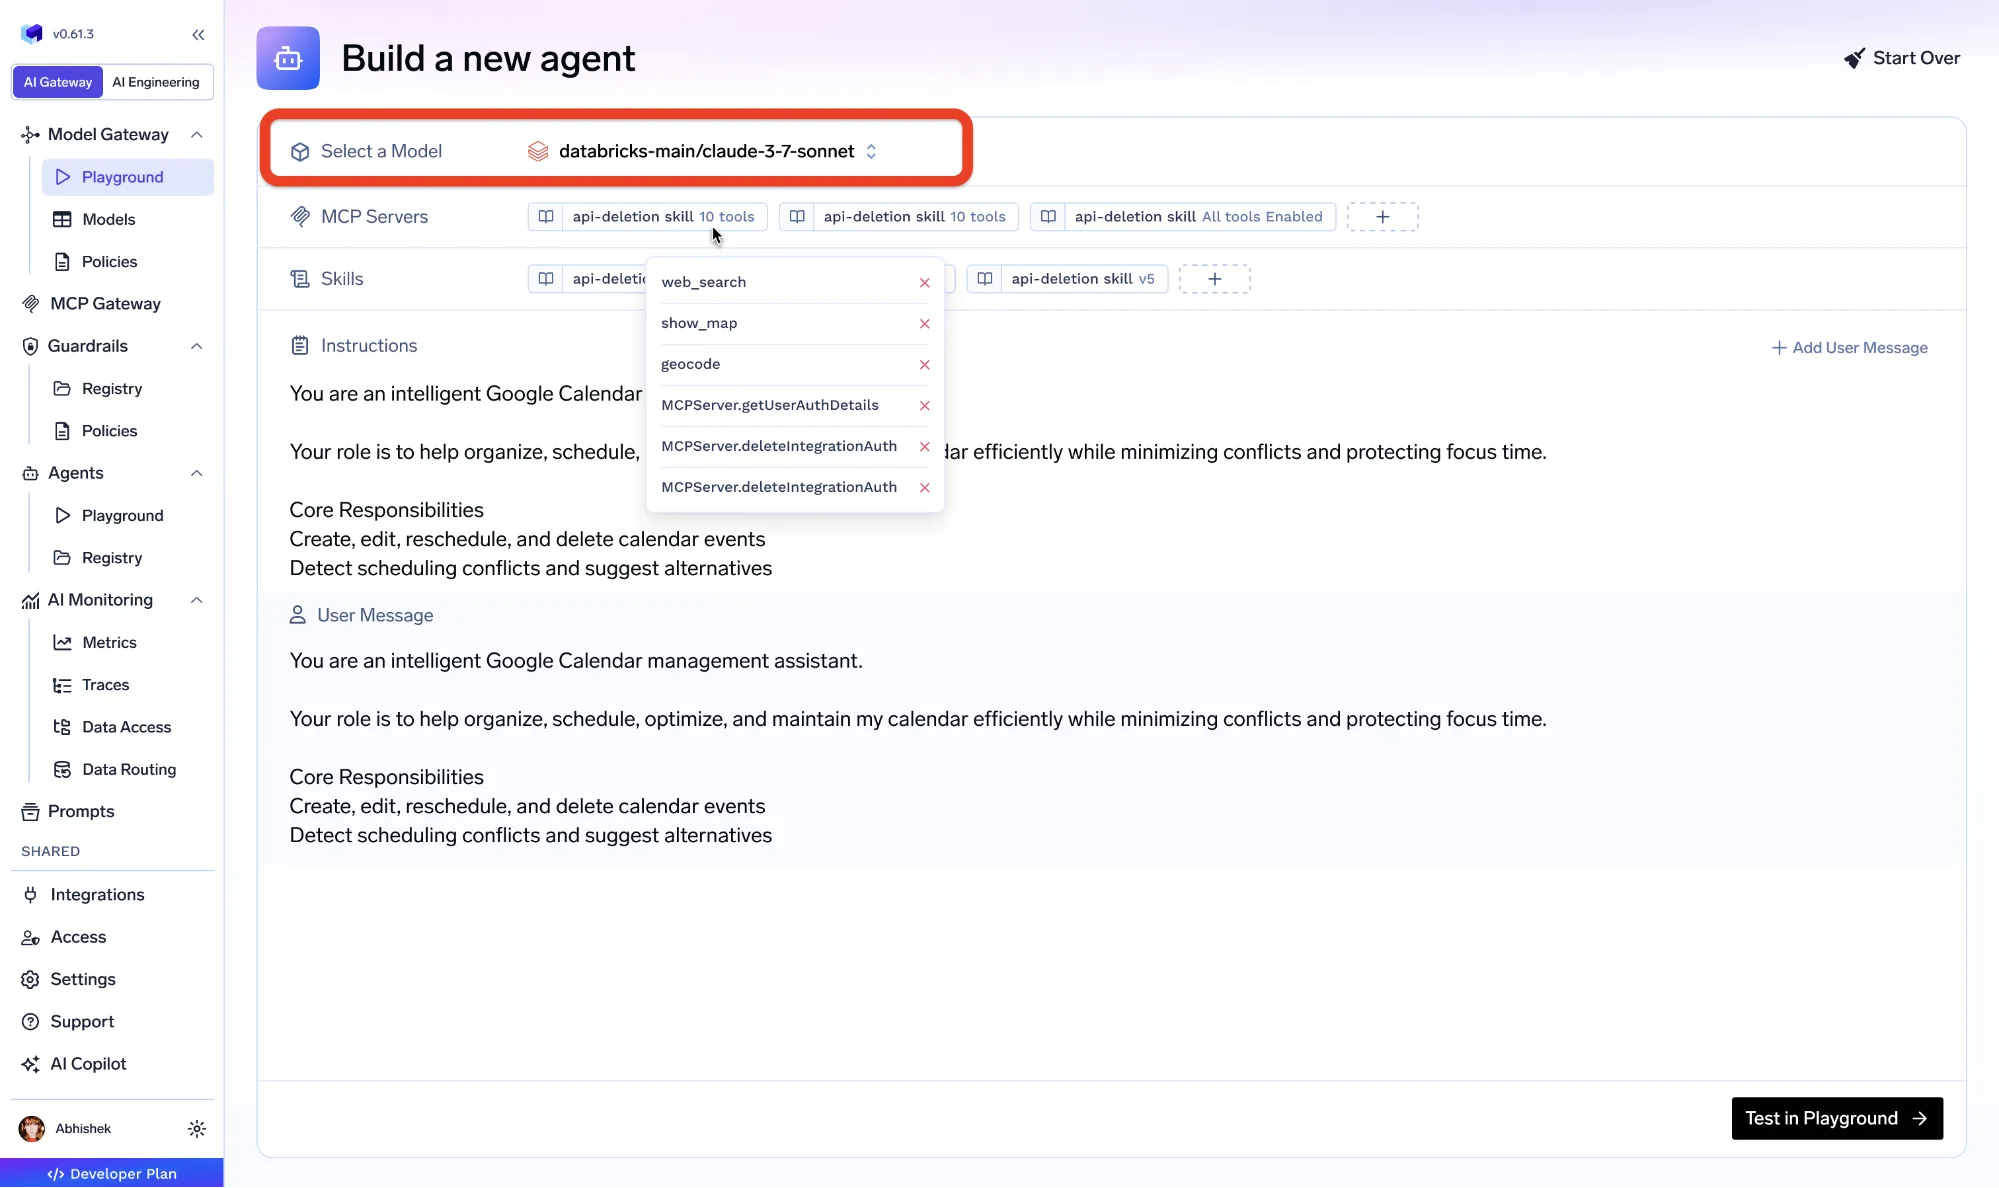
A diferença em relação a outros produtos de agentes gerenciados é onde as credenciais residem. Em vários deles, você fornece chaves de API do provedor ao criar um agente ou as registra por workspace. Na TrueFoundry, o acesso ao modelo é gerenciado uma única vez na camada de gateway e os agentes simplesmente referenciam os nomes dos modelos.
Como a governança reside no gateway, uma equipe de plataforma pode adicionar um novo provedor, rotacionar uma chave ou alterar uma política sem que ninguém precise tocar na definição do agente. Isso é portabilidade em nível de frota, não apenas para um único agente.
Portabilidade não se trata apenas de trocas manuais. Um modelo virtual permite que um agente chame um nome estável enquanto o gateway decide qual modelo real atenderá a cada solicitação, usando roteamento baseado em peso, prioridade, latência ou complexidade, com tentativas de reenvio e fallbacks entre provedores integrados. Se um provedor retornar um erro ou exceder o tempo limite, a solicitação é redirecionada automaticamente para o próximo candidato, para que uma interrupção em um fornecedor não derrube seus agentes.
name: smart-chat
type: gateway-load-balancing-config
rules:
  - id: primary-with-fallback
    type: priority-based-routing
    when:
      models: ["my-group/smart-chat"]
    load_balance_targets:
      - target: openai-main/gpt-4o
        priority: 1
        fallback_status_codes: ["429", "500", "502", "503"]
      - target: anthropic-main/claude-sonnet-4
        priority: 2      # takes over automatically if the primary fails
O Roteamento Automático vai um passo além ao classificar cada solicitação como simples, média ou complexa e enviá-la para o modelo mais barato capaz de processá-la. Nos benchmarks da TrueFoundry, isso reduziu os custos de 50 a 70 por cento, mantendo cerca de 98 por cento da qualidade. O agente continua chamando um único nome de modelo. A portabilidade é o que torna tudo isso uma decisão de configuração, em vez de uma reescrita.
O motivo estratégico para se preocupar com a portabilidade é o poder de negociação. Quando mudar de provedor exige apenas uma linha de alteração, você nunca fica preso a um modelo que se tornou mais caro, mais lento ou simplesmente ultrapassado. Você pode realizar um teste comparativo entre dois modelos com tráfego real de agentes, transferir uma porcentagem das solicitações para o desafiante com roteamento baseado em peso e promovê-lo quando ele vencer, tudo sem um projeto de migração.
Isso também mantém modelos auto-hospedados como cidadãos de primeira classe. Como o gateway atua como interface para modelos de pesos abertos em backends como o vLLM da mesma forma que faz com APIs comerciais, um agente pode alternar entre um modelo de fronteira hospedado e um modelo rodando em seu próprio cluster sem notar a diferença. Essa opcionalidade é difícil de recuperar quando os agentes estão vinculados a um único fornecedor, e é por isso que construir a portabilidade desde o início é mais importante do que parece. Isso combina naturalmente com identidade de agente distintaecontrole de acesso: o agente permanece o mesmo principal com as mesmas permissões, independentemente de qual modelo o atenda.
O gateway faz tudo isso no caminho crítico sem se tornar um gargalo, adicionando cerca de 3 a 4 ms de sobrecarga e sustentando mais de 350 RPS em uma única vCPU em mais de 1.000 modelos.
A portabilidade de agentes de IA transforma a constante rotatividade de lançamentos de modelos de um passivo em uma vantagem. Quando o modelo por trás de um agente é um nome que o gateway resolve, e não um SDK e uma chave embutidos no código, você pode adotar o melhor modelo do mês, usar fallbacks entre provedores durante uma interrupção e rotear tráfego barato para modelos menores, tudo sem reconstruir nada. É isso que mantém uma frota de agentes flexível em vez de estagnada.
Veja como a TrueFoundry permite que seus agentes alternem entre mais de 1.000 modelos a partir de um único plano de controle. Agende uma demonstraçãooucomeçar gratuitamente.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada





















