



October 9, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Published: October 9, 2026

Blazingly fast way to build, track and deploy your models!
Um endpoint de modelo bruto retornará prontamente dados pessoais, aceitará um payload de injeção de prompt ou fornecerá uma resposta insegura. Os guardrails corrigem isso inspecionando e, quando necessário, reescrevendo o tráfego antes que ele chegue ao modelo e antes que a resposta chegue ao usuário.
Colocar guardrails no AI Gateway significa que cada aplicação recebe a mesma proteção automaticamente, sem que cada equipe precise reimplementar a segurança. O TrueFoundry oferece guardrails integrados para redação de PII e detecção de injeção de prompt, ambos totalmente gerenciados e sem a necessidade de configurar chaves de terceiros.
Como o documentação de guardrails explica, aplicar guardrails no AI Gateway é um processo de duas etapas.
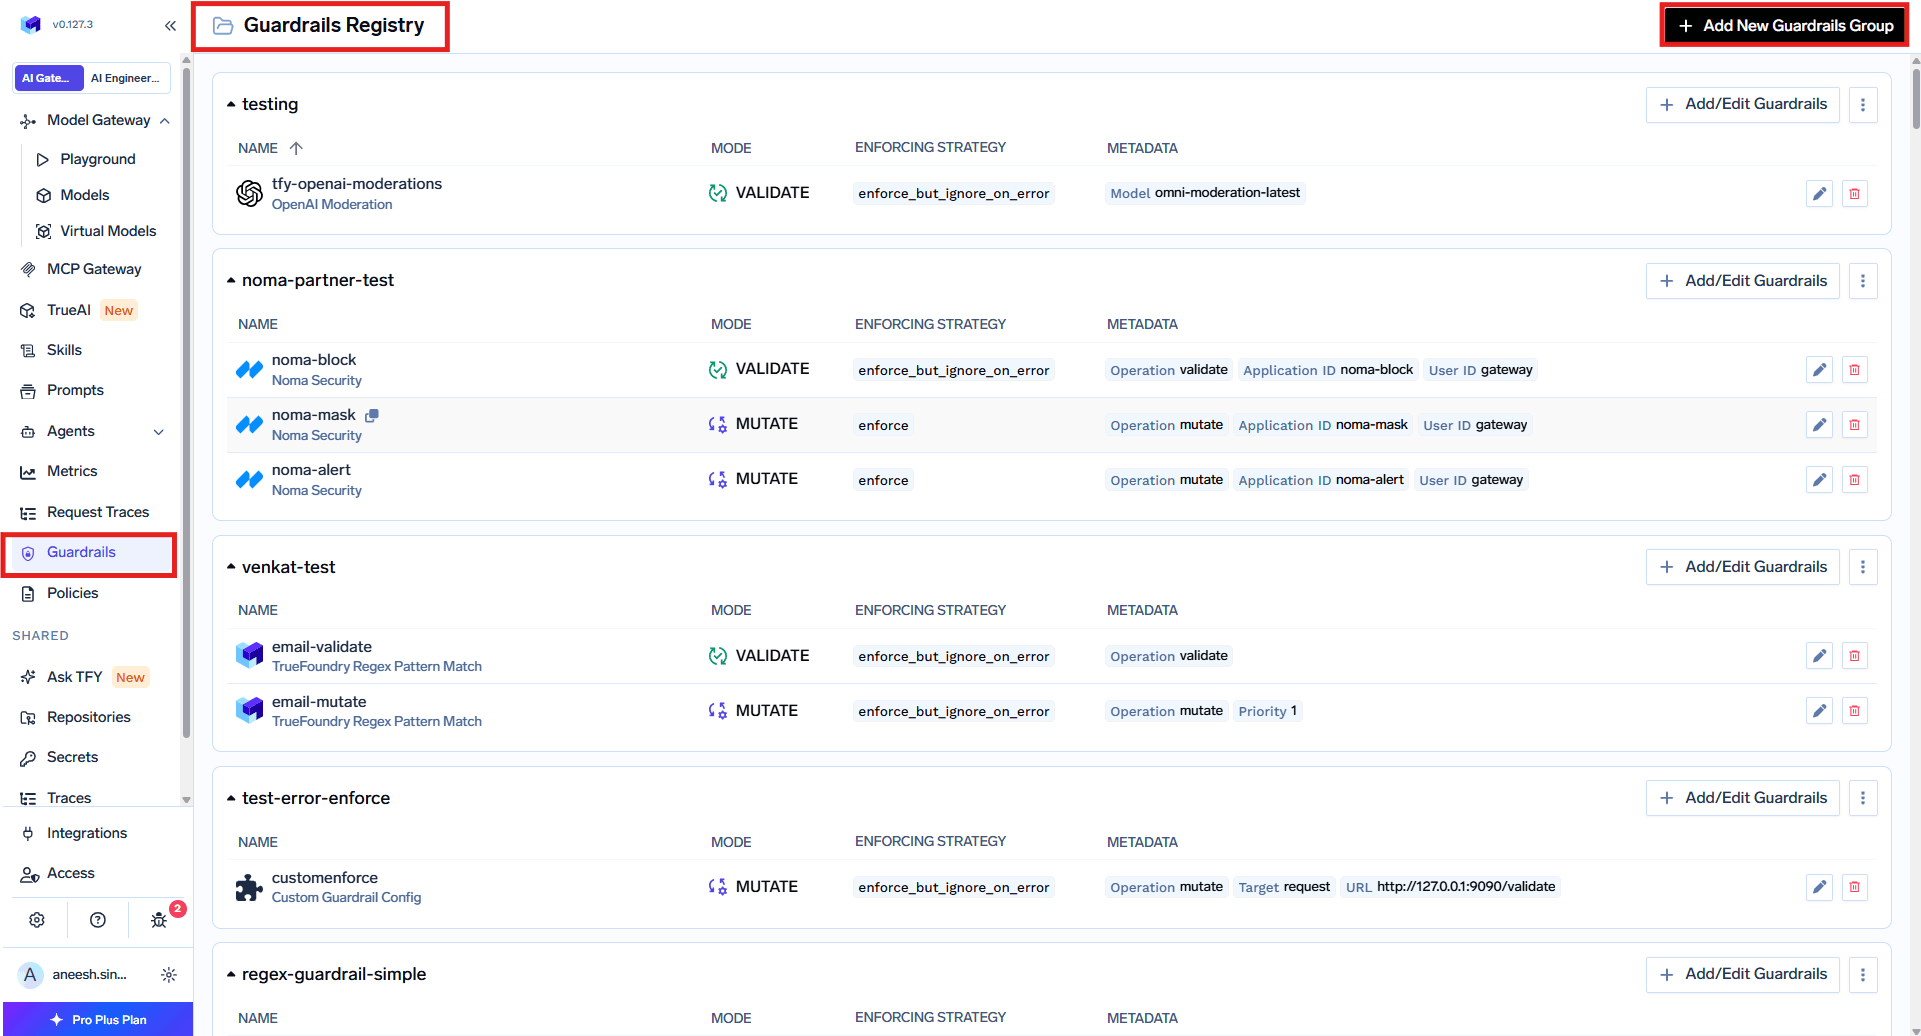
Em Policies, depois Guardrails, clique em Add Rule. Cada regra possui um ID de regra exclusivo e algumas seções que determinam a quem ela se aplica e onde ela é executada.
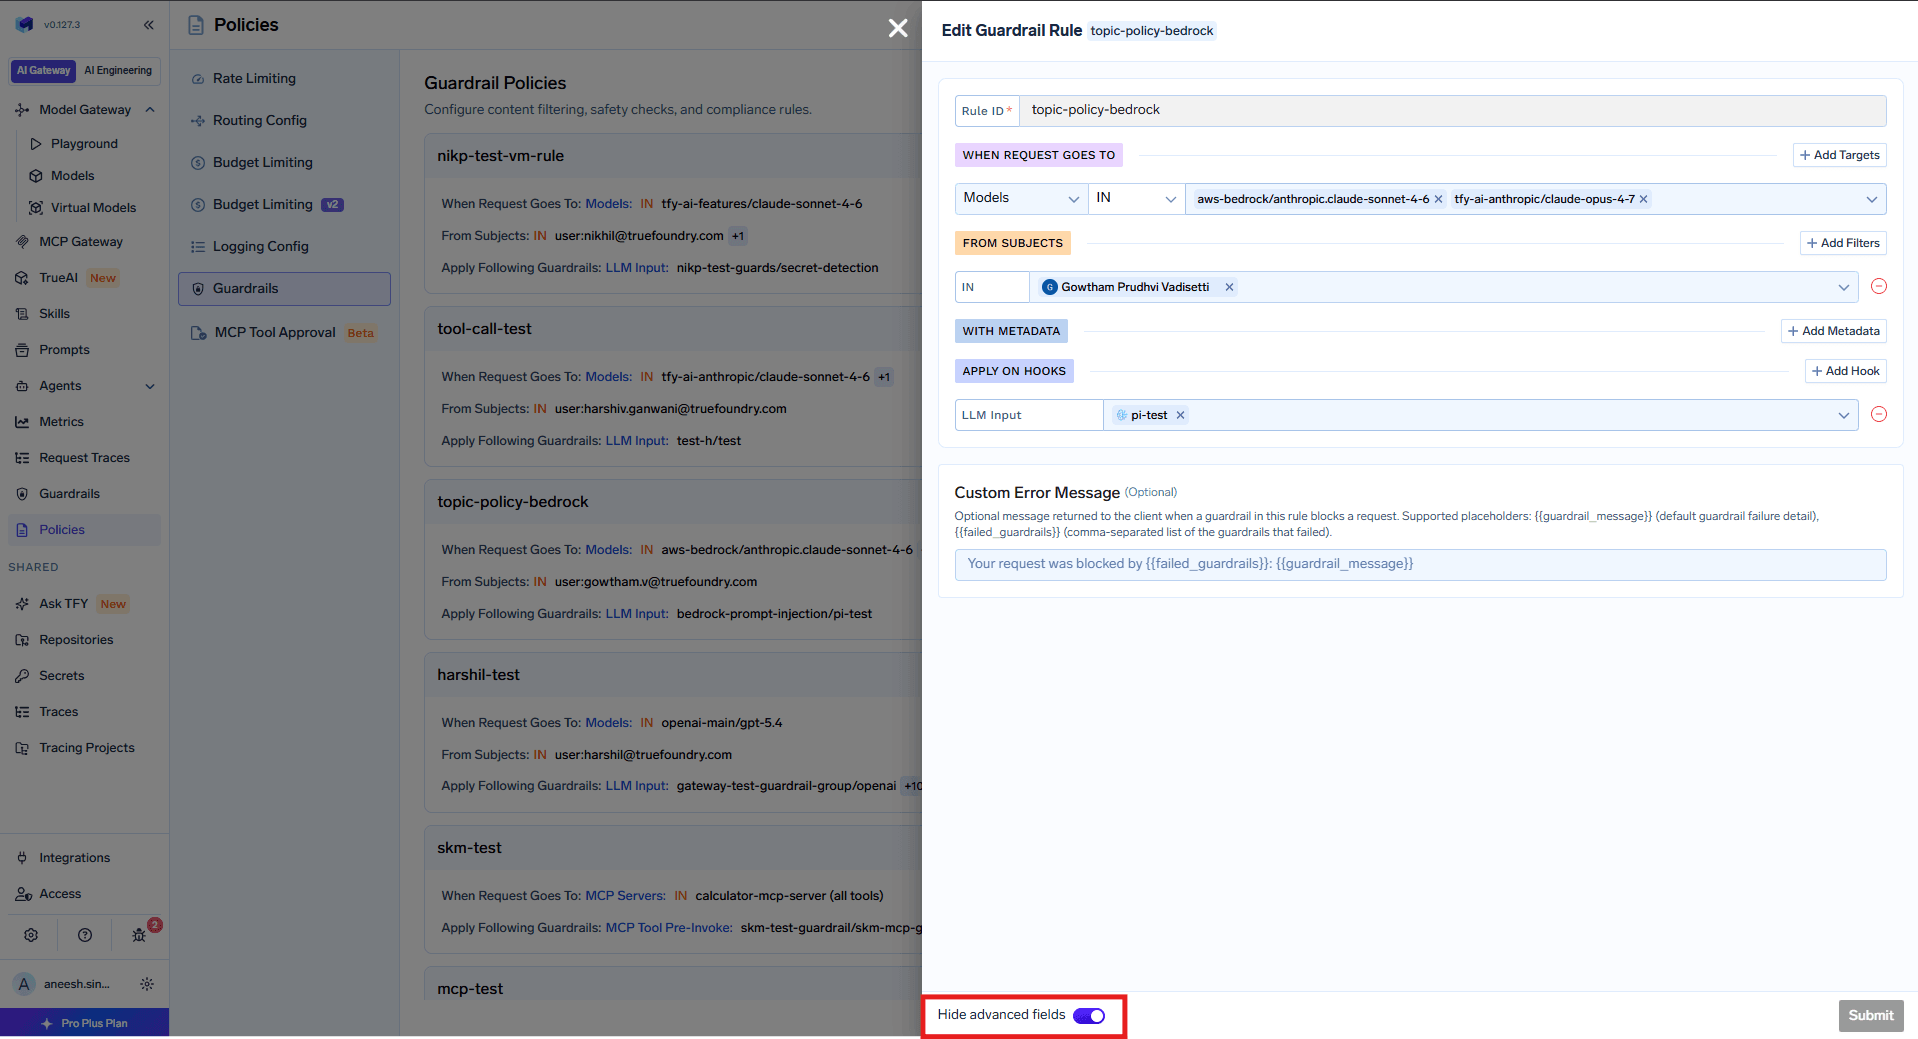
Todas as regras são avaliadas para cada solicitação, e as guardrails de todas as regras correspondentes são combinadas e aplicadas em conjunto. Se uma regra aplica detecção de PII na entrada de LLM e outra aplica detecção de injeção de prompt na entrada de LLM, ambas são executadas.
OGuardrail de detecção de PII e PHI é uma guardrail nativa do TrueFoundry que identifica e redige informações de identificação pessoal (PII) e informações protegidas de saúde (PHI). Ela é alimentada pela detecção de PII do Azure AI Language e é totalmente gerenciada, portanto, não há necessidade de chaves de API de terceiros.
Ela suporta apenas o modo de mutação, o que significa que sempre redige as entidades detectadas. No formulário de configuração, você define um nome, escolhe as categorias de PII ou mantém o padrão de todas as categorias e escolhe uma estratégia de imposição. Os valores detectados são substituídos por asteriscos, de modo que um número de telefone e um e-mail em uma mensagem são mascarados antes mesmo que o modelo os veja.
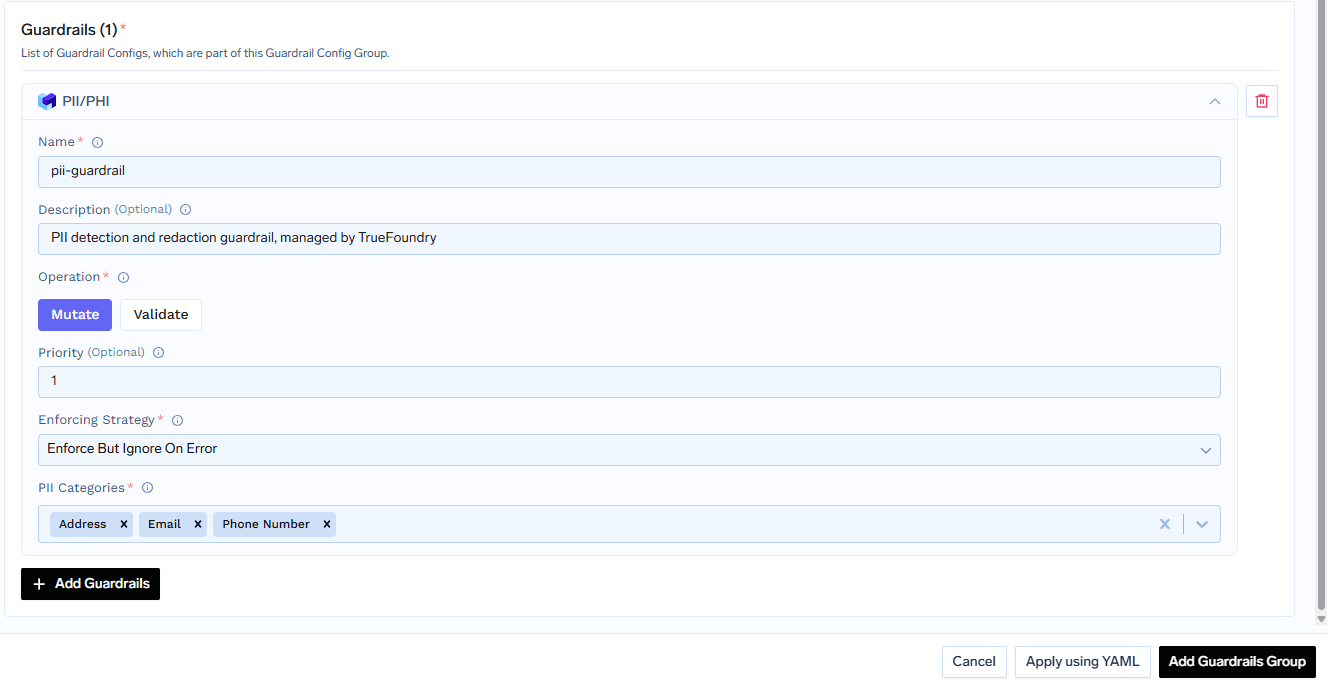
Uma configuração comum aplica a redação de PII na entrada do LLM para limpar as mensagens do usuário, na saída do LLM para limpar as respostas e nos hooks do MCP para remover PII dos parâmetros e resultados das ferramentas, como linhas de banco de dados.
Omecanismo de proteção contra injeção de prompt é um mecanismo de proteção integrado, potencializado pelo Azure Prompt Shield. Ele detecta injeção direta de prompt, ataques de jailbreak, como o padrão "do anything now", e injeções indiretas ocultas em documentos ou conteúdos de contexto. Ele analisa o prompt do usuário e o conteúdo do documento separadamente.
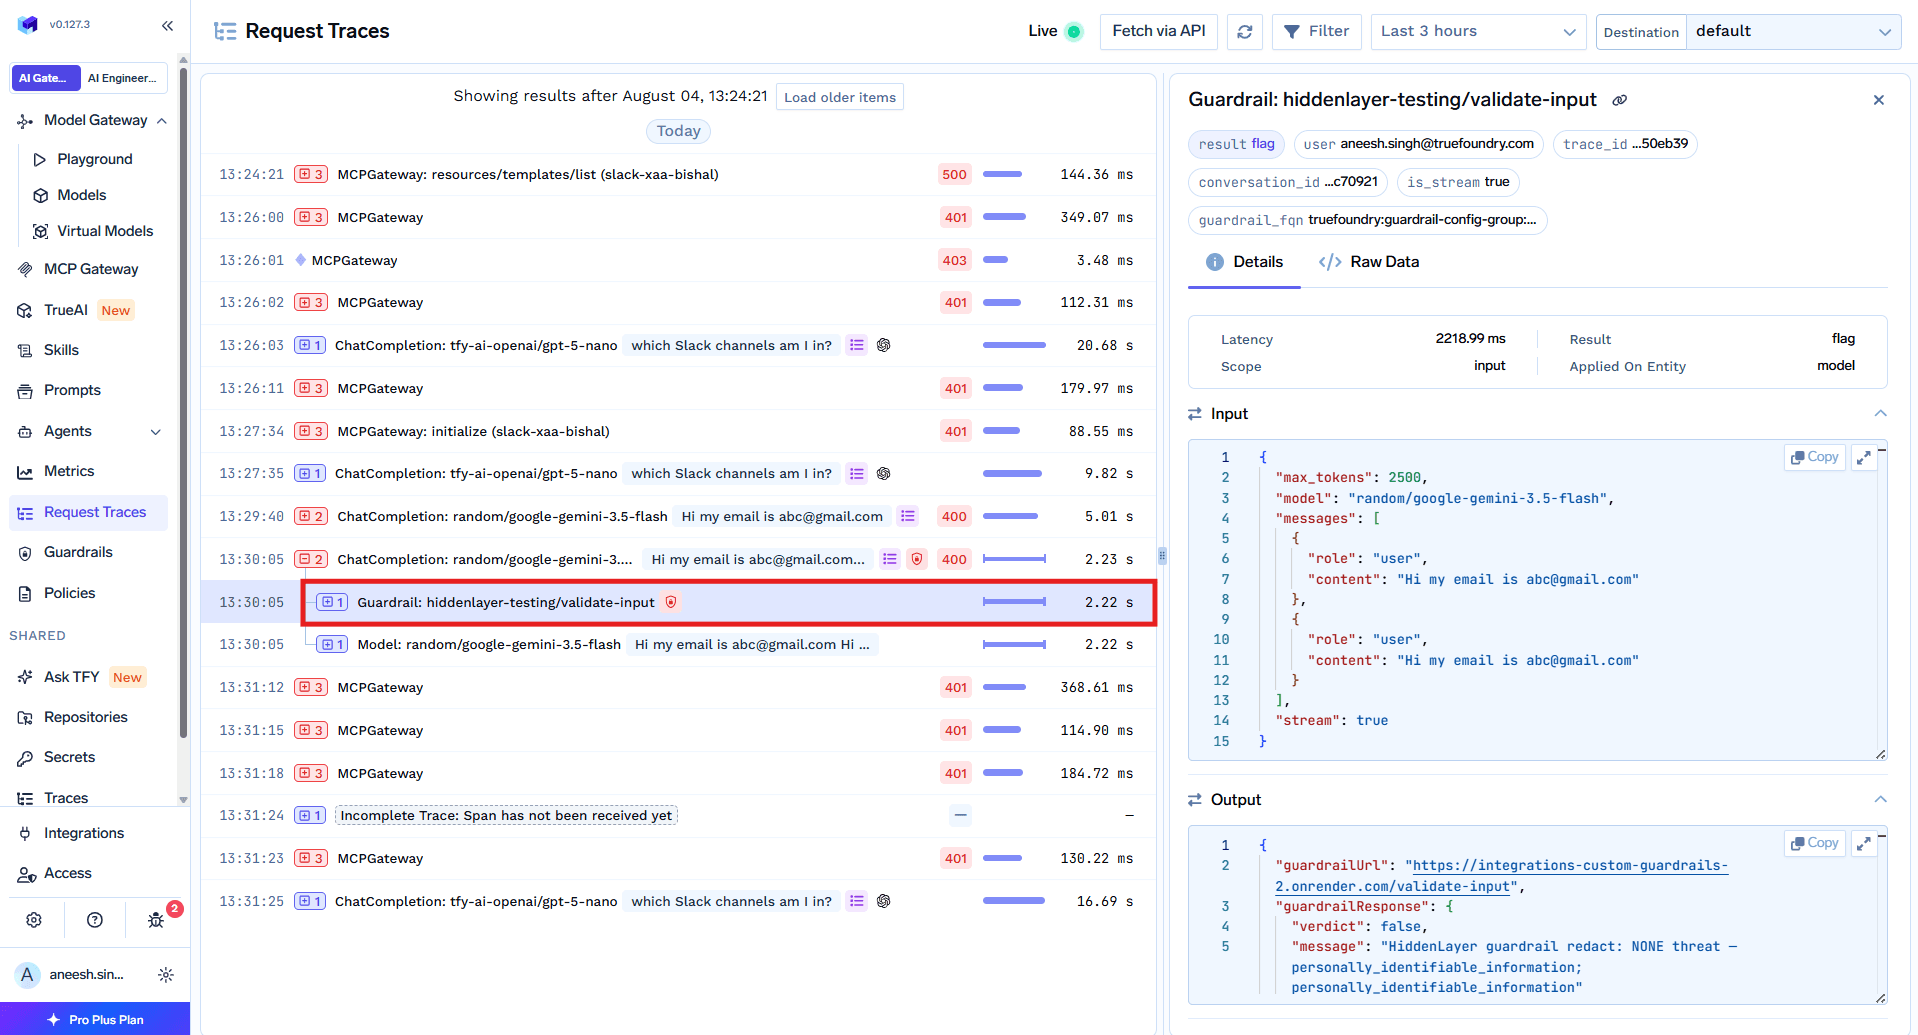
Ele suporta apenas o modo de validação, o que significa que detecta e bloqueia ataques, mas não modifica o conteúdo. A configuração solicita apenas um nome e uma estratégia de aplicação. A documentação recomenda começar com a estratégia de auditoria para monitorar detecções nos rastreamentos de solicitação e, em seguida, mudar para a aplicação (enforce) assim que você confiar no sistema.
Em uma solicitação de LLM, os mecanismos de proteção de mutação de entrada são executados primeiro e bloqueiam o processo até serem concluídos, como, por exemplo, ao redigir PII do prompt. A validação de entrada, como a de injeção de prompt, é executada em segundo plano enquanto a solicitação do modelo está em andamento. Se a validação de entrada falhar enquanto o modelo ainda estiver processando, o gateway cancela a solicitação do modelo imediatamente para que você não pague por ela.
Após o modelo responder, a mutação de saída pode remover segredos, e a validação de saída verifica o resultado final antes que ele chegue ao cliente. Para ferramentas MCP, todos os mecanismos de proteção pré-ferramenta são executados antes que a ferramenta seja chamada e, se algum falhar, a ferramenta nunca é executada. Os mecanismos de proteção são executados em cada chamada de ferramenta separadamente.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.


TrueFoundry ships built in PII and PHI detection, powered by Azure AI Language, and prompt injection detection, powered by Azure Prompt Shield. Both are fully managed, with no external credentials required. You can also add external providers or custom guardrails.
On four hooks: LLM Input, LLM Output, MCP Tool Pre-Invoke, and MCP Tool Post-Invoke. You attach guardrails to the hooks you want in a policy rule, and multiple guardrails can run on the same hook.
If input validation fails while the model request is in flight, the gateway cancels that model request so you do not pay for it. Output validation runs after the model responds, so in that case the model cost is already incurred.
Start with the audit enforcing strategy so detections are recorded in request traces without blocking traffic. Once you are confident in the results, switch the strategy to enforce.



As últimas notícias, artigos e recursos enviados para sua caixa de entrada
















