Blank white background with no objects or features visible.

「Gartner Hype Cycle for AI Governance 2026」の全編を無料で公開しています。レポートを入手する →

LLMフォールバックとは?定義、仕組み、および実装方法

By アシシュ・ドゥベイ

Updated: October 12, 2026

Published: July 28, 2026

TrueFoundry LLM gateway implements automatic LLM fallback in production
⚡ TL;DR

LLM fallback keeps AI applications available when the primary model or provider fails, slows down, or reaches capacity limits. Enterprises need controlled routing, bounded retries, health monitoring, and production observability.

Which areas enterprise teams should prioritize
  • Define fallback triggers:Set clear thresholds for errors, latency, rate limits, and output quality.
  • Build provider diversity: Configure alternative models across providers, regions, and deployment environments.
  • Control retry behavior: Use bounded retries, exponential backoff, and circuit breakers before rerouting requests.
  • Preserve response quality: Validate fallback models for accuracy, compatibility, context limits, and tool support.
  • Monitor every route: Track fallback frequency, recovery success, latency, costs, and exhausted chains.
  • Centralize reliability controls:TrueFoundry manages routing, retries, and LLM fallback across providers from one gateway.

大規模言語モデル(LLM)を利用するアプリケーションは、推論リクエストのたびにAIモデルプロバイダーに依存しています。OpenAI、Anthropic、Googleなどがサービスを提供していますが、レート制限、障害、レイテンシの急増を完全に排除できるLLMプロバイダーは存在しません。そのため、プロバイダー側の問題がLLMアプリケーションやワークフローを停止させる可能性があります。

フォールバック経路がなければ、リクエストが失敗したり、応答目標を超過したり、ユーザー体験の一貫性が損なわれたりする恐れがあります。このパターンは、最初のルートが定義された要件を満たせなかった場合に、影響を受けたリクエストを別のモデルやプロバイダー経由で送信するものです。これにより、インフラの障害をユーザーに意識させることなく、サービスの継続性を維持できます。

本番環境のシステムで複数のモデル、リージョン、プロバイダーを使用する場合、信頼性の高い実装が不可欠です。 LLMゲートウェイ は、ルーティング、回復力、ポリシー適用を単一のインターフェースで一元管理できます。このアーキテクチャにより、開発チームはプロバイダー固有の復旧ロジックをアプリ全体に埋め込む必要がなくなります。

LLM Fallback Without a Gateway Means Rewriting Application Code Every Time

TrueFoundry's LLM Gateway handles multi-provider fallback, retries, and circuit breakers inside your VPC with zero application code changes.

LLMフォールバックとは?

この信頼性パターンは、プライマリモデルが定義された可用性、レイテンシ、品質の要件を満たせなかった場合に、自動的にリクエストを転送します。トリガーには、HTTP 429エラー、サーバーエラー、ネットワークエラー、または設定されたタイムアウトなどが含まれます。その後、リクエストは代替ルートを通じて適切なフォールバックモデルへと送られます。

LLMフォールバックの意味は、単なるエラー復旧にとどまりません。これはモデルアクセスアーキテクチャにおける回復力レイヤーを意味します。このアプローチにより、単一のLLMプロバイダーへの依存度が下がり、プロバイダーが不安定な状況でもアプリケーションの可用性を維持できるようになります。

フォールバックは、プロバイダー、モデル、リージョン、または品質しきい値をまたいで機能します。単一のモデルであっても、同じプロバイダー内の別のデプロイメントにフォールバックすることが可能です。選択する設計は、プロンプト、トークン、コンテキストウィンドウ、ツールサポート、応答形式全体で互換性を維持できるものである必要があります。

LLMフォールバックの仕組み

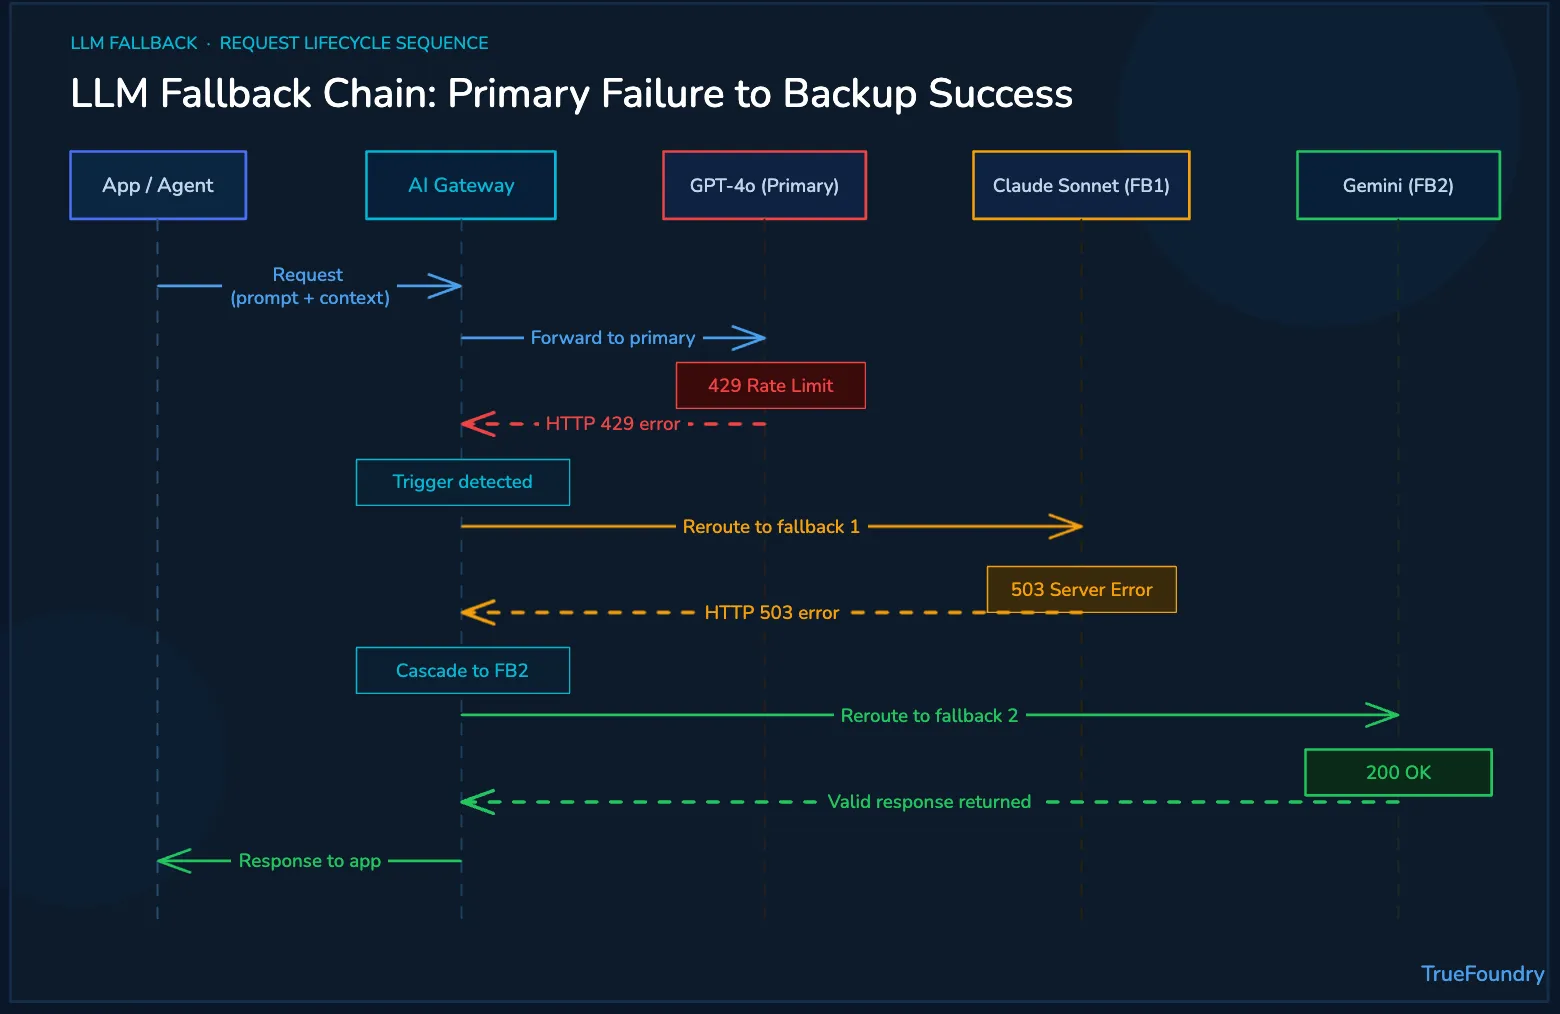
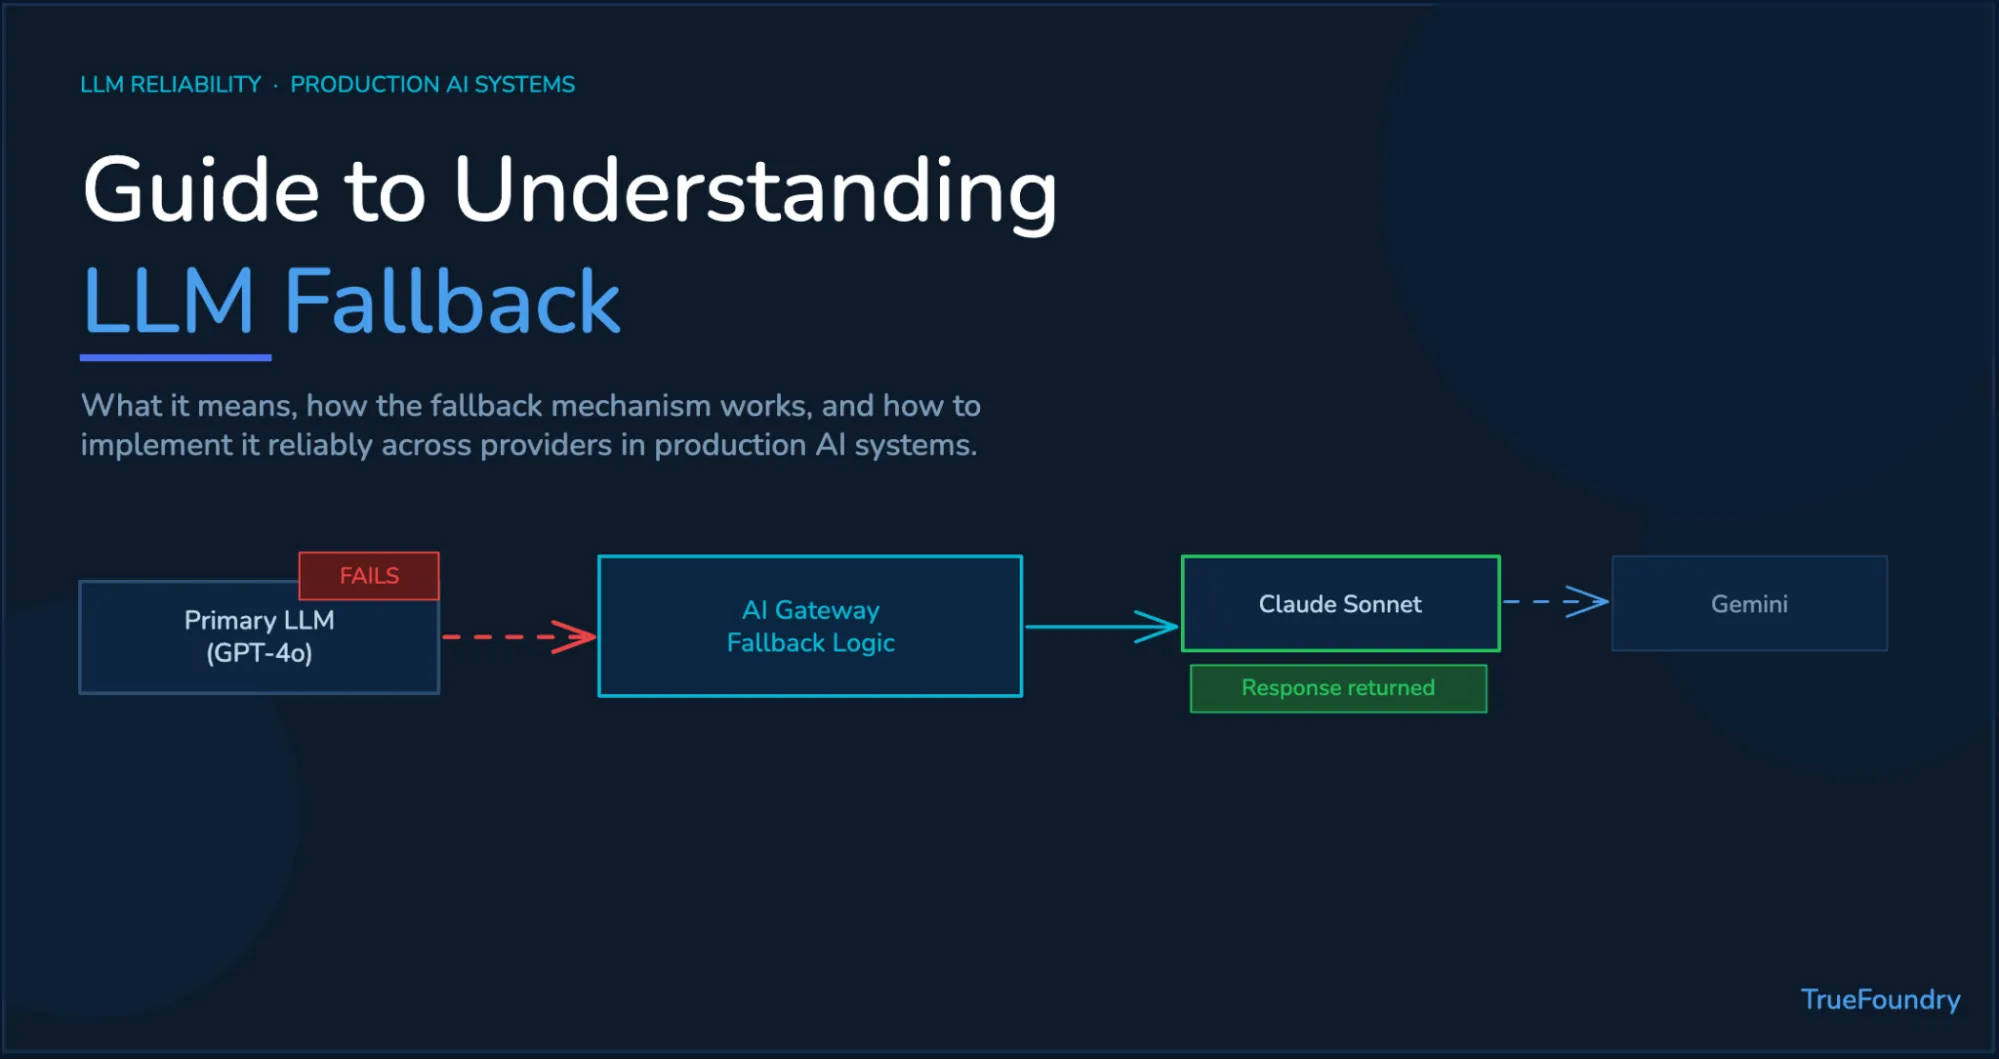
LLMフォールバックのメカニズムは、リクエスト失敗後の制御されたシーケンスに従います。ルーターがトリガーを評価し、設定されたフォールバックチェーンを読み取り、次に適格なターゲットを選択します。その後、元のプロンプト、コンテキスト、生成設定が選択されたフォールバックルートを通じて送信されます。

  • トリガーの検出: リクエストがレート制限、サーバーエラー、接続失敗、または許容できない出力に遭遇します。
  • プロバイダーの選択: ルーティングレイヤーが、アクティブな 設定内で割り当てられた優先順位を確認します。
  • リクエストの再ルーティング: プロキシは、元のペイロード、関連ヘッダー、および生成パラメータを転送します。
  • フォールバックカスケード: いずれかのターゲットが成功するか、チェーンがすべて試行されるまでルーティングが継続されます。
  • 復旧監視: サーキットブレーカーが異常なターゲットを切り離し、ヘルスチェックによって可用性を測定します。

リトライは、プロバイダーを変更する前に一時的な障害に対処するものであるべきです。制限付きポリシーでは、再ルーティングの前に指数バックオフ、ジッター、およびレスポンスガイダンスを使用します。OpenAIはランダム化されたバックオフを推奨しており、Anthropicはレート制限、タイムアウト、過負荷時のレスポンスに関するドキュメントを提供しています。

Sequence diagram of LLM fallback chain routing across three providers

LLMフォールバックとLLMフェイルオーバー:その違いとは?

フォールバック、フェイルオーバー、リトライは、それぞれ異なる運用範囲で関連する問題を解決します。フォールバックは個別のリクエスト失敗を処理し、フェイルオーバーは継続的な障害発生時にトラフィック全体をリダイレクトします。リトライは、別のターゲットに送信する前に、同じエンドポイントに対してリクエストを繰り返します。

Concept Typical trigger Operating scope Expected behavior
Request fallback Request error, rate limit, or timeout Individual request Transparently tries another model
Failover Sustained outage or provider degradation Traffic segment Shifts requests from the affected target
Retries Temporary error from the same endpoint Repeated request Tries briefly before fallback begins

これらの一般的なパターンは、通常、回復力のあるアーキテクチャ内で連携して機能します。制限付きのリトライであれば、プロバイダーを変更することなく短期間のエラーを解決できる場合があります。 LLMロードバランシング は通常のトラフィックを分散させ、フェイルオーバーは継続的な停止時の可用性を保護します。フォールバックは、リクエストレベルで残りの障害を処理します。

LLMフォールバック戦略の種類

さまざまなフォールバック戦略が、可用性、品質、コスト、およびプロバイダーの独立性をサポートします。各戦略には、明確なトリガー条件と互換性のあるモデル機能が必要です。チームは、ルートの優先順位を定義する前に、予想されるレイテンシ、出力品質、コンテキスト制限、およびツールサポートを比較検討する必要があります。

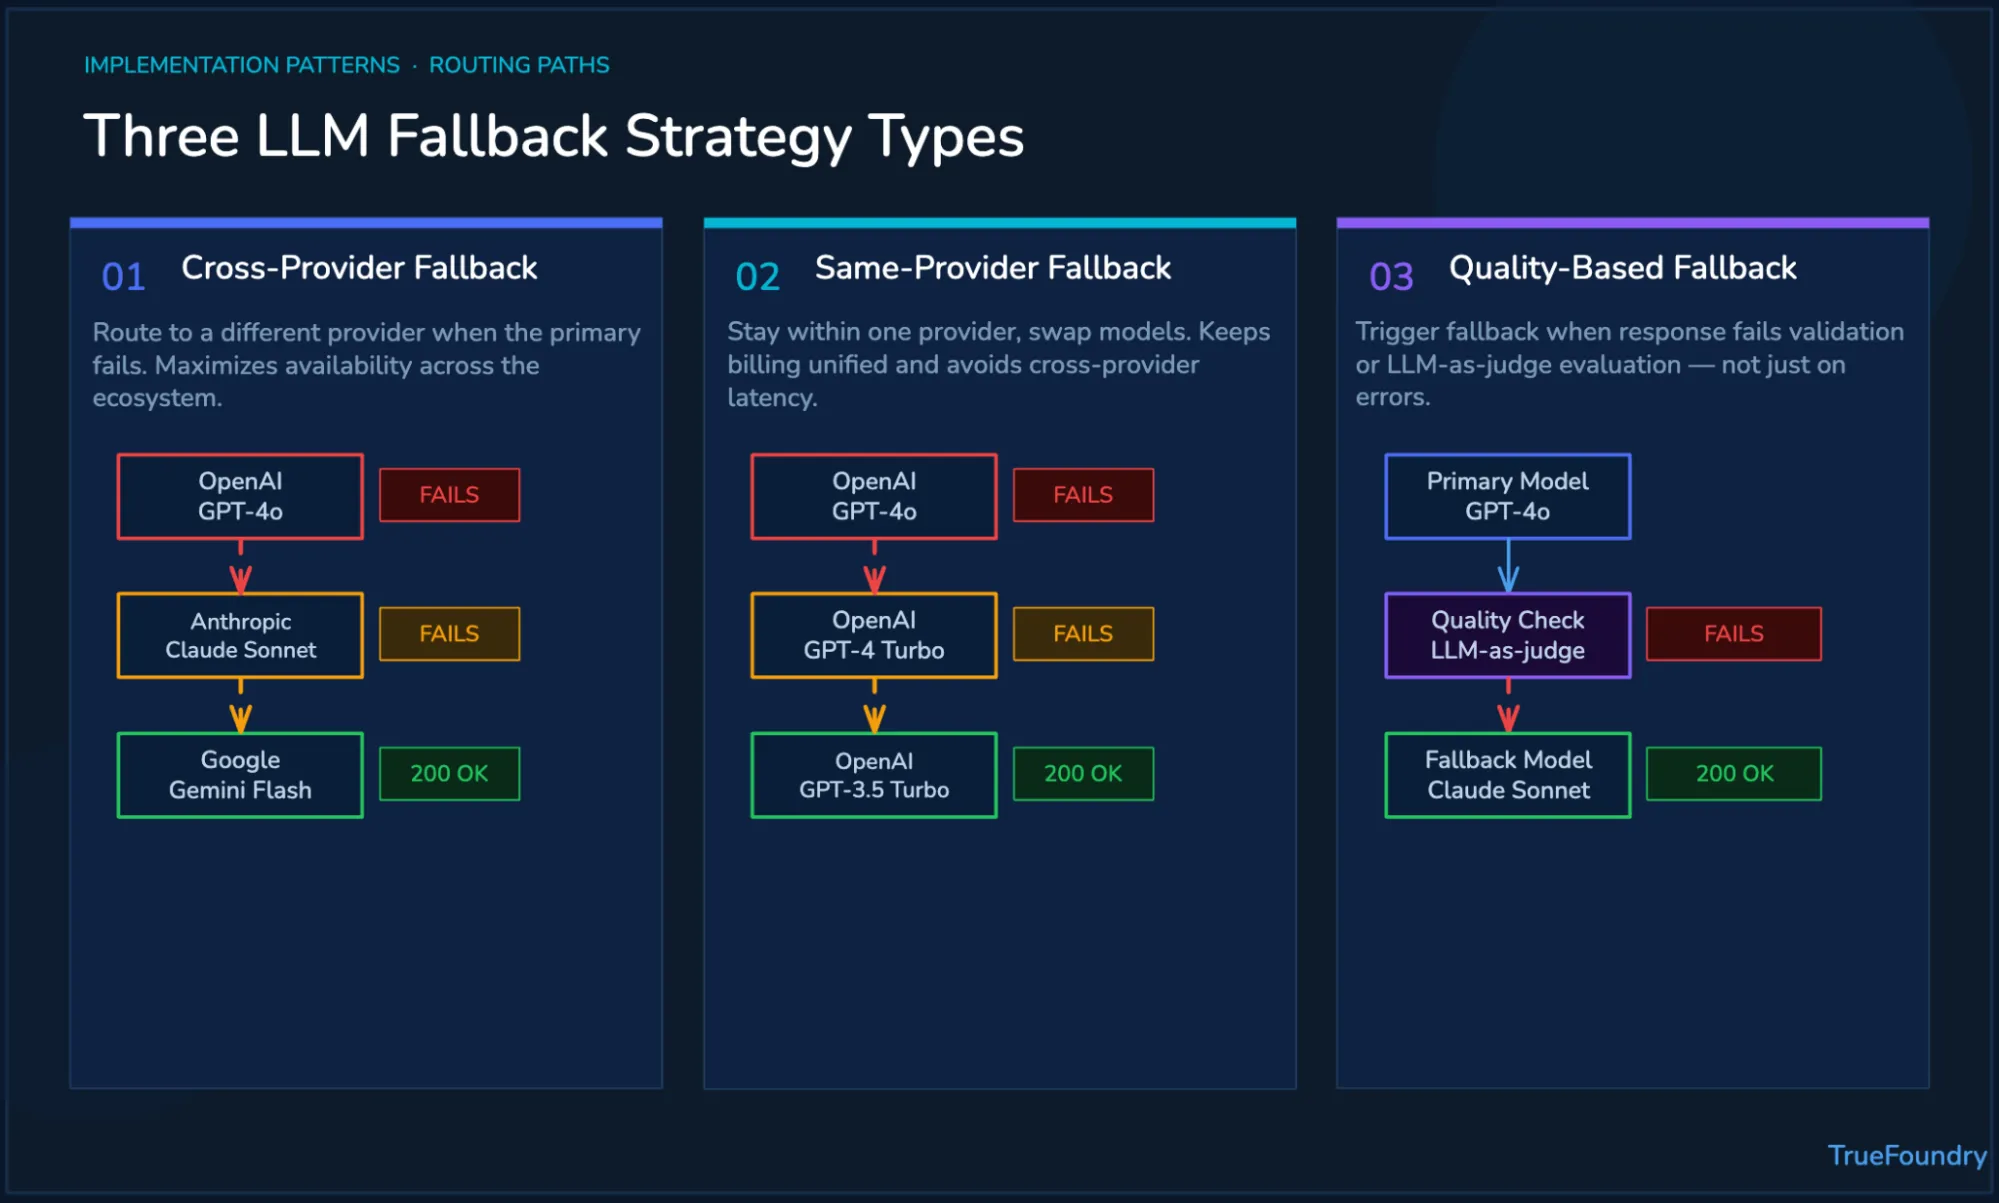
  • プロバイダー間フォールバック: プライマリプロバイダーが失敗した場合、ルーティングをOpenAIからClaudeやGeminiへ切り替えることができます。
  • 同一プロバイダー内フォールバック: Claude Opusへのリクエストが失敗した場合、別のAnthropicモデルへルーティングできます。
  • 品質ベースのフォールバック: 無効なJSON、ポリシー違反、または低い評価スコアをトリガーとして、別のモデルへフォールバックできます。
  • コスト意識型フォールバック: 安価なモデルは単純なリクエストを処理し、より大規模なモデルは複雑なワークロードを処理します。

効果的なレート制限は、制御不能なルーティングの切り替えを引き起こすのではなく、各戦略と連携する必要があります。一元的な レート制限制御 は、ユーザー、モデル、アプリケーション、環境全体にわたってクォータを適用できます。Googleは、Geminiのワークロードが適用されるクォータを超過した場合、HTTP 429レスポンスを返すよう定めています。

Three LLM fallback strategies illustrated with routing paths

ゲートウェイなしでLLMのフォールバックを構築するのが難しい理由

アプリケーションコード内にフォールバックロジックを構築することは、開発初期段階では管理可能に見えます。しかし、複数のプロバイダー、モデルバージョン、環境にまたがる構成になると複雑さが増します。各SDKは、それぞれ異なるエラー、デフォルト値、レスポンス構造、リトライ動作を公開しているためです。

  • 認証情報の管理が煩雑になる: APIキーが個別に存在すると、プロバイダー統合ごとのセキュリティ対策の手間が増加します。
  • タイムアウト設定の不備: 障害検知が遅れると、次のモデルにトラフィックが引き継がれるまでのレイテンシが増大します。
  • 連鎖的なリトライの嵐: 無制限のリトライは負荷を高め、プロバイダーの障害発生時に失敗率を悪化させます。
  • 可観測性の制限: カスタムコードでは、ルーティングの選択やリカバリの試行全体にわたる完全なメトリクスを可視化することは困難です。
  • インターフェースの不整合: Pythonクライアント、JSONペイロード、プロバイダー固有のフォーマットなど、アダプターの継続的なメンテナンスが必要になります。

チームがゲートウェイの選択肢を比較する際、Portkey、Bifrost、Vercelなどが検討対象となるでしょう。どのプラットフォームを選択するにせよ、ベストプラクティスとして、制限付きリトライ、ヘルスチェックに基づくルーティング、安全な認証情報管理、そして測定可能なリカバリが求められます。強力な LLMの可観測性 は、レイテンシ、エラー、フォールバックの頻度、そして最終的な成功率を示す必要があります。

TrueFoundryがゲートウェイ層でLLMフォールバックを実装する方法

TrueFoundry AI Gatewayは、 TrueFoundry AI Gateway モデルへのアクセス、ルーティング、信頼性制御、およびオブザーバビリティを一元管理します。グローバルなルーティング設定により、単一の管理レイヤーから負荷分散、フェイルオーバー、リトライルールを適用可能です。アプリケーション側では、プロバイダーごとにリカバリロジックを構築し直す必要がなく、単一のAPIを利用できます。

メインのプロバイダーと代替ターゲットを組み合わせたチェーン構成をサポートしています。プロバイダーの一時的なエラーに対しては自動リトライが機能し、それでも解決しない場合は自動的にルーティングを切り替えます。継続的なヘルスモニタリングにより、障害発生時の復旧遅延を最小限に抑えます。

  • 設定可能なチェーン: OpenAI、Claude、Gemini、またはカスタムエンドポイントを優先順位に従って定義できます。
  • 自動リカバリ: リトライ、サーキットブレーカー、ヘルスチェックを組み合わせ、サービスの継続性を確保します。
  • ルーティングの可視化: 選択されたプロバイダー、レイテンシ、エラー、トークン使用量、フェイルオーバーの結果を追跡できます。
  • 柔軟なデプロイメント: VPC内、オンプレミス、または管理されたクラウド環境でゲートウェイを実行可能です。
  • 統一されたアクセス: プロバイダーのAPIやモデルの変更に関わらず、一貫したインターフェースを維持します。

AIエージェント向けには、Agent Gatewayがマルチステップ実行を制御します。また、 MCP Gateway が接続されたエンタープライズツールへのアクセスを管理します。これらを組み合わせることで、特定のモデルルートが利用不能になった場合でもシステム全体を保護します。

TrueFoundryのAI Gatewayで、回復力の高いAIアプリケーションを構築しましょう。プロバイダーを横断したルーティング、リトライ、オブザーバビリティ、LLMフェイルオーバーを一元化します。 無料デモを予約する 今すぐ始める。

結論

LLMのフォールバックは、外部モデルを利用する信頼性の高いアプリケーションにおいて不可欠なアーキテクチャ要件です。プロバイダー側の制限や一時的な障害は避けられません。アプリケーションは、こうした状況を吸収し、ユーザーに影響が及ばないようにする必要があります。

アプリケーションレベルでの実装も可能ですが、マルチモデル環境では複雑さが増大します。ゲートウェイを導入することで、リトライルール、フォールバック順序、ヘルスチェック、認証情報、監視を一元管理できます。このアプローチにより、アプリケーションコードをプロバイダー固有の挙動から切り離し、耐障害性を向上させることが可能です。

チームはトリガーを定義し、モデルの互換性を検証した上で、デプロイ後のすべてのルートを監視する必要があります。また、本番環境へのトラフィックを拡大する前に、フォールバックの連鎖がすべて失敗した場合の挙動や復旧プロセスをテストしておくべきです。 TrueFoundry は、モデルへのアクセス制御を一元管理するための単一のコントロールプレーンを提供します。

Try now.

One gateway for all your models, MCP servers, and agents.
No credit card needed.

Start free
Table of Contents

One Gateway for Every LLM, Agent and MCP Server

Book a 30-min with our AI expert

Book a Demo

The fastest way to build, govern and scale your AI

Book Demo
Summarize with
ChatGPT logo by OpenAI
Perplexity AI logo
Blurry red snowflake on white background, symmetrical frosty design with soft edges and abstract shape.

Discover More

No items found.
A complete guide on AI governance framework covering what it is, its objective and top AI governance framework
October 26, 2026
|
5 min read

AIガバナンスフレームワークとは?

No items found.
A guide on the best AI code security tools
October 26, 2026
|
5 min read

2026年の企業向けAIコードセキュリティツールベスト:レビューと比較

No items found.
Claude enterprise security
October 26, 2026
|
5 min read
Claudeのエンタープライズセキュリティ:エンジニアリングチームのための実践的なガバナンスガイド

No items found.
MCP servers in Cursor
October 26, 2026
|
5 min read

CursorにおけるMCPサーバー:セットアップ、構成、およびセキュリティ(2026年版ガイド)

No items found.
No items found.

Recent Blogs

Black left pointing arrow symbol on white background, directional indicator.
Take a quick product tour
Start Product Tour
Product Tour