November 6, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
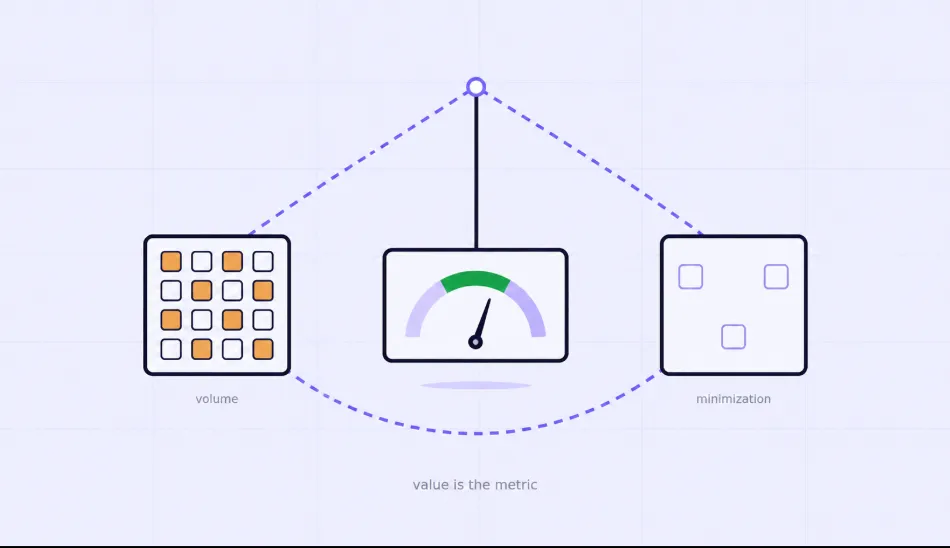
Tokenmaxxing(トークン消費最大化)は、コスト規律へと移行しつつあります。6月下旬、CNBCは、フロンティアラボの最大のエンタープライズ顧客が、トークンを無制限に消費する競走から、予算の引き締めと測定可能な投資対効果(ROI)の要求へと急旋回していると報じました。D.A. DavidsonのGil Luria氏は、企業の一部が制御不能なトークン支出の制限を直接開始する可能性があると指摘しています。Uberは、社内ダッシュボードで追跡可能であり、承認を受ければ上限を超過できる、エージェンティックコーディングツール1つあたり従業員1人につき月額1,500ドルの上限を導入しました(Bloomberg)。Microsoftは一部の社内AI利用枠を縮小し、コスト意識の高い利用を強調したと報じられており、Amazonは拡大し続けるユースケースのリストを増やすのではなく、従業員に実際の課題解決のためにAIを活用するよう指導したと報じられています。また、Metaでもより厳格なトークン予算管理が行われているとの報告がありますが、これらは社内政策のシグナルであり、AI導入自体からの撤退ではありません(Publicis Sapient)。7月10日までに、Forbesはトークン支出が注視すべき指標になったと報じ、AIコーディングのコストが平均的なエンジニアの給与を上回る勢いであるというGartnerの警告を掲載しました(Forbes)。現在重要な問いは、エンタープライズがトークン支出を気にするかどうかではなく(明らかに気にしています)、生の消費量に代わってガバナンスの指標となるものは何かということです。IBMの6月25日のエッセイ(valuemaxxingを主張したのと同じ記事)は、トークンの最小化も消費そのものを最適化の対象とみなすことで、Tokenmaxxingの根本的な謬見を受け継ぐ可能性があると警告しています。IBMの表現を借りれば、「コストは消失するのではなく、移動する」のです。持続可能な解答は「トークンあたりの価値」です。支出によって何が生産されたかを測定し、その証拠に基づいてルーティング、予算管理、最適化を行い、高消費も低消費も成功と混同しないようにすることです。
変化のテンポ自体が重要な発見の一部であるため、新しい情報を時系列で整理します。5月:業界報道により、Microsoftが社内AI利用枠の一部を縮小し、Amazonがユースケースを増やすことよりも実際の課題解決にAIを適用するよう従業員に指示していることが明らかになりました。これらはAI導入の撤退ではなく社内政策のシグナルですが、数ヶ月前には消費を暗黙の美徳として推進していた企業による、インセンティブの最初の逆転現象でした(Publicis Sapientの統合分析)。6月下旬:CNBCの報道が構造的な変化を捉えました。フロンティアラボの最大のエンタープライズ顧客が、消費ペースの競走から予算の引き締めと投資対効果の要求へと移行し、アナリストのコメントでは直接的な支出制限が予想されました。また、IBMはこの変化を命名したエッセイを発表し、トークン消費は価値の指標ではなくコストのシグナルであると主張し、valuemaxxingという後継用語を定義しました。この時代の教訓的な例となったUberは、ダッシュボードで追跡可能であり、承認により超過可能な、エージェンティックコーディングツール1つあたり従業員1人につき月額1,500ドルの上限を導入しました。7月上旬:ForbesのTim Keary氏がその後の一連の動きを整理しました。トークン支出が取締役会レベルの新たな指標となり、Gartnerは従量課金ライセンスのもとでAIコーディングコストが2028年までに平均的なエンジニアの給与を超えると予測し(Gartnerの6月24日の発表)、マルチモデルのブレンドがコスト対策かつ課金の複雑化とエラーリスクという新たな障害面をもたらす手法として浮上しました。さらにLucidworksの2026年ベンチマークでは、2023年の3%に対し、58%の企業が導入コストを最重要懸念事項として挙げていることがわかりました(Forbes)。7月中を通じて:現場の実践者の議論に具体的リアリティが加わりました。ルーティングプラットフォームが戦術的な解決策として浮上し、市場分析ではフロンティアモデルと低予算モデルの間の動的割り当てが新たな標準になりつつあると説明される一方、トークン単価が低下する一方でエージェンティックワークフローが総消費量を押し上げているという裏にあるパラドックスが指摘されました(AlphaSense)。エンジニアリングアナリティクスの有識者は、どちらの方向への極端な消費も費用対効果が高くなく、機会はトークンがどのように使用されるかにあると警告しました。そして時代全体の背景が振り返られました。NvidiaのJensen Huang氏が「50万ドルのエンジニアがトークンを大量に消費していなければ深刻に懸念する」と述べた3月の発言、その心情を運用化した大手ラボやプラットフォームの社内リーダーボード、そして逆転を不可避にした報じられた極端な例(単一のパワーユーザーによる月間数千億トークンの消費、年間9桁[数億ドル]規模に及ぶと報じられたエンタープライズのAI請求額)です。これらを一つの流れとして読み解くと、議論は約90日間で、消費の推奨から消費の制限へと逆転しました。そして組織的な移行は完了したわけではなく、現在も進行中です。8月上旬には、UberのCTO自身が同社はTokenmaxxing時代の終焉を迎えつつあると表現しました(Business Insider)。これがプロキシ指標が廃れる際のテンポであり、プロキシの崩壊の後に起こりうる過ちへの準備段階です。

IBMの警告は、この夏で最も運用上役立つ一文であるため、詳細に紐解く価値があります。最大化と最小化という2つの方向性は、いずれも1つの公理を共有しています。それは「管理すべき数字はトークン数である」という点です。最大化のもとでは、この公理により無駄に増量されたプロンプト、節度のない再試行、長切れを評価されるエージェントが生まれました。一方、最小化のもとでは逆の病理が生じます。そして、一見すると規律正しく見えるため、そのメカニズムはより巧妙です。最初の削減は純粋に無駄のないものです。肥大化したツールカタログ、冗長なペイロード、古くなったコンテキストなど、キャッシュとコンテキストエンジニアリングによって取り除ける無駄です。しかし、削減は無駄だけに留まりません。指標自体が「無駄」と「必要な栄養」を区別できないからです。タスクの説明は曖昧になるまで圧縮され、ビジネス上の制約やアーキテクチャのコンテキストはオーバーヘッドとして削ぎ落とされ、リトリーバルは制限されます。その結果、成功に必要なコンテキストを奪われたシステムは、ダウンストリームで追加の推論、再試行、ツール呼び出し、検証サイクル、人間による手戻りで補填することになります。入力トークンの行は下がりますが、ワークフローの真のコストは増加し、トークンレポートが追跡しない場所へと分散します。これこそが、祝福の声が長続きする理由です。リーダーシップが注視する数値が改善する一方で、誰も計算しない数値が悪化しているのです。7月の取材で得られた2つの悪化要因を加えると、全貌が完成します。1つ目はエージェント的分母(agentic denominator)です。従業員ごとの上限やシートごとの直感は人間を消費主体と想定していますが、構造的な成長を担うのはエージェントです。人間の定額割り当ては、シート数とは無関係に消費が増大するエージェント型CI/CDパイプラインの管理にはほとんど役に立たず、むしろ大量使用が生産的である人間側にペナルティを与えることになります。2つ目はマルチモデル請求面(multi-model billing surface)です。ユニットコストを純粋に削減するブレンディング戦略(ルーティング裁定取引:安いモデルがタスク品質を維持できる場合、モデルの切り替えにより推論コストを大幅に削減可能。削減額はワークロードの組み合わせ、モデルの格差、ルーティングポリシーに依存)は、請求書、料金表、消込の接点も増大させます(Forbesが警告する請求エラー)。そのため、測定を統一せずにモデルを分散させた環境は、1つの不透明さを複数の不透明さとトレードオフしただけになりました。結論はきわめてシンプルです。トークンは美徳でも悪徳でもありません。単なる分母です。成果を測定せずにその分母だけを最適化しようとする体制は、最終的にリソース配分を誤ることになります。したがって、分子側も計測(インストゥルメンテーション)しなければなりません。
トークンあたりの価値という比率を管理するには、トークンが通過する経路に4つの計装が必要です。アトリビューション(帰属)は、請求書をチーム、ワークフロー、エージェントごとに分解します(リクエストごとのコストアトリビューション、アナリティクス)。これは「支出が増加している」という以上のインテリジェントな議論を行うための前提条件であり、マルチモデル請求面において今すぐ対応すべき統合レイヤーです。つまり、ルーティング戦略が関与するすべてのプロバイダーにわたる単一の測定プレーンとなります。評価(Evaluation)は分子を提供します。現在ドキュメント化されているTrueFoundryの機能においては、これはネイティブなダッシュボードの計測値ではなく、構成されたワークフローとなります。GatewayのトレースはOTELを介してBraintrustなどの接続された評価プラットフォームにエクスポートされ、そこで品質スコアと評価が作成されます。そして、それらのスコアこそが、価値ある成果を生み出す1億トークンと、空回りしている1億トークンを区別するものです(オンライン評価パターン)。この区別は、最大化も最小化も単にメーターを読むだけであるため、行うことができません。測定された品質に基づくルーティングは、モデルのブレンドを運用化します(コストと品質を考慮したルーティング、純粋に無駄のない削減のためのセマンティックキャッシュ)。根拠に基づいて性能が維持される場所には安いモデルを適用し、維持されない場所には最先端モデルを適用します。測定された一定の品質を保ちながらコストを削減する、これこそが裏目の出ない唯一の削減方法です。そして、段階的な予算設定が画一的な割り当てに取って代わります(予算制限)。テナントレベルおよびチームレベルのコスト境界を設定し、ユーザー、モデル、バーチャルアカウント、またはメタデータ値ごとに分割可能です。これにより、安定したエージェント識別子およびワークフロー識別子に独立した予算枠が付与されます。75/90/95/100%のしきい値でのマイルストーンアラートに加え、audit、soft_enforce、またはenforceの動作が組み合わされます。「より安価なモデルへの降格ステップ」は予算制御と組み合わせ可能な独立したルーティングポリシーであり、予算ルール自体のネイティブなアクションではありません。これらの制御機構を組み合わせることで、中間アプローチが実現します。明確な無駄を取り除き、成果を向上させるコンテキストは維持し、測定された品質が保持される場合はより安価なモデルへルーティングし、使用頻度の高いワークロードすべてを無駄とみなすことなく無制限な支出を停止します。重要なのは、トークン数をどちらかの方向に最適化することではなく、支出単位あたりに生み出される価値を最適化することです。


情報源と透明性。外部の記録は引用された報道(IBMの6月25日のエッセイ、CNBCの6月下旬の報道、BloombergのUber上限に関する報道、Gartnerの6月24日の発表、Lucidworksのベンチマーク、Forbesの7月のまとめ、Publicis Sapientの統合分析、およびAlphaSenseの市場分析)から要約したものであり、2つの短い引用(IBMの6単語、Huangの2単語の「deeply alarmed」)はそれぞれ15単語未満で出典を明記しています。一次情報源で検証できなかった数値(個々のパワーユーザーの消費合計、特定のエンタープライズ契約額、広く流通している開発者の品質統計)は、報道上の主張として位置づけ、本稿の根幹をなす論旨からは意図的に外しています。また、引用された組織のいずれもTrueFoundryを評価・承認しているわけではありません。当社の商業的関心は構造的であり、公示されています。本稿が推奨する計装セットは当社が販売する製品ですが、これはプリンシパルごとのアトリビューション、リアルタイム評価、ポリシーベースルーティング、および強制的な段階的予算設定を備えた任意のスタック上で実行可能であるという前提条件に準拠しています。自らの仮説に対する1つの限界として、計装にはコストの底値と成熟度の前提条件が存在します。ピボットの最中にある10人のスタートアップが画一的な上限を設定するのは合理的であり、段階的なガバナンス体制がその複雑さに見合う価値を持つのは、大まかな制限にかかるコストが高度な計装のオーバーヘッドを上回るスケールに達した時点です。したがって、この主張には境界条件があります。トークンあたりの価値に基づくガバナンスは、AI支出が十分な規模に達し、ワークロードが十分に安定し、成果測定が高度な計装を正当化できるほど成熟している場合に最も有用となります。
15語未満の引用文を2つ使用しています(IBMの6語、報道されたNVIDIA CEOの2語)。その他のすべての外部資料はパラフレーズされており、一次ソースで検証できない数値は報道された主張としてマークし、根幹となる主張からは除外しています。引用されている組織はいずれも、TrueFoundryを評価または承認していません。当社のツール群に対する商業的関心は開示されており、このレジームは同等の特性を持つ任意のスタック上で実行可能です。製品画像はTrueFoundry独自のドキュメントアセットであり、出展を明記して再現されています。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.