



November 6, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
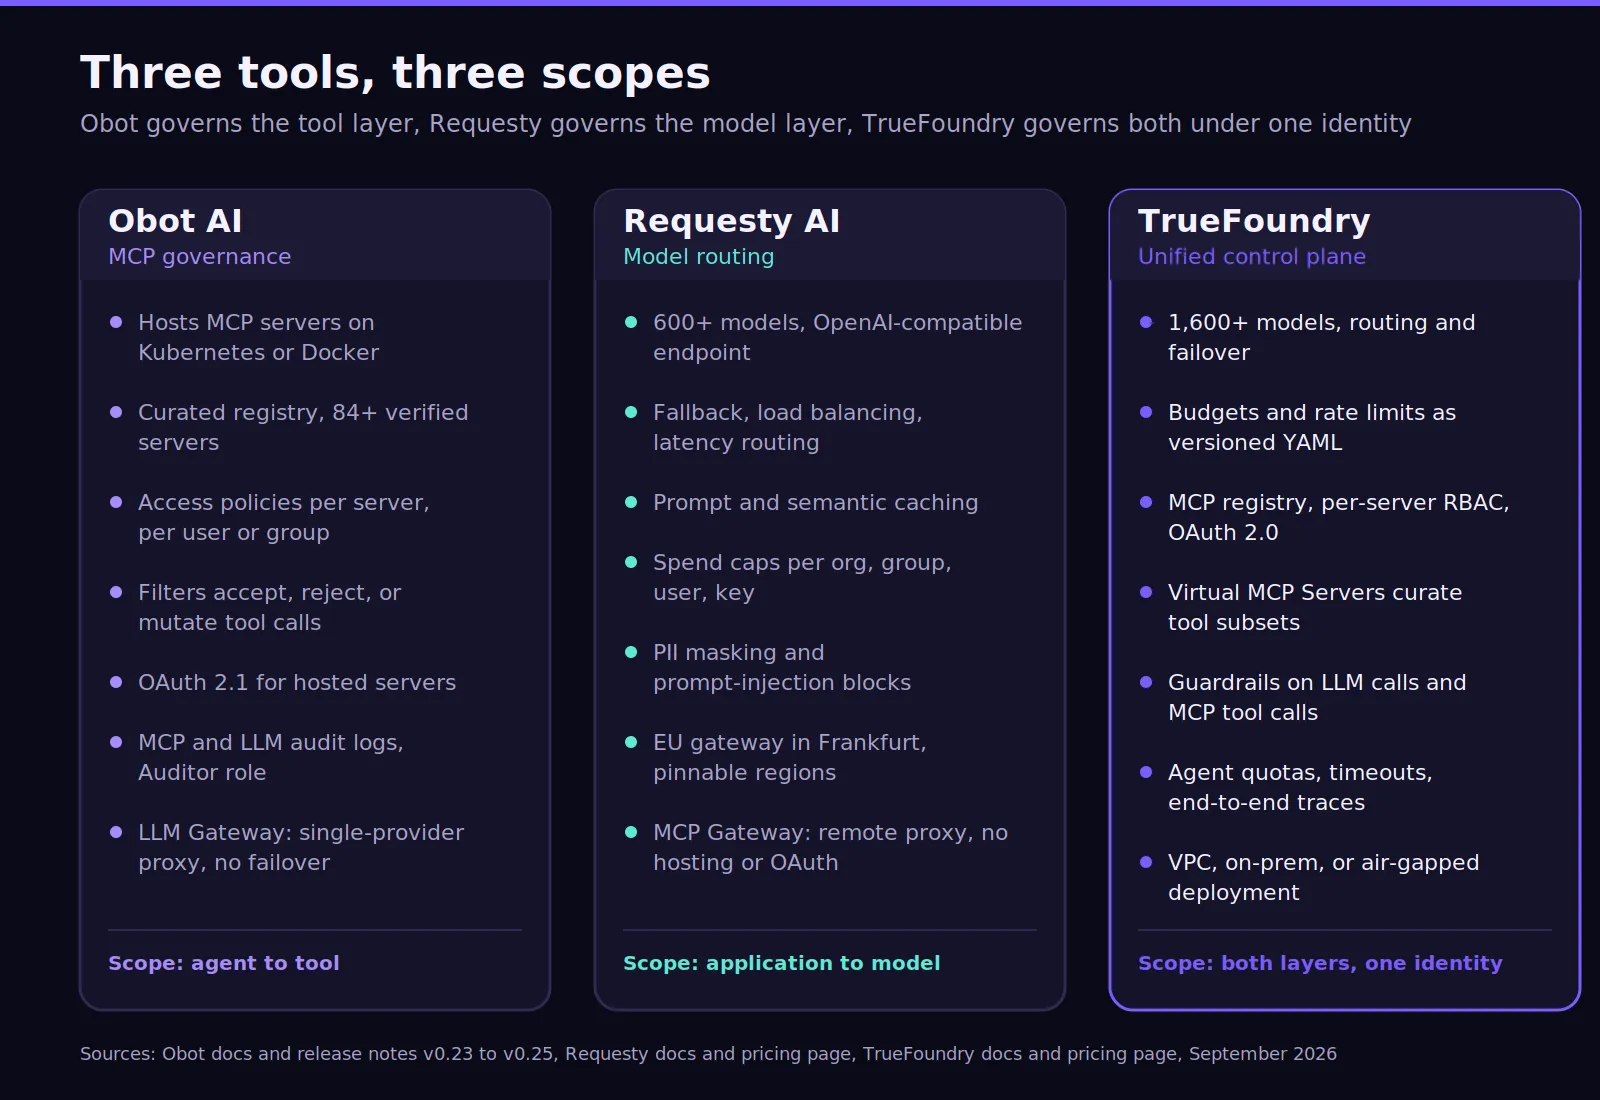
Requesty AIとObot AIの比較を始めるにあたり、両者の主な役割が異なることを理解する必要があります。Obotはエージェント、モデル、ツールの交差点に位置します。Requestyは主にアプリケーションとLLMプロバイダーの間に位置します。
Obot AIは、Obot MCP Gatewayを中心にプラットフォームを構築しています。MCPサーバーのホスティングやプロキシ、資格情報の管理、アクセスポリシーの適用、リクエストの記録を行うことができます。そのコントロールプレーンには、LLM Gateway、モデルポリシー、レジストリ、エージェントサービスも含まれます。
Requestyはモデルアクセスにより重点を置いています。アプリケーションはベースURLをRequestyに変更することで、OpenAI互換のエンドポイントを介して600以上のモデルにアクセスできます。ルーティングポリシーは、フォールバック、ロードバランシング、コスト考慮型選択、プロバイダー間のレイテンシーベースのルーティングをサポートしています。
この実用的な違いは非常に有用です。Obotは、ITチームがどのアイデンティティがどのツールやモデルにアクセスするかをガバナンスするのに役立ちます。Requestyは、アプリケーションがコストと可用性をコントロールしながらモデルプロバイダーを安定して選択するのに役立ちます。
モデルゲートウェイアーキテクチャを検討しているチームは、集中型プロバイダーアクセスの役割についてTrueFoundryのLLM Gatewayの分析も参照してください。
機能比較表だけではアーキテクチャの違いが隠れてしまうことがあるため、以下の注記が重要になります。ObotはMCPインフラストラクチャの多くを所有し、顧客が管理する環境内で実行できます。Requestyはマネージドクラウドサービスとして動作し、顧客からゲートウェイ運用の大部分を取り除きます。
Obotのコア機能は現在、MCPを超えて拡張されています。そのLLM Gatewayは、OpenAI、Anthropic、Amazon Bedrock、Azure、および互換エンドポイントをサポートしています。管理者はモデルアクセスポリシーを定義し、Obotはアップストリームの資格情報をユーザーに公開することなく保存します。
Obot Gatewayは、DockerまたはKubernetes上でのMCPホスティングも処理します。組織がすでに自社のMCPサーバーを運用している場合は、リモートサーバーをサポートします。フィルターは、承認されたツール呼び出しを転送する前に、トラフィックの受け入れ、拒否、または変更を行うことができます。
Requestyは異なるルーティング課題を解決します。そのインテリジェントルーティングは、コスト、レイテンシー、品質、または定義されたフォールバック順序に基づいてトラフィックを分散できます。これにより、アプリケーションが複数の商用モデルを使用する場合のマルチプロバイダーの信頼性とコスト最適化において、より高い強みを発揮します。
エージェント管理も明確な違いを生み出します。ObotはAIエージェントを、モデルやツールへのアクセス権を持つガバナンス対象のプラットフォームアイデンティティとして扱います。Requestyは主にエージェントが使用するモデルルーティングポリシーをガバナンスします。
Obot Agentは会話やスケジュールされたワークフローをサポートし、Agent Authorization Scopesはマシン資格情報を提供します。管理者は、APIキーを特定のMCPサーバー、LLMプロキシアクセス、またはその他の機能に制限できます。これにより、個人のインタラクティブログインを使用することなく安全なアクセスが可能になります。
開発者がローカルのAIツールに資格情報を直接設定する代わりに、Obotは一元化された資格情報管理とサーバーアクセスを提供します。フィルターにより、承認されたリクエストがダウンストリームシステムに到達する前にポリシーが適用されます。ゲートウェイはまた、アップストリームのOAuthフローを処理し、ユーザーに代わって必要なOAuthトークンを更新します。
Device Managementは、Claude Code、Codex、Cursorなどのサポートされている開発者クライアントへと可視性を拡張します。ツール呼び出しの制御適用はまだ実験的段階ですが、ローカルアクティビティの監査は可能です。これにより、エンジニアリングチームは一元ホストされたエージェントワークロード外のAIアクティビティに対する可視性を得ることができます。
Requestyは同様のホスト型エージェント実行モデルを提供しません。代わりに、特定のエージェントに対してルーティングポリシーと支出上限を適用できます。これは、ワークフロー全体の実行よりもモデルの信頼性が主な要件である場合に役立ちます。
エージェントやMCPガバナンスに関する代替手段を検討しているチームは、Obot AIの代替製品も参照してください。
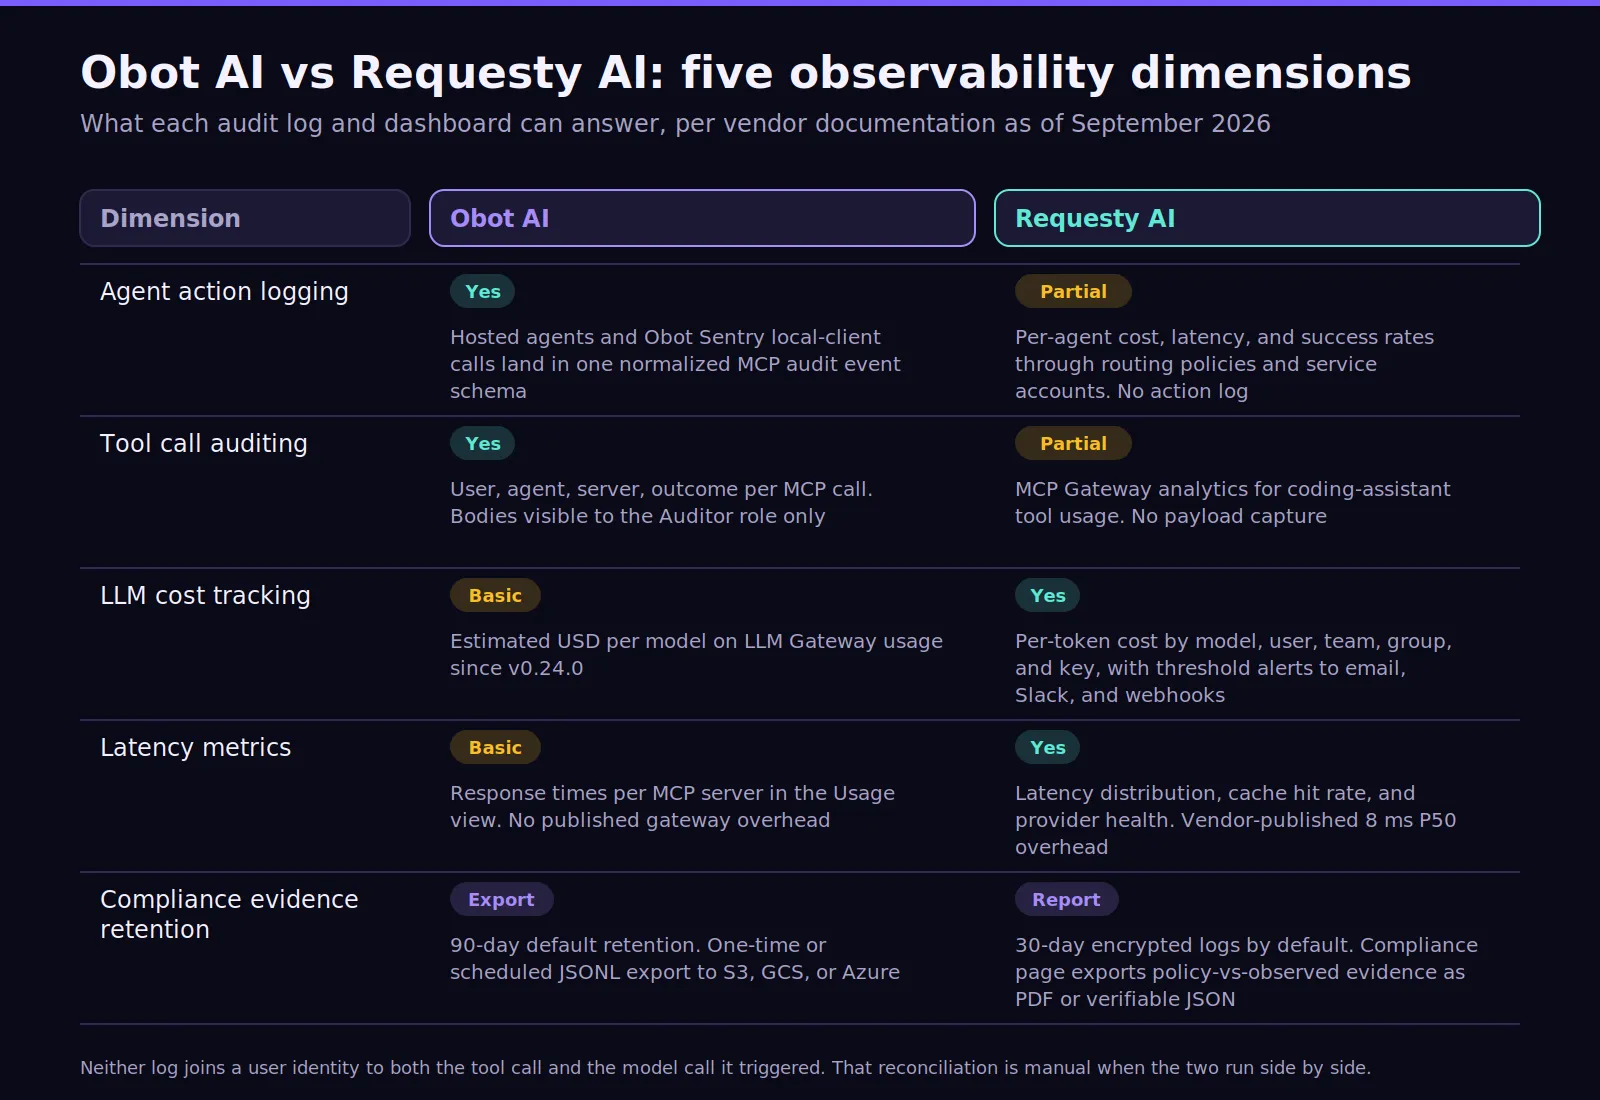
両プラットフォームともオブザーバビリティを提供しますが、答える運用上の質問が異なります。Obotはエージェント、モデル、ツールのアクティビティに焦点を当てます。Requestyは、プロバイダーの動作、コスト、ルーティング、ゲートウェイのパフォーマンスにより強く焦点を当てています。
Obotは、MCPリクエスト、ユーザー、タイムスタンプ、結果、モデル情報、トークン使用量を記録します。LLM監査記録には、プロバイダー、要求されたモデル、クライアントの詳細、所要時間も含まれます。機密性の高いリクエストまたはレスポンスデータにはAuditorロールが必要です。
監査ログのエクスポートは、Amazon S3、Google Cloud Storage、Azure Blob Storage、または互換性のあるオブジェクトストレージに送信できます。そのため、組織は長期的な証跡に対して完全な制御を保持し、自社のデータプライバシー要件に合わせてストレージを調整できます。
Requestyはリクエストレイテンシー、キャッシュパフォーマンス、モデルコスト、失敗、プロバイダーのルーティングを強調します。そのダッシュボードは、キー、チーム、モデル全体にわたるリアルタイムのコストと使用状況の可視性を提供します。ゲートウェイは、ポリシーベースのリージョンルーティングとデータ非保持(Zero Data Retention)エンドポイントもサポートしています。
この違いはコンプライアンス要件において重要です。Obotは、エージェントとMCPアクションに関する詳細な監査トレールを提供します。Requestyは、本番環境のモデルトラフィック全体におけるモデルルーティングの結果、ポリシーの適用、コストに対してより強力な可視性をチームに提供します。
価格設定とデプロイメントモデルは、運用の所有権に関する異なる思想を反映しています。Obotは顧客により多くのインフラストラクチャ制御権を与えます。Requestyはフルマネージド型のゲートウェイに対して課金し、運用の手間を大幅に削減します。
Obotは現在、同じコンテナイメージから3つのエディションを提供しています。デフォルトエディションは最大100ユーザーおよび100デバイスをサポートします。Communityは無料で、Entra、Okta、JumpCloud、Auth0を追加できます。Enterpriseはこれらの制限を解除し、エンタープライズサポートを追加します。
KubernetesまたはDockerでのデプロイメントにより、Obotを顧客のインフラストラクチャ内に維持します。ホストされたMCPワークロードは、分離されたコンテナまたはKubernetesワークロード内で実行されます。この構造は、プライベートクラウド、内部資格情報、またはローカル監査ストレージに関する厳しい要件を持つ組織に適しています。
Requestyは無料のエントリーポイントと従量課金の価格設定を提供しています。現在の価格設定では、アップストリームのモデルコストに5%が加算されますが、顧客が所有するプロバイダーキーを使用する場合は0%のマークアップになります。無料プランは、利用可能な無料モデルに対して1日200リクエストをサポートしています。
Requestyのエンタープライズ価格は個別見積もりです。Enterpriseでは、SSO、RBAC、コンプライアンスサポート、カスタムSLA、およびより高度な組織コントロールが追加されます。SOC 2 Type IIの観察期間は現在進行中であり、EUデータ常駐はフランクフルトで利用可能です。
大規模なワークロードの場合、チームはライセンスと運用負担を比較検討する必要があります。セルフホスティングでは、パッチ適用、スケーリング、ストレージ、サポートが組織内部の責任となります。SaaSではこれらの作業の多くが不要になりますが、顧客はベンダーのデプロイメントオプションとセキュリティ境界を受け入れることになります。
こちらの記事もおすすめ: AIゲートウェイコストガイド
Obot AIは、専用のMCPガバナンスレイヤーを必要とするチームに適しています。社内のエージェント、コーディングアシスタント、AIクライアントが、ローカル、リモート、またはホスト型のMCPサーバーへの承認されたアクセスを必要とする場合に役立ちます。また、オープンソースインフラストラクチャとセルフホスト管理を好む組織もサポートします。
ここで1つ注意点があります。Obot Enterprise未満での100ユーザーおよび100デバイスの上限はv0.25.0で導入され、以前は無制限だったGitHubおよびGoogle認証デプロイメントにも適用されるようになりました。既存のユーザーは上限を超えても動作し続けますが、新しいユーザーを追加することはできません。パイロット運用はこの数値を念頭に置いて調整してください。
Requesty AIは、マネージドゲートウェイを通じて多数のモデルへの迅速なアクセスを必要とするチームに適しています。セルフホストのインフラストラクチャなしで、信頼性の高いLLMプロバイダー、ルーティングポリシー、キャッシュ、アナリティクス、支出コントロールを提供することが最大の価値となります。
このプラットフォームは、チームが迅速にモデルの実験を行いたいプロトタイプワークロードにも向いています。使用量が一定以上のRPSや高いピークに達した場合は、単発のリクエストではなく、実際のプロダクション設定トラフィックを使用して、プロバイダーの信頼性と高レイテンシーシナリオをテストする必要があります。
Requestyのゲートウェイは、性能が低下したプロバイダーを回避してトラフィックをルーティングし、モデル制限を一元的に適用できます。これにより、チームが個別の資格情報や統合を維持する場合に比べて、開発者体験を向上させることができます。また、OpenAI互換のインターフェースにより、アプリケーションの変更も最小限に抑えられます。
デモだけでObot AIまたはRequesty AIを選択すると、間違った結論に至る可能性があります。一方のプラットフォームがブロックされたツールアクセスを示し、もう一方が正常なフェイルオーバーを示すことがあります。両方のシナリオが重要ですが、それぞれ本番環境の異なるレイヤーを測定しています。
Obot AIとRequesty AIの比較から、1つのワークフローが両方のレイヤーにまたがる場合の共通の制限が明らかになります。Obotは自社プラットフォーム内でモデル、エージェント、MCPアクセスをガバナンスします。Requestyはより高度なプロバイダー間ルーティングを提供します。しかし、どちらもエンタープライズにおけるすべての管理機能を同じ深さで統合して提供しているわけではありません。
サポートワークフローでは、1つのモデルを呼び出し、MCP経由でCRMにクエリを実行し、ケースを更新して、別のエージェントをトリガーすることがあります。アイデンティティ、権限、予算、ログが独立したシステムに分散している場合、データ露出の潜在的なリスクが発生します。
Requestyも独自のMCP統合を拡張しています。そのMCP Gatewayは、集中認証、ツールのホワイトリスト登録、使用状況アナリティクス、およびリモートMCPサーバー用の共有またはユーザーごとの資格情報をサポートしています。ただし、完全なMCPホスティングやエージェント実行ガバナンス全体を置き換えるものではありません。
モデルとツールの双方に渡る統一されたポリシーを適用しようとすると、不足している要素が顕著になります:
これらのアクションが複数ステップのワークフローに発展する場合、専用のエージェントレイヤーが必要になります。TrueFoundryのAgent Gatewayは、それらのワークフロー全体でリトライ、タイムアウト、ポリシー制御、トレーサビリティ、およびガバナンスされたツール実行を提供します。
TrueFoundryは、モデル、ツール、エージェントのガバナンスを統合する単一のプラットフォームを企業が求める場合に最適です。そのAIコントロールプレーンは、モデルルーティング、アイデンティティ、ポリシー、予算、ガードレール、オブザーバビリティを同じ本番アーキテクチャ内にもたらします。
モデルレイヤーは、ホスト型およびセルフホスト型のエンドポイント全体でマルチプロバイダーのルーティングとモデルサービングをサポートします。予算ポリシーは、追加のリクエストが実行される前に、ユーザー、チーム、モデル、またはメタデータに適用できます。
予算ルールはバージョン管理されたYAMLオブジェクトであるため、プラットフォーム設定の残りの部分と一緒にGit内に保持されます:
サポートチームのRAGパイプラインの月額費用が5,000ドルを超えると、ゲートウェイは請求書上のサプライズではなく、ボディに `error_origin_level: rate_limit_budget`、`x-tfy-applied-rules` ヘッダーに違反したルールIDを含む429を返します。これにより、Requesty AIが提供するマルチプロバイダーアクセスとコストガバナンスのユースケースをカバーしつつ、VPCネイティブデプロイというアーキテクチャ上の利点も追加されます。
TrueFoundry MCP gatewayは、サーバーごとのRBAC、Virtual MCP Server抽象化、自動更新機能を備えたOAuth 2.0トークン管理、およびすべてのツール呼び出しについてユーザーアイデンティティに紐付けられた監査トレールを提供します。
Virtual MCP Serverは、登録された複数のサーバーからツールのサブセットを取得し(たとえば、`delete_pr`を除外したGitHubや、`delete_message`を除外したSlackなど)、デプロイを必要としない単一のエンドポイントとして公開します。ガードレールは同じポリシーレイヤーに適用され、1つのYAMLファイルでLLM呼び出しとMCPツール呼び出しの両方をガバナンスします:
このアーキテクチャは、別々のゲートウェイ製品を使用することでポリシーの重複が発生してしまう場合に非常に有用です。また、複数のチームが環境間でモデル、エージェント、MCPツールを共有する際のガバナンスもシンプルになります。
以下のような場合にTrueFoundryの導入を推奨します:
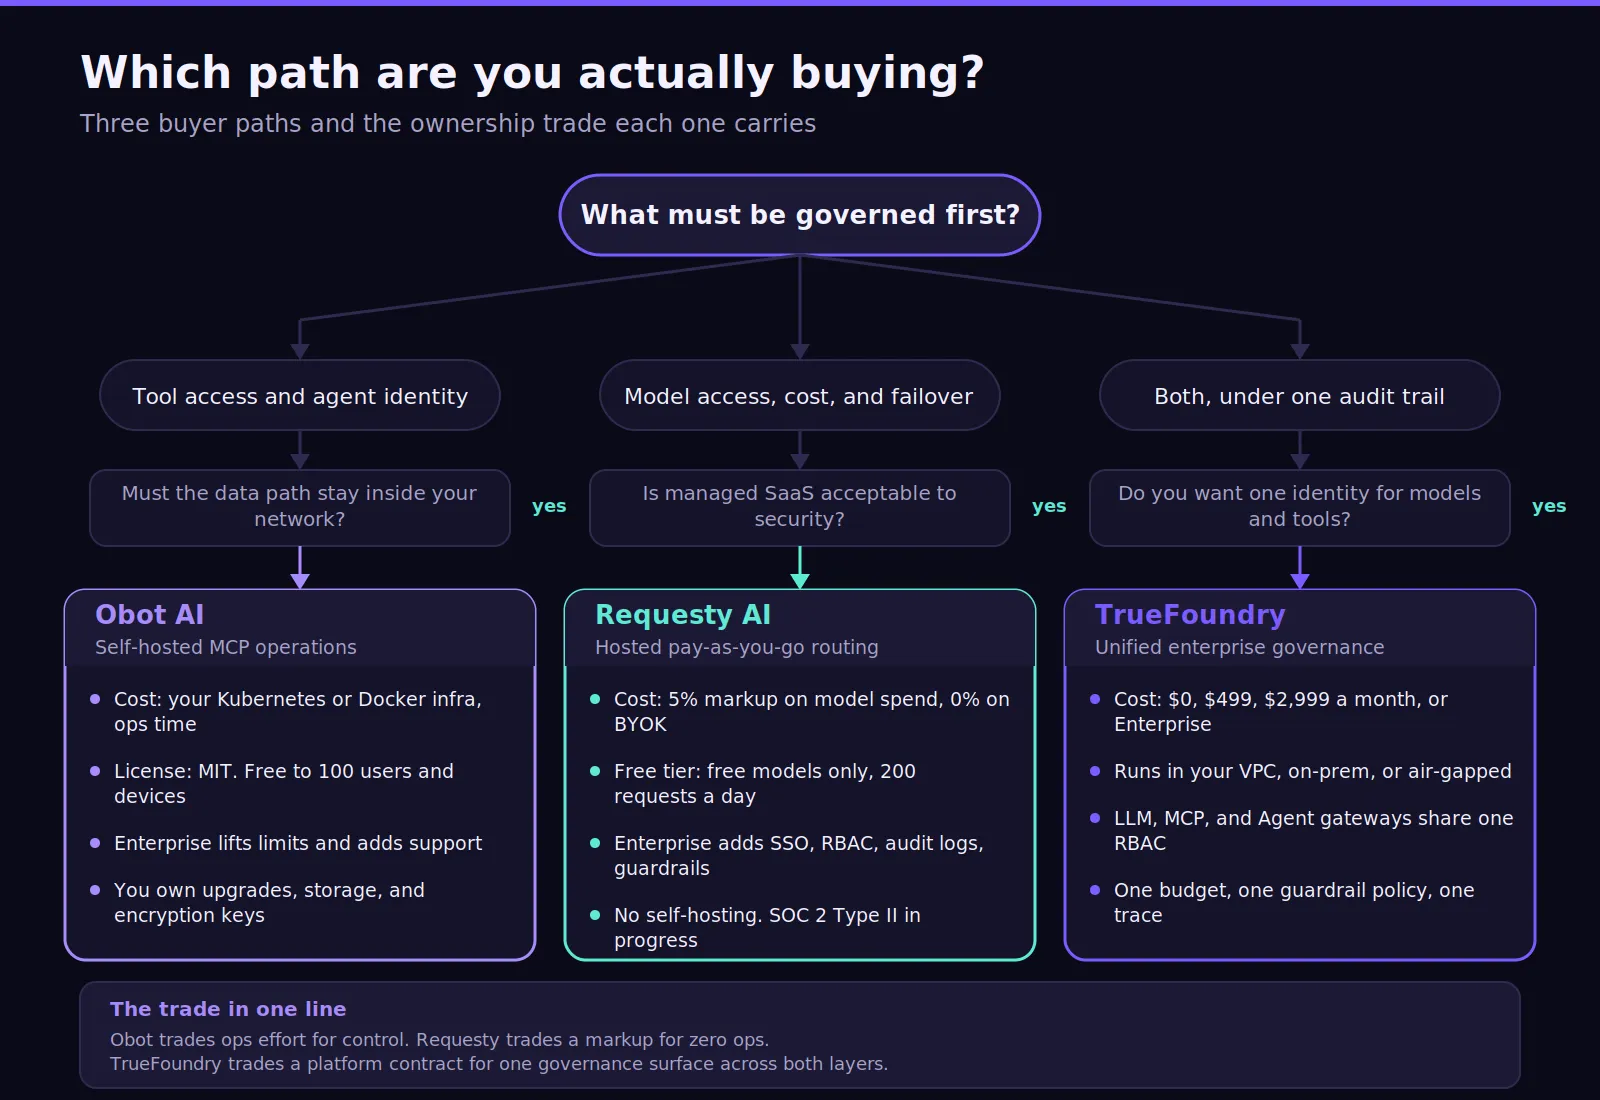
TrueFoundryは現在、Developerプラン($0)、Proプラン(月額$499)、Pro Plusプラン($2,999)、およびカスタムのEnterpriseプランを提供しています。Enterpriseプランは、VPCおよびエアギャップ環境でのコントロールプレーンおよびゲートウェイプレーンをサポートしています。
より広範な本番環境アーキテクチャを比較しているチーム向けに、TrueFoundryはモデル、ツール、エージェント、およびガバナンスされたエンタープライズ実行のための統合コントロールレイヤーを提供します。
本番AI環境全体で、モデル、MCPツール、エージェント、予算、ポリシー、監査証跡を単一のエンタープライズコントロールプレーンでいかに安全に管理できるか、TrueFoundryのデモを予約してご確認ください。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.


























