


November 17, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
大企業のLLM API支出は、2024年後半の35億ドルから2025年中盤には84億ドルへと、わずか6ヶ月で倍増し、衰える兆しを見せていません。 Gartnerは、2026年の世界全体でのAI支出が前年比44%増の2兆5200億ドルに達すると予測しています。
皮肉なことに、トークン単価はかつてないほど低下しています。GPT-4クラスのモデルのコストは、18ヶ月前の数分の一に過ぎません。それにもかかわらず請求額が急増している理由は、価格の低下を上回るスピードで利用量が爆発的に増加しているためです。これは、チャットボットの10〜100倍のトークンを1セッションで消費するエージェント型ワークフローや、コスト規律のないままチームによって構築されたプロダクト機能全般へのLLM呼び出しの拡散が原因となっています。
現場の監査によって、不都合な真実が明らかになりつつあります。プロダクション環境におけるLLMアプリケーションのトークン予算の40〜60%は、完全に無駄になっています。全く同じプロンプトに対する重複呼び出し、最高峰フラグシップモデルへのわずかなコストのモデルで十分こなせるタスクの割り当て、開発環境やCIパイプラインにおけるレート制限の欠如、月末の請求書が届く前に作動する予算上限の非設定、どのチーム、機能、ユースケースが支出を増加させているかの可視性の欠如などがその例です。
セマンティックキャッシュ、インテリジェントなモデルルーティング、階層的な予算上限、オンプレミス/クラウドのフェイルオーバーチェーンといった最適化手法自体は存在します。問題は、中央集中型の制御レイヤーなしには、これらをスケールさせて実装できないことです。アプリケーションとモデルプロバイダーの間に介入するものがなければ、あらゆる最適化はアプリケーションコード内に分散し、各チームで重複して作成され、ガバナンスも可観測性も失われてしまいます。
AI Gatewayこそが、その制御レイヤーです。本ガイドではその理由を解説し、Gartnerの「2026 Best Practices for Optimizing Generative & Agentic AI Costs」で紹介されているTrueFoundryのAI Gatewayが、各チームがアプリケーション内で何を行っているかに依存せず、各コストレバーをインフラストラクチャレベルで正確にどのように実装しているかを示します。
多くの組織は、5年前のAPIコスト管理と同じアプローチでLLMコストの最適化を行っています。各チームがそれぞれの利用に責任を持ち、プロバイダーから毎月請求書が届き、エンジニアリング部門の誰かが定期的に合計金額を見てため息をつく、という方法です。
このアプローチには、LLMワークロードにおいて4つの構造的な失敗パターンがあります。
1. 帰属情報の不在: OpenAIからの請求書が届いたとき、確認できるのは組織全体の合計トークン使用量だけです。どのアプリケーション、チーム、機能、あるいはユーザーがその利用を促進したのかは分かりません。調査も、コストの割り振りも、どの20%のユースケースが80%の支出を引き起こしているかの特定も不可能です(データ内にその80/20の法則がほぼ間違いなく存在しているにもかかわらずです)。
2. 予防措置の不在: LLMワークロードにおけるコストの異常事態は非常に急速に発生します。エージェントを無限ループに陥れるバグが発生すると、わずか数分で数千ドルのコストを消費する可能性があります。コンテキストの重いプロンプトを使用して新機能をテストしている開発者が、一日の午後の間に1ヶ月分の予算を使い果たしてしまうこともあります。インフラストラクチャレイヤーにレート制限と予算上限がなければ、これらのイベントは発生時ではなく、毎月の請求書で初めて発見されることになります。
3. 影響力の不足: 最も影響の大きいコスト最適化(セマンティックキャッシュ、モデルルーティング、オンプレミス/クラウドのフェイルオーバーチェーンなど)は、すべてのアプリケーションに同時に適用できるインフラストラクチャレベルで最もよく機能します。これらを個々のアプリケーションに実装するということは、すべてのチームが同じインフラを再構築することになり、カバー範囲にばらつきが生じ、アプリケーション間でのキャッシュヒットの共有もできなくなります。
4. モデルの柔軟性の欠如: アプリケーションコードからプロバイダーへ直接ルーティングしている場合、モデルの切り替えにはすべてのアプリケーションでコード変更が必要になります。この摩擦により、チームは新しい安価なモデルが利用可能になっても採用が遅れ、プラットフォームチームが組織的にモデルのティアポリシーを強制することが不可能になります。
AI Gatewayは、組織内のすべてのLLM呼び出しに対する単一の適用ポイントとなることで、これら4つの失敗パターンすべてを解決します。すべてのトラフィックをGateway経由でルーティングすることで、アプリケーションコードに手を加えることなく、中央集権的に帰属情報の特定、事故の予防、全体的な適用力、そして柔軟性を確保できます。

可視化できないものは最適化できません。すべてのLLMトラフィックをGatewayでルーティングすることによる最初の成果は、ユーザー、チーム、バーチャルアカウント、アプリケーション、モデルごとに、すべてのモデル呼び出しに対する完全で、帰属が特定可能であり、クエリ検索が可能な記録が得られることです。
TrueFoundryのAI Gatewayは、プロバイダーが公表している料金レートで常に更新されるオープンソースの価格カタログを使用して、リクエストごとのコストを自動的に追跡します。これには、階層型料金設定(例: Gemini 2.5 Proの20万トークンを超える異なるレート)や地域固有の料金設定(例: AWS Bedrock Nova Liteのリージョンごとのレート)が含まれます。カスタム契約やファインチューニングの料金設定を持つモデルについては、Private Cost設定により、すべてのダッシュボードに反映される正確なトークンごとのレートを設定できます。
その結果、チーム、ユーザー、バーチャルアカウント、モデル、アプリケーションごとに分解されたコストを表示するライブダッシュボードが得られ、X-TFY-METADATAヘッダーで渡された任意のメタデータタグでフィルタリング可能です。すべてのリクエストにproject_id、feature、customer_id、あるいはenvironmentのタグを付けることで、コストダッシュボードはそれらの軸で自動的にセグメント化されます。
セットアップの詳細については、TrueFoundryのコスト追跡ドキュメントを参照してください。
これは最も優先して導入すべき制御機能です。支出を最適化する前に、致命的な支出を防ぐ必要があります。Gatewayレベルでの予算制限とレート制限は、請求書が届く前に作動するサーキットブレーカーの役割を果たします。
TrueFoundryの予算制限は階層的であり、ルールは重ね合わせて結合されます。
TrueFoundry Gatewayにおけるレート制限は、3つの異なるシナリオに対応します。
ここには、最も大幅なコスト削減の機会が存在します。研究によると、企業におけるLLMコストの60〜80%は全ユースケースの20〜30%に集中しており、そのほとんどは、最先端モデルを使用するには明らかに過剰な高ボリューム・低複雑性のタスクであることが一貫して示されています。
RouteLLM(ICLR 2025で発表)では、十分にトレーニングされたコンプレキシティルーターが、リクエストの14〜26%のみを高価なモデルにルーティングすることで、GPT-4の性能の95%を達成し、ルーティングされたワークロードのコストを75〜85%削減できることが実証されました。品質を損なうことなく、このような削減が可能です。その前提条件となるのがルーティングレイヤーです。
TrueFoundryのVirtual Modelsは、コスト最適化シナリオに直接対応する3つのルーティング戦略を実装しています。
クラウドへフェイルオーバーするオンプレミス・プライマリのパターンは、GPUインフラストラクチャを持つ企業にとって最もROIの高いルーティング構成です。
容量が限界に達するまでトラフィックは自社のGPU(限界コストゼロ)に留まり、限界に達した後は自動的にBedrockへとバーストします。クラウドAPIはデフォルトの宛先ではなく、キャパシティバッファーとなります。 設定オプションの全容については、TrueFoundryのロードバランシングドキュメントを参照してください。
また、ルーティングはメタデータによって範囲を制限することも可能です。アプリケーションコードを変更することなく、開発環境を安価なモデルティアへ、プロダクション環境をプレミアムモデルへルーティングできます。
キャッシュは、少しでもクエリの重複が存在するワークロードにおいて、最も即効性のあるコスト削減レバーです。重複または意味的に類似したプロンプトは、キャッシュされたレスポンスを瞬時に返します。これによりトークン消費ゼロ、プロバイダーコストゼロとなり、レイテンシも劇的に改善します。
TrueFoundry AI Gatewayは、2つのキャッシュモードをサポートしています。
完全一致キャッシュ(Exact Match Caching)は、バイト単位で同一のプロンプトに対するレスポンスを保存し、返却します。誤検知(False Positive)はゼロで、同じプロンプトからは常に同じキャッシュされたレスポンスが返されます。キャッシュヒット率はワークロードに依存しますが、パラメータが一定であるAPI駆動型のテンプレート化されたプロンプトに最適です。
セマンティックキャッシュ(Semantic Caching)は、埋め込み表現の類似性(Embedding Similarity)を使用して、言い回しが異なっていても同じ意味を持つプロンプトをマッチングします。「パスワードをリセットするにはどうすればよいですか?」という質問と、「パスワードを忘れました、どうすればいいですか?」という質問は、同じキャッシュされた回答を返します。反復的なクエリパターンを持つカスタマーサポート、FAQ、ドキュメント検索のワークロードにおいて、一般的なコスト削減効果は30〜50%に達します。 詳細についてはTrueFoundryのセマンティックキャッシュガイドを参照してください。
どちらのモードも構成可能なキャッシュ有効期限ポリシーと手動無効化をサポートしているため、時間の経過に敏感なデータではキャッシュされたレスポンスを最新に保ちつつ、静的コンテンツは無期限にキャッシュすることができます。
プロバイダーネイティブのプロンプトキャッシュは、ゲートウェイレベルのキャッシュを補完する手段として併用できます。AnthropicのClaude APIプロンプトキャッシュは、キャッシュされたプレフィックスに対する入力トークンコストを最大90%削減し、ファーストトークン生成時間を13〜31%改善します。これはプロバイダーレベルで動作します。ゲートウェイが適切なエンドポイントへルーティングし、プロバイダーはサポートされているモデルに対してプロンプトキャッシュを自動的に適用します。
ゲートウェイによって処理されるすべてのリクエストには、以下が自動的にタグ付けされます:
X-TFY-METADATAを介して渡す任意のカスタムディメンション(project_id、feature、customer_id、environmentなど)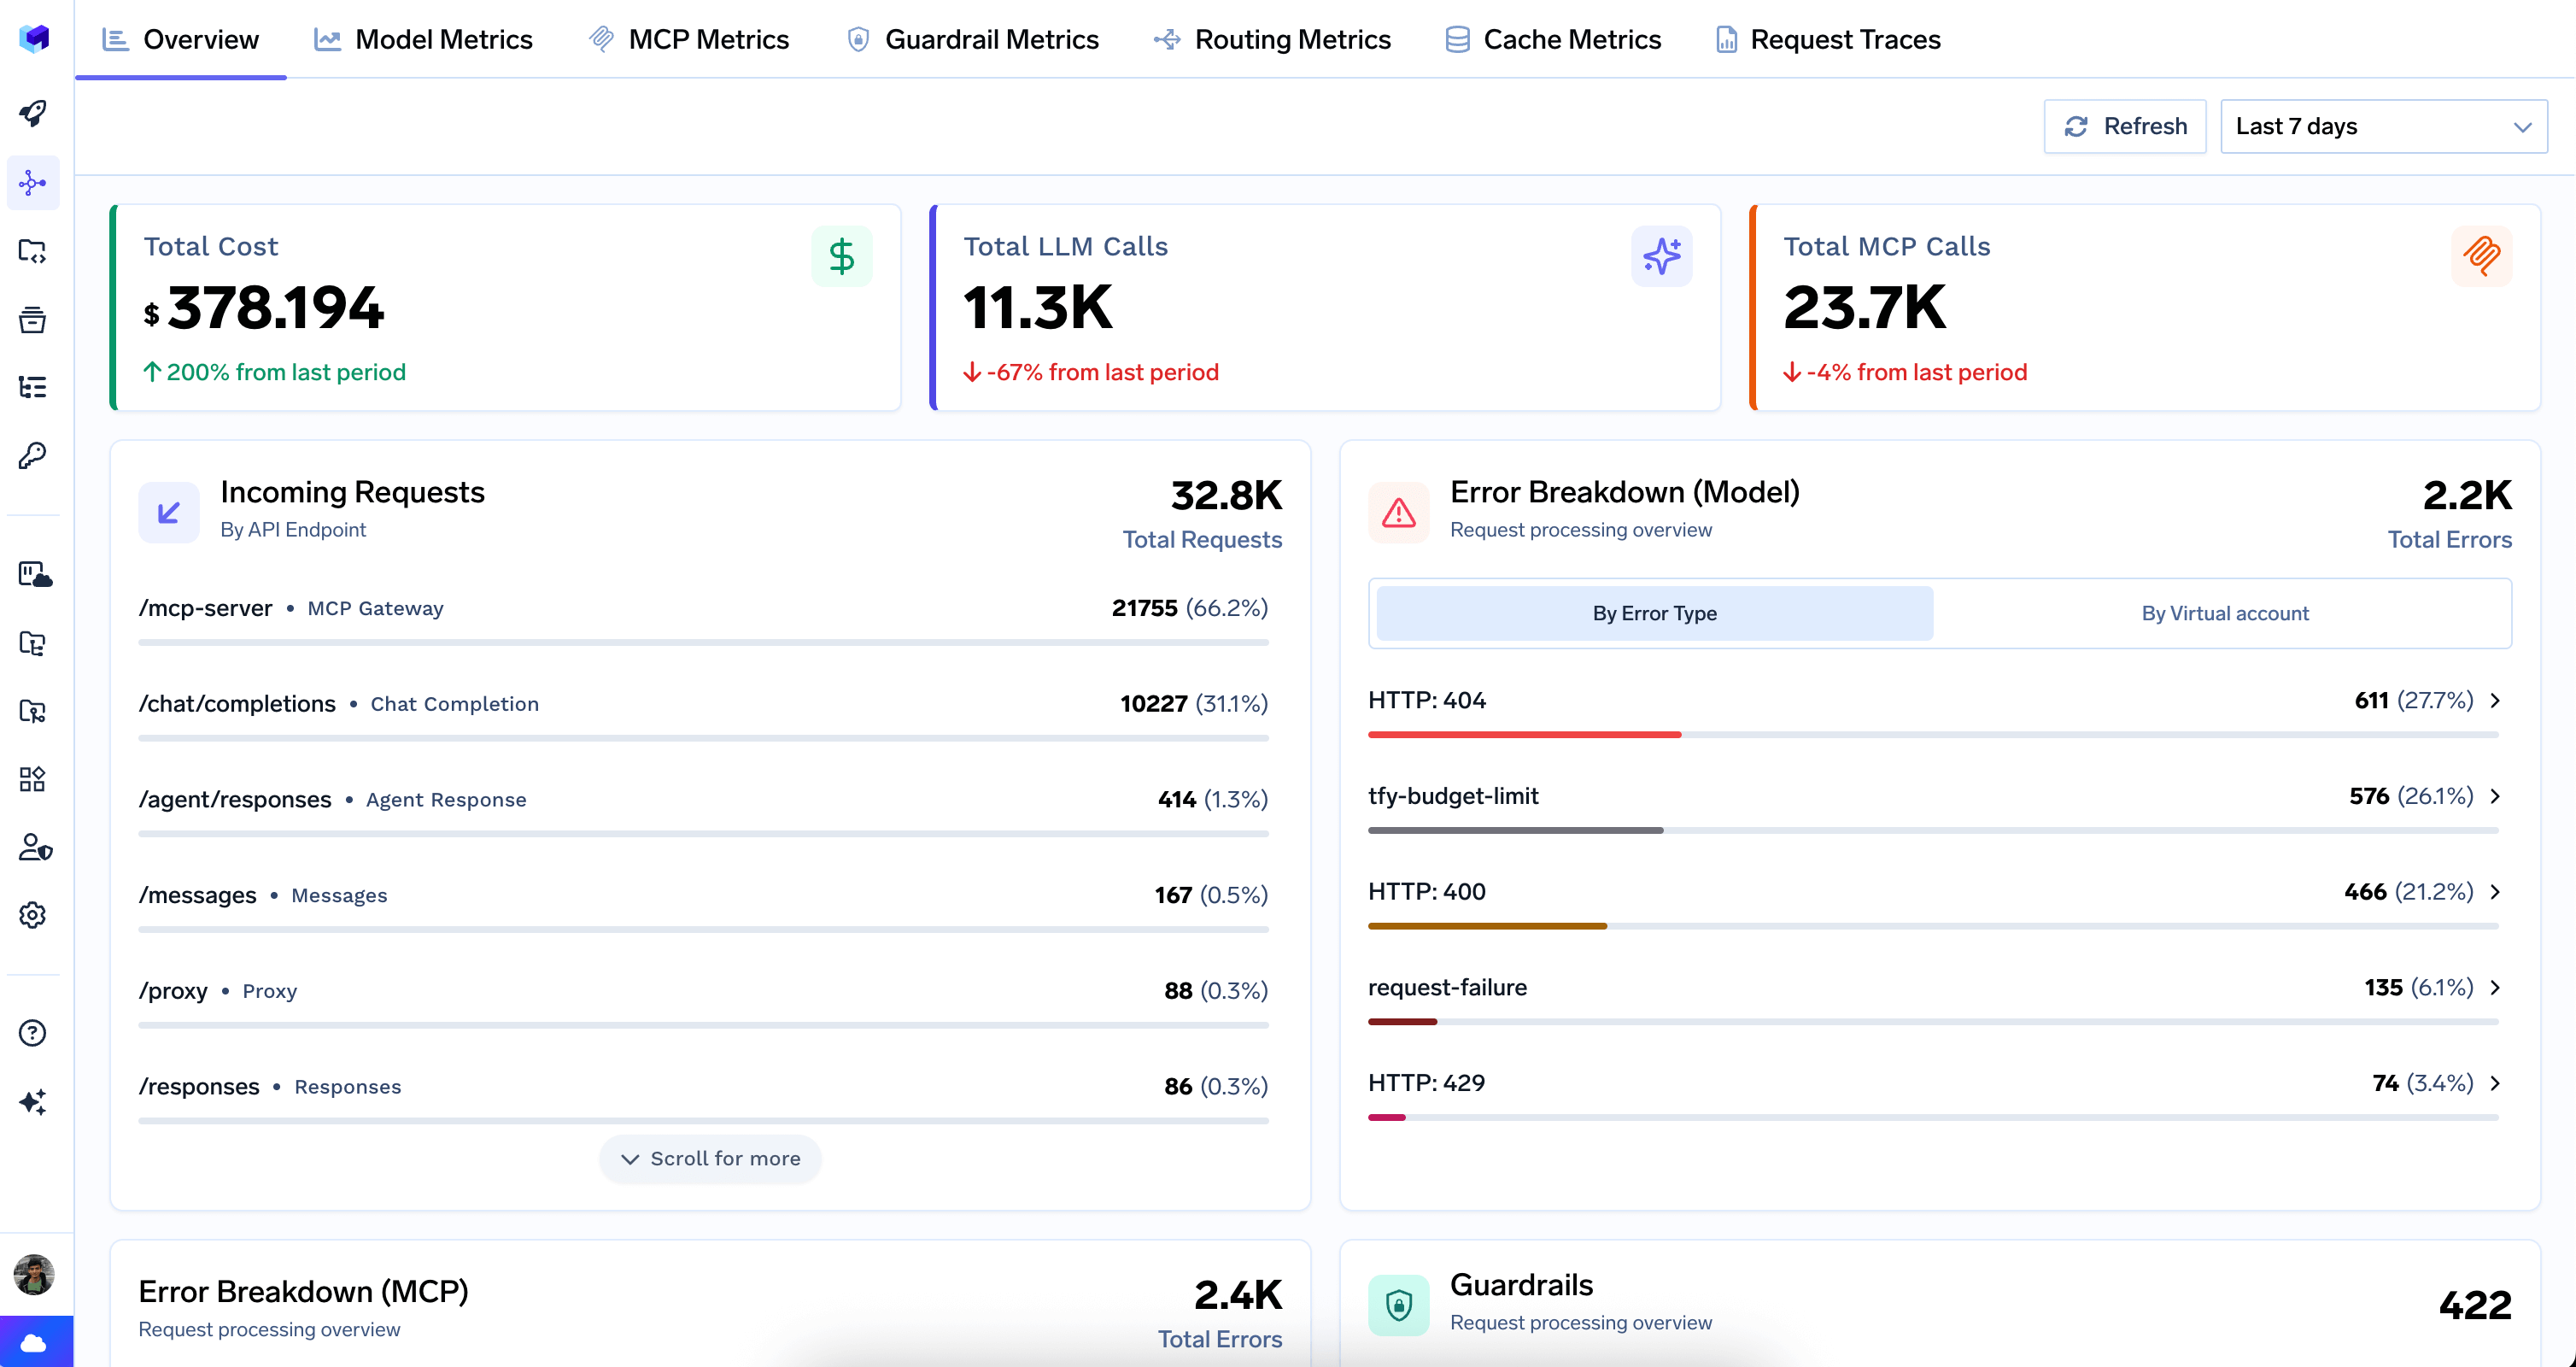
アナリティクスダッシュボードは、ユーザー、仮想アカウント、チーム、構成ごとにグループ化された事前構築済みのビューでこれらを視覚化します。ルーティングメトリクスタブには、どの予算上限やレート制限が誰によって達しているかが表示されるため、月末を迎えてからではなく、どのチームが予算を消費しているかをその場で正確に把握できます。
すべてのトレースはOpenTelemetry経由で任意のSIEMや可視性プラットフォーム(Grafana、Datadog、Splunk、または既存のスタック)へエクスポート可能であり、カスタムダッシュボードの作成、自動アラート設定、既存のFinOpsツールとの連携を実現します。
TrueFoundryの予算制限エンジンは、リクエストごとに複数のルールを評価し、最も制限の厳しい一致ルールを適用します。ルールは順序付け可能で、組み合わせることができます:
実践的な構成例: チームオーバーライド付きの開発者ごと日次上限
MLチームのメンバーは最初にルール1に一致します($100/日)。その他のすべての開発者はルール2に一致します($10/日)。トラッキングのために両方のルールが評価されますが、許可/ブロックの決定は最初に一致したルールに従います。
モデルレベルのセーフティネットの追加
個々のユーザーは1日あたり$10以内に収まります。しかし、すべてのユーザーが各自の制限内に収まっていたとしても、組織全体のGPT-4の総支出は月額$500に制限されます。これにより、制限内の個別ユーザーが多数集まることで、全体としてモデル予算を使い果たしてしまうシナリオを防ぎます。
ルールの完全なスキーマについては、TrueFoundryの予算制限ドキュメントを参照してください。

レート制限は、単なるユーザーやチームだけでなく、特定の環境、モデル、またはアプリケーションを対象にしてスコープを設定できます:
これにより、本番環境のトラフィックに影響を与えることなく、開発環境でのGPT-4の使用量を1日あたり1,000リクエストに制限できます。テスト中にLLMを呼び出すCI/CDパイプライン(予期せぬコストの代表的な原因)を、CI設定を変更することなく制御可能です。
全設定オプションについては、TrueFoundryのレート制限ドキュメントを参照してください。
フォールバックは単なる信頼性機能ではなく、コスト管理のメカニズムでもあります。プロバイダーからの429(レート制限)レスポンス発生時に自動フェイルオーバーすることで、再試行や失敗したリクエストに対する余計な支払いを防ぎます。
ゲートウェイのフォールバックチェーンは、以下のシナリオを自動的に処理します:
TrueFoundryのロードバランシングとフォールバックは、ターゲットごとの再試行設定を備えた3つのルーティング戦略(優先度、ウェイト、レイテンシー)すべてを処理するため、各アプリケーションで再試行ロジックを実装する必要がありません。
正確な削減額はワークロードの構成によって異なりますが、以下のフレームワークによって削減の方向性と機会を把握できます:
現実的な複合シナリオの例: 月間$150,000のLLM API支出がある500人規模のエンジニアリング組織の場合。40%のヒット率でのセマンティックキャッシュにより全体で20%削減。開発環境をより安価なモデルへルーティングすることで15%削減。トラフィックの60%をオンプレミス優先にすることでさらに25%削減。合計: 60%の削減、すなわち月額$90,000の節約となります。 TrueFoundry gatewayの価格設定を考慮すると、ROI(投資対効果)は四半期単位ではなく、日数単位で測定されます。
1週目 - 可視化の最優先。 すべてのLLMトラフィックをTrueFoundry AI Gateway経由でルーティングします。公開価格を使用してコスト追跡を有効化します。すべてのリクエストにコスト帰属用メタデータ(team、project_id、environment)をタグ付けします。1週間後には、費用がどこに使われているかを正確に把握できるようになります。 これだけでも、「AIの請求額が高い」という曖昧な議論から、「チームXのドキュメント解析パイプラインがコストの40%を占めている」という具体的な会話へと変化します。
2週目 - 事前防止。 1週目の分析結果に基づいて、予算制限とレート制限を構成します。開発者ごとの日次支出上限を設定します。開発/ステージング用に環境ベースのレート制限を追加します。最も高価なモデルに対してモデルレベルの月次上限を設定します。これらの制御により、次の偶発的なコスト高騰インシデントを防ぎます。 これらは最適化というよりも、防護壁として機能します。
3週目 - ルーティング。 環境ベースのルーティング(開発環境 → 安価なモデル、本番環境 → プレミアムモデル)やプロバイダーの優先度チェーンを実装する Virtual Models を作成します。オンプレミスのGPUリソースがある場合は、クラウドフォールバック付きの優先度ベースルーティングを構成します。ここで大幅なコスト削減が実現します。
4週目以降 - キャッシュと調整。 反復パターンが多いワークロードに対してセマンティックキャッシュを有効にします。類似度しきい値を調整します。ルーティングメトリクスダッシュボードを確認して、どの予算制限やレート制限が頻繁に発生しているかを把握し、微調整を行います。アナリティクス層により、次に注力すべきポイントが明らかになります。
各チームには、独立した予算追跡機能を備えた独自の仮想アカウントが割り当てられます。プラットフォームチームは組織レベルのモデル上限とデフォルトのレート制限を設定します。個々のチームリードは、他チームのデータにアクセスすることなく自チームのコスト内訳を確認できます。
主な構成: メタデータを使用したプロジェクトベースの予算 + 仮想アカウントごとの週次上限 + 組織全体のセーフティネットとしてのモデルレベルの月次上限。
チームレベルのダッシュボード設定については、TrueFoundry AI Gatewayアナリティクスを参照してください。
顧客向けのAIプロダクトでは、チャージバックや階層型課金を実装するために顧客ごとの使用量追跡が必要です。メタデータ内のcustomer_idですべてのリクエストにタグを付けます。ゲートウェイはcustomer_idごとのコストを自動的に追跡します。プラン階層に対応する顧客ごとのレート制限を設定します。
主な構成: customer_idごとのメタデータベースの予算ルール + 顧客階層によってスコープされたレート制限。これにより、独自の従量課金インフラを構築することなく、請求パイプラインに必要な正確なデータを取得できます。
エージェント型のワークロードは、最もコストが高くなりやすいLLMの利用パターンです。1つのエージェントタスクが、数文字の呼び出しから数千トークンを消費することがあります。エージェントワークフローにおいて、予算上限はオプションではなく、主要な安全メカニズムです。
すべてのエージェントトラフィックをANTHROPIC_BASE_URL(または同等の手段)経由でゲートウェイにルーティングします。日次予算制限を備えたエージェントIDごとの仮想キーを設定します。長期実行されるエージェントが定常的なサブタスクにおいて安価なオンプレミスリソースを優先的に利用するよう、オンプレミス/クラウドのフォールバックチェーンを構成します。
エージェントデプロイの構成については、TrueFoundry Claude Code統合ガイドを参照してください。
ゲートウェイの不在自体がコストとなります。それは主に4つの形で現れます:
インシデントコスト: レート制限のない Agentic ループ、コンテキスト処理の重いプロンプトをテストするエンジニア、冗長な API 呼び出しを発生させるバグなど、こうした事象は日常的に発生します。問題は、それらが 50 ドルの時点で停止されるか、月額請求書で 5,000 ドルになってから発覚するかです。
最適化のタイムラグ: 一元化されたルーティングがない場合、より安価なモデルへのフォールバックやキャッシュの実装を望むすべてのチームが、それを個別に構築することになります。プラットフォームレベルの最適化であれば1人のエンジニアが1週間で済ませられる作業に、チーム間で断片化した取り組みにより6か月もかかってしまいます。
帰属化のギャップ: コストをチーム、アプリケーション、機能ごとに帰属(アトリビューション)できない場合、誰にも AI 支出の責任を持たせることができず、最もレバレッジの高い最適化ターゲットを特定することもできません。
コンプライアンス上のリスク: 規制の厳しい業界やマルチテナント製品において、顧客ごとまたはチームごとのコストと使用量の帰属を証明できないことは、単なる財務上の問題にとどまらず、ガバナンスおよび課金の正確性の問題となります。
LLM コスト最適化とは、出力の品質を維持しながら、組織が大規模言語モデル(LLM)の API 呼び出しに支払う費用を削減するための一連の戦略と管理策です。従来のチャットボット導入よりもはるかに多くのトークンを消費する Agentic ワークロードに牽引され、エンタープライズの LLM API 支出が6か月で倍増し、2026年末までに150億ドルに達すると予測されているため、今まさに重要となっています。体系的なコスト最適化を行わない場合、その支出の 40〜60% は純粋な無駄(冗長な呼び出し、簡単なタスクに対する過剰なモデル指定、キャッシュの欠如、予算管理の欠如)となります。
個別最適化をアプリケーションコード内に実装することは可能ですが、3つの問題に直面します。すべてのチームが同じインフラを不統一に再構築すること、どこに集中すべきかを知るための一元的な可視性がないこと、そして最適化の精度がスタック内で最もメンテナンスされていないアプリケーションのレベルに依存してしまうことです。AI Gateway は、個別のチームに何の実装も求めることなく、すべてのアプリケーションに対して一元的にコスト管理を全面的かつ同時に適用します。 ゲートウェイ内の1つのルーティングルールが、数重のアプリケーションにわたる数百のコード変更を置き換えます。
セマンティックキャッシュは、カスタマーサポート、FAQ システム、ドキュメント検索、分類パイプラインなど、クエリの重複率が高いワークロードにおいて、通常 30〜50% のコストを削減します。 この削減は、以前に回答された質問と意味的に類似しているクエリに対して、キャッシュされたレスポンスを返すこと(プロバイダーコストゼロ、レイテンシほぼゼロ)によって実現されます。ヒット率はワークロードのパターンに大きく依存し、多様でユニークなクエリが多いワークロードではヒット率が低くなります。ワークロードの評価としきい値調整のガイダンスについては、TrueFoundry セマンティックキャッシュガイドを参照してください。
モデルルーティングは、複雑さ、チーム、環境、その他の基準に基づいて、各 LLM リクエストを最もコスト適したモデルに送信します。研究(RouteLLM、ICLR 2025)によると、リクエストの 14〜26% のみを最先端モデル(frontier model)にルーティングし、残りをより安価なモデルで処理することで、75〜85% 低いコストで最先端モデルの 95% のパフォーマンスを達成できることが示されています。実際に GPU インフラを持つ企業にとって最も影響力のある形態は、オンプレミスをプライマリ、クラウドをフォールバックとするルーティングです。トラフィックは自社の GPU(限界費用ほぼゼロ)に留まり、キャパシティが枯渇した場合にのみクラウド API にバーストします。TrueFoundry の Virtual Models は、アプリケーションコードを変更することなく、これら3つのルーティング戦略(優先度、ウェイト、レイテンシ)すべてを実装します。
TrueFoundry の予算制限機能は、階層型かつルールベースです。誰に適用するか(ユーザー、チーム、仮想アカウント、モデル、またはメタデータ値)、予算額と期間(例:ユーザーあたり1日 10 ドル)、および制限が個人単位か共有かを指定するルールを定義します。複数のルールは重複して適用されます。たとえば、エンジニア個人に1日 10 ドルの上限を設定しつつ、組織全体の GPT-4 の月額 500 ドルの上限にも貢献させることができます。該当する上限を超えると、ゲートウェイはトークン消費が発生する前にリクエストをブロックし、エラーを返します。制限に達する前にアラートを発信するよう設定することも可能です。
LLM のコスト問題はインフラの問題であり、アプリケーションの問題ではありません。 個々のチームにプロンプトの効率化や独自のマシンのレート制限実装を求めるだけでは解決できません。請求書が届いた後ではなく、トークンが消費される前のすべての LLM 呼び出しに対してコストガバナンスを適用する一元的な管理層が必要です。
AI Gateway がまさにその管理層となります。コストを可視化し(アトリビューション)、無駄を排除し(予算制限とレート制御)、高価なモデルの使用を例外化し(インテリジェントルーティング)、反復的な計算を無償化します(キャッシュ)。これらのメリットはそれぞれ単体でも利用可能ですが、組み合わせることで、本番 LLM ワークロードにおいて定常的に 50〜80% のコスト削減を実現します。
TrueFoundry の AI Gateway はこれら4つのレバーを単一のプラットフォームに実装しており、2026年の Agentic AI コスト最適化において Gartner に取り上げられました。1 vCPU 上で 4ms 未満のオーバーヘッドと 350+ RPS を誇るこのゲートウェイは、有意義なすべてのコスト管理機能を追加しながら、レイテンシに実質的な影響を与えません。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



























