



November 6, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
GPT-6 Astraは2026年9月3日に登場しました。API文字列は gpt-6-astra です。日付付きのスナップショットも別個のエイリアスもなく、モデルページでは gpt-6-astra がスナップショットとエイリアスの両方として掲載されています。
OpenAIのモデルドキュメントによる仕様は以下の通りです:
詳細な仕様において、見出し以上に重要な点が3つあります。
第1に、reasoning.effort は none を受け付けなくなりました。GPT-5.6 Solでは受け付けていました。none に固定された安価で高速なパスがある場合、そのまま移植することはできません。
第2に、temperature、top_p、logprobs が廃止されました。チェンジログには、Astraは「カスタムの temperature や top_p の値、および log probabilities をサポートしない」と明記されています。スタック内でサンプリングパラメータを設定している部分は、切り替える前に監査が必要です。
第3に、ツール呼び出しには Responses API が必須となりました。現在 Chat Completions を介してツールを呼び出している場合、これはモデルの単純変更ではなく移行作業となります。
[スクリーンショット: OpenAI Platform — コンテキストウィンドウ、最大出力、トークン単位の価格を表示している gpt-6-astra モデルページ]
コンテキストウィンドウと出力上限に変更はありません。変わったのは価格です。
出典:GPT-6 Astraモデルドキュメント、GPT-5.6 Solモデルドキュメント(2026年9月)。OpenAIはGPT-5.6 Solの料金を少なくとも2026年11月21日まで利用可能なプロモーション価格として説明しているため、この比率はその日付以降維持されない可能性があることに注意してください。
すべての料金が一律に同じ倍率で移動しました。これは、以下のキャッシュに関する検討において重要な意味を持ちます。
Batch と Flex は Standard の50%に維持されています。OpenAIがStandard処理の最大2倍のスピードを提供すると謳う Fast モードは、適用可能な料金の2倍に設定されているため、Fast モードのAstraは入力$20、出力$100となります。
OpenAIはローンチ記事で大規模な直接比較表を公開しています。ここでは、掲載する価値のある部分と、ほとんどの報道が見落としている部分を取り上げます。
出典:GPT-6 Astraローンチ記事(2026年9月)。スコアはいずれかの推論努力度における最高値です。
Astraが明確にリードしている領域。 長期的なエージェント作業。Terminal-Bench 4.0ではSolより20ポイント以上向上しています。Terminal-Bench Scienceはほぼ3倍になりました。AutomationBenchは2倍以上になりました。512K-1Mでのロングコンテキスト検索は73.8%から96.3%に向上しています。これらはこのモデルがターゲットとして構築されたワークロードであり、その差は非常に顕著です。
差が誤差範囲に縮まる領域。 単発の知識および推論。GPQA Diamondは94.6%から96.0%への移動にとどまります。DeepSWEは72.7%から74.1%への移動です。トラフィックが「ステップのあるタスク」ではなく「回答のある質問」である場合、わずか1ポイント程度の向上のために2.5倍のコストを支払うことになります。
Astraが勝っていない領域。 OpenAIが敢えて掲載した2つのサードパーティ総合インデックスにおいて、Astraは首位ではありません。Artificial Analysis Intelligence Indexでは、Claude Fable 5.1が65.7であるのに対し、Astraは61.2です。Coding Agent Indexでは、Claude Opus 5が68.1であるのに対し、Astraは67.0です。OpenAIが両方の数値を公開したことは評価すべきであり、これらは上記のエージェント向けベンチマークでの勝利に対する公正なカウンターウェイトとなっています。
価格に関する議論を複雑にする1つの要素。 OpenAIのタスクあたりの見積もりコストは、2.5倍の料金設定にもかかわらず、Solよりも低くなることがあります。これはAstraがより少ないトークン数でタスクを完了するためです。ローンチ記事では、Terminal-Bench 4.0でのタスクあたりの推定APIコストがSolと比較して約9%低く、低コスト設定でのTerminal-Bench Scienceでは約27%低く、BenchCADでは約43%低いと主張されています。これらは特定の構成におけるOpenAI自体の試算であり、第三者による再現ではなく、あらゆるトラフィックに一般化できるわけではありません。しかし、「2.5倍高価」という要約がエージェント作業においては不適切であることを意味しています。トークンあたりの価格ではなく、完了したタスクあたりのトークン数を測定してください。
TrueFoundryは、キャッシュ書き込みが最初に課金対象となった際にGPT-5.6でのキャッシュ損益分岐点の計算を行いました。同様の疑問がここでもあてはまり、その答えは一見する以上に興味深いものです。
Astraのキャッシュ乗数はGPT-5.6と同一です。モデルドキュメントによると、キャッシュ書き込みは非キャッシュ入力レートの1.25倍で課金され、公表されているキャッシュ済み入力レート$1.00は$10.00の入力レートに対して正確に0.10倍です。したがって:
共有プレフィックスに対するリクエストのうち、読み取りではなくキャッシュ書き込みである割合を w とします。キャッシュが採算ラインに乗る(損益分岐点に達する)のは以下の場合です:
1.25w + 0.10(1 - w) = 1
1.15w = 0.90
w = 78.3%
損益分岐点は78.3%であり、GPT-5.6から変更ありません。 P が相殺されるため、2.5倍の価格上昇は何も変化させません。キャッシュの優位性が失われるのは、特定のプレフィックスに対するリクエストの約78%以上が書き込みである場合、つまり共有コンテキストが変更または期限切れになるまでに平均して約1.3回未満しか利用されない場合のみです。実際のプロダクション環境のエージェントワークロードで、そのようなケースはほぼ存在しません。
価格上昇によって変化するのは、削減できる「金額の大きさ」です。25回のリクエストセッションで再利用される32Kトークンの共有プレフィックス(1回の書き込みと24回の読み取り)を例にとってみましょう:
割合は同一です。しかし、ドル換算の額は2.5倍になっています。キャッシュは常に実行する価値がありましたが、Astraにおいては、キャッシュを適用しないことで生じるコストの損失が2.5倍大きくなります。
失敗のパターンも変わっていません。それは、コンテキストが激しく入れ替わるケースです。エージェントが数ターンごとにシステムプロンプトやツールスキーマを再構築する場合、ほとんど読み取られないキャッシュの書き込みに100万トークンあたり$12.50を支払うことになります。これは以前なら$5.00のミスでしたが、今では$12.50のミスになります。
公称されているGPT-6のコンテキストウィンドウは1,050,000トークンです。しかし、課金はコンテキスト全体に対して均等にスケーリングするわけではありません。
モデルドキュメントより:「272Kを超える入力トークンを含むプロンプトは、リクエスト全体に対して入力およびキャッシュレートが2倍、出力が1.5倍で価格設定されます。」
ここをよく読んでください。これは272Kを超えた超過分に対してではなく、リクエスト全体に対して適用されます。境界線を超えた場合、追加トークンだけが2倍になるのではなく、全トークンが2倍になります。
プロンプトサイズが0.7%増加するだけで、入力請求額が101%増加します。キャッシュされた読み取りも100万トークンあたり$1.00から$2.00へと2倍になり、出力は$50.00から$75.00になります。GPT-5.6 Solにも同じルールがあったため、これは新しいルールではありません。しかし、Astraのレートにおいてはその差額(ステップ)が2.5倍高くなっています。
実用上の結論:プロンプトが272K付近にある場合、利用可能な最もレバレッジの高いコスト最適化は、プロンプトを272K未満に抑えることです。275Kのプロンプトから5Kトークンを削ることは、どのようなルーティング変更を行うことよりも価値があります。
[スクリーンショット: OpenAI Platform — モデルごとの入力、キャッシュ済み入力、および出力トークンの消費金額を示す利用状況ダッシュボード]
フロンティアモデルのローンチ直後の数週間に繰り返し発生する4つの失敗モードがあり、Astraにはその4つすべてが当てはまります。
すべてを新モデルにルーティングしてしまう。 ローンチ後にチームが行う最も高くつく行動は、デフォルトの向け先を新モデルに設定することです。入力$10、出力$50では、安価なモデルで正確に回答できる分類呼び出しに対して、品質の向上もないまま前月の2.5倍の費用を支払うことになります。上記のベンチマークのばらつきは、単一モデルへの移行ではなく、複数モデルの組み合わせ(混合フリート)を支持する根拠となります。
移行は単純な文字列の置き換えではない。 none の reasoning effort は利用できず、temperature、top_p、logprobs も存在せず、ツール呼び出しには Responses API が必要です。 gpt-5.6-sol に対して動作していたコードが gpt-6-astra に対して失敗する可能性があり、それは本番環境に投入するまで表面化しないことがあります。
不整合モニタリング(Misalignment monitoring)によってリクエストが停止する可能性がある。 OpenAIは、サポートされている Responses API リクエストにおけるエージェントの作業に対して非同期チェックを実行します。ローンチ記事ではその結果について明確に述べられています。ChatGPTやCodexではアクションの確認を求められる場合がありますが、「APIではタスクが停止します」。OpenAIはこれらのチェックが「正当な作業を中断することがある」と認めています。これは注記レベルの話ではなく、設計時に考慮すべき新しい信頼性の特性です。
請求書が届くまで実際のコストが誰にもわからない。 モデルがタスクごとに異なるトークン数を使用する場合、トークン単位の価格はほとんど参考になりません。リクエスト単位、チーム単位でのコスト帰属(トラッキング)がなければ、「Astraは自社にとって安くなったのか、高くなったのか」という問いに答えることはできません。
より高価なフロンティアモデルが登場したからといって、ゲートウェイの必要性が薄れるわけではありません。むしろすべてのルーティング決定の価値が2.5倍になるため、その重要性はさらに高まります。
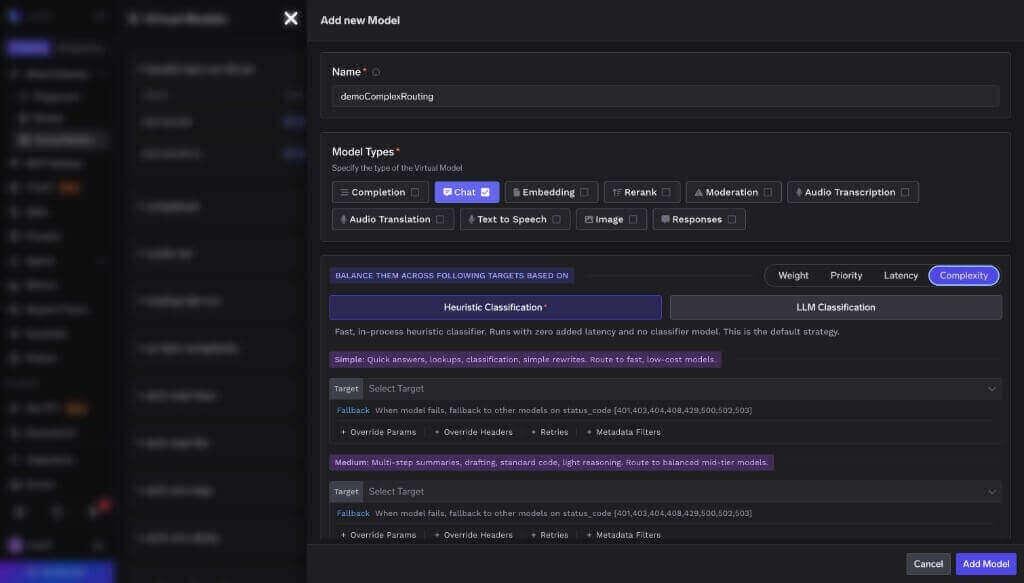
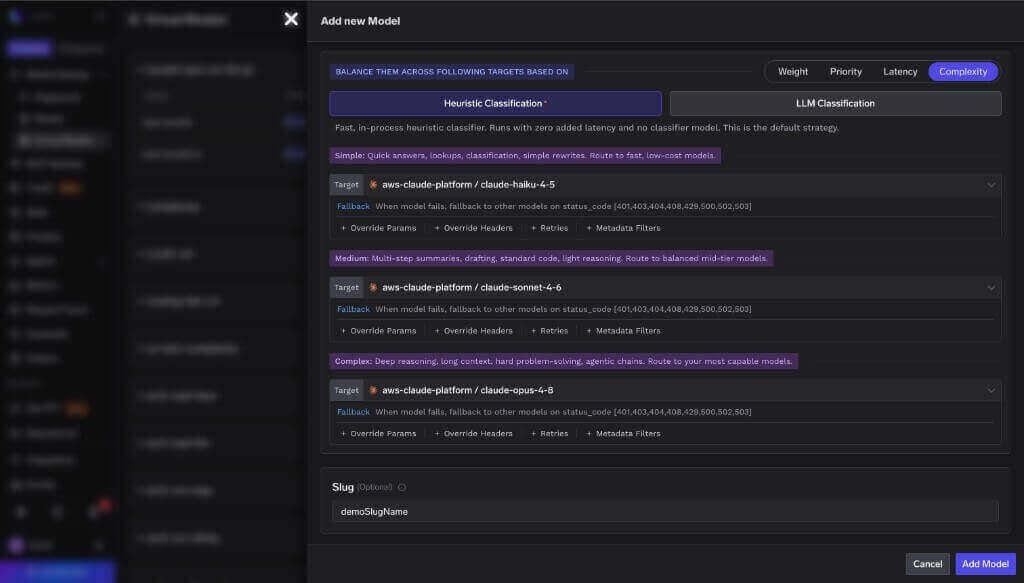
習慣ではなく、複雑さに基づいてルーティングする。 AI Gatewayは着信リクエストを分類し、それぞれを適切なティアに送信します。これにより、高度なエージェント作業はAstraに送信され、抽出、分類、要約はAstraに届かないよう制御されます。550個のプロンプトを対象としたTrueFoundry独自のAuto Routingベンチマークでは、階層化(ティアリング)により、ベースライン品質の98%を維持しながらコストを69%削減し、平均レイテンシは7.6秒から4.0秒に低下しました。プロダクション環境のトラフィックパターンでは、削減率は80%に達しました。これらの削減率を $10/$50 のレートに適用すると、以前の $4/$20 の時よりもはるかに大きな価値を生み出します。
プロバイダー間でキャッシュ処理を標準化する。 Astraのキャッシュ仕様はOpenAIのものです。Anthropicの仕様は異なり、Bedrockの仕様もまた異なります。ゲートウェイでのプロバイダー非依存のプロンプトキャッシュを利用すれば、プレフィックスを1度書き込むだけで、ルーターがどのモデルを選択しても上記の78.3%のルールが適用されます。
トークン単位のコストではなく、タスク単位のコストを測定する。 Astraの価格設定に関する議論全体はトークン効率に依存しており、価格表から結論を出すことはできません。チームおよびモデルごとに細分化されたリクエストあたりのコスト、トークン数、レイテンシを把握することこそが、Astraの「タスクあたりのトークン削減」という主張が実際のワークロードで有効かどうかを確認する唯一の方法です。

モデル間で共通のガードレールパスを維持する。 ゲートウェイレベルのガードレールは、どのモデルが応答するかに関わらず、リクエストおよびレスポンスパス上で実行されます。そのため、ルーティング構成を変更しても、セキュリティや安全性の体制が意図せず変わることはありません。

2026年9月時点の要約手順:

GPT-6 Astraは、本来の目的として構築された作業において間違いなく大きな進化を遂げています。Terminal-Bench 4.0で20ポイント上昇、ロングコンテキスト検索で22ポイント上昇、AutomationBenchで2倍以上という数値は、段階的な改善にとどまらないものです。OpenAI自体が公表したサードパーティの総合インデックスでは首位ではなく、単発の知識問題におけるGPT-5.6 Solに対するアドバンテージは誤差範囲に近いと言えます。
価格設定も同様に二面性を物語っています。すべての料金が2.5倍になりました。これは単純な値上げのように聞こえますが、Astraはより少ないトークンで完了するため、いくつかのエージェントベンチマークにおいてOpenAI独自のタスクあたり推定コストがSolよりも低くなることに気付くと、見方が変わります。両方の事実が成り立ち得ます。どちらが当てはまるかは実際のトラフィックに依存する実証的な問題であり、答える唯一の方法は、両方を実行して完了タスクあたりのコストを測定することです。
測定を必要としない事実が2つあります。キャッシュはGPT-5.6と同じ正確に78.3%の損益分岐点で引き続き有効であるため、現在キャッシュを利用している場合は継続してください。そして、272Kの課金断崖は、数千トークン増加しただけのプロンプトに対して入力請求額を気づかないうちに2倍にするステップ関数として存在しています。
したがって、最終的には何を運用管理したいかという点に帰着します。1つのモデルとシンプルな請求にまとめたい場合は、すべてをAstraに向けて、トラフィックの簡単な半分に対しても過剰な支払いを受け入れることになります。高度な作業をフロンティアモデルに送り、それ以外を安価なモデルに送信したい場合は、ルーティング層が必要となります。入力$10、出力$50という価格設定において、それを構築するための計算上の合理性は2.5倍高まったと言えます。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.




GPT-6 AstraはOpenAIのフロンティアモデルで、2026年9月3日にリリースされ、APIではgpt-6-astraとして呼び出せます。OpenAI API、Microsoft Azure、AWS Bedrockを通じて利用できるほか、ChatGPT Plus、Pro、Business、Enterpriseのユーザーも利用できます。
2026年9月時点で、100万トークンあたり、入力が10.00ドル、キャッシュされた入力が1.00ドル、キャッシュの書き込みが12.50ドル、出力が50.00ドルです。BatchとFlexはこれらの50%、Fastモードは2倍です。入力が272Kトークンを超えるリクエストは、リクエスト全体に対して、入力とキャッシュが2倍、出力が1.5倍の単価で課金されます。
1,050,000トークンで、最大出力は128,000トークンです。どちらもGPT-5.6 Solと同じです。実際の制約は技術面ではなく料金面にあります。入力が272Kトークンを超えると、リクエスト全体が入力単価の2倍で課金されます。
タスクの性質によって大きく変わります。長期にわたるエージェント型の作業では向上が大きく、Terminal-Bench 4.0は37.3%から57.9%に上がります。単発の知識に関する質問では向上はわずかで、そのためにトークンあたり2.5倍の料金を支払うことになります。全面的に切り替えるのではなく、タスクに応じてルーティングしてください。
はい。効果の幅も同じです。キャッシュの書き込みは入力価格の1.25倍、読み取りは0.10倍で、GPT-5.6とまったく同じです。そのため、損益分岐点はどちらの場合も書き込み比率78.3%になります。定価が上がると節約額の絶対値は増えますが、しきい値は変わりません。
TrueFoundryのAI Gatewayが追加するのはおよそ3〜4ミリ秒で、1 vCPUで350 RPS以上を処理できます。数秒かかる生成時間と比べれば、無視できる水準です。






















