



November 16, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
Anthropicが2025年9月に発表したコンテキストエンジニアリングに関するエッセイは、この分野の再定義を行いました。それは、単一のプロンプトに適切な言葉を選ぶことから、エージェントの作業の各ステップでコンテキストウィンドウに含めるべき情報を決定することへのシフトです。本記事では、ゲートウェイ層でそれらの決定を実行するインフラストラクチャについて取り上げます。セッション追跡、会話の圧縮(Compaction)、およびプレフィックスキャッシュは、コンテキストエンジニアリングを本番環境で実際に稼働させるゲートウェイレベルのプリミティブです。これらは戦略(それはエージェントに属します)ではなく、何千もの長時間実行(Long-running)プロセス全体でその戦略を強制可能にする基盤となります。
Northwind社での金曜日の午後。 プラットフォームチームのスタッフエンジニアであるMayaは、「#agent-help: code-review is failing on big PRs(大きなPRでコードレビューが失敗する)」という Slack スレッドを開きます。彼女は障害の原因を、600行のリファクタリングである PR #4127 まで特定しました。エージェントは23回のツール呼び出しを実行していました。4つのファイルを読み取り、テストスイートを2回実行し、リンターに問い合わせ、カバレッジを取得しました。24ターン目にモデルは同じパラグラフを3回繰り返し、文の途中で終了する応答を返しました。
ゲートウェイのセッションビューには、決定的な証拠が示されていました。失敗した時点で、リクエストのペイロードは200Kコンテキストモデルに対して185Kトークンを超えて膨れ上がっていました。2回のテストスイート実行だけで、それぞれ数万トークンが加算されていました。エージェントは容量が不足していることに気付かず、モデルの注意(Attention)予算が崩壊するまで、会話配列にツール結果を追加し続けていました。
この修正には、通常、より賢いベースモデルは必要ありません。必要なのは、エージェントがコンテキスト予算を使い果たしてしまうのを防ぐインフラストラクチャです。「誤ってコンテキストウィンドウを一杯にしてしまった」という状態を、「ゲートウェイが150Kのしきい値付近で圧縮を行い、エージェントは処理を継続した」という状態に変えることです。本記事では、そのインフラストラクチャがどのように機能するかを解説します。
2023年頃の多くのアプリケーションにおいて、プロンプトエンジニアリングとは、単一の応答を正しく得るために適切な言い回し、例、および順序を選択することを意味していました。Anthropicが2025年9月のエッセイで明確に述べたように、コンテキストエンジニアリングはその発展形です。単一の呼び出しだけでなく、エージェントの実行全体を通じて、コンテキストのどのような構成がモデルの望ましい挙動を引き出す可能性が最も高いかを問いかけます。
このシフトが重要である理由は、長時間実行エージェントが状態を蓄積するためです。すべてのツール結果、以前のモデル応答、およびユーザーのフォローアップは、コンテキストウィンドウ内に存在するかいずれかです。名目上のコンテキスト制限に達するかなり前に、モデルのパフォーマンス低下(Anthropicの表現では「コンテキストの腐朽(context rot)」)が発生します。正確な低下曲線は、モデル、タスク、および関連情報がウィンドウのどこに配置されているかによって異なります。したがって、エージェントには決定すべきことがあります。何を保持し、何を要約し、何を破棄し、何に全額を支払い、何をキャッシュするか。これらの決定はエージェントに属します。それらを実行するメカニズムは、ゲートウェイ(TrueFoundryのAI Gatewayにおいて、すでにすべての呼び出しに介在している層)に属します。リクエストに会話IDのタグを付け、システムプロンプトと増大する履歴の比率を計算し、しきい値で圧縮エンドポイントを呼び出し、呼び出しごとに同じ12Kトークンのシステムプロンプトの料金を支払う代わりにプレフィックスキャッシュにヒットさせます。エージェントは希望するコンテキスト構成を決定し、ゲートウェイはその構成を効率的に実装します。本記事の残りの部分では、そのメカニズムについて説明します。
単一のエージェントの実行は、プロバイダーへの多数の呼び出しで構成されます。1つのPRを処理するコードレビューエージェントは、計画に1回、ファイルの読み取りに数回、テストの実行に数回、レビューの下書きに1回、ツールのエラー後の修正に1回というように、10〜30回の呼び出しを行う場合があります。セッションメタデータがない場合、トレースストアには30個の無関係なリクエストが表示されます。セッションメタデータがあれば、トレースストアには、エンドツーエンドで再試行可能な30ターンの会話が表示されます。
慣例として、外部呼び出し時にエージェントによってヘッダーが設定されます。TrueFoundryのAI Gatewayでは、これは X-TFY-CONVERSATION-ID ヘッダーです。X-TFY- プレフィックスはTrueFoundryのネームスペースであり、コスト属性特定に関する前回の記事の X-TFY-METADATA ヘッダーとペアで使用されます。特定のヘッダー名は、業界標準ではなく、例示的なゲートウェイの慣例として扱ってください。同等のヘッダーには任意の名前を付けることができ、重要なのは、その値がスパンツリー全体に伝播することです。
HTTP — アプリケーションがマルチターンエージェントの各ターンに会話IDのタグを付与
ゲートウェイがセッションごとに記録する内容:トレースIDを含む会話内のプロバイダー呼び出しの順序付けされたシーケンス、ターンごとおよび会話全体での累積入力、出力、キャッシュ読み取りおよびキャッシュ書き込みトークン、各呼び出しからのメタデータフィールド(前回の記事のコスト属性特定スキーマを引き継ぐ)、および全文ではなくトレースIDへの参照(レンダリングされたコンテキストウィンドウはプロバイダー側に残り、セッション記録は小さく保たれます)。
これはデバッグにおいて重要です。ターン15で失敗した20ターンのエージェントは、20個の独立したリクエストとしてはデバッグできません。シーケンスとしてデバッグできる必要があります。ターン14で生成されたツール結果がターン15の不良な動作を引き起こし、ターン13の入力はすでにコンテキスト制限の95%に達していた、というようにです。セッションビューは、20個のトレースを、累積トークン数、レイテンシープロファイル、ターンごとのキャッシュヒット率を備えた検索可能な1つのタイムラインに集約します。
コーディングエージェントのコンテキストウィンドウは、予測可能なパターンで成長します。以下の簡易モデルでは、ターン0で12Kトークンのシステムプロンプト(ツール定義、スタイルガイド、例)が存在し、それ以降の各ターンで約6Kのレンダリング済みトークン(ツール結果とアシスタントの応答、およびターンごとのオーバーヘッド)が追加されると仮定します。これにより、1ターンあたり約6Kの線形な増加が生じます(実際の実行はより断続的です。表の後の注記を参照してください)。
ウィンドウが一杯になると、厳密には失敗ではなく「劣化」が起こります。検索や指示に従う精度は、名目上の制限に達するかなり前に低下する傾向があります。さらに悪いことに、モデルは性能が低下したというシグナルを出さず、誤っているにもかかわらず、確信に満ちた適切な形式の出力を生成します。ウィンドウが一杯になる頃には、モデルは幻覚(Hallucination)を起こしやすくなり、同じことを繰り返し、指示を見落とし、あるいは誤った形式のツール呼び出しを返すようになります。劣化は断崖絶壁ではなく緩やかな勾配であり、それがどこから始まるかはモデル、タスク、関連トークンの配置場所によって異なります。しかし、運用上の意味合いは同じです。パフォーマンスが完全に崩壊した後ではなく、崩壊する前にインフラストラクチャが動作しなければならないということです。(上記の表は例示的な線形モデルです。実際のコーディングエージェントの実行は通常よりスパイク状であり、大規模なコードベースに対する単一の grep や詳細なテスト実行により、1ターンで20Kトークンが加算されることがあります。)
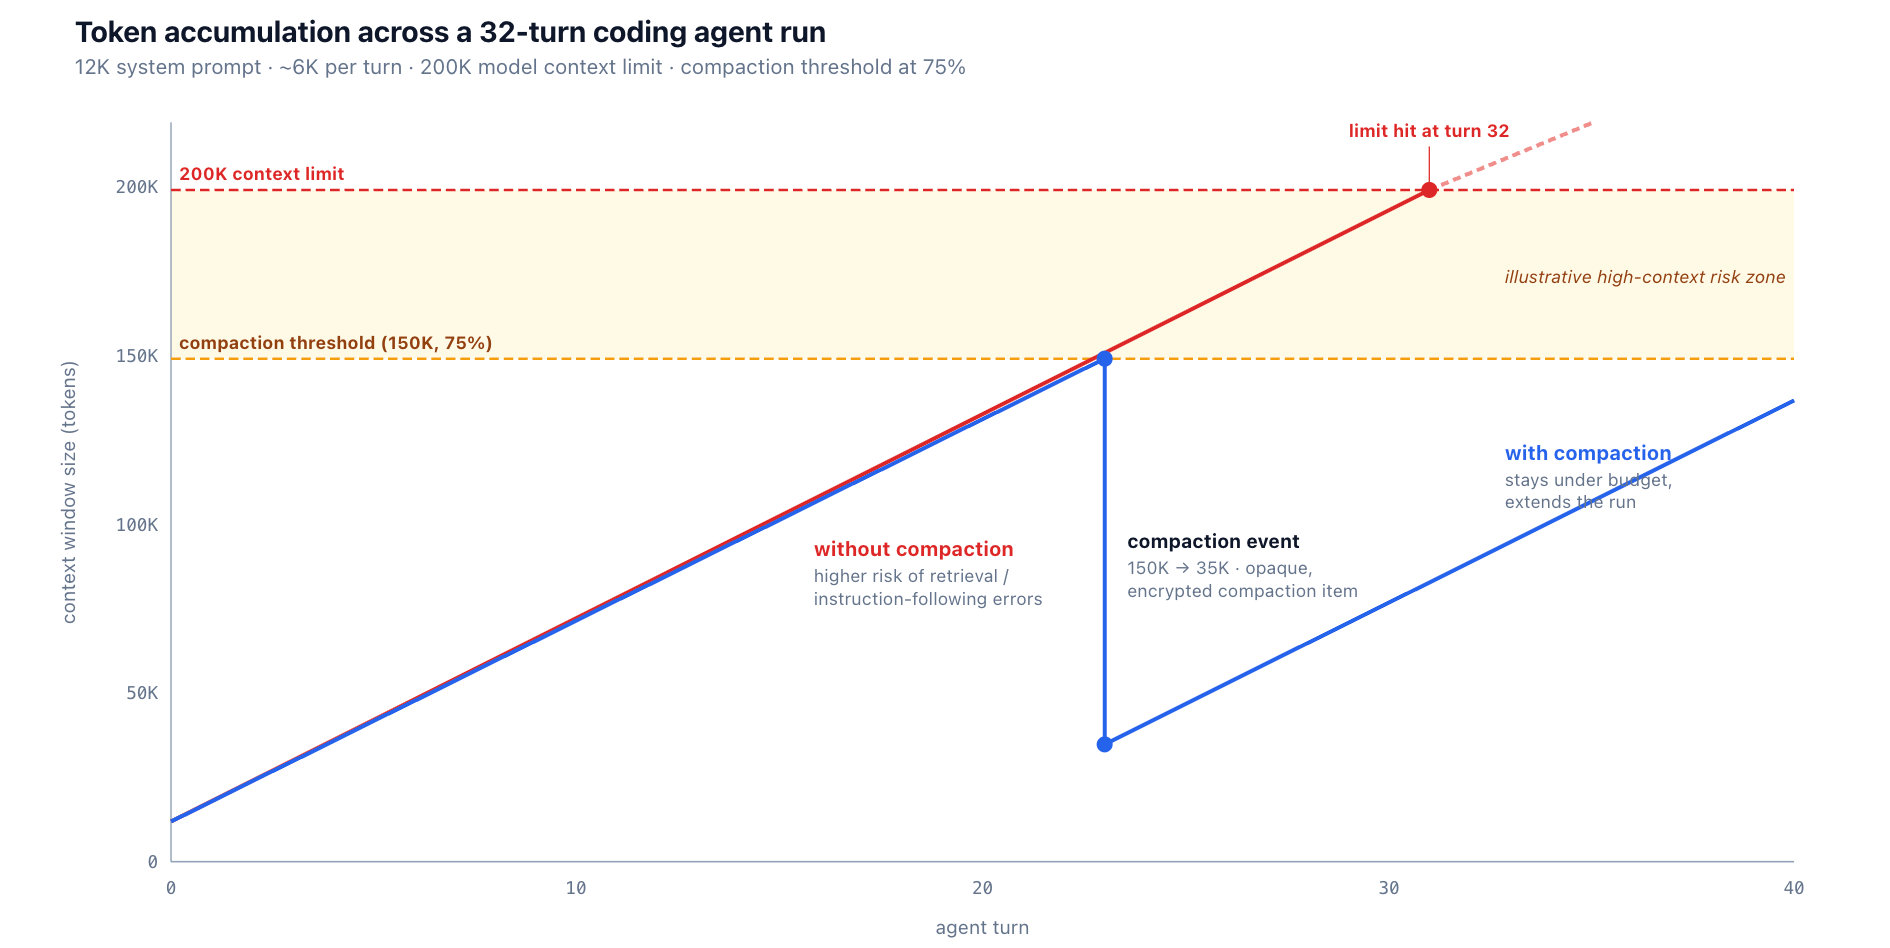
エージェントはこれほど大きく成長させないことを選択することもできます。古いツールの結果を削除したり、サマリーをディスクに書き出したり、新しいコンテキストを持つツール呼び出しごとにサブエージェントを実行したりすることです。これらは実用的な戦略であり、エージェント側に属します。ゲートウェイの役割は、代替手段である「圧縮」を一貫して適用しやすくすることです。ルーティングし、監視し、そのトークンとレイテンシーの影響を属性特定し、いつトリガーされるかについてのポリシーを強制します。TrueFoundryのAI Gatewayでは、この表を現実のものにするターンごとのトークン数は、冒頭で障害を表面化させたのと同じセッションロールアップから得られます。トークンの蓄積は、モデルが破綻した後に発見するものではなく、上昇を監視できるものとなります。
OpenAI Responses APIは、2つのモードでファーストクラスのプリミティブとして圧縮をサポートしています。
スタンドアロン(明示的)。 アプリケーションはコンテキストの増加を検出し、完全な会話を入力として POST /v1/responses/compact を呼び出し、新しい圧縮されたコンテキストウィンドウを受け取ります。次の /responses 呼び出しでは、以前の会話履歴の代わりに、返されたウィンドウがそのまま渡されて使用されます。これは、モデルが必要とする状態を引き継いでいるためです(圧縮アイテムとともに初期の項目の一部が保持される場合もあります)。
Python — アプリケーションの判断による明示的な圧縮
サーバーサイド(自動)。 アプリケーションは、元の /responses リクエストに compact_threshold を指定した context_management を含めます。レンダリングされたトークン数がストリームの途中でしきい値を超えると、サーバーはインバンドで圧縮を行い、レスポンスストリームに暗号化された圧縮アイテムを出力し、別個のラウンドトリップなしで推論を継続します。
Python — context_management を介した自動サーバーサイド圧縮
圧縮アイテム自体はクライアントに対して不透明(Opaque)です。内容を読み取ったり、編集したり、検査したりすることはできません。モデルが処理を継続するために必要な状態と推論を引き継ぎ、元の会話よりも大幅に小さくなります。元のリクエストで store=false が設定されている場合、ZDR(Zero Data Retention)と互換性があります。
圧縮が行われた後の2つのチェーンパターン。ステートレスな入力配列チェーン(Stateless input-array chaining):出力アイテム(圧縮アイテムを含む)を次の入力配列に追加し、リクエストを小さく保つために最新の圧縮アイテムより前のアイテムをドロップします。previous_response_id チェーン:次のリクエストで新しいユーザーメッセージのみを渡し、サーバーに以前の状態を解決させます。前者はアプリケーションにワイヤペイロードの明示的な制御を与え、後者はそれをオフロードします。ZDRに敏感なワークロードでは、store=false を指定したステートレスが標準的なパターンです。いずれの場合も、圧縮はプロバイダーの機能のままであり、TrueFoundryのゲートウェイは呼び出しをルーティングしてセッションタイムラインに記録します。そのため、トークンの減少は、会話配列における理由不明の落ち込みではなく、圧縮呼び出しに起因する観察可能なステップとして扱われます。
多くの本番環境のエージェントにおいて、主なコストは増大する会話ではなく、毎回の呼び出しで変更されずに送信されるシステムプロンプトです。Claude Sonnet 4.6の料金体系(入力トークン100万個あたり3ドル)において、12Kトークンのシステムプロンプトは、キャッシュを使用しない場合、1回の呼び出しあたり0.036ドルかかります。1時間に1,000回の呼び出しを行うと、不変の指示だけで1時間あたり36ドルになります。1つの本番環境エージェントを1年間運用すると、システムプロンプトの部分だけで約315,000ドルに達します。
プロバイダー側のプレフィックスキャッシュがこの問題の解決策です。Anthropicはプロンプト上の cache_control ブレークポイントを介してこれを公開し、OpenAIは1,024トークン以上のプレフィックス一致に対して自動的に適用します。一致は完全なプレフィックスに対して行われるため、両方のプロバイダーでの実用的なルールは同じです。呼び出し間でキャッシュ可能な先頭部分をバイト単位で同一に保つため、安定したコンテンツ(システムプロンプト、ツール定義)を最初に配置し、可変コンテンツ(ユーザーのターン)を最後に配置します。Anthropicの経済性は明確です。キャッシュ読み取りは入力料金の10%(Sonnet 4.6の場合は100万トークンあたり0.30ドル)で請求されます。キャッシュを作成する最初の呼び出しでは、5分間のTTLの場合は25%、1時間のTTLの場合は100%のプレミアムが支払われます。
JSON — システムプロンプト上の Anthropic cache_control ブレークポイント
12Kのシステムプロンプト × 1時間あたり1,000回の呼び出しで、85%のウォームヒット率(コールドパスでのキャッシュミス、ウォームパスでのキャッシュ読み取り)の場合の経済性:
1時間あたり36ドルから9.81ドルへの変化は、プロンプトプレフィックスキャッシュが、長時間の実行を伴うエージェントワークロードにおいて、ほとんどのチームが最初に採用する最適化手法となる理由を示しています。このメカニズムは、プロンプトキャッシュのコアとなる経済原則に従っています。つまり、安定したコンテキストはリクエストごとに再処理するのではなく再利用すべきであり、ゲートウェイにより、運用上それを簡単に強制できるようになります。キャッシュ読み取りトークンおよびキャッシュ書き込みトークンは、TrueFoundryのゲートウェイがコストのために属性特定する同じ呼び出しごとの使用量に反映されます。そのため、上記の割引は概算の試算だけでなく、前回の記事のコスト属性特定ビューで実際のトラフィックに対して確認できます。
圧縮はレイテンシーを増加させますが、キャッシュ読み取りは増加させません。この非対称性が本番環境のヒューリスティックを形成します。
/v1/responses/compact へのスタンドアロン呼び出しは同期的なラウンドトリップであり、入力全体を読み取り、独自のレイテンシーとコスト特性を持つプロバイダー側の圧縮操作を実行し、圧縮されたウィンドウを返す必要があります。150Kトークンの入力の場合、目立つレイテンシーが加算される可能性があります。しきい値を選択する前に、自身のトレースで測定してください。その間、エージェントは停止します。
サーバーサイドの圧縮は改善されていますが、無償ではありません。圧縮パスは次の /responses 呼び出し中にストリーム内で行われるため、その呼び出しのTTFT(Time To First Token)には、圧縮のオーバーヘッドと通常の推論時間の両方が含まれます。高負荷のエージェントでしきい値を超えるたびに圧縮がトリガーされると、ユーザーが体感するTTFTは二峰性(バイモーダル)になります。つまり、ほとんどのターンは高速ですが、一部のターンは著しく遅くなります。TrueFoundryのゲートウェイはセッションのトレース上に各呼び出しのレイテンシーを記録するため、この二峰性パターンはリクエストトレースビューで直接確認できます。遅いターンは圧縮のオーバーヘッドを伴うターンであり、これにより、推測ではなく実際の数値に基づいてしきい値を調整できます。
本番環境で重要な2つのヒューリスティック:
反応的ではなく、予防的に圧縮する。 実際のコンテキスト制限に達した時点のみで圧縮をトリガーする場合、エージェントは品質が低下しがちな「リスク上昇ゾーン」ですでに過去数ターンを費やしてしまっています。しきい値は制限より十分に低い値(通常は75%)に設定し、エージェントがそのゾーンで費やす時間を減らします。200Kコンテキストモデルの場合、これは150Kのしきい値となります。
短い会話を圧縮しない。 30Kトークンで完了する5ターンのタスクの場合、圧縮のオーバーヘッドが利点を上回ります。推論が小さくてもラウンドトリップコストは発生します。合理的な下限設定:約75Kトークン未満、またはターン10未満の場合は、圧縮を行わないこと。それ以下では、最悪のケースの完全なコンテキストパスであっても、圧縮のラウンドトリップより安価です。
本番用エージェントプラットフォームの実用的なデフォルト値:compact_threshold をモデルコンテキスト制限の75%に設定し、最小サイズガードを約75Kトークンとし、ステートレスチェーンを用いたサーバーサイド圧縮を介して適用します。
また、圧縮はいくつかのツールの1つに過ぎず、常に適切な選択肢であるとは限りません。選択はタスクの形状によります:
これらは競合するのではなく組み合わせて使用されます。本番環境のエージェントは、多くの場合、システムプロンプトをキャッシュし、コーパスから検索し、ノートをディスクに書き込み、残りの会話を圧縮します。すべての手法においてゲートウェイの役割は共通しています。エージェントの代わりに特定の手法を選択するのではなく、それぞれを観察可能かつ属性特定可能にすることです。
コンテキストエンジニアリングの原則と具象的なゲートウェイプリミティブとの間には、直接的な関連性があります:
ゲートウェイ自体はコンテキストエンジニアリングの決定を行いません。それらの決定を実装可能にし、デバッグ可能にし、エージェントが通信するプロバイダー間で統一します。これこそがTrueFoundryのようなAIゲートウェイの存在理由です。エージェントがOpenAIと通信しているかAnthropicと通信しているかに関わらず、セッションのグループ化、トークン予算の可視性、およびコスト属性特定が全く同じように適用される統合された場所を提供します。
圧縮機能を利用するには Responses API を使用する必要がありますか?
APIネイティブなサーバーサイドのバージョンを使用する場合は、その必要があります。Chat Completions にはファーストクラスの圧縮プリミティブがないため、アプリケーションは独自の実装を行う必要があります(通常は、別のモデル呼び出しで以前の会話を要約し、その要約を次に引き継ぐ方法をとります)。Responses API は、ZDR安全性を実現する不透明な圧縮アイテムのセマンティクスを備えた明示的な操作として圧縮を提供します。
圧縮はプロンプトキャッシュとどのように相互作用しますか?
静的なシステム/デベロッパー/ツールのプレフィックスがバイト単位で同一のまま保持され、圧縮された履歴の前に配置されている場合、圧縮によってそのプレフィックスでのキャッシュヒットが阻害されることはありません。キャッシュヒットには完全なプレフィックス一致が必要であるため、変更されていないプロンプトの先頭部分は引き続き一致します。変化するのは会話履歴部分のキャッシュ可能性です。その後のリクエストは、圧縮後のプレフィックスに対して新しいキャッシュエントリーをウォームアップする必要があります。これが、数ターンごとではなく頻度を低くして圧縮を行う実用的な理由の1つです。大きなシステムプロンプト部分が影響を受けない場合でも、圧縮イベントごとに会話部分のキャッシュが無効化されるためです。
ゲートウェイは複数のプロバイダーをまたいで圧縮を行うことができますか?
できません。圧縮はプロバイダー側で行われ、圧縮アイテムは不透明かつプロバイダー固有のものです。そのため、OpenAIで圧縮を行い、Anthropicで処理を再開することはできません。ゲートウェイは圧縮呼び出しをルーティングし、結果として得られるアイテムをセッションビューに表示することはできますが、継続処理は同じプロバイダーで行う必要があります。
エージェントが Compaction の代わりにサブエージェントを使用する場合はどうなりますか?
サブエージェントは有効な代替策です。サブタスクごとにフレッシュな Context を使用するため、各サブエージェントが自身のサブ問題を超えて拡張されることはなく、オーケストレーターは最後に出力を統合します。サブエージェントはサブ問題が明確に分解可能な場合に機能し、Compaction はエージェントが1つの関連するタスクの多くのターンにわたって継続性を必要とする場合に機能します。この2つは排他的なものではありません。
セッショントークン数は、すでにキャプチャしている OTel スパンとどのように一致しますか?
プロバイダー呼び出しごとに1つの Trace、会話ごとに1つの Session となります。セッションは、会話の Trace 全体をロールアップしたものであり、すべてのターンにわたる累積トークン数、Latency プロファイル、Cache Hit 率を表示します。
TrueFoundry はどこに適合しますか?
この記事のパターンは Gateway に依存しません。Gateway はすでにすべてのリクエストの間に位置しているため、Session グルーピング、ターンごとのトークンバジェットの可視化、Cache Hit の属性特定、プロバイダーの Compaction 呼び出しの Routing を公開する自然な場所です。TrueFoundry AI Gateway は、それらの基盤となる Session および可視性レイヤーを提供します。これには、以前の記事で取り上げた中央集権的な Tracing、メタデータタグ付け、Trace ごとのコスト属性特定およびバジェット適用が含まれ、これらは会話レベルにロールアップされます。Compaction と Caching 自体はプロバイダーの機能です。Gateway の貢献は、それらを Route し、トークンとコストへの影響を属性特定し、長時間のエージェント実行を1つのタイムラインとしてクエリ可能にすることです。(ここで使用されている特定のヘッダー名 X-TFY-CONVERSATION-ID は例示的な規則です。固定されたコントラクトではなく、Gateway が公開できるプリミティブとして扱ってください。)エージェントプラットフォームが Context 戦略を決定し、Gateway が可視性とコントロールを提供します。
現在本番環境で長時間の作業を行うエージェントを運用している場合、最も効果的なアクションは System Prompt で Prefix Caching を有効にすることです。OpenAI の場合、これは自動的でありコードの変更は不要です。Anthropic の場合、キャッシュの書き込みには独自の料金体系があるため、安定した Prefix の周りに cache_control ブレークポイントを追加し、ワークロードに対する書き込み/読み取りの経済性を検証してください。どちらの場合も、通常は数週間以内にプラットフォームへの投資が回収されます。Compaction は、エージェントがモデルの Context 上限の60〜70%を定期的に超えるようになった場合の第2のアクションです。Session のトラッキングは、上記の両方をデバッグ可能にするためのアクションです。
Northwind、Maya、および PR #4127 は例示です。Compaction および Prompt Caching の例は、2026年5月時点のドキュメント化された OpenAI Responses API および Anthropic API の動作を反映しています。トークンの累積、閾値、Latency、および Cache Hit 率は代表的なワークロードの仮定であり、測定値ではありません。本番ポリシーを設定する前に、自身のエージェント Trace に対して測定してください。記載されているプロバイダーの価格および Context 上限は、その時点でのプロバイダーの公開料金表およびモデルページに基づいています。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



























