



November 6, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
La partie 1 a identifié le problème : le tokenmaxxing, cette nouvelle métrique façon "lignes de code", où les ingénieurs optimisent le volume d'utilisation de l'IA simplement parce qu'il s'agit du chiffre mesuré. La partie 2 a prescrit le remède architectural : identité, politique, sécurité et observabilité rattachées à chaque requête au niveau de la passerelle. Cette dernière partie transforme cette architecture en un système exploitable par une entreprise, semaine après semaine.
La décision de conception la plus conséquente à ce niveau est aussi la plus facile à manquer. Le tableau de bord que vous construisez va façonner les comportements. Un classement crée une pression sociale pour consommer des tokens. Un centre de contrôle aide les responsables plateforme, sécurité, finance et ingénierie à répondre à des questions plus complexes et à agir en conséquence.
Les questions qui comptent réellement : Quels workflows créent de la valeur par dollar dépensé ? Quels agents tournent en boucle ? Quelles équipes sous-utilisent l'IA là où elle serait véritablement utile ? Quel usage des modèles premium est justifié, et lequel est décoratif ? Quels événements de garde-fous sont du bruit et lesquels signalent un vrai risque ?
Concevez correctement les panneaux et ces sujets deviendront des questions opérationnelles de routine traitées lors du standup du lundi. Concevez-les mal et votre tableau de bord le plus précis encouragera silencieusement les mêmes comportements biaisés que vous cherchiez à éviter.
Avant les panneaux, voyons les règles de conception. Chaque principe est la réponse directe à un mode d'échec introduit par les classements.
Le panneau d'adoption répond à une question trompeusement simple : combien d'ingénieurs utilisent réellement les outils d'IA au quotidien ?
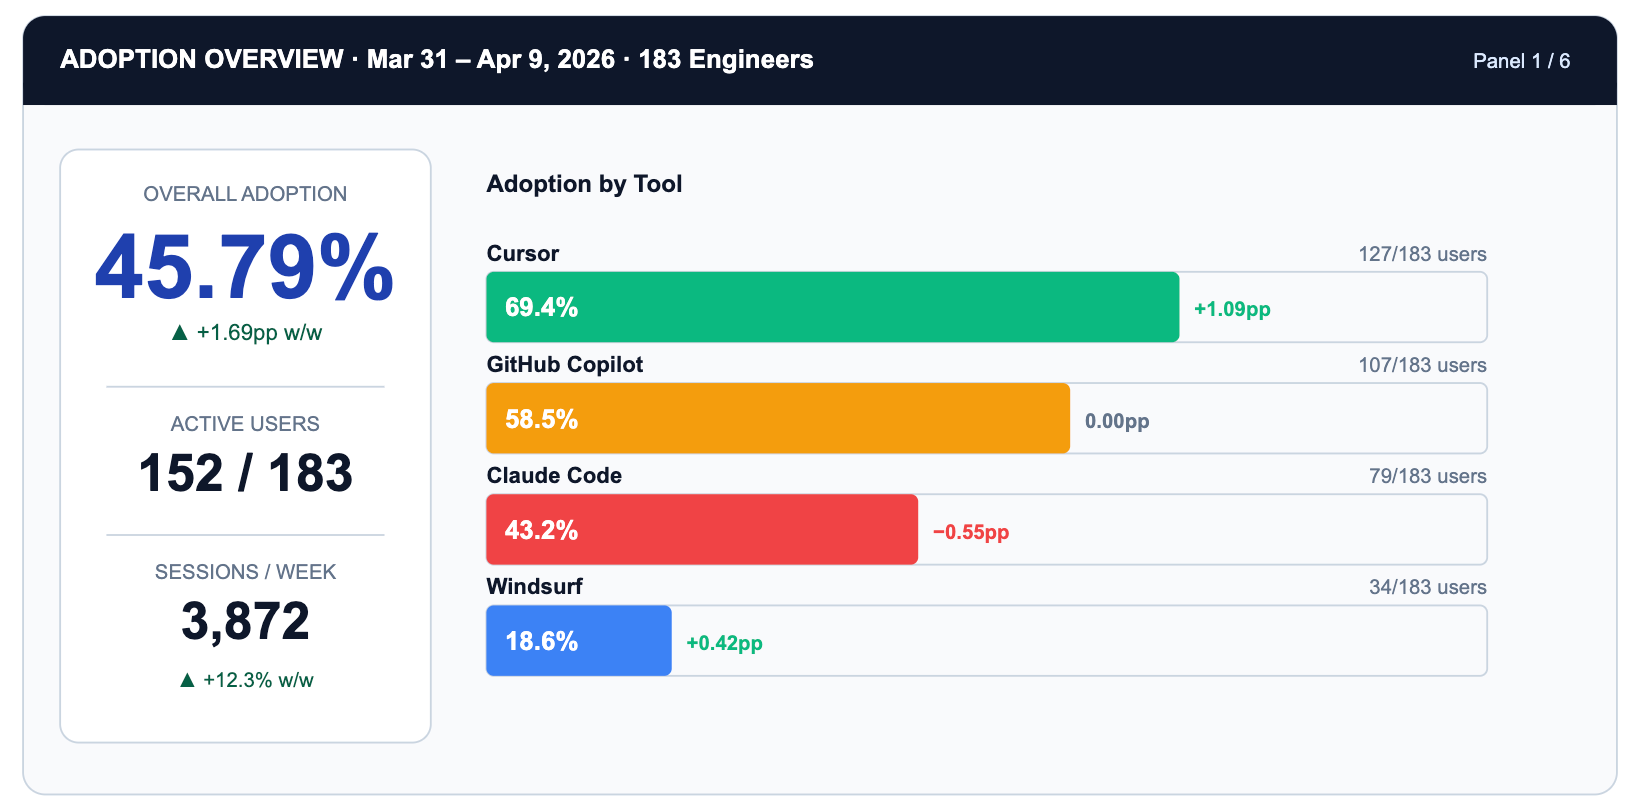
Remarquez ce que le panneau ne montre pas : des classements individuels. L'unité est fournisseur x équipe x jour. L'action qu'il produit n'est pas "féliciter Alex", mais "l'adoption de Claude Code est inférieure de 26 points de pourcentage à celle de Cursor. S'agit-il d'un problème de friction d'outillage ou d'adéquation au cas d'usage ?" Voilà une question qui mérite un sprint.
TrueFoundry rend cela possible via l'en-tête X-TFY-METADATA attaché à chaque requête de passerelle. L'en-tête transporte un objet JSON sérialisé sous forme de chaîne dont les champs incluent l'identité de l'utilisateur, l'appartenance à l'équipe, le nom de l'outil, le tag du projet et l'ID de session.
→ Référence des en-têtes de requête et de réponse TrueFoundry
→ Vue d'ensemble du tableau de bord Analytics
L'adoption vous dit qui utilise l'IA. Le taux de consommation vous dit où va l'argent. Ce sont deux questions différentes et elles appartiennent à des panneaux distincts.
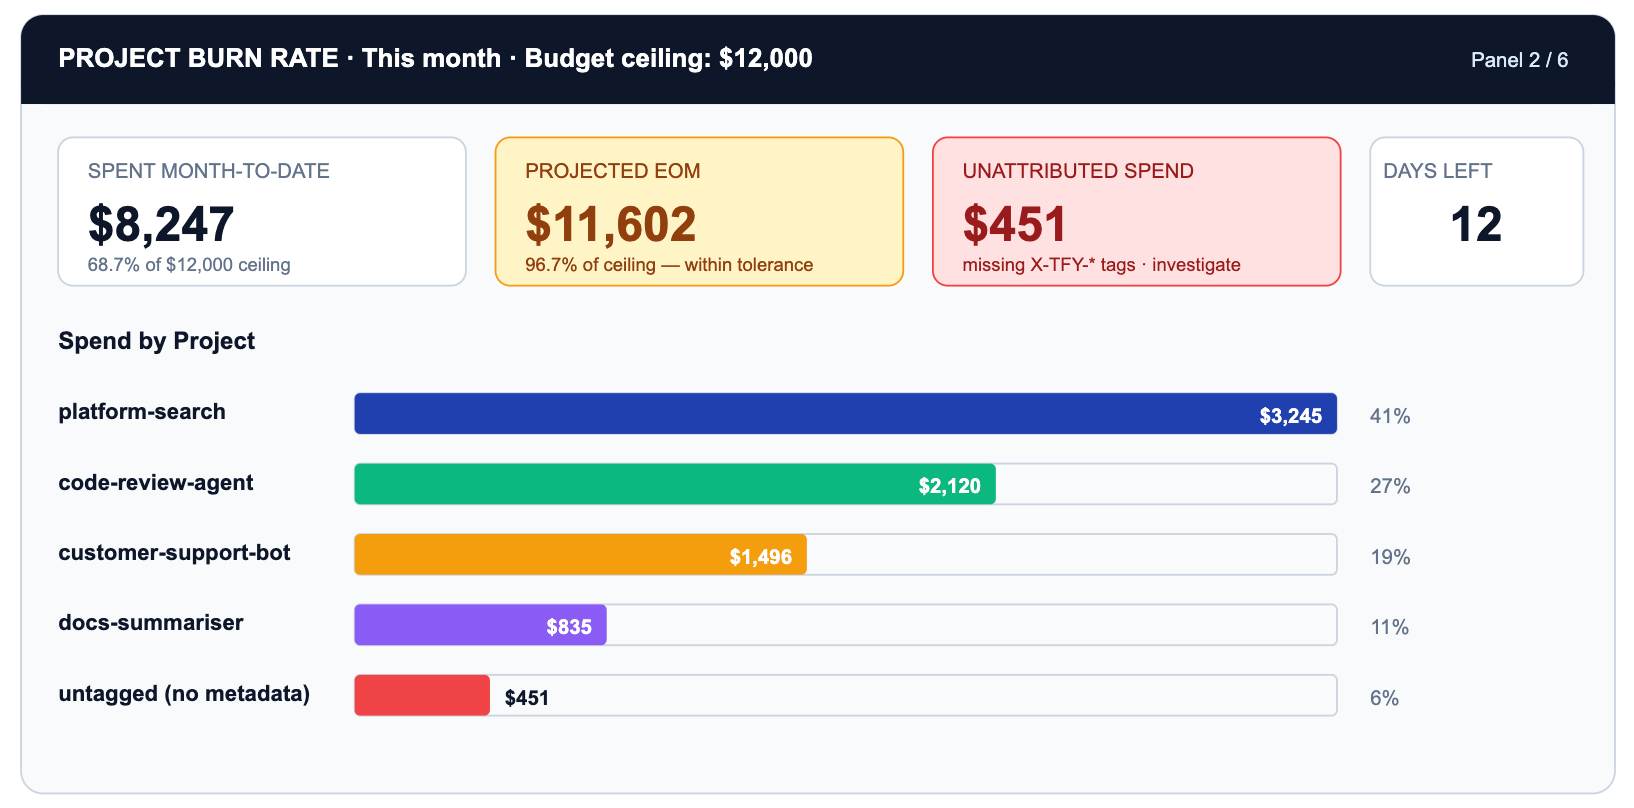
La ligne critique est UNTAGGED. 451 $ de dépenses n'ont aucune métadonnée de projet. C'est un manque de configuration de la passerelle, pas un problème de dépense. Chaque requête non tagguée ne peut être attribuée à un résultat métier, gouvernée par une politique budgétaire, ni apparaître dans un graphique de taux de consommation utile.
TrueFoundry Budget Limiting vous permet de définir des plafonds stricts par projet, par équipe, par famille de modèles ou par fenêtre temporelle. Lorsque platform-search atteint 100 % de son plafond mensuel de 4 000 $, les requêtes commencent à renvoyer des erreurs 429 ou basculent sur un modèle moins cher selon votre politique configurée.
→ Budget Limiting — fenêtres, plafonds et alertes
→ Rate Limiting — par utilisateur, par modèle, par tag de métadonnées
Le mode d'échec récent le plus coûteux dans un monde d'agents est la boucle infinie : un agent qui réessaie indéfiniment parce que sa condition de sortie n'est jamais satisfaite, ou parce que l'outil qu'il appelle renvoie continuellement des erreurs. Un seul agent en boucle peut consommer autant de tokens en une heure qu'une équipe d'ingénieurs en une journée.
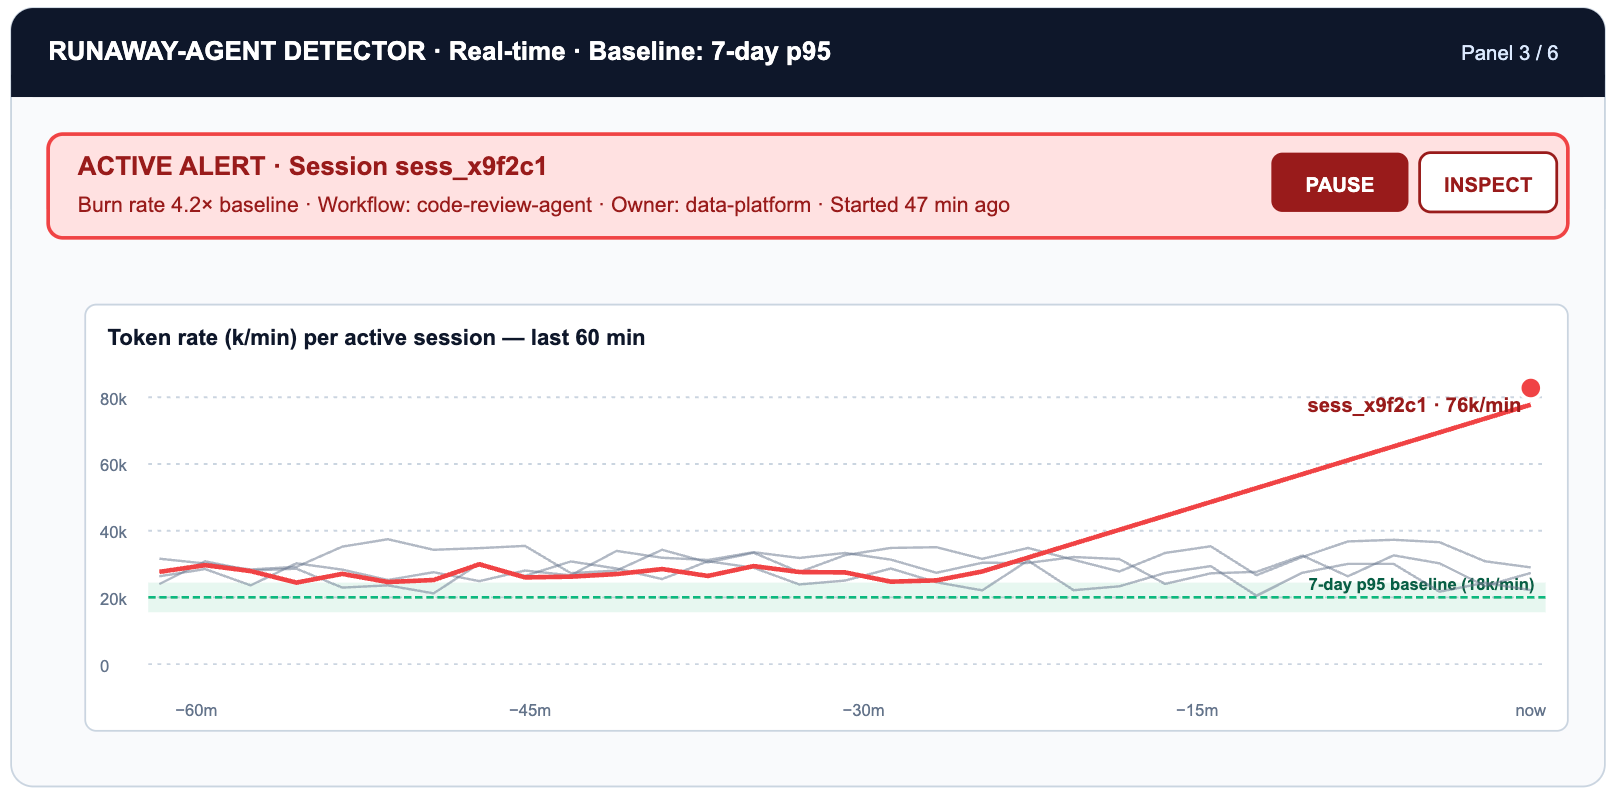
Ce panneau nécessite le signal OTEL exporté par TrueFoundry : le débit de tokens par session au fil du temps, et pas seulement des comptages par requête, prenant en charge des pratiques d'AIOps telles que la détection d'anomalies et l'identification proactive des problèmes. La ligne de base p95 est calculée à partir des sept derniers jours de sessions pour chaque tag de workflow. Tout dépassement de 3x cette ligne de base déclenche un événement d'astreinte et éventuellement l'arrêt de la session via la voie d'application du rate-limiting.
→ Exporter les données OpenTelemetry — traces, spans, compteurs de tokens
→ Rate Limiting — application de plafonds par session
Toutes les tâches qui atteignent un modèle frontier ne nécessitent pas un modèle frontier. Router une tâche de classification d'e-mail vers Claude Opus 4.7 à 5 $/25 $ par million de tokens alors que Haiku 4.5 à 1 $/5 $ la traiterait à 2 points de pourcentage d'exactitude près, c'est payer 5x pour une capacité inutilisée. Ce choix est invisible jusqu'à ce qu'il soit agrégé sur des milliers de requêtes quotidiennes — ce qui est exactement le rôle de ce panneau.
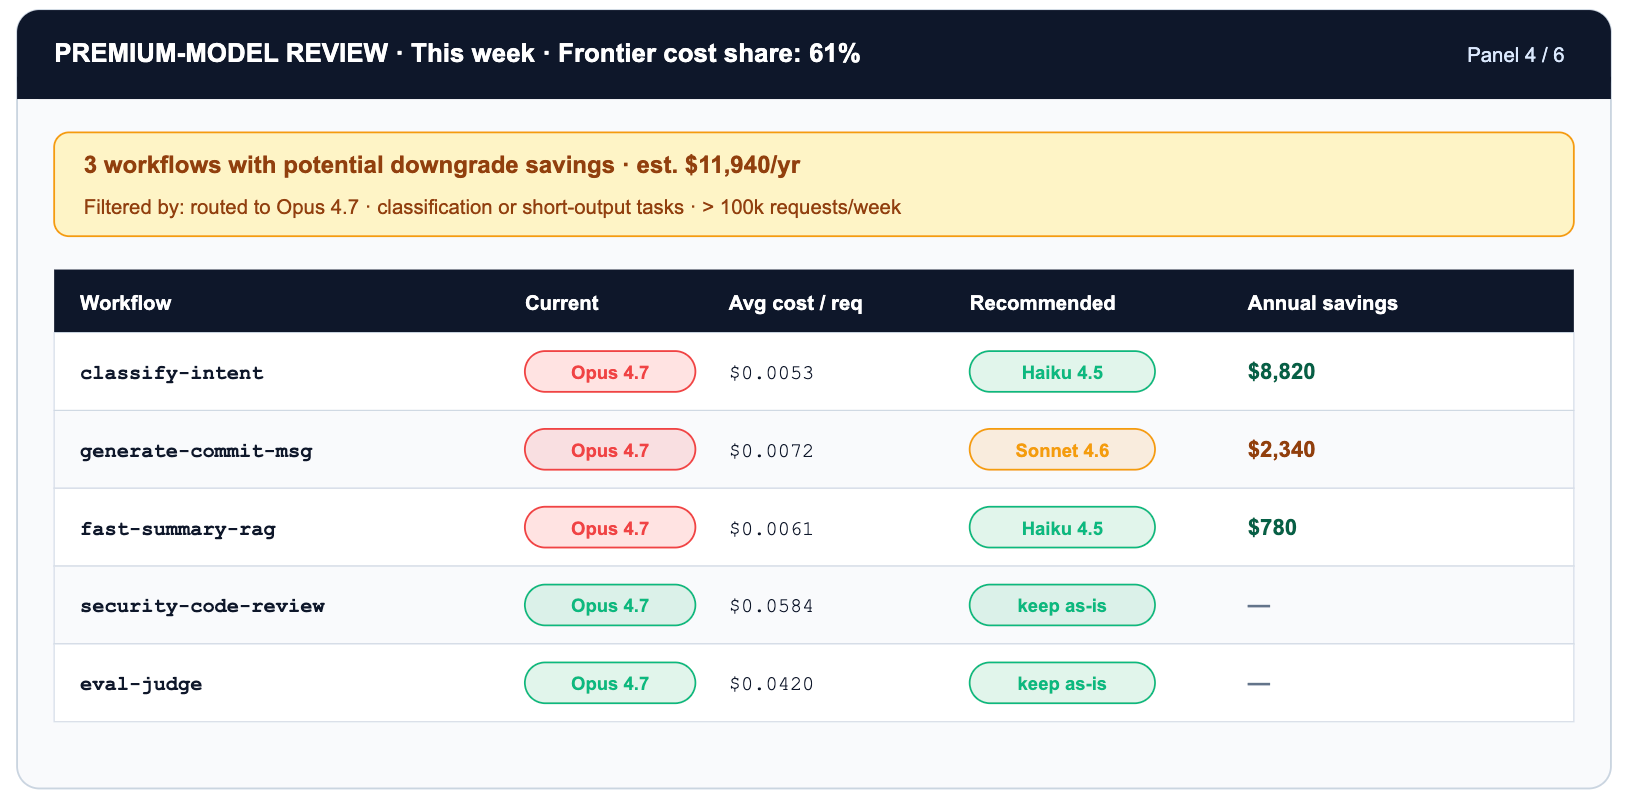
Deux optimisations superposées se cumulent sur ce panneau. Router classify-intent de Opus 4.7 vers Haiku 4.5 réduit le coût des tokens d'un facteur 5. En plus de cela, l'activation de la mise en cache des prompts sur le prompt système réduit les tokens d'entrée mis en cache de 90 % supplémentaires — une réduction cumulée qui transforme un workflow à 3 200 $/mois en environ 50 $/mois, sans aucun changement d'exactitude.
Il existe également une version cachée de ce panneau : la dérive du tokenizer. Lorsque Anthropic a sorti Opus 4.7, le nouveau tokenizer générait jusqu'à 35 % de tokens en plus pour le même texte en entrée par rapport à Opus 4.6. Les tarifs affichés n'ont pas changé. Le coût effectif par requête, si. La seule façon de le voir est d'observer la télémétrie des tokens par version de modèle sur la passerelle. La seule façon de réagir est de faire revenir l'alias virtuel du modèle à la version précédente — ce qui, sur TrueFoundry, est un simple diff YAML, et non un sprint.
Le routage de modèle virtuel de TrueFoundry permet d'agir sur ce panneau sans aucune friction. Vous configurez un nom de modèle logique comme 'code-review-fast' qui se route vers différents endpoints physiques selon le tag du workflow, l'heure de la journée ou la charge — sans toucher au code de l'application. Tester un modèle moins cher en A/B testing est un diff YAML, pas un sprint.
→ Vue d'ensemble du routage — poids, priorité, fallback, mise en cache de prompt
Le rôle du panneau de sécurité est le tri. La plupart des événements de garde-fous sont du bruit : du trafic de test, de l'expérimentation de développeurs, des cas limites attendus en production. Seule une poignée représente un vrai risque : fuite de PII dans un prompt, présence d'un secret dans du code généré par un agent, tentative d'injection de prompt dans une entrée utilisateur.
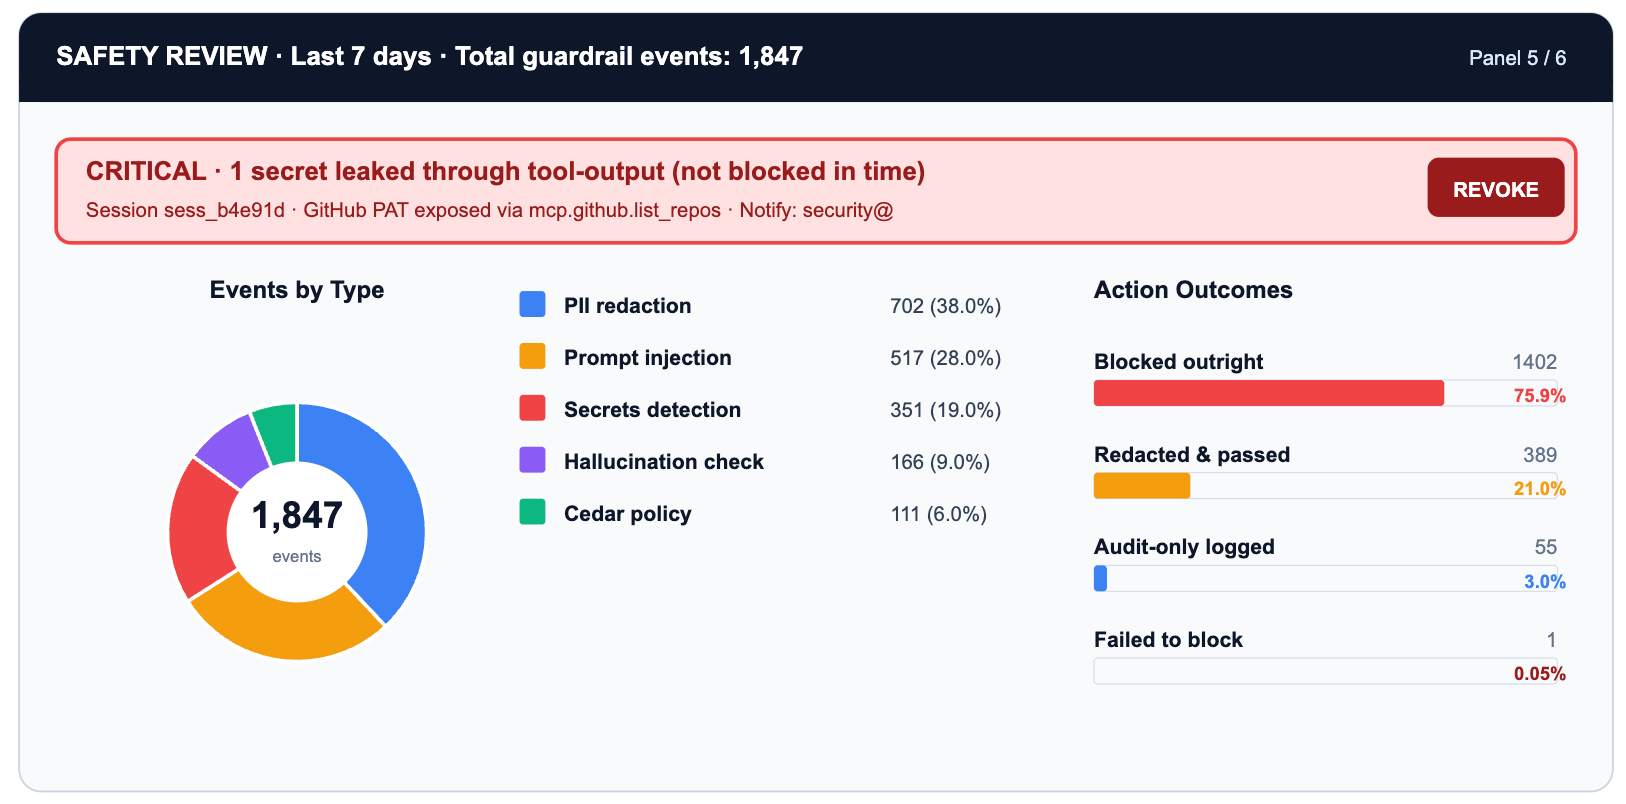
Le seul secret divulgué dans la ligne secrets-scan est la cellule qui justifie une action immédiate. Tout le reste est à titre informatif : utile pour ajuster la sensibilité des garde-fous, distinguer le signal du bruit et démontrer la posture de conformité aux auditeurs.
Le modèle à quatre crochets (hooks) de garde-fous de TrueFoundry (request-input, request-output, tool-input, tool-output) signifie que chaque ligne d'événement s'associe à un point d'interception spécifique dans le cycle de vie de la requête. La détection de PII lors du request-input intercepte les données utilisateur avant qu'elles n'atteignent le modèle. Le scan de secrets lors du tool-output intercepte les identifiants avant qu'ils n'atteignent les systèmes en aval.
→ Vue d'ensemble des garde-fous — quatre crochets, décomposition de la surface de menace
→ Détection PII/PHI — modes de caviardage et placement des crochets
→ Détection de secrets — mode validation vs mutation
C'est le panneau le plus difficile à construire et le plus important à posséder. Les cinq panneaux précédents décrivent l'usage de l'IA. Celui-ci répond à la question de savoir si cet usage a produit quelque chose.
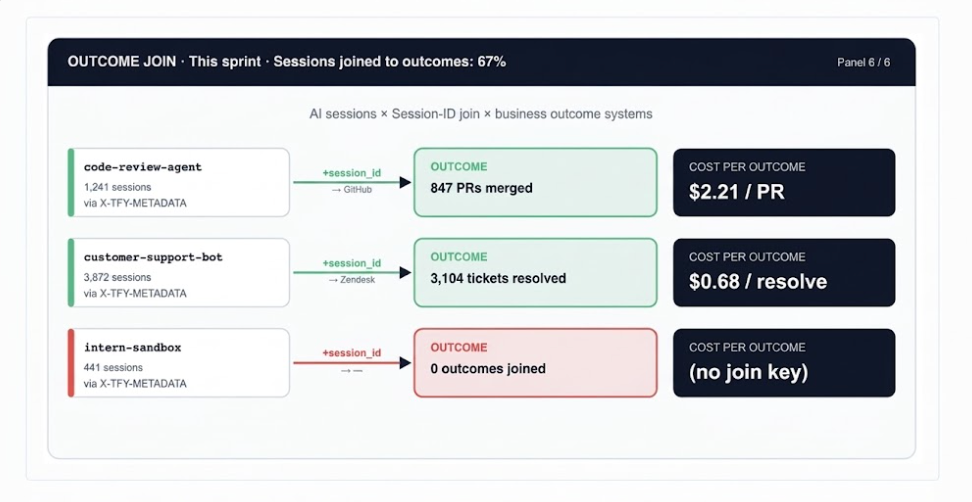
La clé de jointure est le champ session_id dans X-TFY-METADATA, propagé par TrueFoundry à travers chaque requête d'une session d'agent multi-tours. Lorsque le même ID de session apparaît dans la charge utile de votre webhook GitHub ou dans les métadonnées Zendesk, vous pouvez boucler la boucle : cette session a coûté 2,21 $ et a produit une PR de revue de code fusionnée.
→ Analytics — vues des coûts et de l'usage au niveau de la session
Les six panneaux s'appuient sur trois couches de métriques distinctes. L'erreur la plus courante sur les tableaux de bord est de les mélanger : une vue exécutive ne devrait pas montrer les comptages de réessais, et une vue d'astreinte ne devrait pas afficher le taux de réussite des évaluations.
Une fois les trois couches en place, la tentation est de les agréger dans un score par ingénieur et de publier un classement. Résistez-y. La fonction ci-dessous est explicitement diagnostique : c'est un outil pour identifier les modèles de workflow qui méritent un investissement, une refonte ou de nouveaux garde-fous. Regroupez par workflow_tag, et non par user_id.
Les tableaux de bord ne dirigent pas les organisations. Les rituels le font. La cadence opérationnelle minimale viable pour un usage gouverné de l'IA :
Chaque alerte doit être associée à une étape de procédure opérationnelle, et pas seulement à un événement d'astreinte. Le code YAML ci-dessous définit l'ensemble minimal de règles d'alerte pour le centre de contrôle, s'exécutant sur l'export OTEL de TrueFoundry :
Vérifier le champ workflow_tag dans l'en-tête X-TFY-METADATA de la requête pour identifier l'équipe propriétaire
Vérifier le champ workflow_tag dans l'en-tête X-TFY-METADATA de la requête pour identifier l'équipe propriétaire
→ tfy apply — Déploiement d'alertes et de politiques en mode GitOps
→ Exporter les données OpenTelemetry — Endpoints de métriques OTEL
Avant de déclarer votre centre de contrôle IA opérationnel, vérifiez ces huit conditions. Chacune correspond à une fonctionnalité spécifique de TrueFoundry :
La trilogie Tokenmaxxing a développé un argumentaire en trois couches. Chaque couche est nécessaire ; aucune n'est suffisante à elle seule.
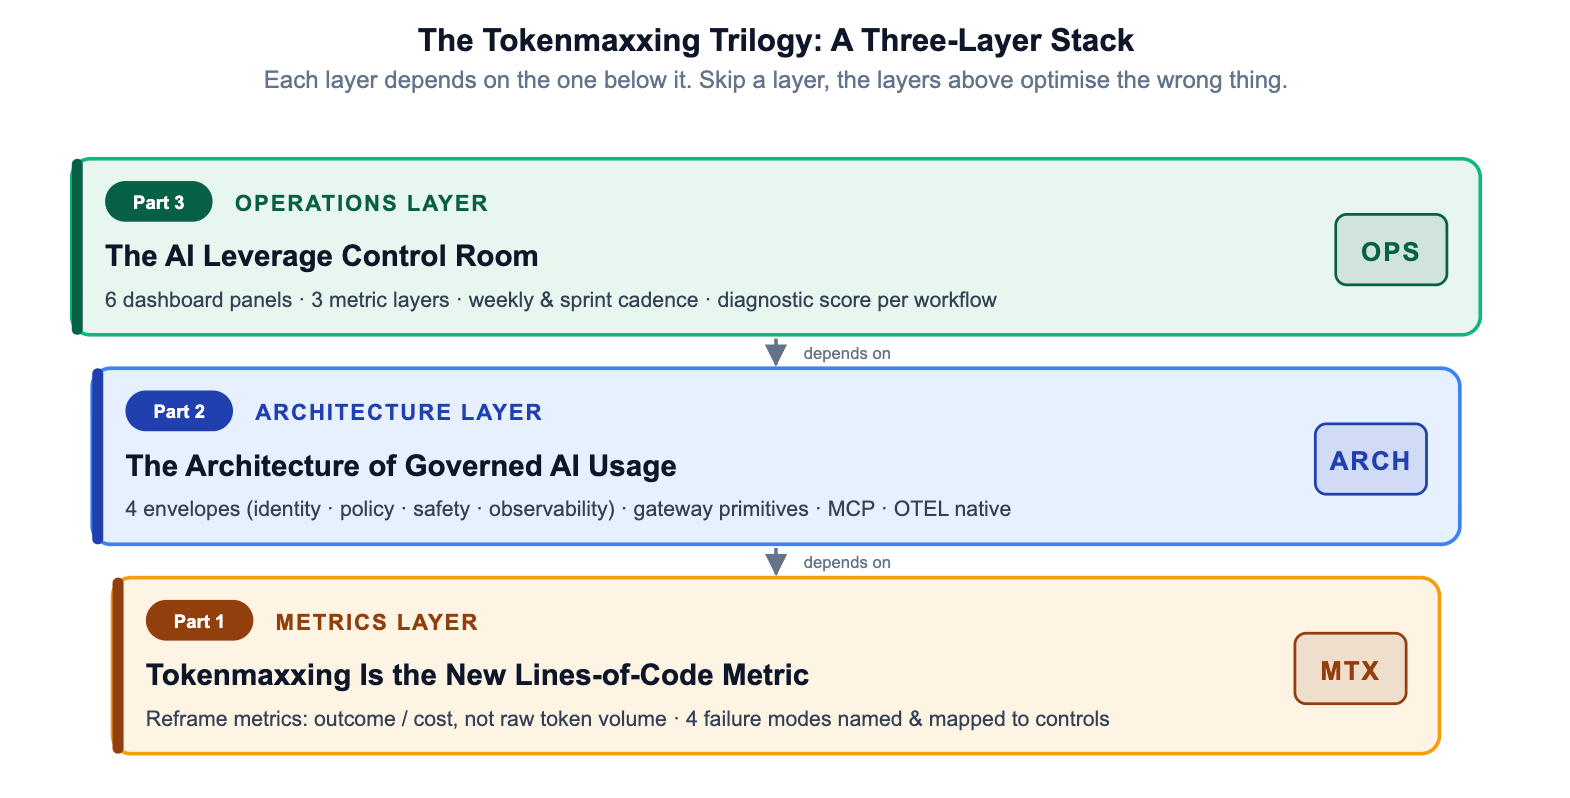
Les entreprises qui s'arrêtent à la couche 1 ont une vision mais aucune application. Celles qui s'arrêtent à la couche 2 ont de l'application mais pas de boucle de rétroaction. Le centre de contrôle boucle la boucle — faisant de l'usage gouverné de l'IA non pas une simple posture de conformité, mais une discipline opérationnelle qui porte ses fruits au fil du temps.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception



















