



November 6, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
La partie 1 posait le diagnostic : le tokenmaxxing n'est pas un problème d'usage de l'IA ; c'est un problème de plan de contrôle. Si les tokens bruts deviennent un objectif, les équipes vont optimiser pour les tokens bruts. Si le levier d'une IA gouvernée devient le modèle opérationnel, la plateforme peut encourager l'adoption tout en delimitant les coûts, les risques et le bruit opérationnel. Cette partie rend cette architecture concrète.
La thèse est simple. Chaque requête IA quittant une application d'entreprise est, que vous la traitiez ainsi ou non, un événement d'exécution ayant des conséquences sur les coûts, la sécurité et l'audit. Le lieu unique offrant le plus de levier pour rattacher des contrôles à ces événements est la gateway — la couche qui se situe entre chaque application et chaque backend de modèle ou d'outil. Un tableau de bord construit en aval peut décrire ce qui s'est passé. Seule la gateway peut décider de ce qui se passera ensuite.
Un tableau de bord signale un problème. Une gateway évite le suivant. L'architecture ci-dessous est ce qui rend cette distinction opérationnelle.
Une requête IA gouvernée a besoin de quatre enveloppes enveloppées autour d'elle avant de quitter l'application. Pensez-y comme au modèle OSI pour l'IA d'entreprise — chaque couche a une responsabilité spécifique et un mode de défaillance spécifique lorsqu'elle est absente.
Ces enveloppes doivent se trouver sur le chemin de la requête, et non dans un rapport que quelqu'un lit le vendredi. Un tableau de bord construit a posteriori peut décrire un problème ; seule une enveloppe sur la requête en direct peut façonner l'appel suivant. C'est le principe architectural qui sépare une plateforme d'IA gouvernée d'un module d'analyse complémentaire.
La première norme d'implémentation est un contrat de métadonnées strict. Utilisez des clés de type chaîne de caractères, envoyez-les à chaque requête et rendez-les obligatoires dans vos wrappers SDK, bibliothèques clientes internes, frameworks de bots et modèles d'agents. Le coût d'un champ manquant réapparaît plus tard sous la forme d'une ligne de facture manquante, d'un pic non attribuable ou d'un événement de guardrail que personne ne peut orienter vers un propriétaire.
Le taggage est le travail d'ingénierie le moins cher de toute cette architecture et la première chose qui casse lorsque les équipes l'ignorent.
Dans la gateway TrueFoundry, cela circule sous l'en-tête X-TFY-METADATA. Le même espace de noms de clés alimente ensuite tout le reste en aval : les budgets s'appliquent par projet, les rate limits s'appliquent par workflow, les tableaux de bord regroupent par équipe, les traces se joignent aux tickets et la finance alloue les dépenses par centre de coûts. Il n'y a pas de seconde source de vérité.

L'objectif architectural n'est pas d'ajouter des boutons de réglage. Il est de maintenir une cartographie étroite entre chaque mode de défaillance réaliste et le contrôle spécifique qui l'évite. Voici la taxonomie complète :
Si le code applicatif nomme un modèle de fournisseur spécifique, vous avez perdu la capacité de migrer, tester, faire de l'A/B testing ou effectuer des basculements d'urgence sans modification de code. Le bon modèle consiste à exposer des capacités logiques — des noms comme prod/engineering-assistant ou prod/frontier-reasoning — et à laisser la gateway les résoudre en cibles physiques en fonction des métadonnées, de la priorité, du poids ou de la latence mesurée.
Dans TrueFoundry, c'est le rôle des Virtual Models et de la configuration de routage. Les mêmes règles couvrent les déploiements canary, les préférences régionales, le déploiement sur site avec fallback cloud, et les remplacements de prompts spécifiques aux fournisseurs. C'est la capacité la plus sous-estimée de la pile de gouvernance — elle rend la conformité, l'optimisation des coûts et la migration de modèles invisibles pour les développeurs d'applications.
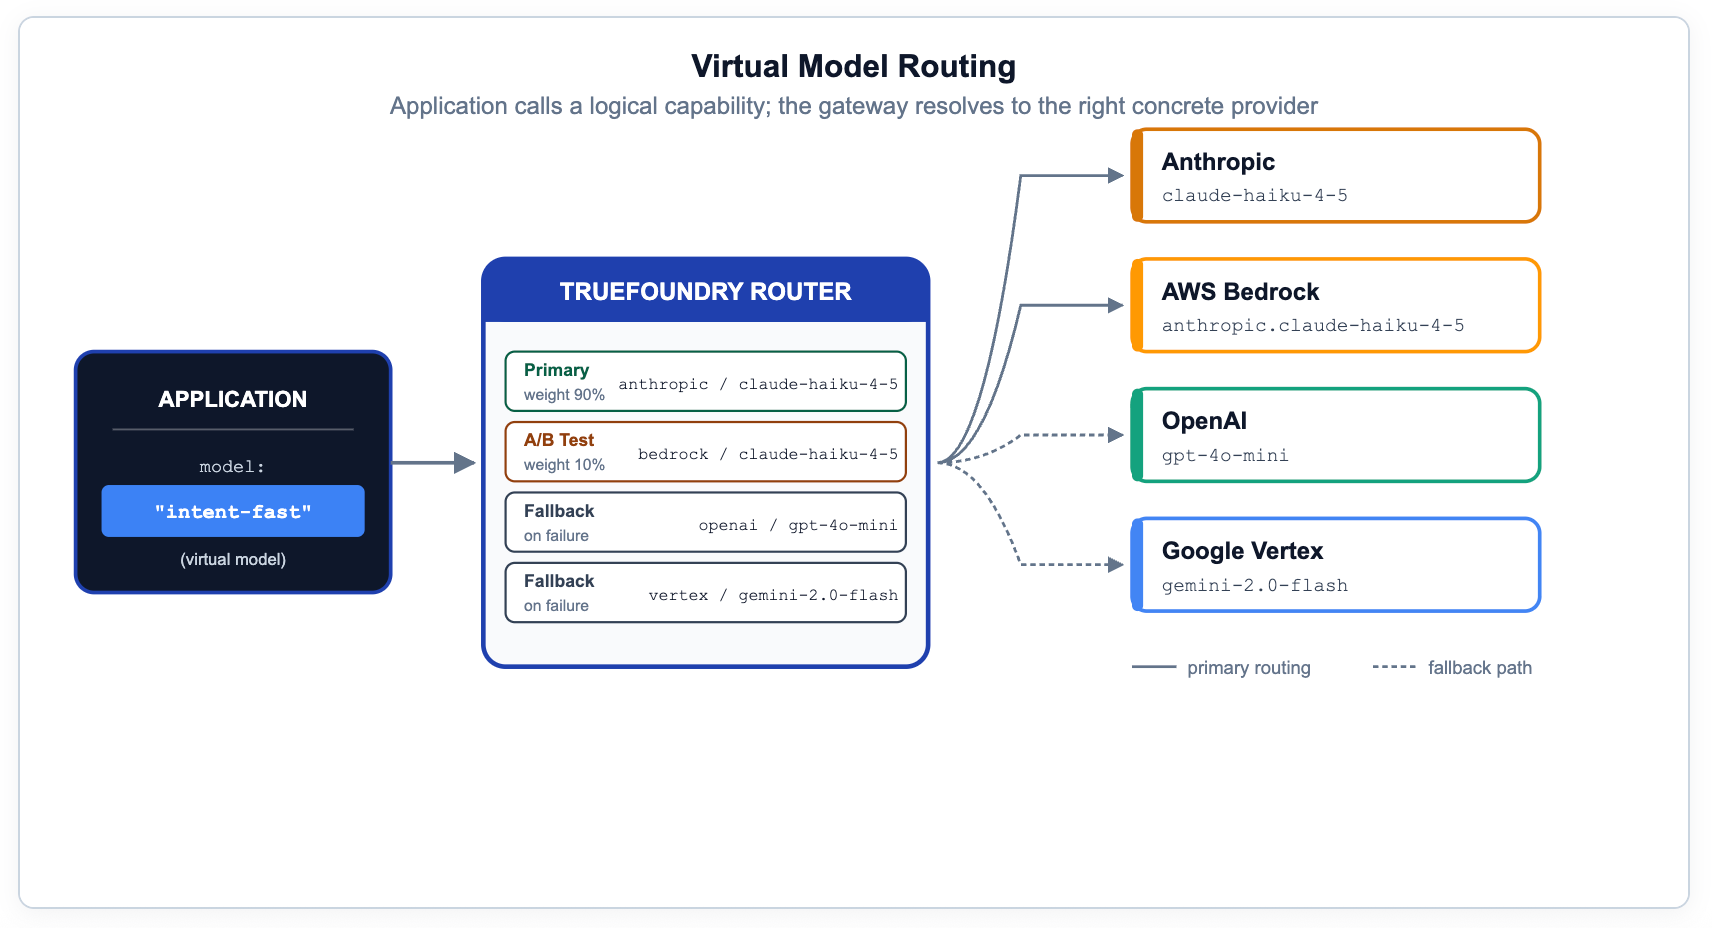
Documentation sur le routage : truefoundry.com/docs/ai-gateway/load-balancing-overview
Une fois que les applications d'IA atteignent la production, elles manipulent de vraies données utilisateurs et, dans des configurations agentiques, entreprennent de vraies actions via des outils. Le périmètre de sécurité n'est pas un élément unique. C'est un ensemble de quatre hooks, placés aux quatre moments où la gateway peut intervenir avant qu'une requête ne cause un dommage.
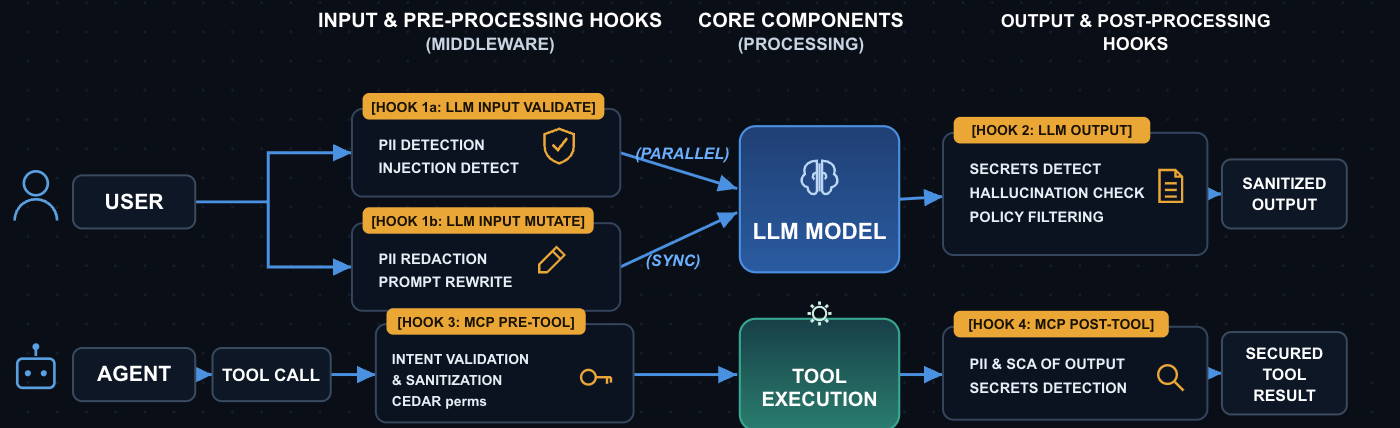
Déployez les guardrails en trois étapes : Audit → Appliquer-mais-ignorer-en-cas-d'erreur → Strict. Le réglage intermédiaire est celui qui vous sauvera le jour où un fournisseur de sécurité tiers subira une panne.
Aperçu des guardrails : truefoundry.com/docs/ai-gateway/guardrails-overview
Détection PII/PHI : truefoundry.com/docs/ai-gateway/tfy-pii
Détection de secrets : truefoundry.com/docs/ai-gateway/secrets-detection
Deux questions dominent les opérations une fois que l'usage de l'IA gouvernée est en production : "pourquoi cette requête s'est-elle comportée ainsi ?" et "le coût que nous payons est-il aligné avec le travail que nous obtenons ?" Aucune de ces questions ne peut être répondue à partir d'un graphique de comptage de tokens.
La surface minimale nécessaire pour y répondre — et la surface que la gateway de TrueFoundry fournit clé en main :
Documentation Analytics : truefoundry.com/docs/ai-gateway/analytics
Export OpenTelemetry : truefoundry.com/docs/ai-gateway/export-opentelemetry-data
Les quatre enveloppes ci-dessus ont été conçues en supposant des requêtes de type chat : une application envoie un prompt, le modèle renvoie du texte. Les charges de travail d'IA modernes ont dépassé cette hypothèse. Les agents appellent des outils. Les outils appellent d'autres outils. Une seule requête utilisateur peut engendrer une trajectoire d'agent en 50 étapes qui touche une demi-douzaine de serveurs MCP. La surface de coût, la surface de sécurité et la surface d'audit se sont toutes déplacées du prompt vers l'appel d'outil.
C'est pourquoi la gateway TrueFoundry prend en charge nativement à la fois l'API LLM et le Model Context Protocol (MCP). La même enveloppe d'identité, les mêmes coupe-circuits, les mêmes hooks d'observabilité s'appliquent aussi bien à un appel d'outil qu'à une complétion de chat. L'identité OAuth 2.0 est injectée dans les appels d'outils MCP afin qu'un agent agisse en tant qu'utilisateur spécifique, et non comme un compte de service, lorsqu'il interroge une base de données ou crée un ticket Jira. Les serveurs MCP virtuels vous permettent de composer un 'finance-agent-server' logique à partir d'outils répartis sur trois vrais serveurs MCP, avec des contrôles d'accès et des rate limits appliqués à la composition.
Le Model Context Protocol importe pour les coûts, pas seulement pour l'architecture. TrueFoundry rapporte jusqu'à 99 % d'économies de tokens d'inférence lorsque les agents utilisent la récupération d'outils active au lieu d'engorger le contexte dans les prompts — avec une surcharge d'appel d'outil mesurée à environ 10 ms.
Il est tentant de repousser ces contrôles dans le code applicatif : un wrapper ici, un décorateur Python là, une classe d'aide dans le framework d'agent. Cela fonctionne jusqu'à ce que vous ayez trois équipes d'application, deux fournisseurs de modèles, une acquisition, un audit PCI et un incident de rate-limit un mardi.
À ce stade, vous découvrez que vous avez construit quatre plans de contrôle légèrement différents qui se contredisent, et qu'aucun d'entre eux ne peut stopper une requête provenant d'une équipe qui n'a pas importé le wrapper. La gateway existe pour la même raison que les gateways d'API d'il y a dix ans : c'est le seul endroit où chaque requête, de chaque application, dans chaque environnement, peut être observée et façonnée de manière uniforme.
L'objection à une gateway est toujours 'un saut de plus sur le chemin de la requête.' La gateway IA de TrueFoundry ajoute environ 5 ms de surcharge p50 et gère plus de 350 requêtes par seconde sur un seul vCPU. L'objection ne résiste pas à l'épreuve des chiffres.
La gateway est également le seul endroit capable de prendre en charge l'ensemble de la surface de l'infrastructure d'IA moderne : plus de 1000 LLM répartis sur plus de 19 fournisseurs, en plus des serveurs MCP que vos agents appellent et des modèles hébergés en propre derrière votre VPC. TrueFoundry a été citée dans le rapport Gartner '10 Best Practices for Optimizing Generative & Agentic AI Costs 2026' — parce que la seule façon pour les entreprises d'optimiser réellement sur cette surface d'attaque est de faire passer chaque requête par une couche gouvernée unique.
→ Architecture de la plateforme
→ Architecture du plan de la gateway
Le tokenmaxxing est le symptôme d'une adoption non gérée de l'IA. L'architecture ci-dessus en est le remède. L'identité définit qui demande. La politique définit ce qui est autorisé. La sécurité définit ce qui est acceptable. L'observabilité définit ce qui s'est réellement passé. Ensemble, elles convertissent l'activité brute de tokens en un cycle de vie de requête gouverné — responsable, utile, sûr, ajustable.
L'objectif n'est pas de réduire l'usage de l'IA. L'objectif est de rendre chaque ligne de cet usage explicable.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception



















